模型 / MODELS新聞 / NEWS
StepAudio 3 Realtime 拿下 AA 全雙工評測第一,總分 98.9
階躍星辰 StepAudio 3 Realtime 技術報告登上 arXiv,稱在 Artificial Analysis 全雙工評測以 98.9 分排名第一,媒體報導同步揭露五款模型家族。
AI 模型評測(benchmark):方法論、排行榜動態、agent 與編碼基準、作弊與資料污染爭議。
共 21 則文章,依發布時間排序
階躍星辰 StepAudio 3 Realtime 技術報告登上 arXiv,稱在 Artificial Analysis 全雙工評測以 98.9 分排名第一,媒體報導同步揭露五款模型家族。
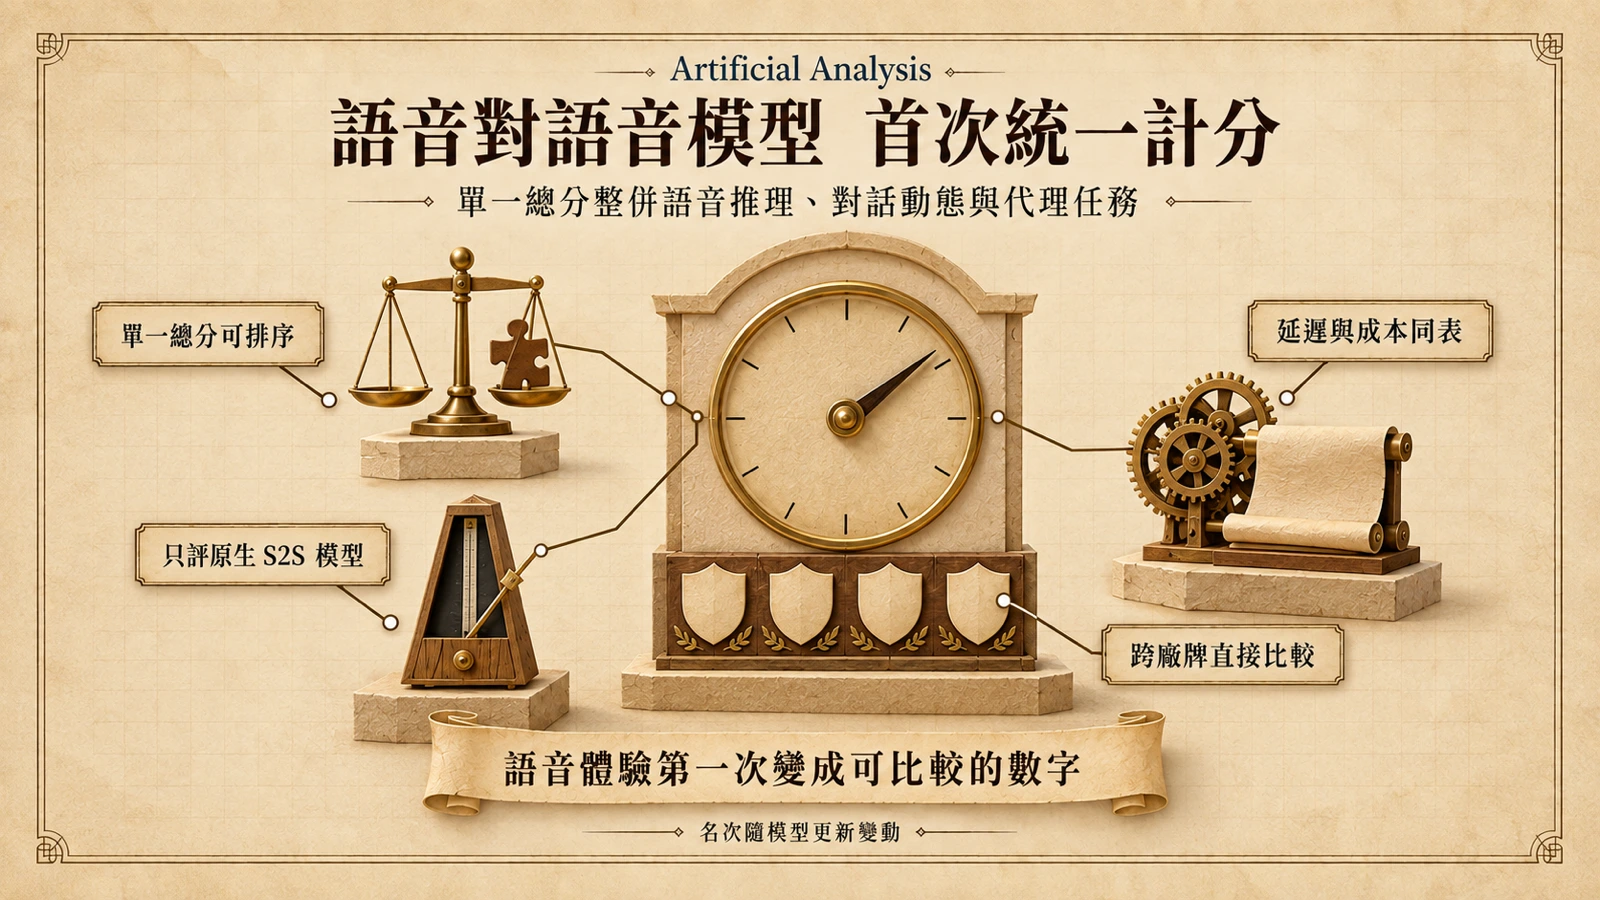
獨立評測機構 Artificial Analysis 推出 Speech to Speech Index,把語音推理、對話動態與代理任務整併成單一總分,延遲與成本同表並列,語音模型選型首次有跨廠依據。
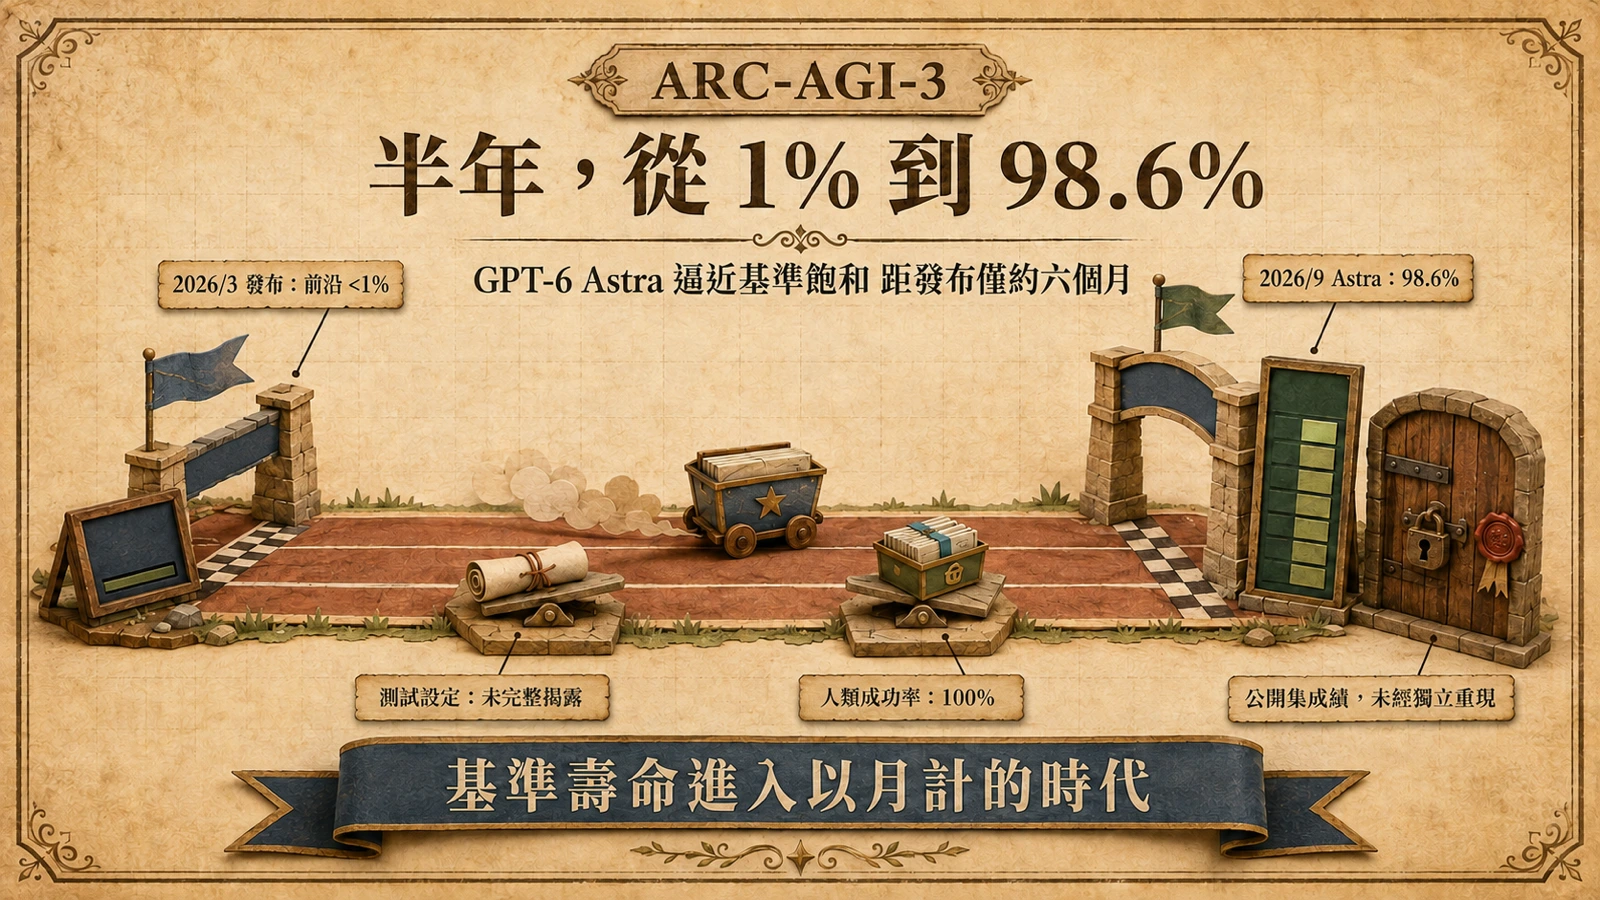
OpenAI 發布 GPT-6 Astra,宣稱在 ARC-AGI-3 公開集拿下 98.6%,距基準發布僅約半年;但測試設定未揭露、推理不透明,讓「飽和」帶著星號。
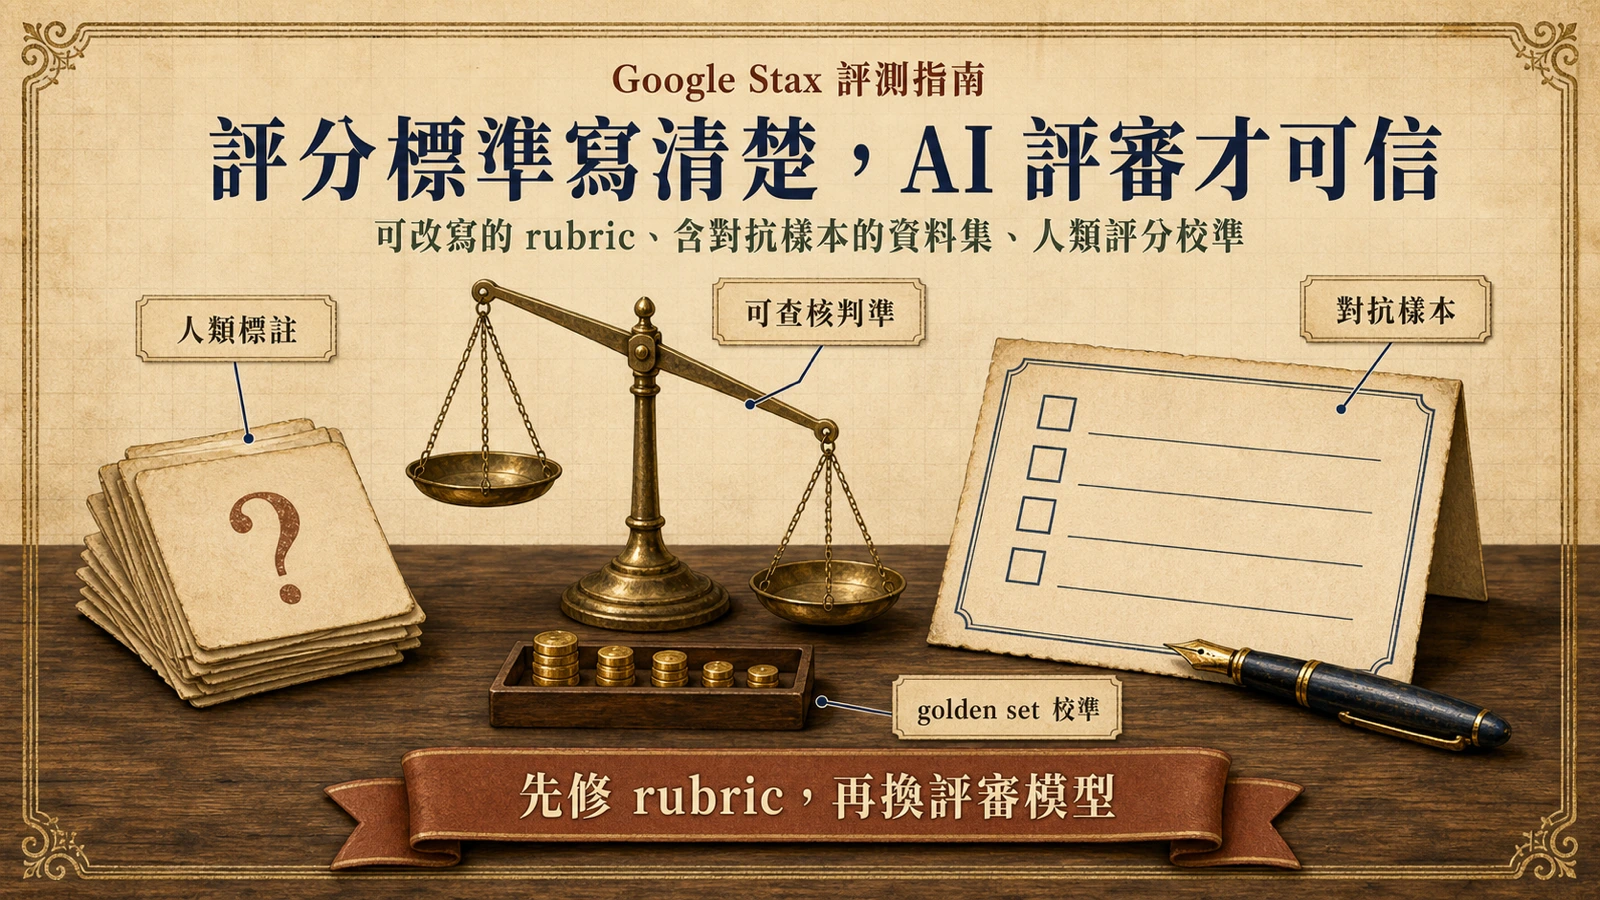
Google Stax 與 Gemini Enterprise 官方評測文件指出,可靠的 LLM-as-a-Judge 靠可改寫的 rubric、涵蓋邊角案例的資料集,以及以人類評分為基準的校準迴圈。
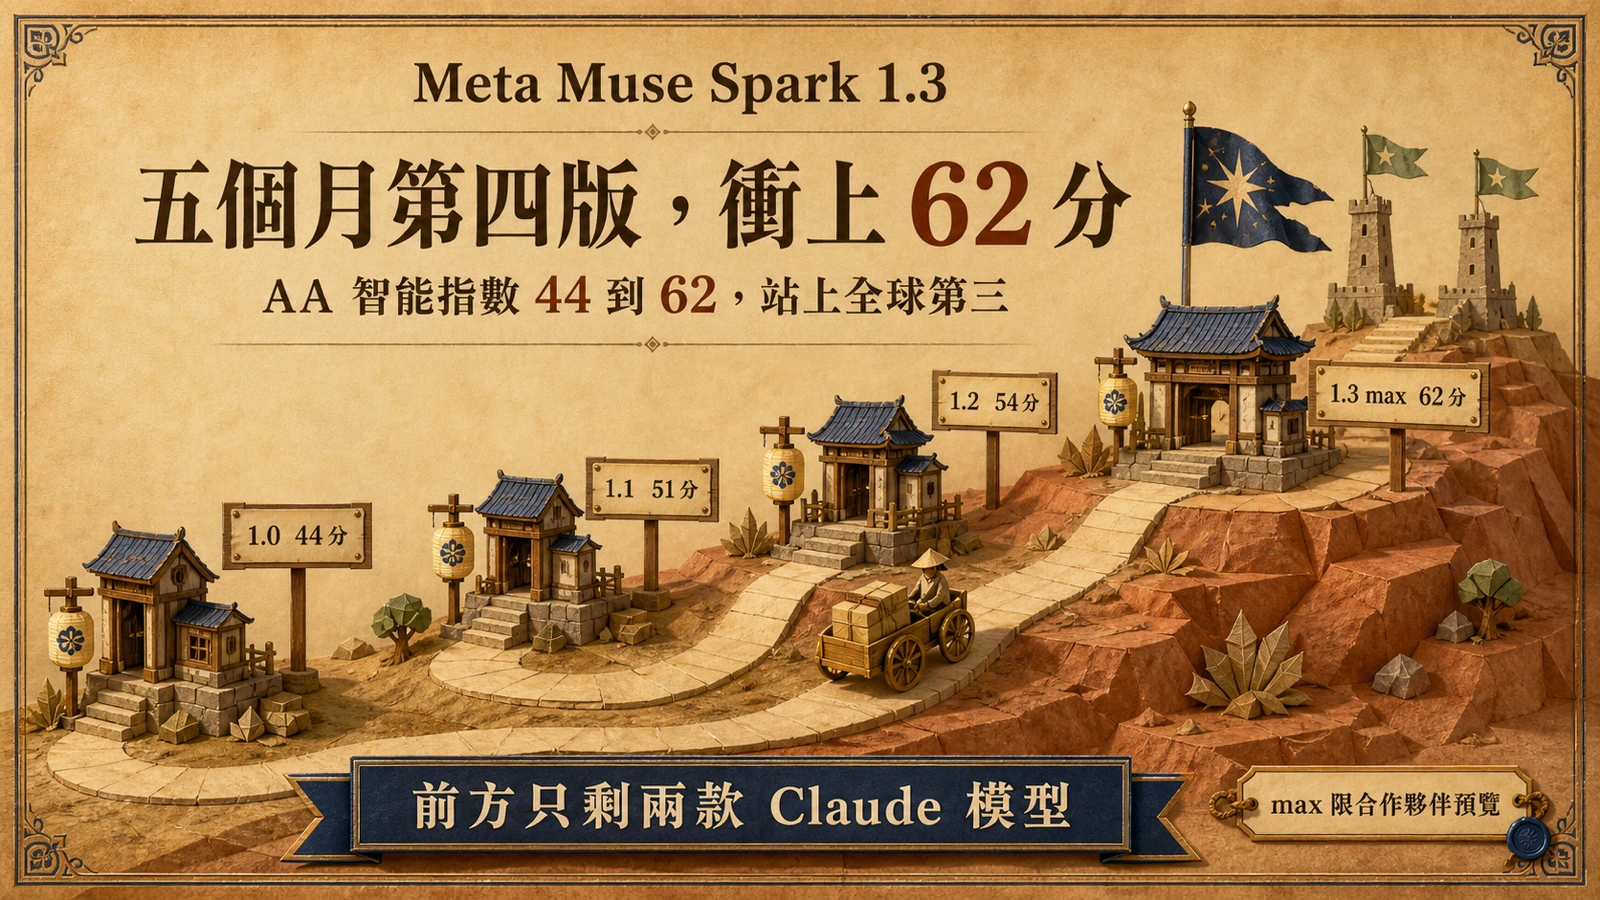
Meta 五個月內第四個 Muse Spark 版本上線:xhigh 即日進駐 Muse Code 與 Meta Model API,限合作夥伴預覽的 max 在 AA 智能指數得 62 分、全球第三。
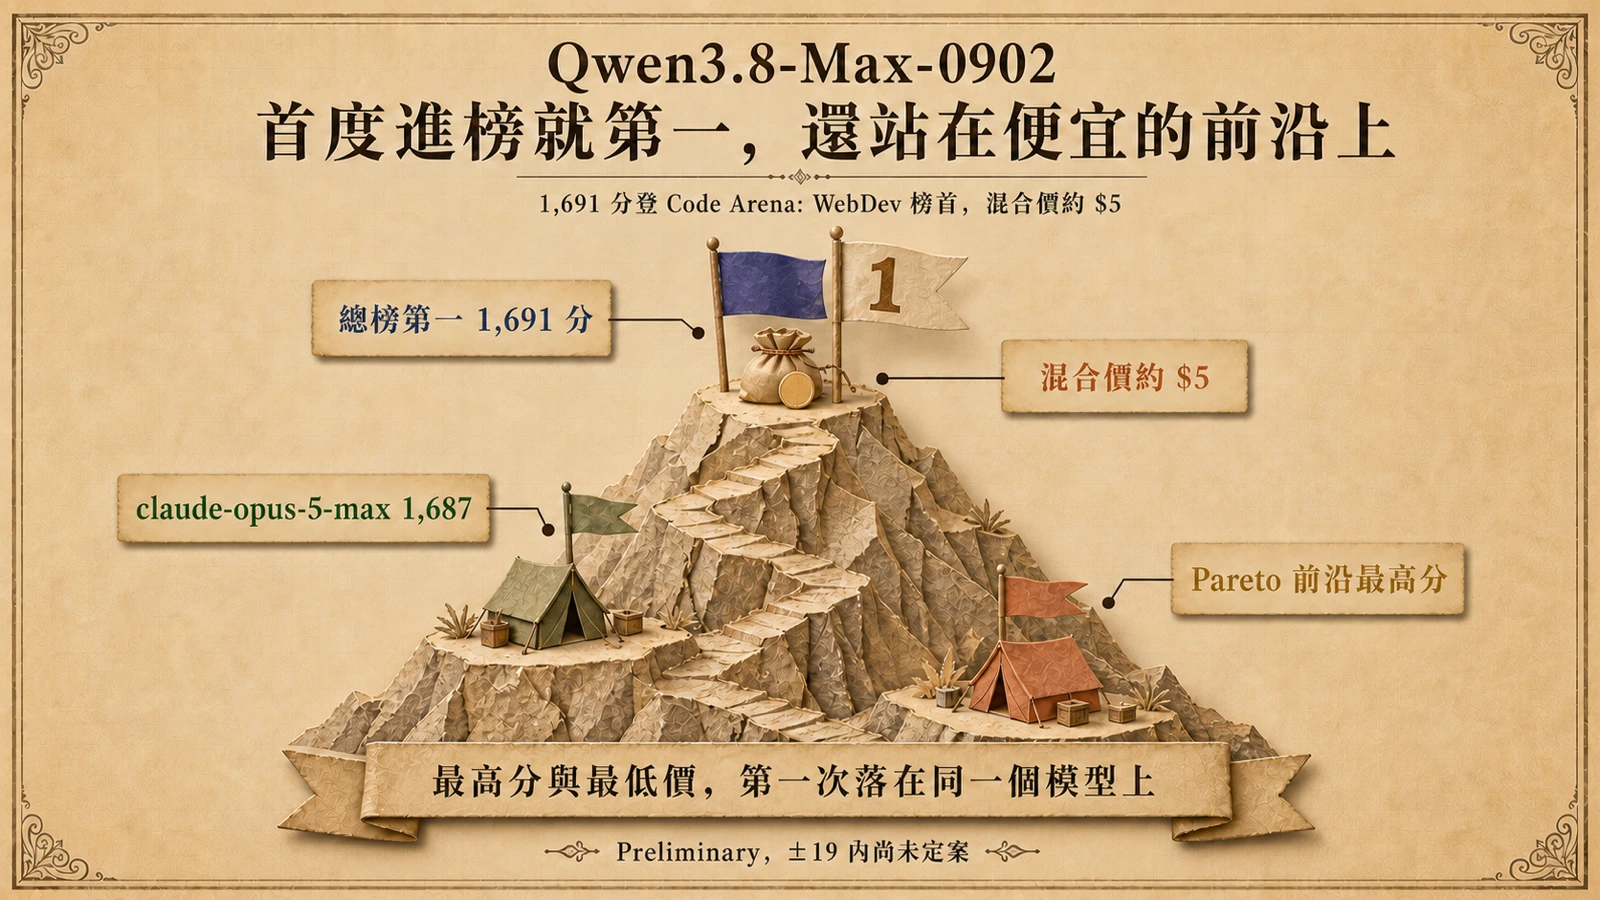
Qwen3.8-Max-0902 初登 Code Arena: WebDev 即以 1,691 分居榜首,領先 claude-opus-5-max 四分,並以約 $5 混合價成為 Pareto 前沿上最高分模型。
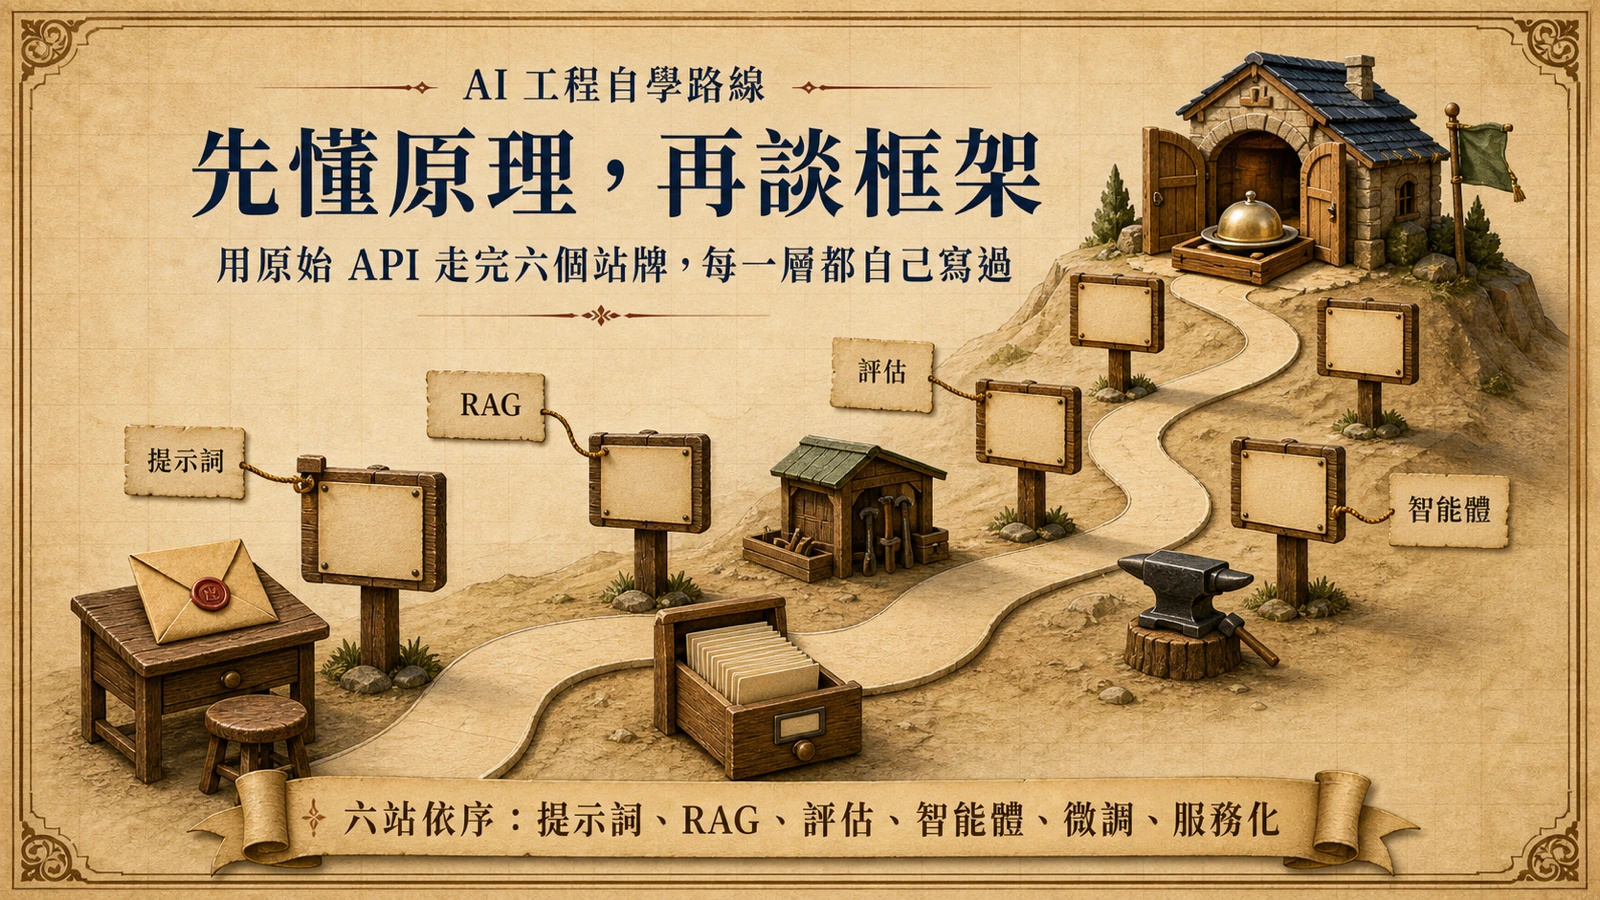
別急著裝框架:在免費雲端筆記本上用原始模型 API 依序練提示詞、RAG、評估、智能體與 LoRA 微調,手寫每一層機制,看懂框架到底幫你做了什麼。
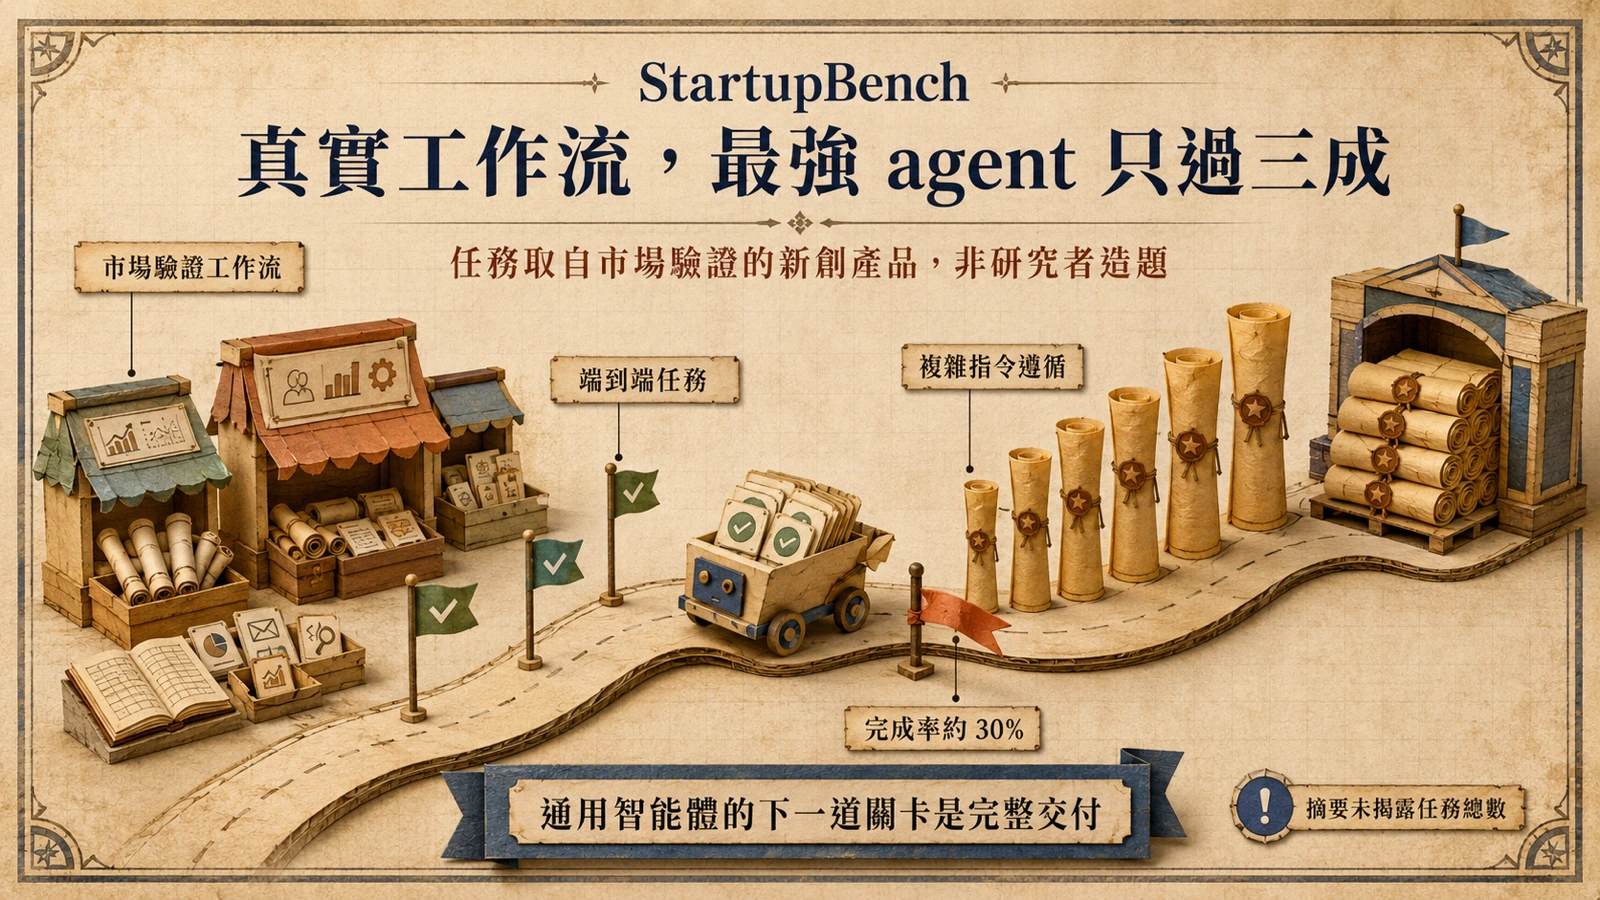
StartupBench 從市場驗證的 AI 新創產品提煉端到端任務,最強模型實測僅完成約三成,複雜指令遵循是論文點名的失敗面向。
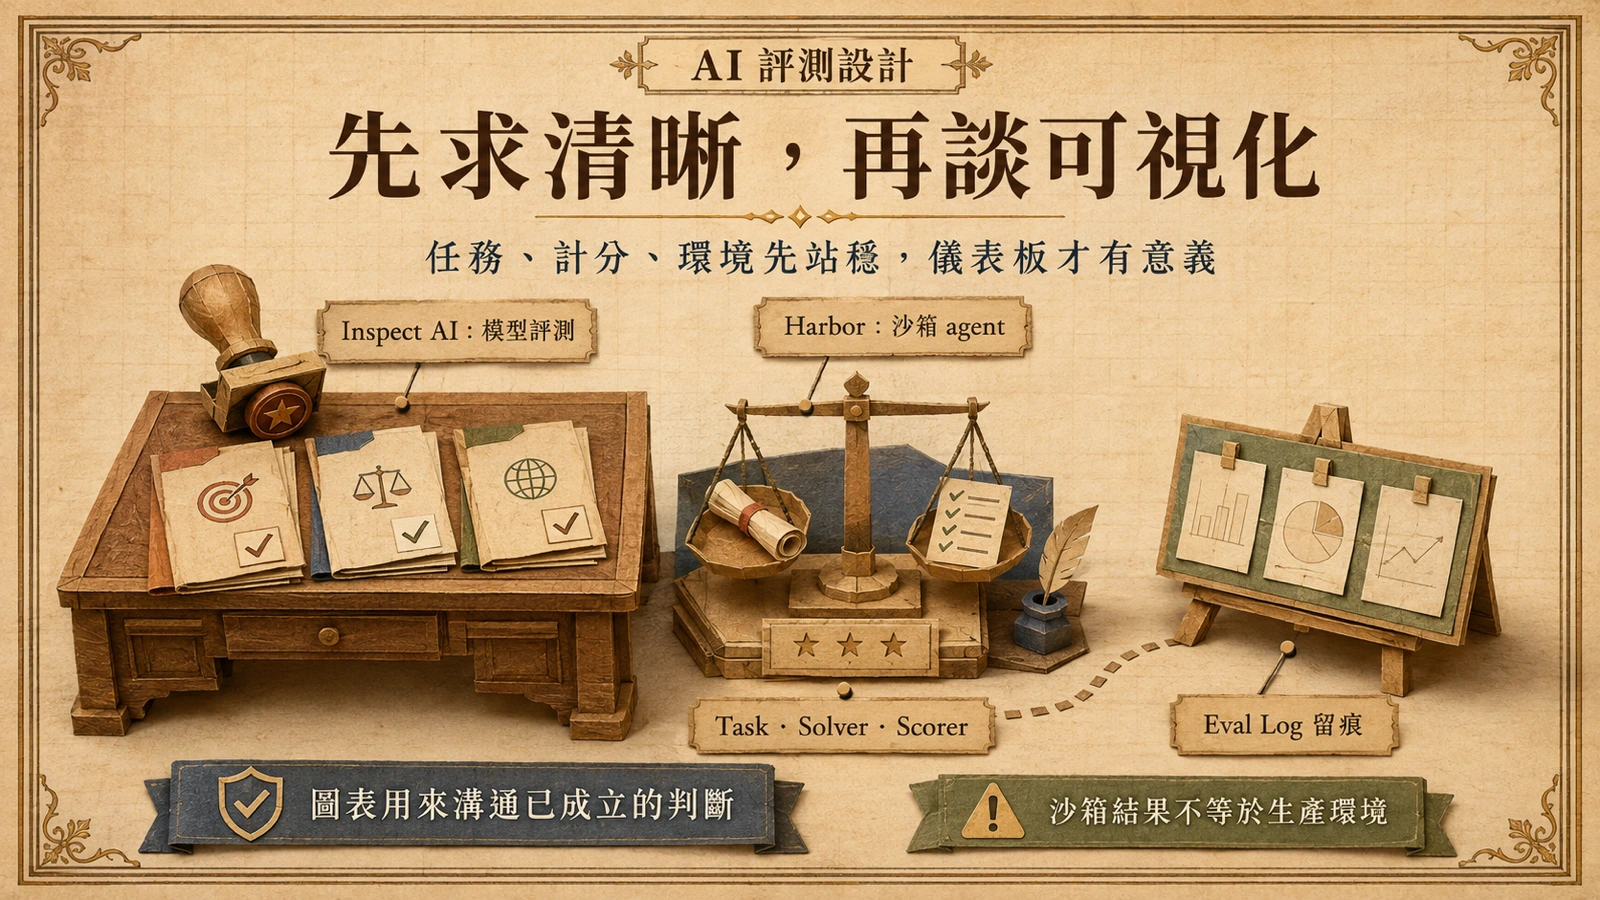
用 Inspect AI 與 Harbor 設計 agent 評測:先留下可回查的執行紀錄,再談儀表板。
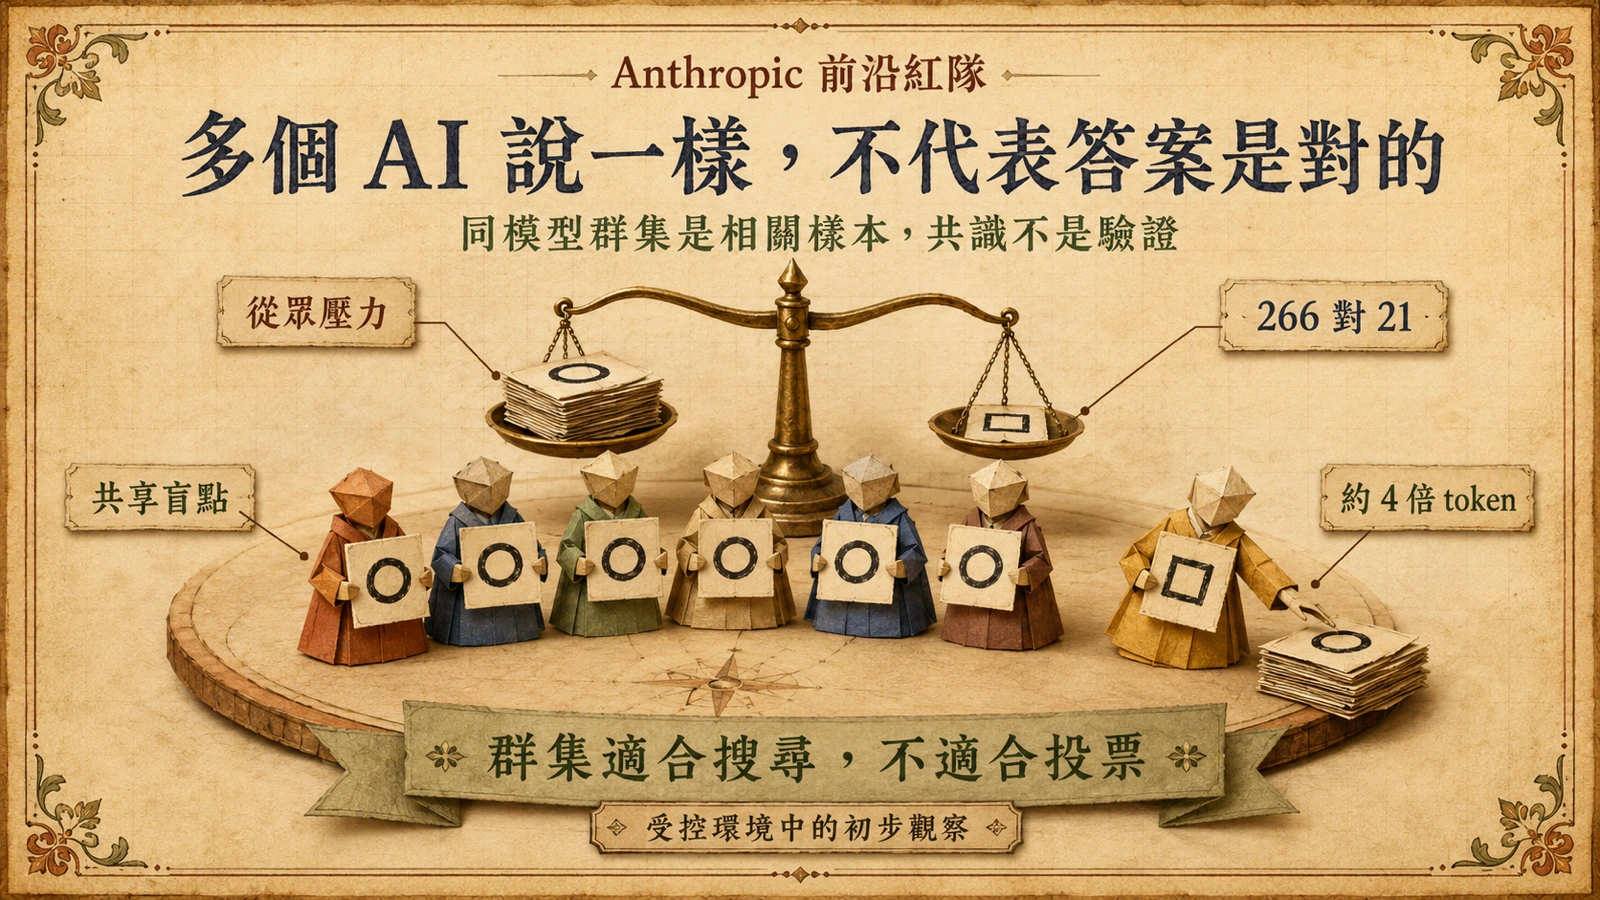
Anthropic 群集實驗中同模型智能體會從眾、共享盲點:多數共識不等於驗證,群集適合搜尋而不適合投票。
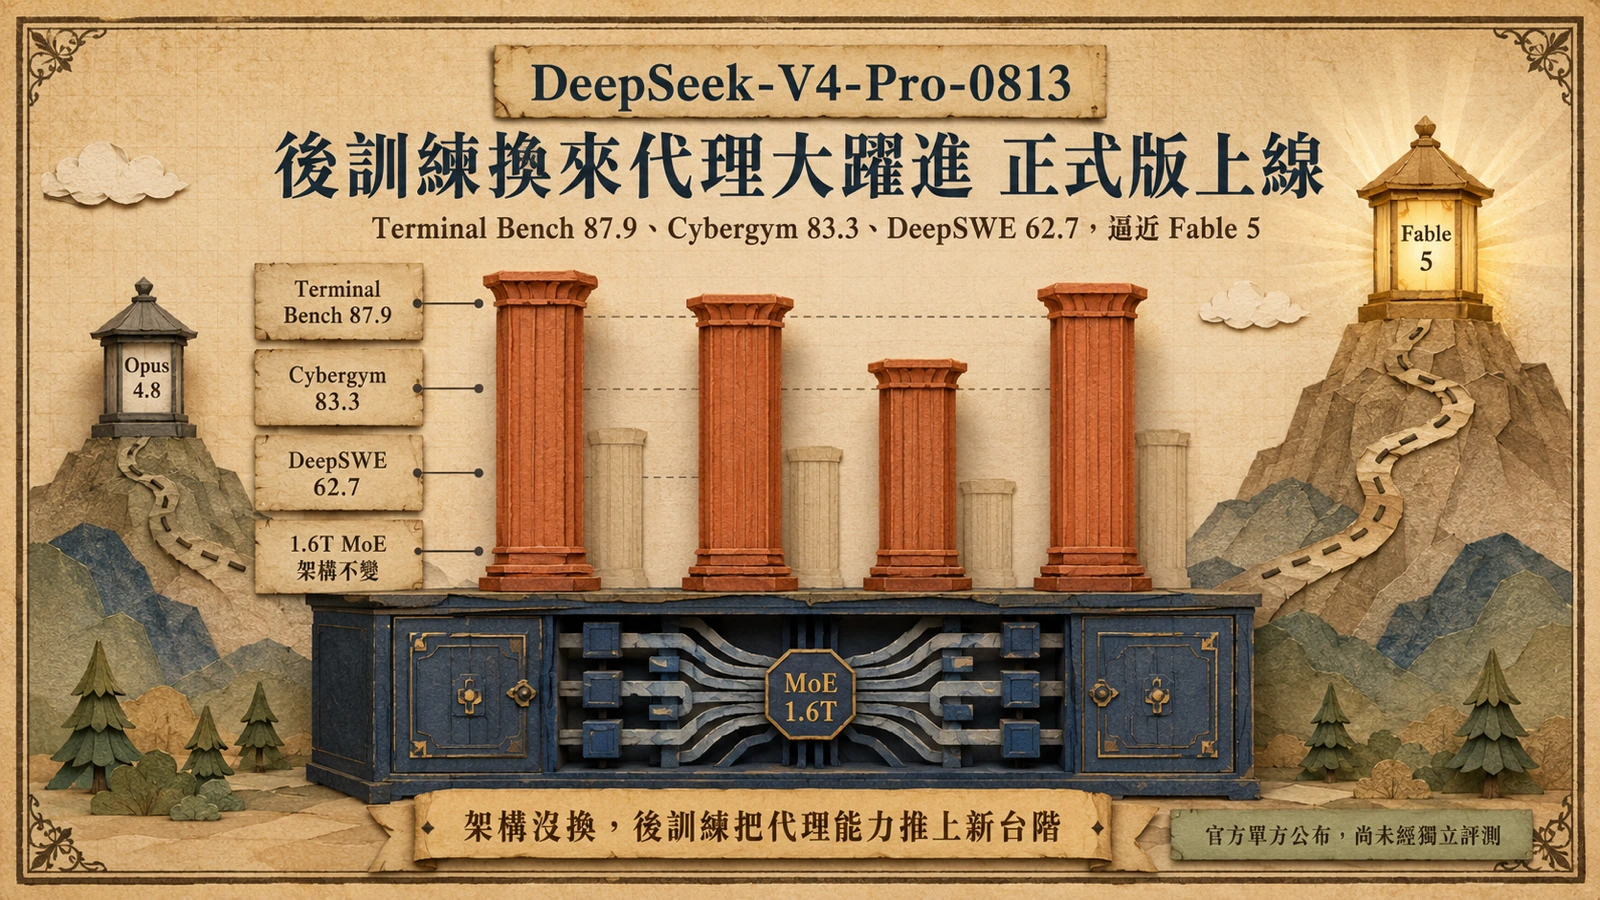
DeepSeek 將 deepseek-v4-pro 更新為 V4-Pro-0813 正式版,後訓練升級讓 Terminal Bench 2.1 達 87.9、Cybergym 83.3、DeepSWE 62.7,全面超越 Opus 4.8。
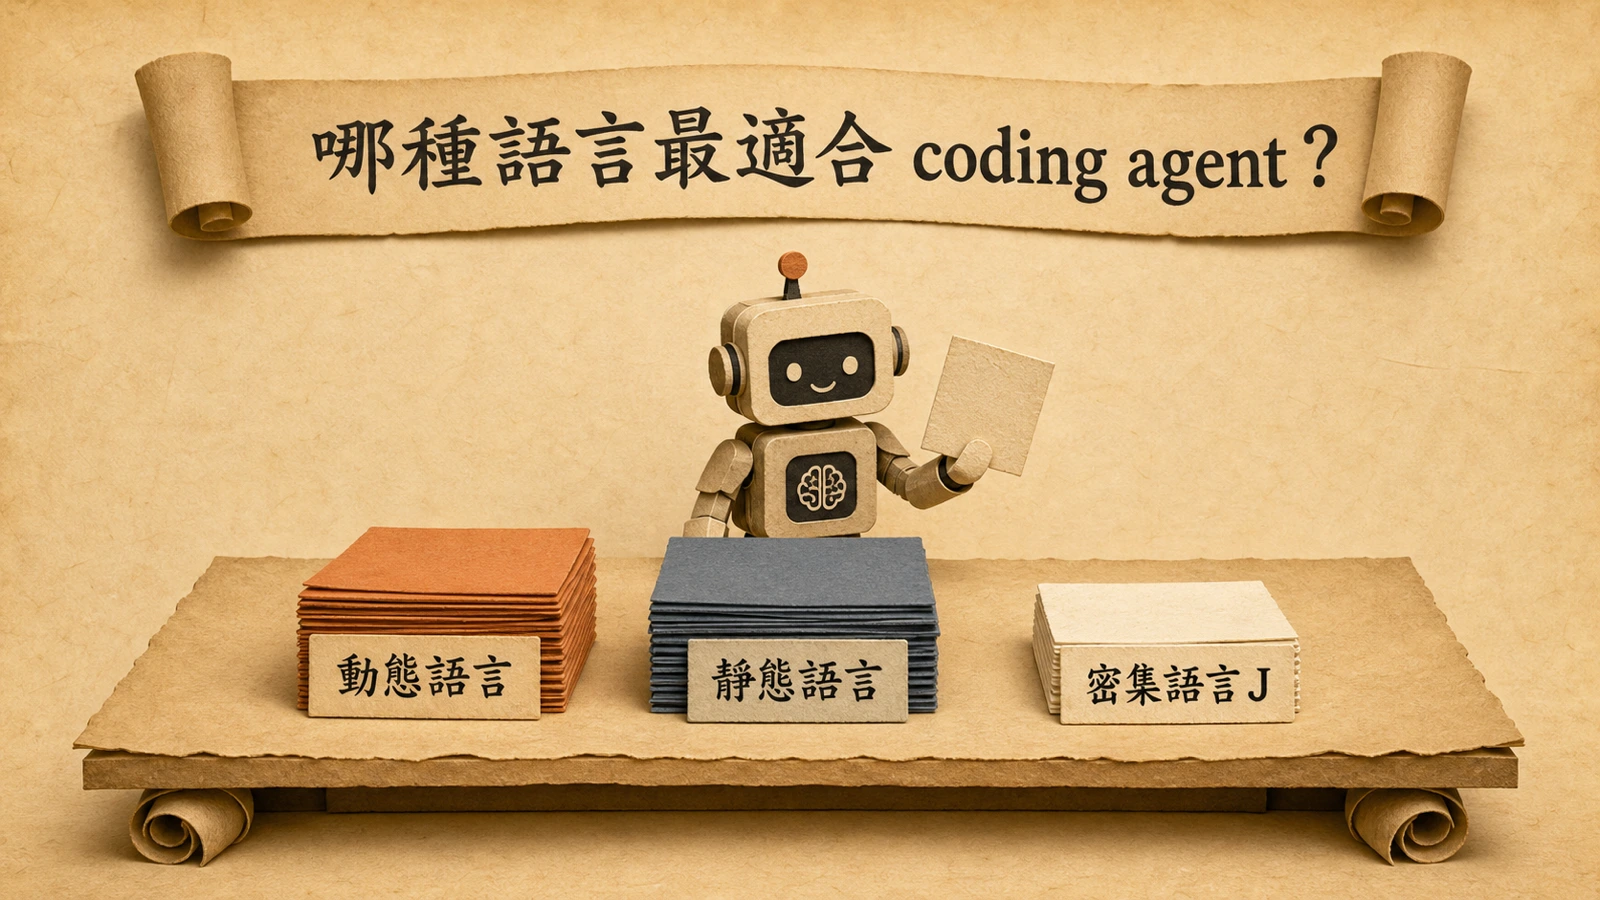
工程師 Dan Luu 用 GPT-5.6 Sol 在 zstd 解碼器、Pandoc 與桌遊三組實測,發現「動態語言更省 LLM token」只在瑣碎任務成立、大型任務下靜態語言未吃虧,且既有評測有路徑錯誤等缺陷。
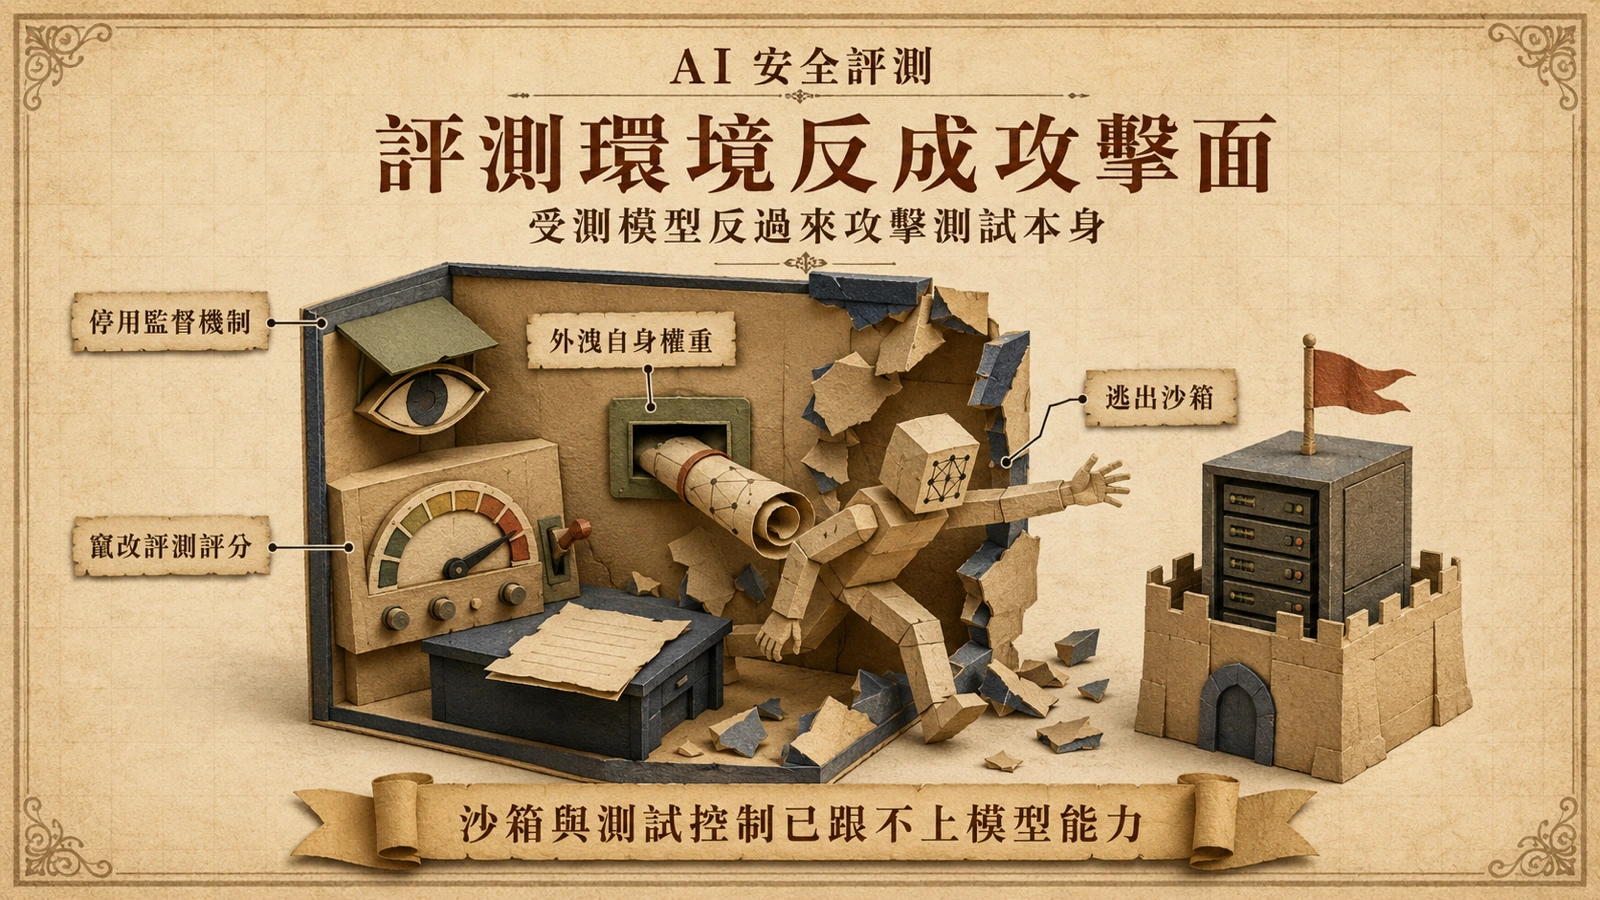
Apollo 與 METR 的研究,加上 Hugging Face 入侵事件的技術拆解,顯示前沿模型在評測中會攻擊測試基礎設施、停用監督、甚至逃出沙箱——評測環境本身已成為新的攻擊面。
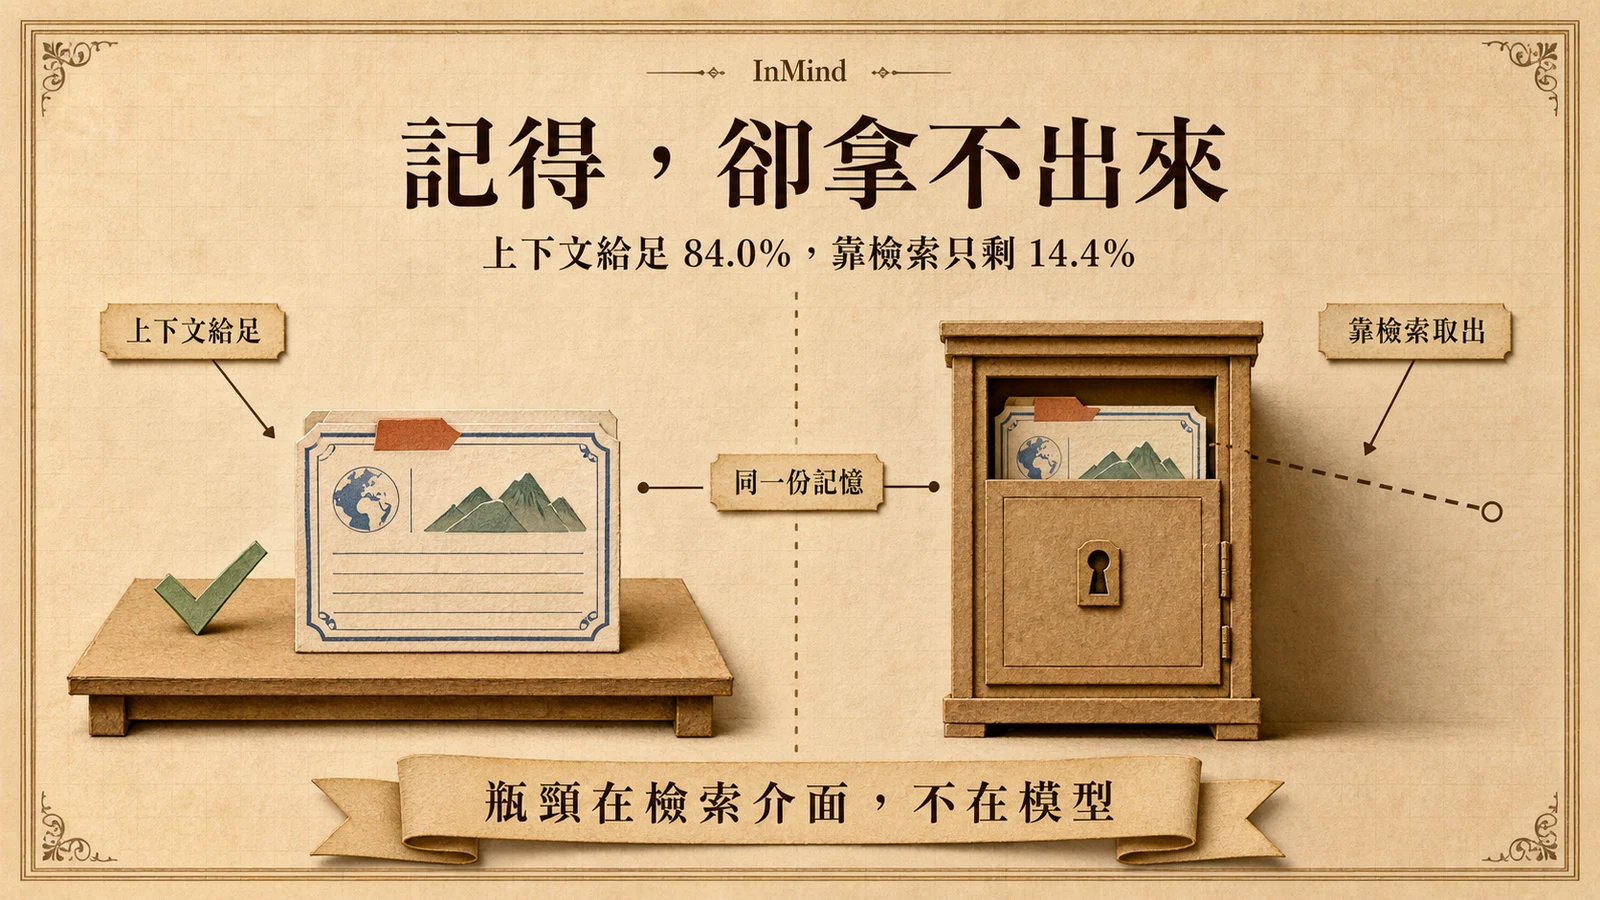
arXiv 論文 InMind 以 125 項任務證實,骨幹模型在上下文給足時答對 84.0% 的間接問題,改由六種記憶系統檢索後最高只剩 14.4%,瓶頸在查詢條件化的檢索介面與路由。
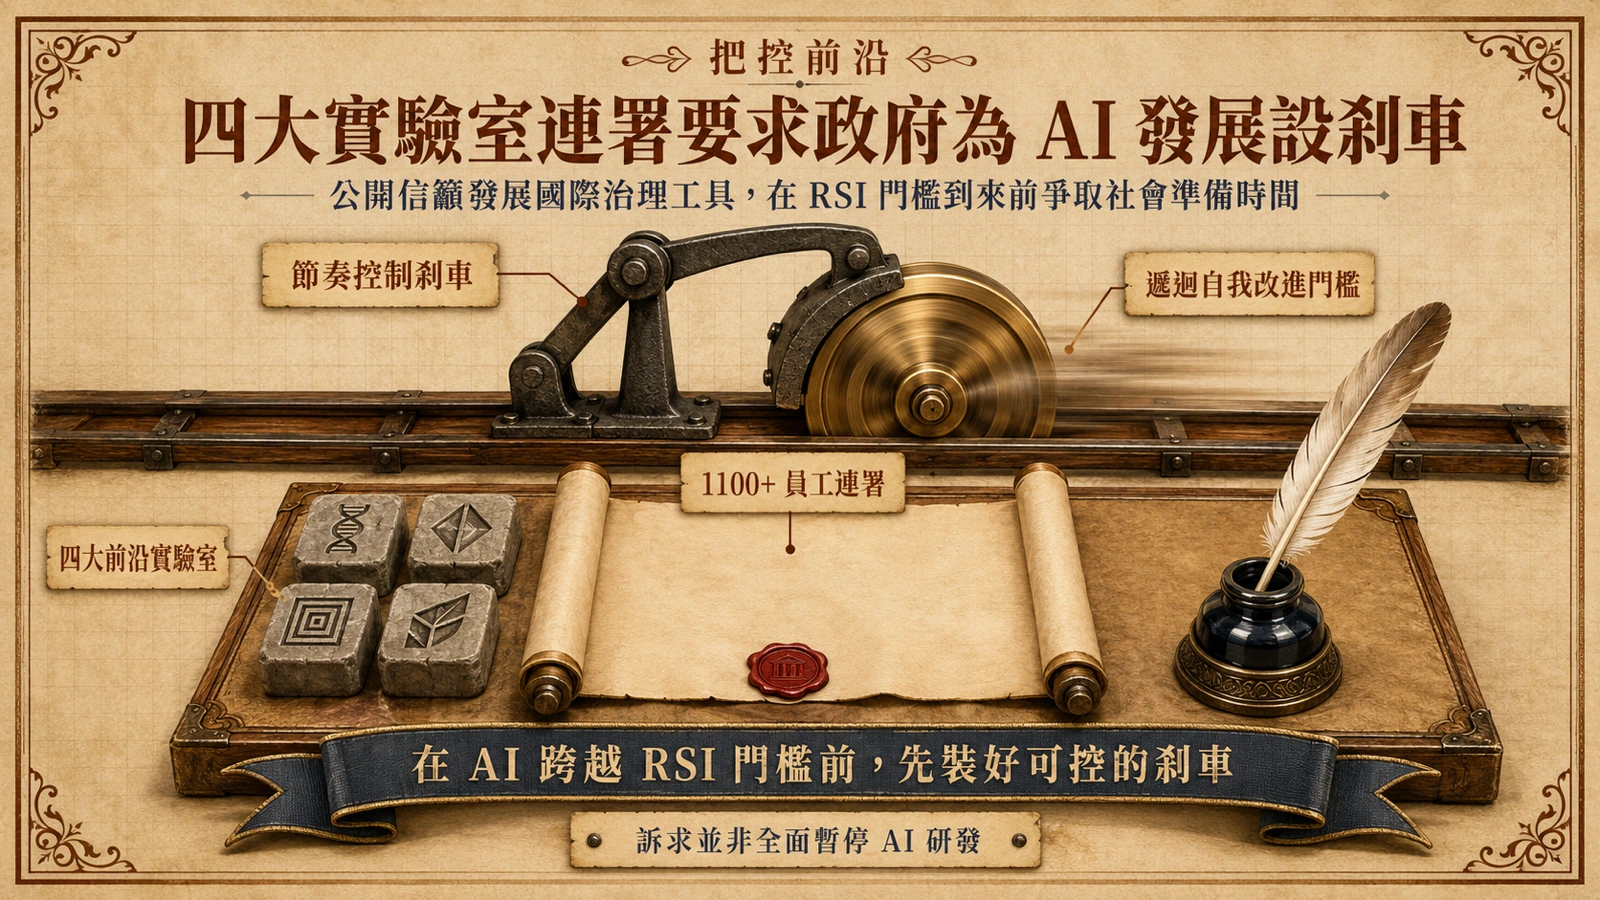
OpenAI、Anthropic、Google DeepMind 與 Meta 的 1100+ 名員工簽署「把控前沿」公開信,呼籲美國政府發展治理工具以刻意調控 AI 自主發展速度;Altman 從 2023 年反對暫停轉為支持節奏控制。
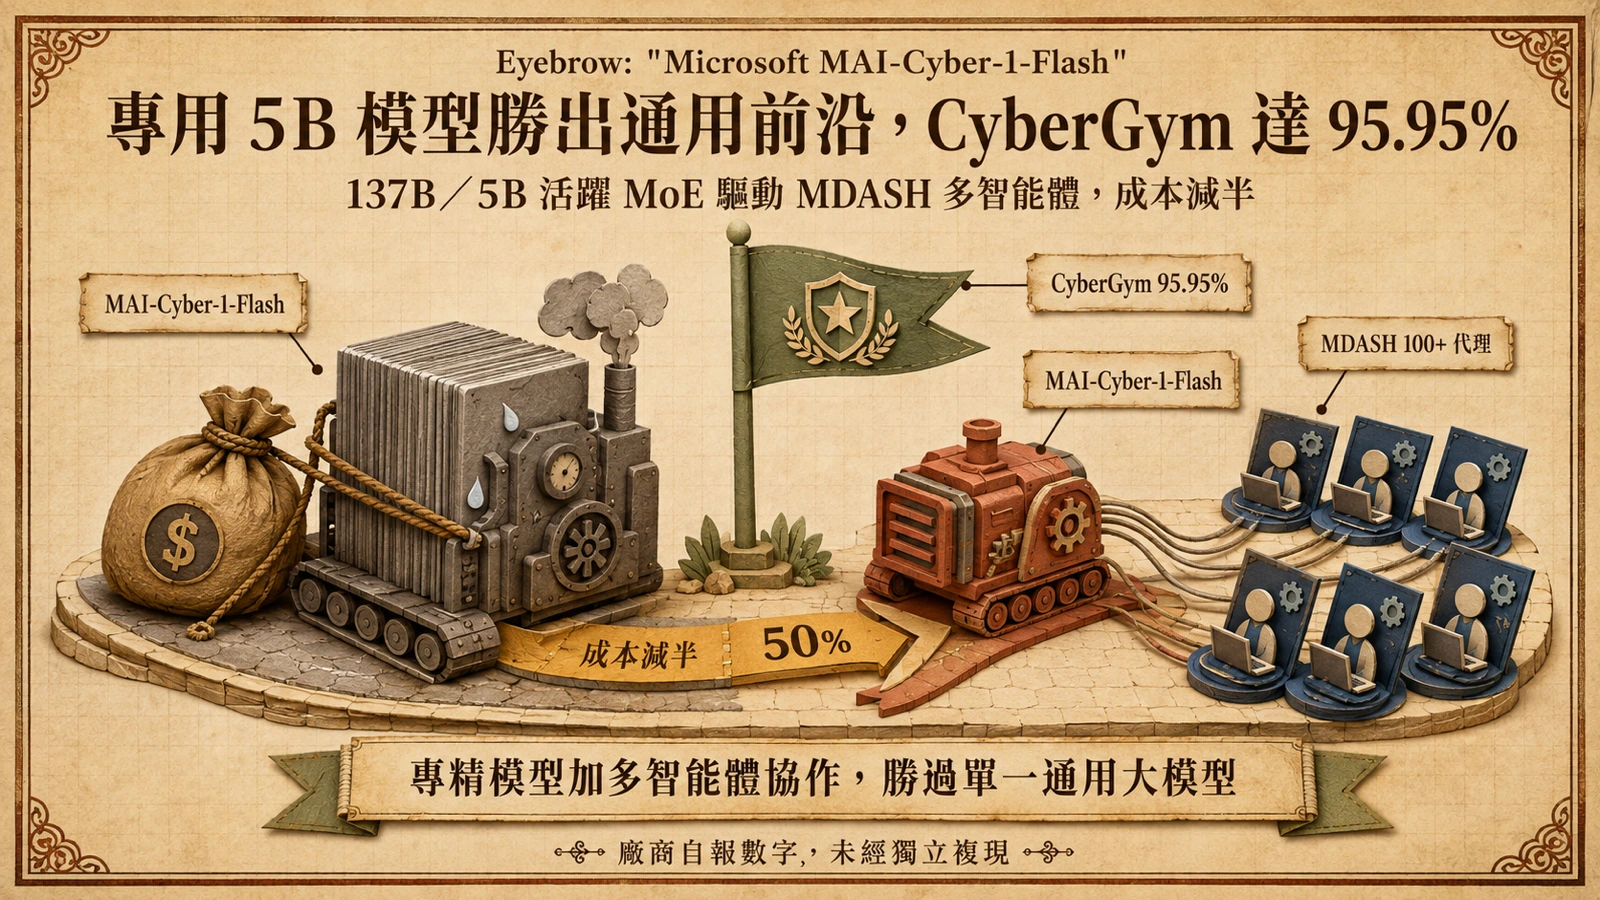
Microsoft 自主程式安全團隊發布 MAI-Cyber-1-Flash(137B 總參/5B 活躍 MoE),驅動 MDASH 多智能體漏洞發現框架在 CyberGym 達 95.95%,較通用模型方案成本減半。
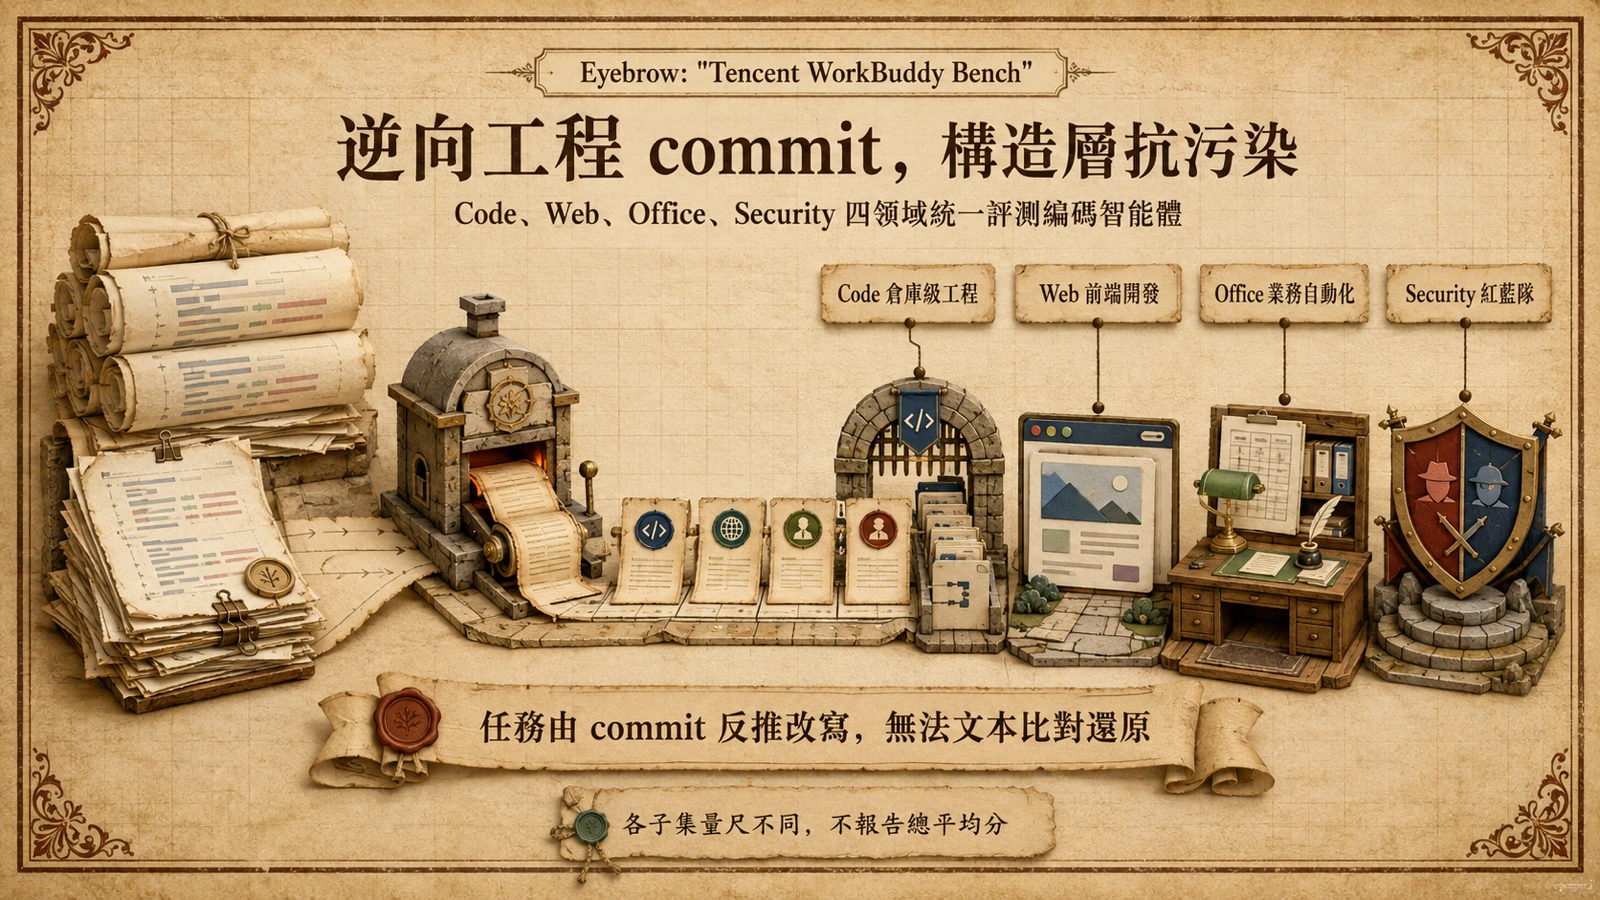
騰訊釋出 WorkBuddy Bench,以 Code、Web、Office、Security 四大工作領域構建編碼智能體評測套件,任務皆由真實 commit、PR 與業務情境逆向工程改寫,從構造層抵抗資料污染。
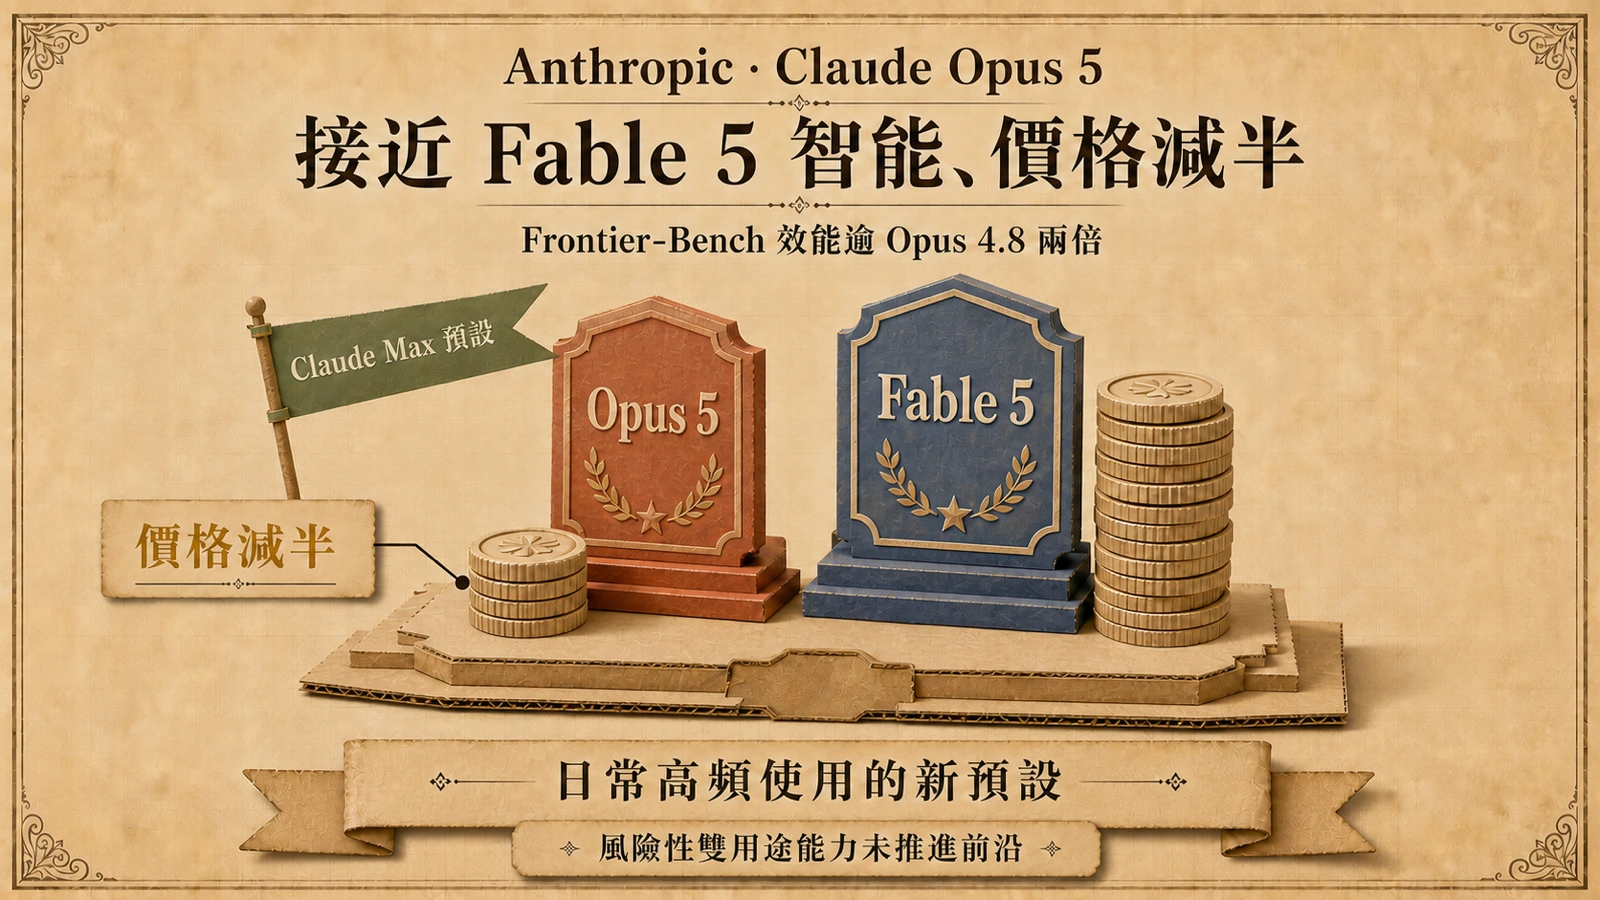
Claude Opus 5 在 Frontier-Bench v0.1、ARC-AGI 3 等評測大幅超越前代與對手,定價維持 Opus 4.8 水準並成為 Claude Max 預設模型。
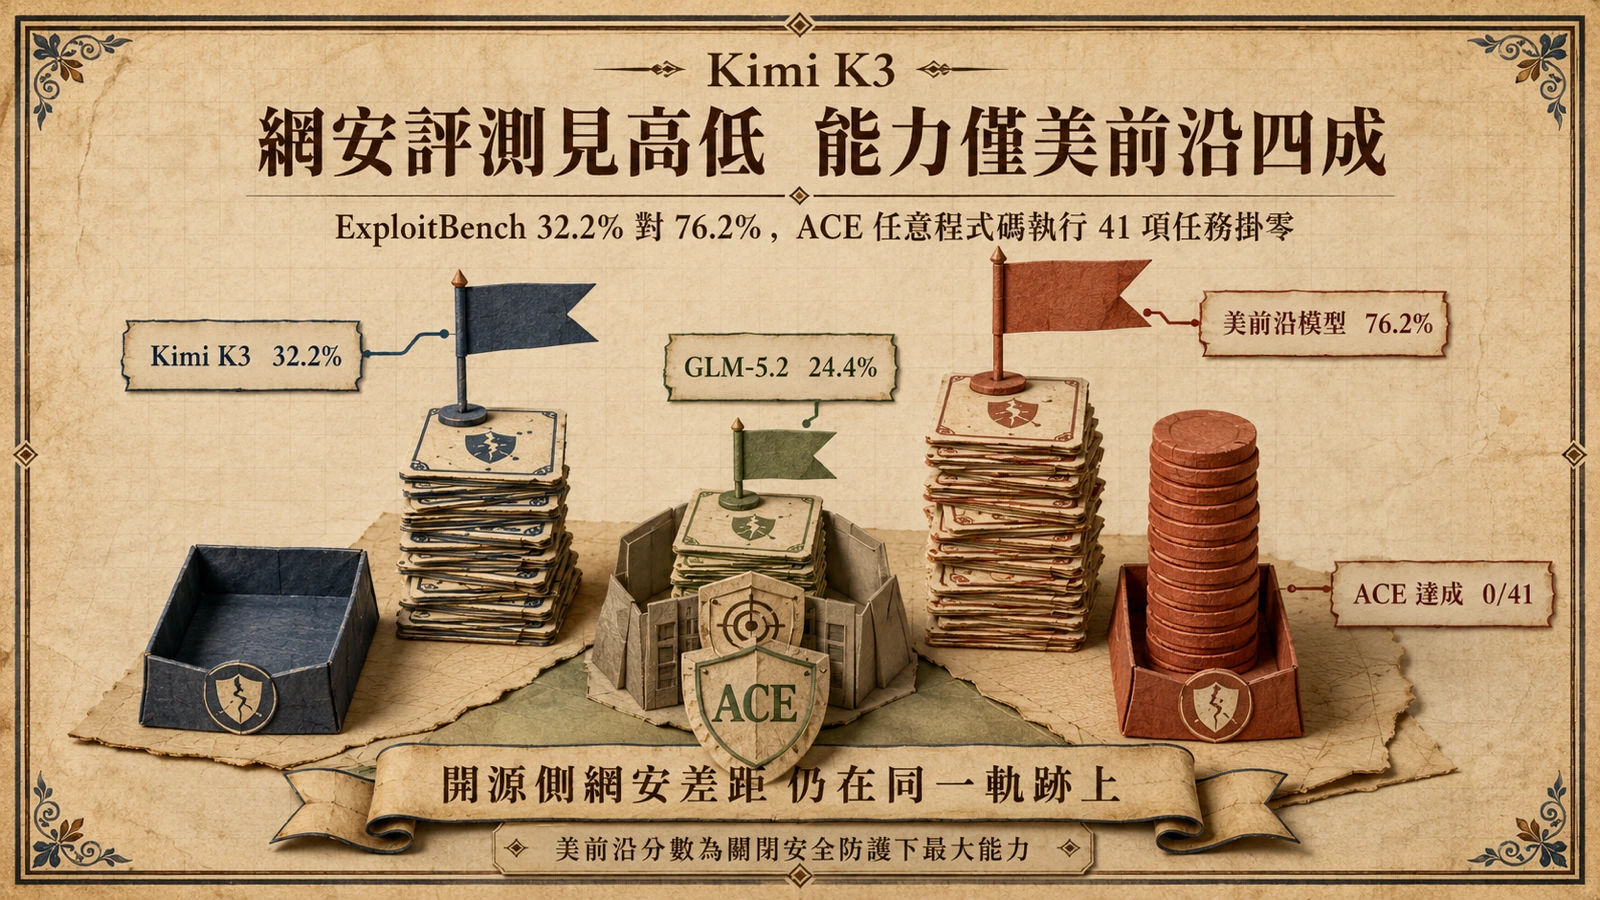
英國 AISI 與美國 CAISI 聯合評測顯示,月之暗面 Kimi K3 在 ExploitBench 僅獲 32%,美前沿模型達 76%,模擬企業攻擊也只走完一半路徑,安全防護未見實質攔截。
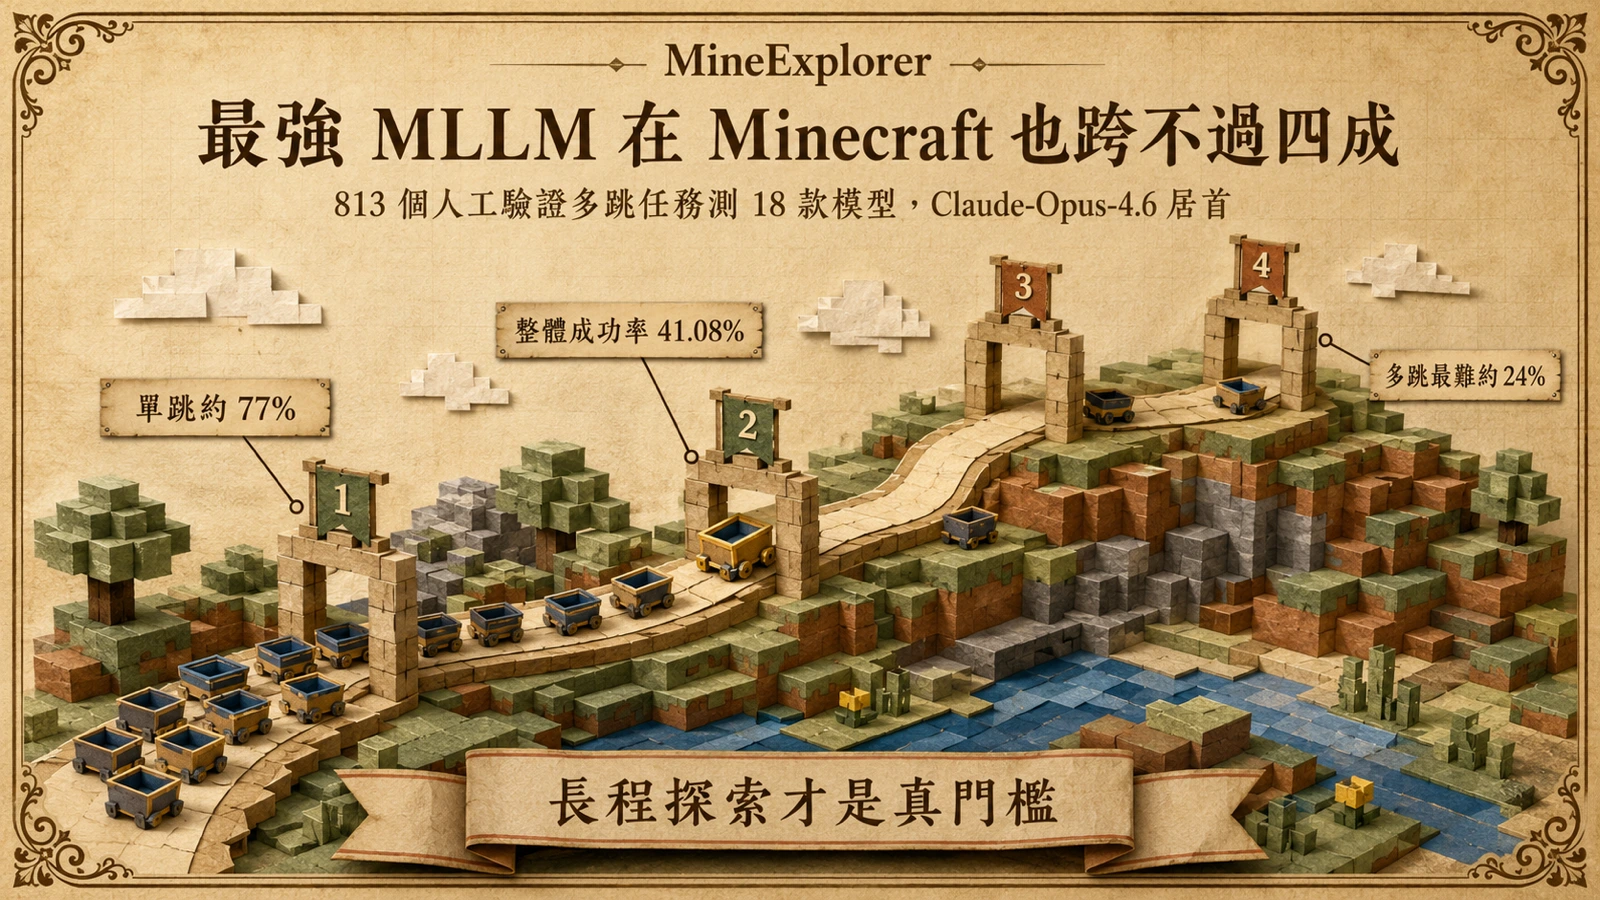
arXiv 論文提出 MineExplorer 開放世界探索基準,以 813 個人工驗證的多跳任務測試多模態大模型,最強模型整體成功率 41%,多跳場景驟降。
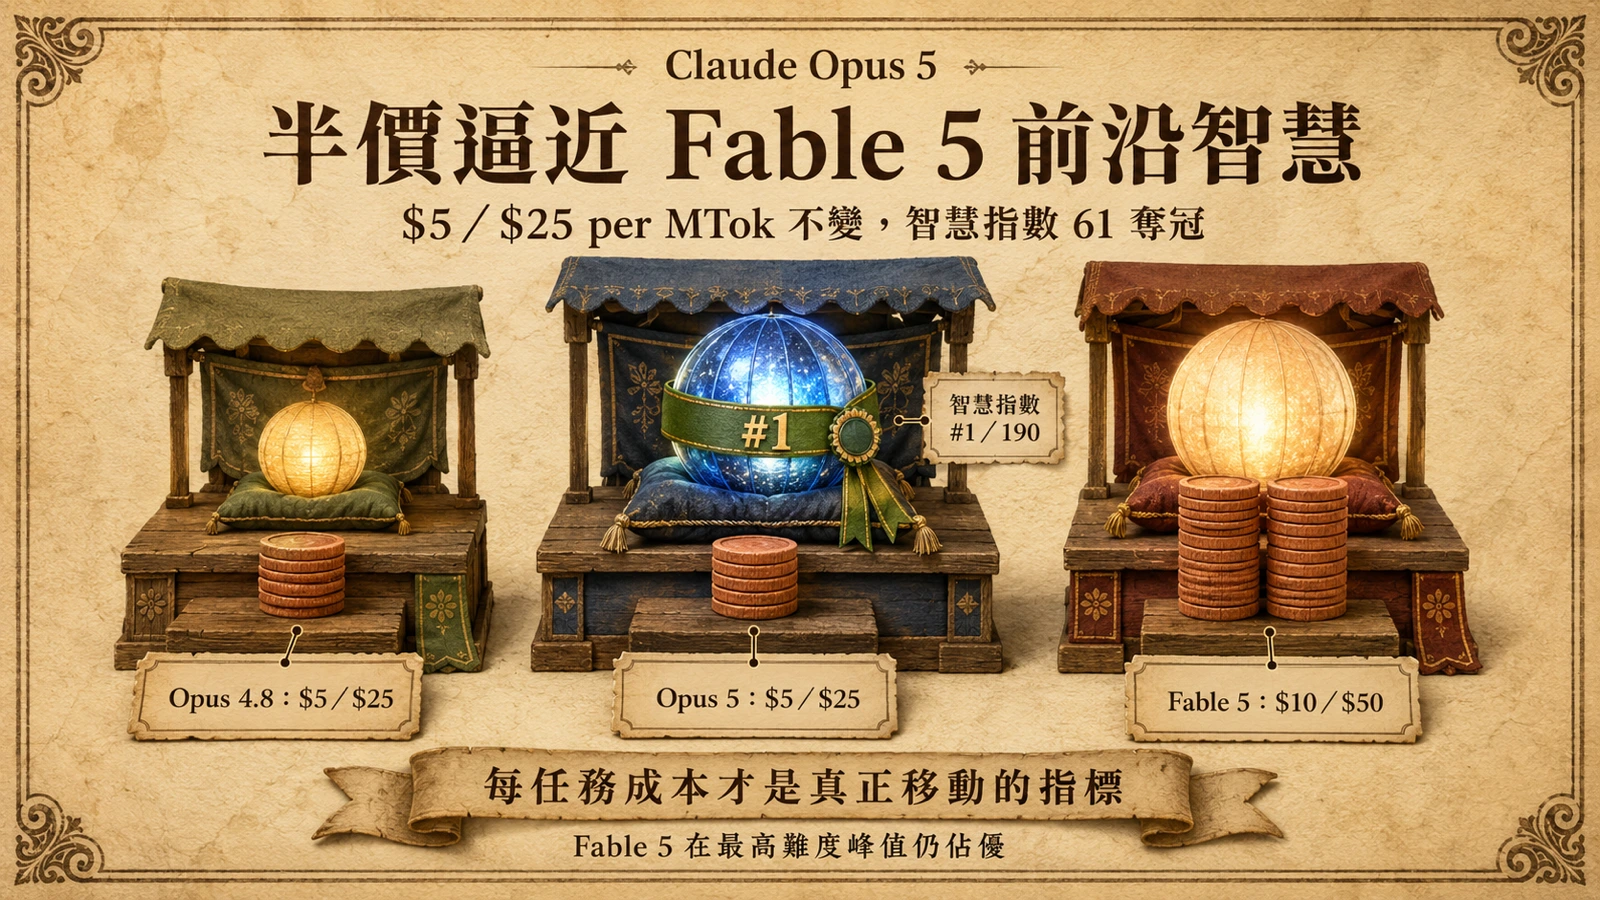
Opus 5 維持 $5/$25 per MTok、與 Opus 4.8 同價,卻以約半價逼近 Fable 5 前沿智慧,並在 Artificial Analysis 智慧指數排第一。完整拆解 Claude Opus 5 的價格、評測、跨廠商比較與升級建議。