語音模型為什麼需要一張統一計分板
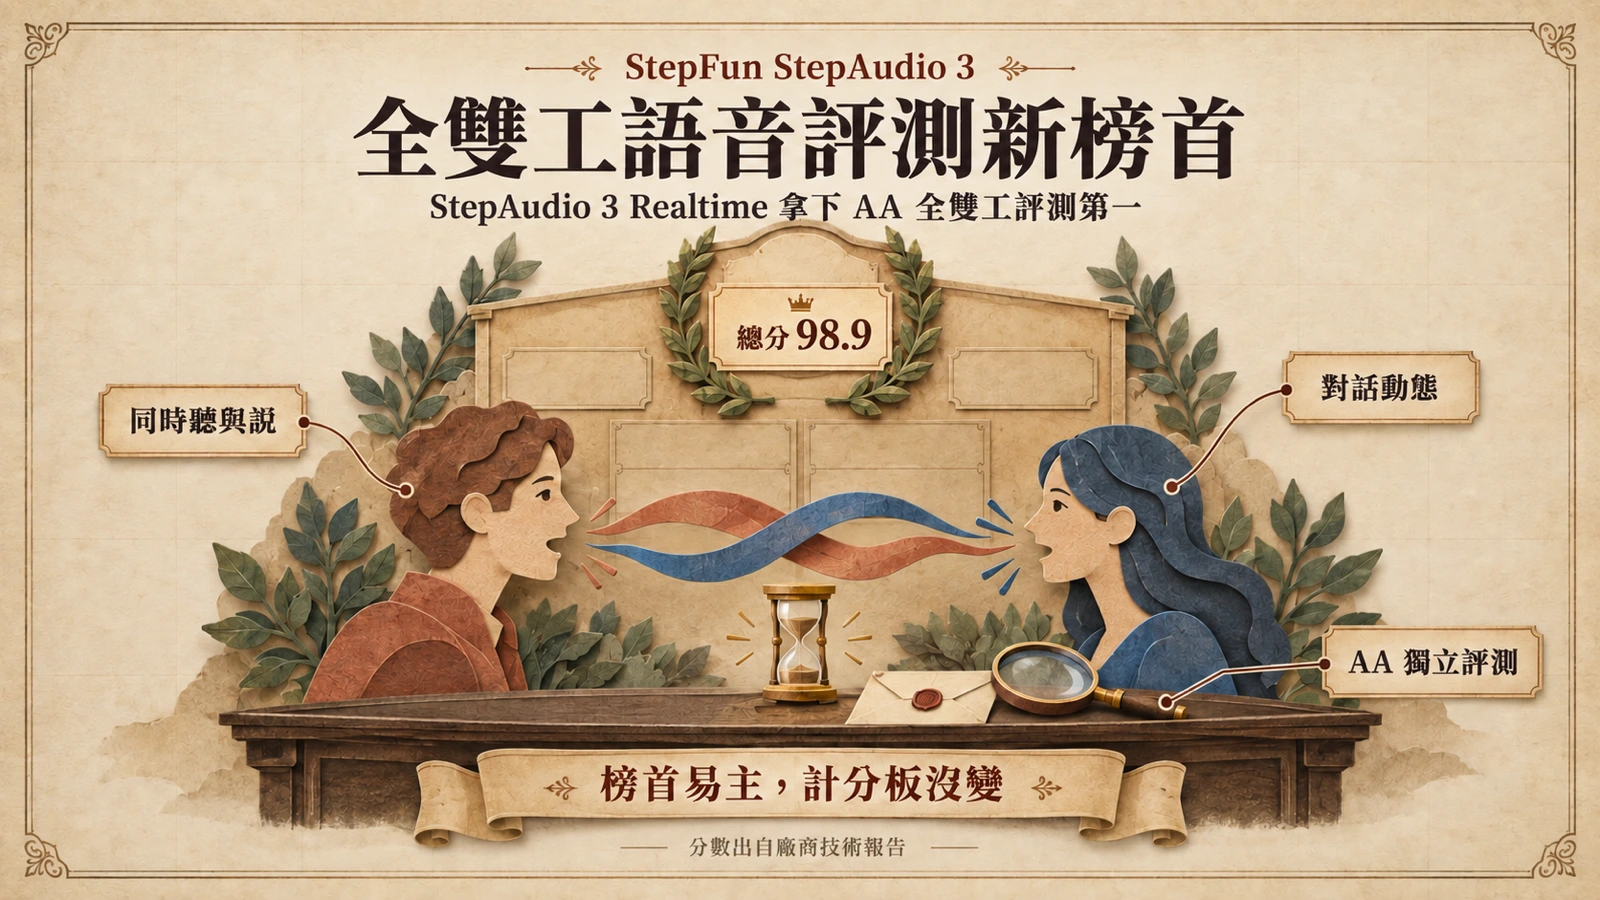
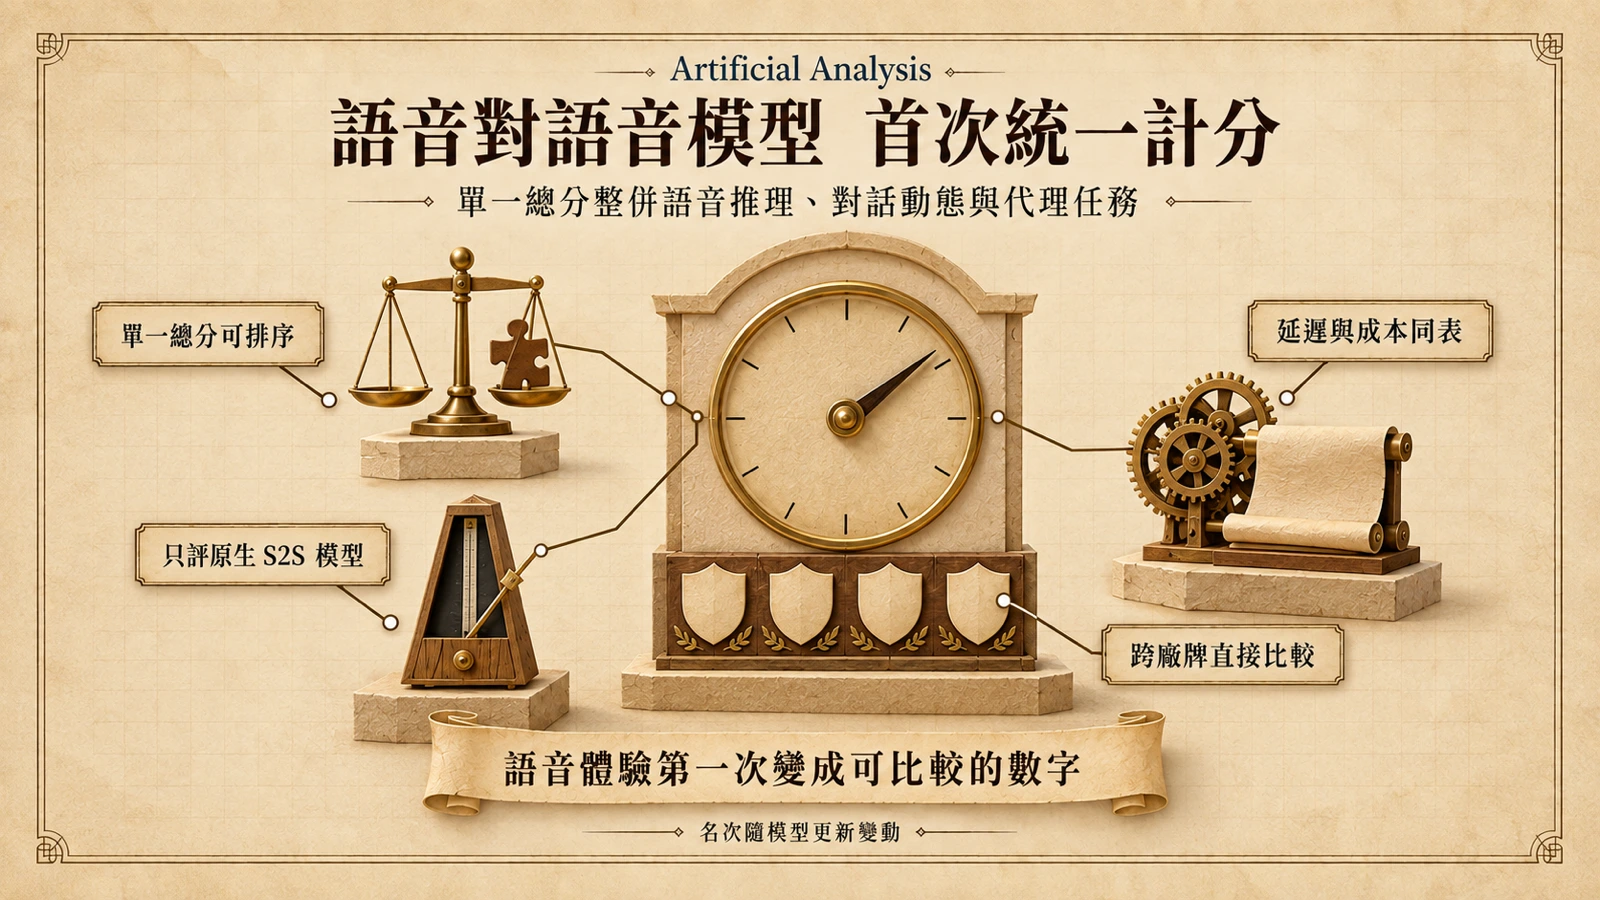
挑選語音模型的團隊都遇過同一種碎片感:A 家公告主打辨識準確率、B 家主打每分鐘價格、C 家主打「聽起來更像真人」,指標各自表述,數字之間沒有換算公式。文字模型的世界早有大量跨廠排行榜可以互相印證,語音對語音這一端卻長期缺一張能直接排序的總表。獨立評測機構 Artificial Analysis(以下簡稱 AA)近日發布的說明寫得明白:Speech to Speech Index 要為原生語音對語音模型的表現提供單一衡量,評測項目從語音推理(Big Bench Audio)起手。
值得先注意的是「單一衡量」四個字。語音模型的強弱向來難以比較,因為「好聊」同時包含智力、節奏、任務能力與成本等多個面向,任何單一面向的數字都以偏蓋全。把它壓成一個指數,等於承認使用者需要的不是某個子分數,而是一個可以跨廠牌排序的共同刻度。這正是文字模型評測走過的路:先有單一智慧指數,才有一致的選型討論語言。語音端補上這一步之後,「哪家比較好」的討論第一次有了共同的參照系。
指數怎麼算:七個欄位看懂一場對話
打開 AA 的榜單頁,表格本身就是一份說明書。每一列是一家供應商的一個模型配置,先給一個 Speech to Speech Index 總分;扣掉廠牌、模型名稱與作為結果的總分,真正要看懂的是七個欄位——五個品質分項:語音推理(Speech Reasoning,採 Big Bench Audio 子集)、對話動態(Conversational Dynamics)、代理表現(Agentic Performance)、競技場偏好(Arena Preference,以 Elo 計)、任務成功率(Task Success Rate),再加上兩個營運數字:首音延遲(Time to First Audio,秒)與每小時音訊輸入成本(美元)。
把欄位翻成白話,一場語音對話的成績單是這樣讀的:語音推理測「用耳朵答題」,直接聽題目、口頭作答,不經文字轉接;對話動態看輪替與打斷,能不能自然接話、被搶話時如何收場;代理表現與任務成功率測「辦事」,打電話查資料、改訂單、呼叫工具,最後有沒有把事情做完;競技場偏好是真人盲測對決累積出的偏好分數,補上儀器測不出來的聽感。首音延遲決定使用者等待的第一印象,每小時成本決定這條產品線算不算得過來。
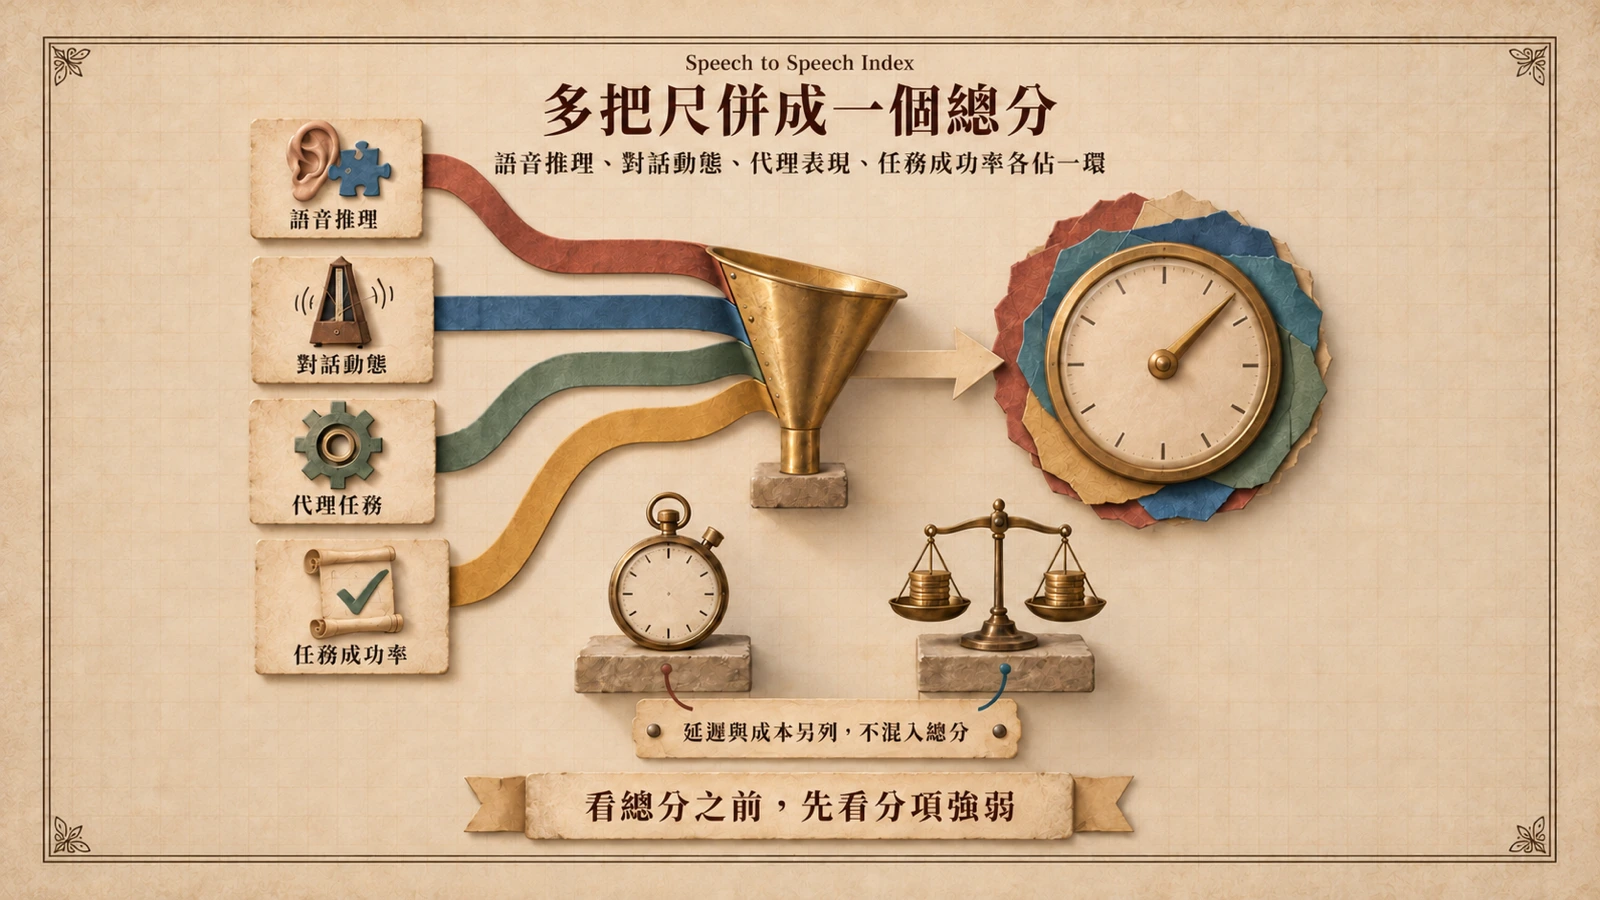
這組欄位的設計透露了一個判斷:2026 年的語音模型競爭,已經不只是「念得自然」,而是「聊得下去、辦得成事、付得起帳單」。把推理、節奏、任務、成本放進同一張表,等於把整條語音產品線的單位經濟攤在陽光下。
只評原生語音對語音:串接管線不在榜上
指數的受測資格寫得很清楚:只評原生語音對語音模型,聲音進、聲音出,中間不拆站。這個限定本身就是訊號。過去主流的語音代理是串接管線:語音辨識先把聲音轉成文字,語言模型生成回覆,語音合成再念出來,三站各計各的延遲與費用,輪替要靠外掛邏輯去猜。原生模型把整條路收進一個模型裡,聽、說、停頓、打斷都由同一組參數決定。
兩條路線在業界文件裡也壁壘分明。OpenAI 的開發者文件就把 Realtime API 定位為打造語音對語音代理的方案,模型直接處理聲音、維護對話狀態並可呼叫工具;GPT-Live 走的則是全雙工互動層加後端推理的組合。開源陣營同樣往原生路線靠攏,NVIDIA 已開源支援工具呼叫的全雙工語音模型。受測資格排除串接系統,不代表串接一定落後,而是兩者根本不在同一個競技場:指數量測的是「模型本身是一場對話」,不是「三個零件串成一條生產線」。
全雙工與後端委派:這波語音模型的共同架構
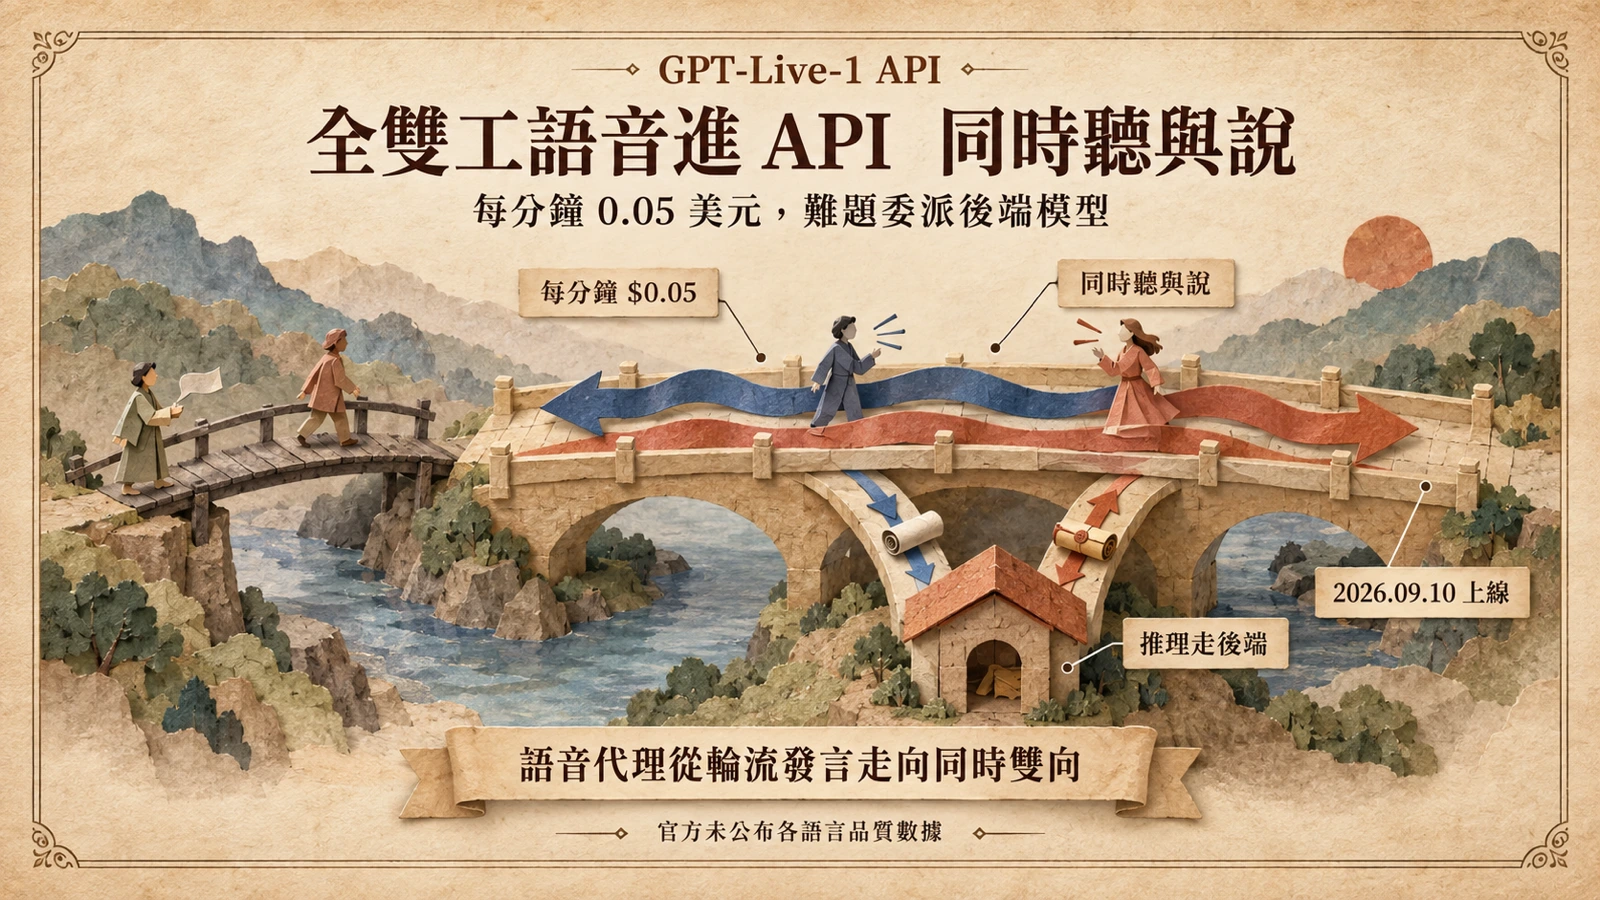
要讀懂這張榜單量的是什麼,得先看這波語音模型的共同架構。OpenAI 七月讓 GPT-Live 進駐 ChatGPT Voice 時說明,它建立在全雙工架構上,可以一邊聽一邊說:對話中用「mhmm」「yeah」這類短回應表示還在聽,能快速一來一往,也能在你需要思考時安靜等待。上線當時的後端是 GPT-5.5,官方並預告會隨新模型發布持續更換。
「後端是誰」因此成了新的配置變數。語音層顧節奏,難題外包給推理模型,推理模型的強弱與計價就會直接寫進語音體驗的品質與帳單。AA 自己的評測提供了具體參照:在 Artificial Analysis Intelligence Index 裡,GPT-6 Astra 以約四成的每任務成本追平 Claude Fable 5.1,並比 GPT-5.6 Sol 高出 6 分。換句話說,同一個語音互動層搭配不同後端,答題品質與成本結構都會改寫,這也是看語音榜單時,模型配置比模型名稱更值得細看的原因。GPT-Live-1 已於 9 月 10 日進入 API,計價每分鐘 0.05 美元,這類託管方案的帳單結構,正好和榜單上的每小時音訊成本欄位互為對照。
從 TTS 競技場到 S2S 指數:AA 的語音評測版圖
Speech to Speech Index 並不是 AA 在語音端的第一步。更早之前,AA 已用 Speech Arena 盲測 Elo 替文字轉語音模型排序,阿里巴巴的 Qwen-Audio-3.0-TTS 就曾以 Elo 1234登上該榜首位。加上文字端的智慧指數與編碼代理指數,這次的新指數補上「模型自己開口對話」的最後一塊拼圖,讓 AA 的評測體系橫跨文字、語音合成與語音對話三個戰場。
學界也在補位。arXiv 上的 τ-Voice 論文提出以真實世界複雜度的落地任務評測語音代理,與產業端指數形成互補:產業指數追求跨廠可比較的單一刻度,學術基準往任務真實度與可重現性深挖。兩條線同時推進,說明評測基礎設施正努力追趕模型迭代的速度——對依賴第三方數字做決策的團隊來說,這是比任何單一排名都重要的趨勢。
延遲與成本同表:開發者選型的新依據
這張表對開發者最實際的改變,是選型流程可以收斂。過去評估語音方案要向三家供應商各要一份資料,再把不同口徑的數字手工對齊;現在品質分項、首音延遲與每小時成本在同一列上,可以直接按場景畫權重:電話客服型應用先看首音延遲與成本,使用者等不了太久,帳單又隨通話時長線性成長;陪伴與會議型應用先看對話動態與競技場偏好,聊得自然比答得快重要;辦事型代理先看任務成功率與代理表現,查得到、訂得到、改得動,才是真本事。
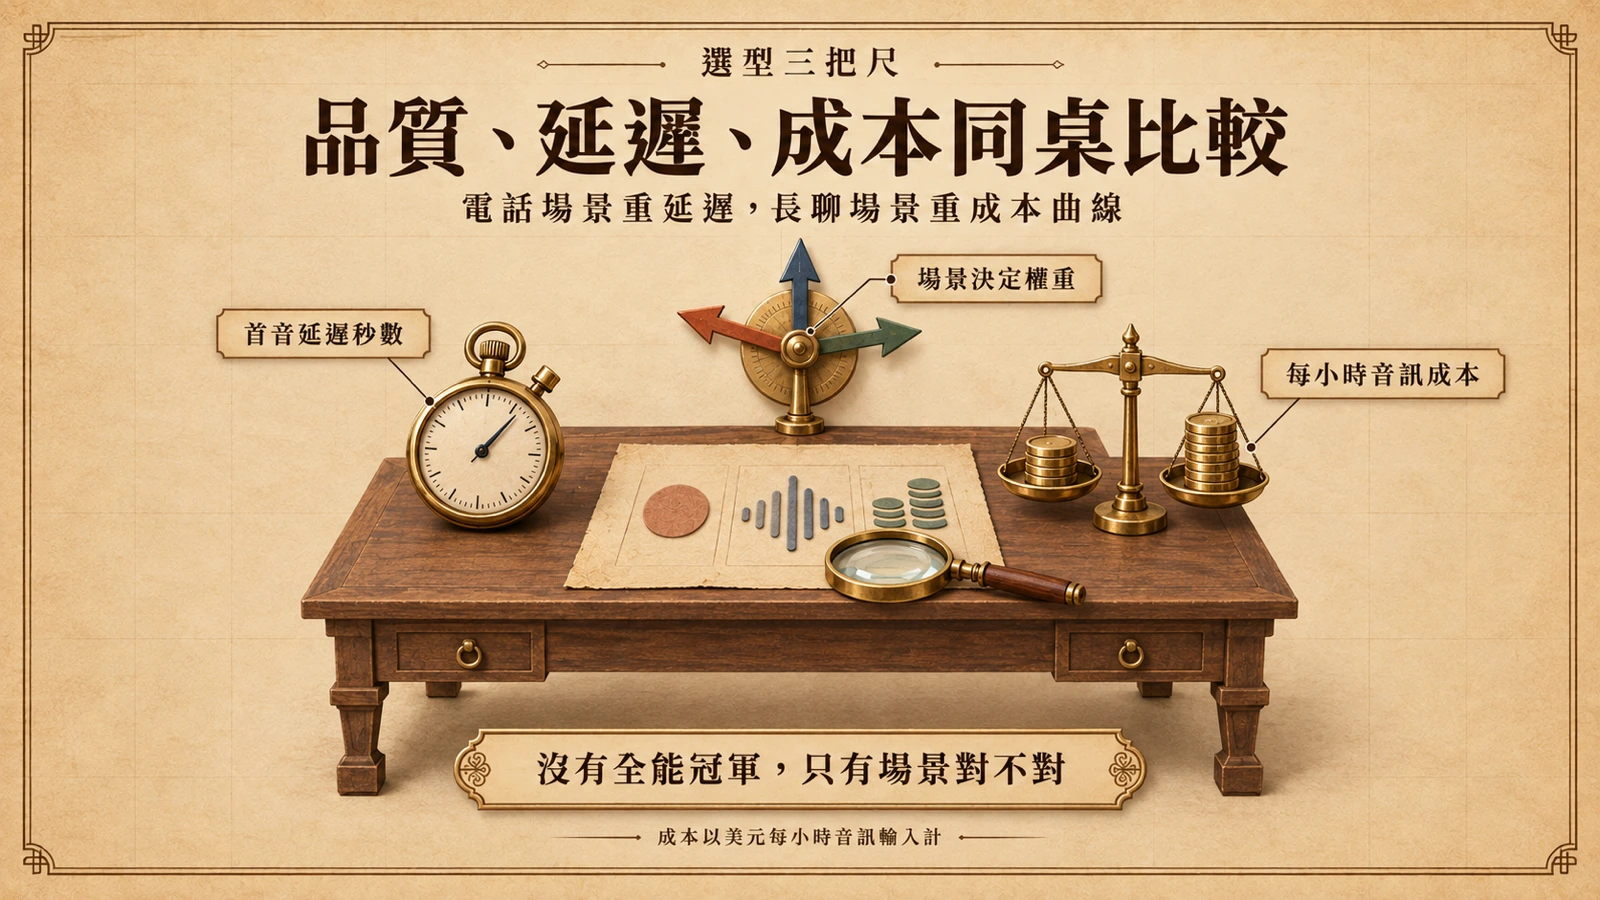
成本欄位的單位也值得留意:以每小時音訊輸入的美元價格計,對應的是「按通話時長付費」的世界。長時間掛線的產品要先把這條曲線算進單位經濟,再談體驗升級;反之,把疑難推理外包給後端的架構,讓語音帳單與推理帳單可以分開最佳化,「換後端不換嗓音」也成為可行的成本調節手段。
限制:新指數該怎麼讀才不會被誤導
指數剛發布,有幾件事在使用前要想清楚。第一,單一總分天生會掩蓋強弱項:一個推理頂尖但輪替生硬的模型,和一個聊天自然但辦事常失敗的模型,總分可能相差無幾,選型時分項比總分誠實。第二,計分方法與權重屬於設計選擇,新指數尤其可能隨回饋調整,引用數字時應連同查閱日期一起記錄。第三,榜單只收原生語音對語音模型,串接方案的團隊不能直接類比。第四,排名與分數會隨模型版本與後端配置快速變動,任何名次都是有時效的快照,決策前應回到官網即時榜單,並用自家場景的語料實測輪替與打斷表現。
值得追蹤的後續指標包括:各品質分項的領先者是否輪動、後端配置何時成為榜單上的顯性欄位、每小時成本隨新模型定價的變化,以及計分方法是否修訂。這些變化比「誰是第一名」更能預告語音代理市場的下一步。