一份從市場驗證產品提煉任務的基準
2026 年 8 月中旬,一篇題為《StartupBench: Benchmarking General-Purpose Agents on Market-Validated End-to-End Workflows》的論文出現在 arXiv 論文頁,編號 2608.17800,隨後由 ByteDance Seed 提交至 Hugging Face 論文頁;依論文頁的作者資訊,研究團隊橫跨 ByteDance Seed、南京大學等多個機構。它要回答的問題只有一個:把通用智能體放上真實世界的完整工作流,表現究竟如何?
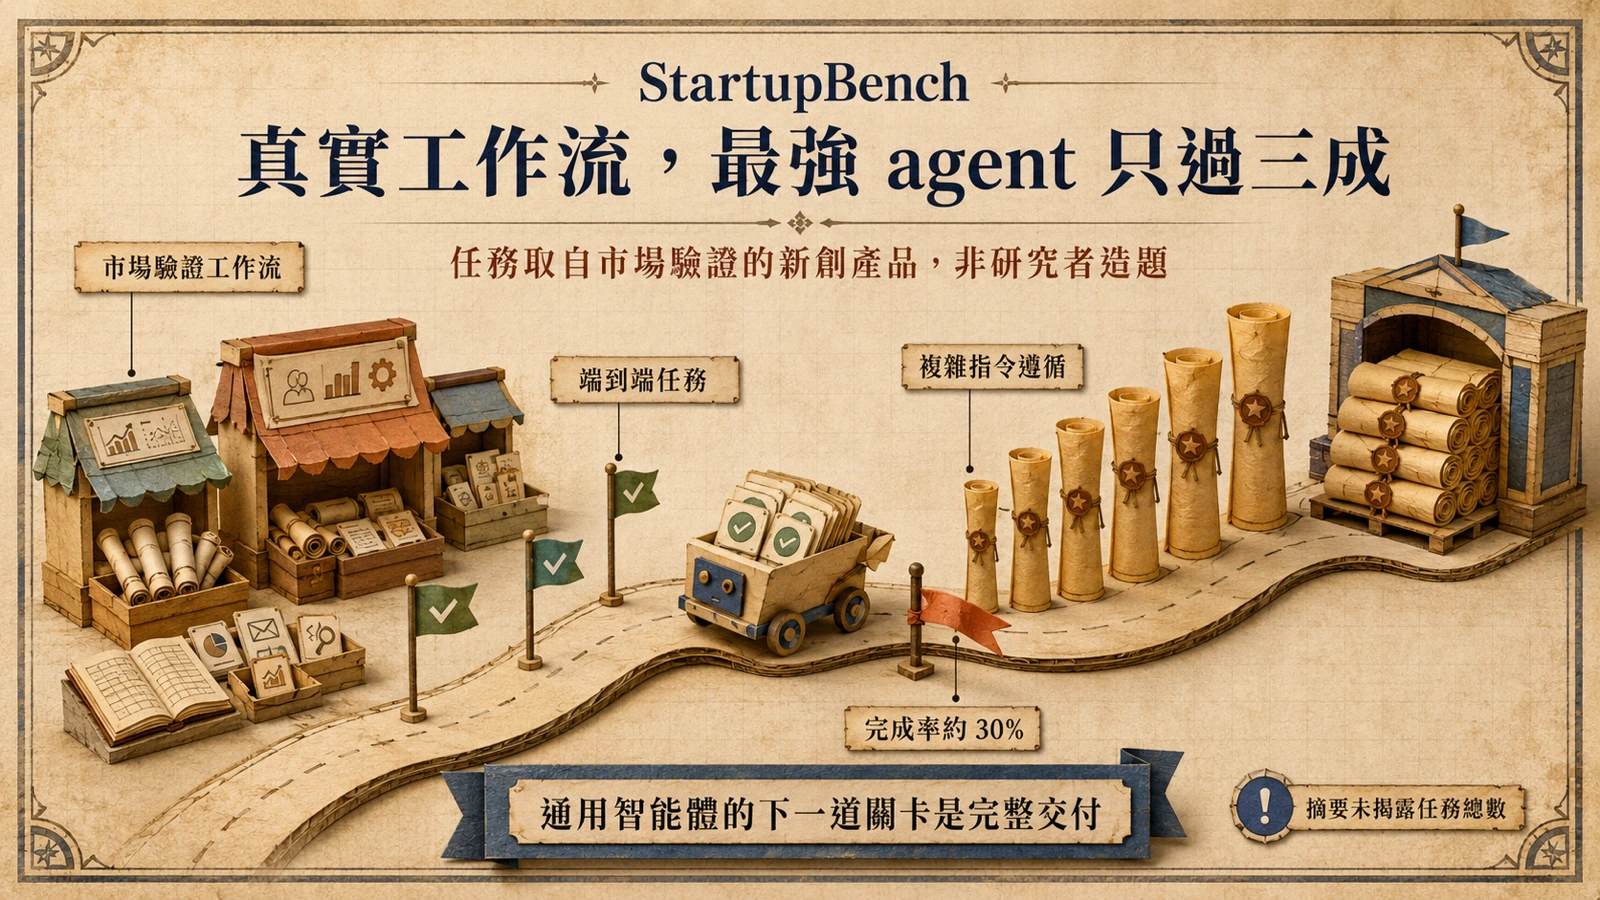
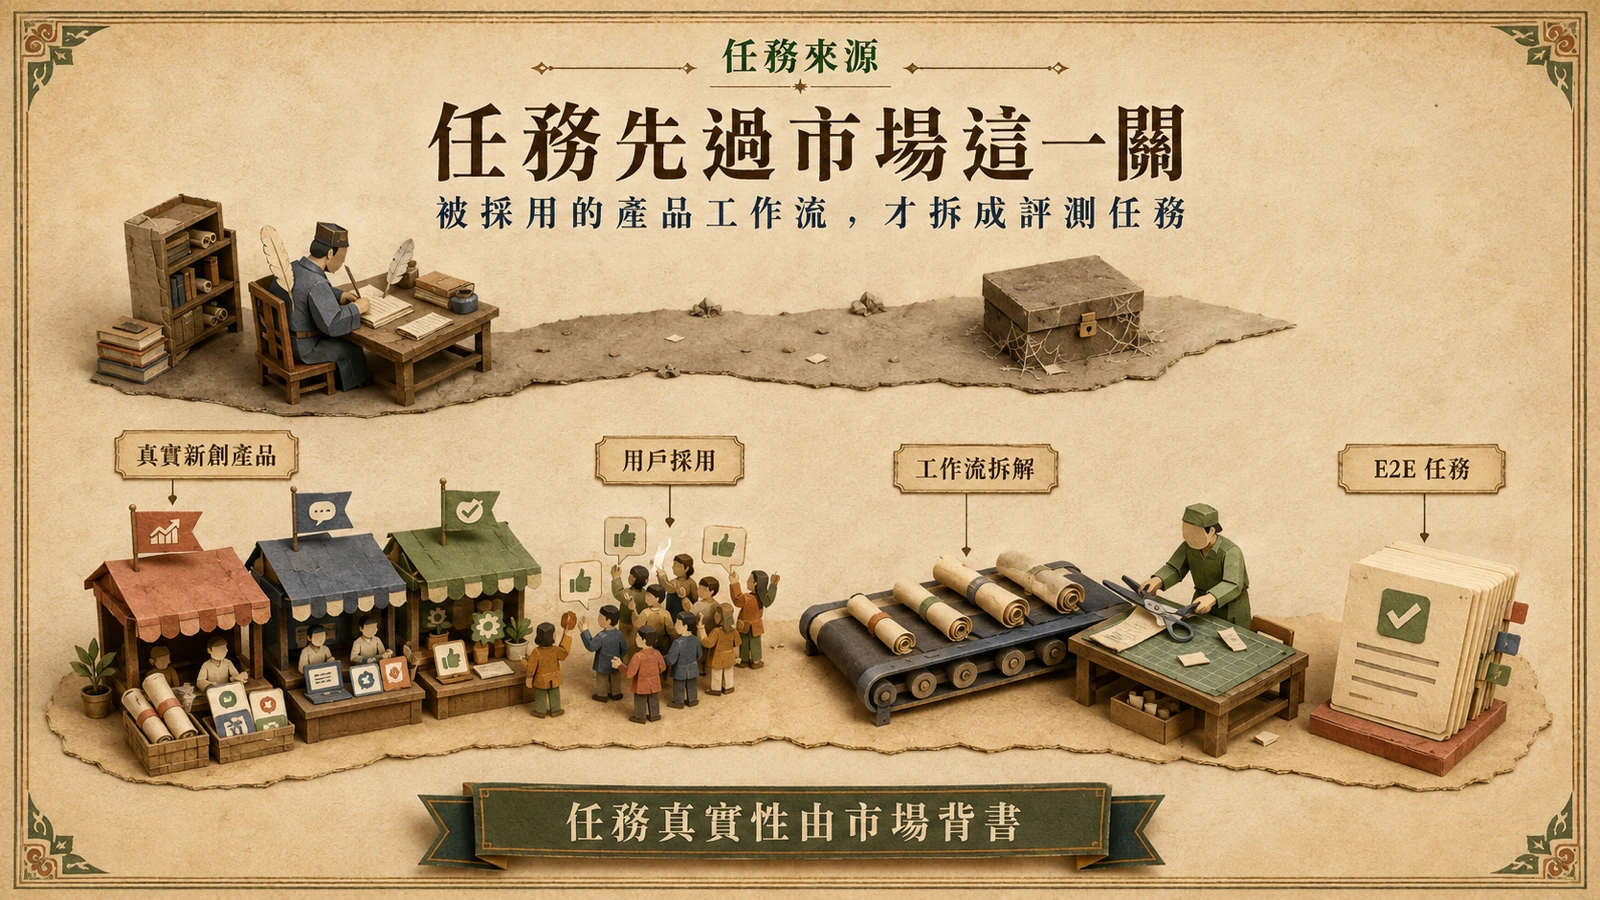
論文摘要開宗明義地定調:「We introduce StartupBench, an E2E agent benchmark grounded in market-validated AI startup products.」這句話裡最關鍵的詞是 market-validated(市場驗證):StartupBench 的任務不是研究者在實驗室裡憑空設計的題目,而是從已經被真實用戶採用、在市場上證明有價值的 AI 新創產品中,提煉出來的端到端工作流。
「市場驗證」憑什麼當評測的尺
要理解這個設計,得先回到基準測試的老問題:任務從哪裡來。絕大多數智能體基準的任務由研究者預先定義——先設想「模型應該會做什麼」,再寫成規格與評分標準。這條路效率高,卻有兩個副作用:其一,題目可能脫離真實需求,測出來的高分對應不到有人願意付費的工作;其二,題目形態一旦被摸熟,分數便容易隨著訓練資料的適配而虛高。
StartupBench 反向操作:摘要接著寫「Rather than defining tasks from pre-defined…」,任務不從預設規格出發,而是先找到市場上確實被採用的 AI 新創產品,把它們實際提供的產品工作流拆解成任務。這一步的實質,是把「任務值得做」的舉證責任交給市場:一個工作流如果已經有真實用戶持續使用,它就天然通過了「這件事有價值、有完整交付定義」的檢驗,評測者不必再替任務的重要性背書。
「端到端」也要放在這個脈絡裡理解:它測的不是單一技能——翻一句話、補一個函式——而是從需求進來到可交付成果出去的整段流程,中間的每一步都得由智能體自己規劃、執行、驗收。這正是新創產品每天在市場上面對的考題。
三成完成率:數字怎麼讀
結果是這份基準最被討論的數字。論文在 Hugging Face 的頁面摘要寫得直白:「StartupBench evaluates end-to-end AI agents on real-world startup workflows and reveals that even top models complete only about 30% of tasks.」即使是最強的模型,在這批真實工作流上也只完成約三成。
單看三成很難有感覺,放進座標系就清楚了。就在差不多的時間點,電腦操作智能體才在 OSWorld-Verified 上寫下 85%、超越人類約 72% 水準的成績。兩個數字並不矛盾:OSWorld 量的是單機環境裡的操作任務,StartupBench 量的是真實產品等級的完整工作流,分數不該直接互比。但落差本身就是訊號——當任務從「操作一台電腦」升級為「做出有人要的完整工作流」,最強模型的完成率就從八成五掉到三成。通用智能體的下一道關卡,顯然不在點擊介面,而在更上游的整體交付能力。
從評測原理看,這個落差其實可以預期。單機操作任務的步驟短、回饋即時,做錯一步多半會立刻被環境糾正;產品等級的端到端工作流則把多個相互依賴的步驟串成一條線,每一步的產出都是下一步的輸入,中途任何一個規格細節被漏掉,都會往下游放大成整份成果的不合格。任務的長度本身,就是難度的一部分——這也是為什麼同一個模型能在短任務上逼近人類,卻在完整工作流上頻頻失守。
失敗集中在複雜指令遵循
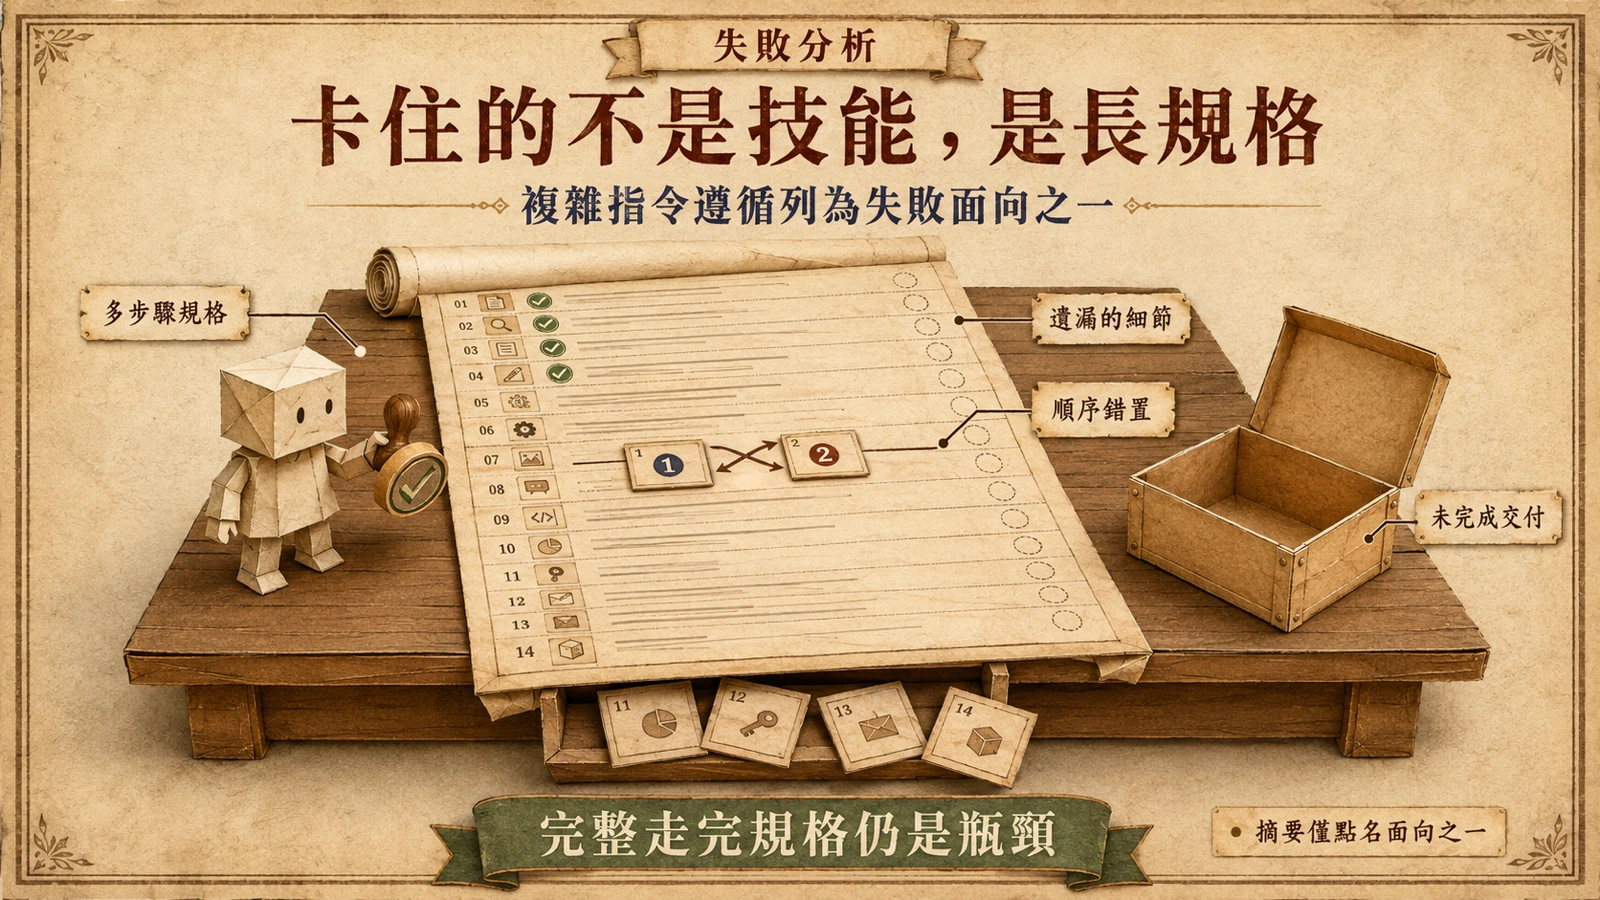
三成完成率的另一半故事,是那七成為什麼失敗。論文對失敗樣本做了進一步分析,摘要點名「Further analysis identifies aspects like complex instruction following」——複雜指令遵循是主要失敗面向之一。
這個結論值得停下來細看。它說的不是模型缺乏領域知識、不會呼叫工具或找不到資料,而是更基礎的問題:真實產品的工作流規格又長又密、限制層層相疊,智能體在多步驟執行中漏掉細節、顛倒順序,交出來的成果不符合規格。換句話說,卡住的不是技能,而是把一份長規格完整走完的能力——這恰好最難靠堆疊單點技能來彌補。
與其他智能體基準的定位差異
把 StartupBench 放進基準版圖,可以看出新一代評測的共同轉向。騰訊七月發表的 WorkBuddy Bench 從真實 commit 與 pull request 逆向工程出任務,測四個工作領域裡的編碼智能體;StartupBench 則把「真實性」的來源換成市場已驗證的新創產品,對象是通用智能體的端到端工作流。取材路徑不同,命題一致:對「研究者造題」的傳統路線投下不信任票,讓任務的真實性可以被回查——一個回到版本控制系統裡的 commit,一個回到市場上的實際採用。
另一個有用的對照,是「讓智能體經營一家模擬公司」這類基準:它們把重點放在長期決策與經營策略,量的是策略遊戲式的分數;StartupBench 不經營公司,而是把場景換成一家已經被市場接受的產品,要求智能體把真實工作流做出來。前一種測策略,後一種測交付,兩者回答的問題並不相同,卻常被同一批「通用智能體」的宣稱混在一起談。企業在解讀各家排行榜時,先分清楚它量的到底是哪一種能力,往往比記住名次更重要。
對開發者與企業的實際影響
對正在導入代理型工具的團隊,第一個啟示是解讀方式:不要用單一基準的分數推斷「智能體能不能做我們的工作」。85% 與 30% 量的是不同層次的事,採購與導入決策應該回到自身工作流的小規模試點,而不是排行榜名次。
第二個啟示是工程面的:既然失敗集中在複雜指令遵循,最值得投資的就是規格的工程化——把長規格拆成可驗收的步驟清單、在流程中插入檢查點、對交付物逐項驗收。這些做法不會讓模型變強,但能讓同一個模型少漏細節,直接改善完成率。
第三個啟示是方法論的:就算不用這份基準,它的造題思路也搬得走——把自家產品或部門裡最有價值的幾條工作流寫成任務,附上完整規格與驗收清單,就能得到一份比任何排行榜都貼近自身情境的評測集。基準會過時、分數會被刷新,這個「從真實工作流造題」的方法本身才是可複用的資產。
值得追蹤的指標也明確:這份基準是否開源、任務集與評分協議是否公開可重現,以及後續模型在端到端工作流上的爬升速度。如果三成在幾個季度內被推升到五成以上,通用智能體的落地敘事就得重寫。
沒被證實的部分
最後要劃清界線:摘要與論文頁揭露的資訊有限,任務總數、評分方式細節、受測模型清單與完整的失敗分析,都沒有出現在目前可查的摘要層級內容中,須回到論文全文查證,也不應從「約 30%」過度推論特定模型之間的優劣。同時,「市場驗證」保證的是任務的真實性與價值,不等於任務難度經過校準,也不排除新創產品的成功帶有商業與通路因素。30% 是現有最強模型的快照,會隨模型迭代快速變化;在開源審計與獨立重現出現之前,把它當成方向性的能力邊界訊號,比當成精確排名更穩妥。