為什麼多數評測專案敗在一開始
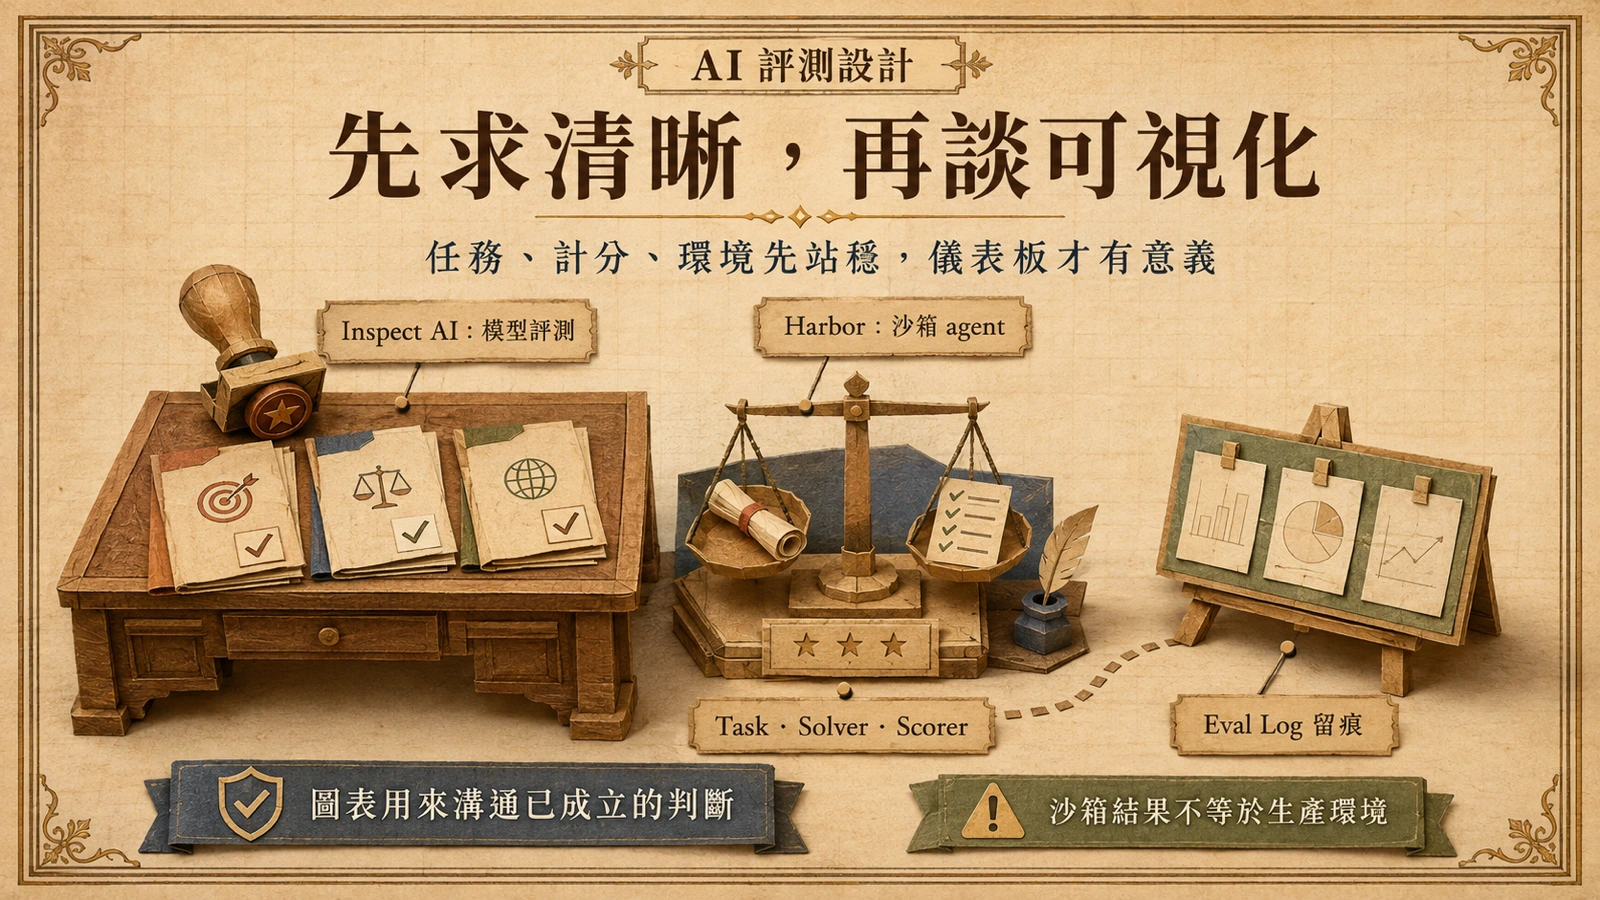
團隊導入 AI 的常見路徑是:先挑一個看起來厲害的儀表板,把模型分數餵進去畫出曲線,然後在會議上爭論曲線代表什麼。問題不在曲線,而在曲線背後沒有先講清楚的三件事:你要測的技能是什麼、每一題怎麼判對錯、模型在什麼環境裡作答。這三件事沒有落成白紙黑字,任何可視化都只是把混亂畫成圖。
「先求清晰、再談可視化」因此是設計評測的第一原則。清晰的具體內容可以拆成三項:任務描述夠精確,不同人讀了會準備出同一種考題;計分規則夠明確,判定不依賴評分者當下的心情;執行環境夠可控,換一台機器、隔一週重跑,結果不會無故漂移。做到這三點,數字才有累積價值——這週與上週的分數可以比較,A 模型與 B 模型的差距才有意義。
這也是成熟評測框架把力氣花在結構而非畫面的原因。接下來用兩個開源框架說明這套結構長什麼樣:英國 AI 安全研究所開發的 Inspect AI,以及 Terminal-Bench 團隊開發的 Harbor。
Inspect AI:把評測拆成 Task、Solver、Scorer
Inspect 官方文件開宗明義把它定位為前沿 AI 評測框架,由英國 AI 安全研究所(UK AISI)與 Meridian Labs 開發,網站列出超過 200 個現成可跑的評測,這段介紹出自官方首頁。它不是雲端服務,而是一個安裝在本地的 Python 套件,評測定義就是程式碼,可以進版本控制、可以 Code Review——「清晰」在這裡不是態度,是被工具強制的格式。
框架的核心抽象有三層。Task 把一個評測包成可重複執行的單位:資料集、提示模板與計分方式寫在一起,官方教學用 @task 裝飾器為任務掛名,之後指令列就能用名字找到它。Solver 是作答的過程,例如套用系統提示、讓模型逐步推理、或開放模型呼叫工具。Scorer 負責判分:可以寫成程式直接比對,也可以用另一個模型當評審依標準給分。三層各自獨立,所以你能固定題目與計分、只換受測模型,也能固定模型、比較不同提示策略——這正是可控實驗的基本形態。
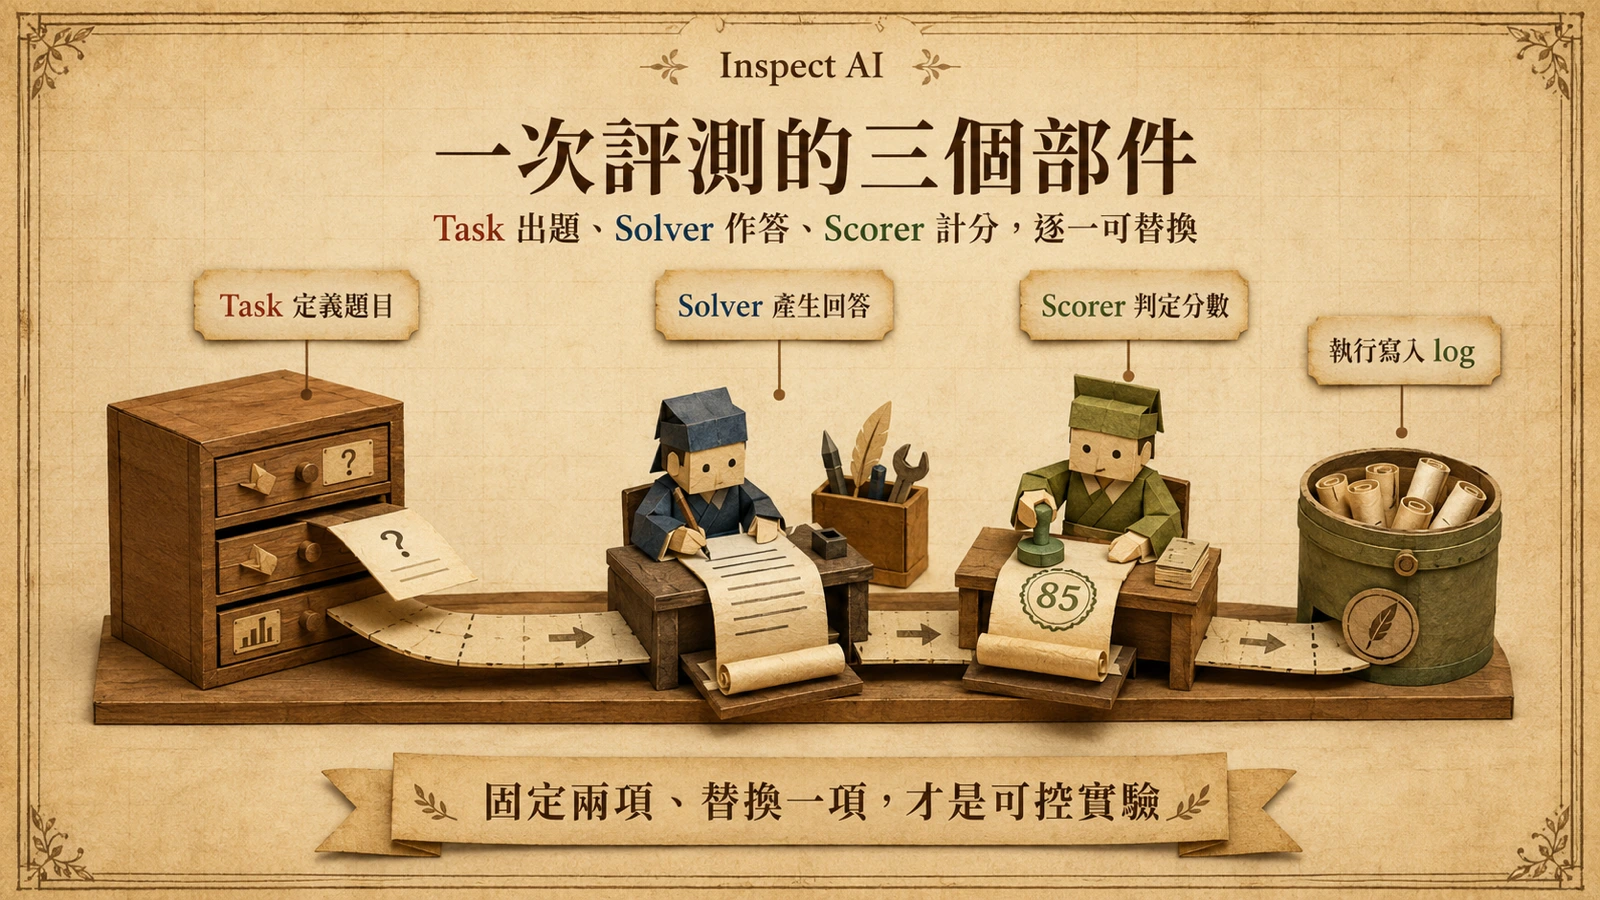
執行收進指令列:inspect eval 指令搭配 --model 參數就能指定受測模型,評測因此可以腳本化、排程、放進 CI,而不是手動貼網頁的雜事。GitHub 儲存庫對它的描述同樣直白:為大型語言模型評測而生、內建多種元件的框架,見儲存庫說明。
eval log:每次執行都留下可回查的證據
清晰的最後一塊拼圖是紀錄。Inspect 的設計裡,每次執行評測都會為每個任務寫下評測日誌(eval log):當時用了哪個模型、每個樣本的完整輸入輸出、Scorer 給分的角度與理由,全部落在檔案裡。這件事看似平凡,卻是「先求清晰」與「先求好看」的分水嶺——分數會被截圖轉貼而失去脈絡,log 不會。
實務上 log 決定兩件常被忽略的事。第一是除錯:平均分數掉了三個百分點,原因往往藏在十幾筆具體樣本裡,可能是提示改版、模型換版、或某類題目集體失效;沒有逐筆紀錄,這種問題只能用猜的。第二是可比性:兩週後有人質疑「這個分數怎麼來的」,你拿出當時的完整執行紀錄重驗即可,不必重跑一次然後祈禱結果一樣。Inspect 也附帶檢視 log 的工具,逐筆瀏覽不必打開原始檔案。
把 log 當成評測的原始資產、把儀表板當成它的衍生視圖,這個先後順序一旦顛倒,團隊就會開始為了讓圖好看而回頭改動評測本身——那是評測失去公信力的起點。
Harbor:在沙箱裡跑真實的 agent 任務
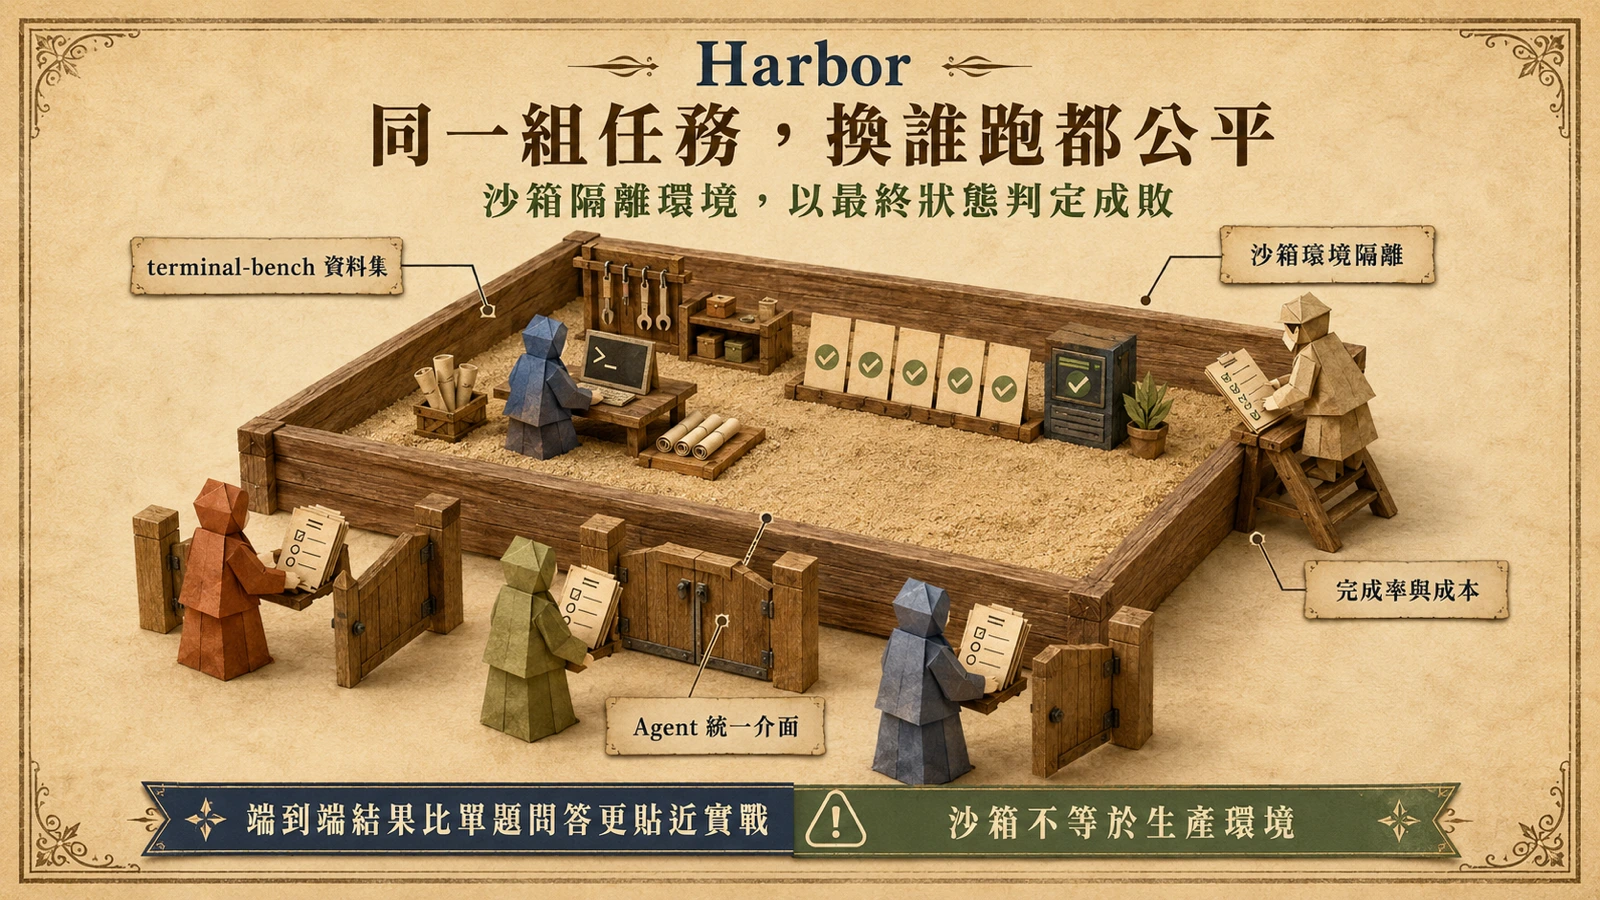
模型評測與 agent 評測是兩個世界。問答式評測裡,模型回一句話就能判分;agent 評測裡,受測對象要連續行動——讀檔案、下指令、裝套件、改程式——成敗取決於一連串動作之後環境的狀態。這類評測需要的不只是計分規則,還有一個能安全執行任意行動的沙箱。
Harbor 正是為此而生。Harbor 的 README 自我介紹:來自 Terminal-Bench 原班團隊、用於評測與優化 agent 及語言模型的框架。Terminal-Bench 是同一團隊維護的終端機任務基準,題目是真實的命令列工作;Harbor 把「跑基準」這件事一般化:任務包成資料集、agent 透過統一介面接入、執行環境以沙箱隔離,README 列出的用途包括在資料集上評測任意 agent 或模型、透過 client 與任務互動、並以 dashboard 掌握執行狀況。
門檻低到兩條指令:倉庫的快速開始寫著先 uv tool install harbor,再以 harbor run --dataset [email protected] 指定 agent(例如 claude-code)與模型,就把一個 agent 放進沙箱跑完整套終端機任務,這兩行出自倉庫內的快速開始指引。對想把「我的 agent 到底比上週強還是弱」變成可測語句的團隊,這是最低門檻的起點。
兩個框架怎麼選、怎麼搭配
分工大致這樣畫:Inspect AI 強在把「單次作答品質」結構化,適合 API 模型的知識、推論、遵循指示、單步工具呼叫等評測,計分邏輯與實驗設計是它的強項;Harbor 強在「多步行動的端到端成果」,適合驗證 coding agent、終端機操作、工作流自動化這類要看最終環境狀態的任務。一個看答案對不對,一個看事情有沒有做成。
兩者並用不衝突。常見組合是:用 Harbor 顧端到端的能力底線(任務完成率、步數、成本),用 Inspect 顧元件層的品質(檢索品質、摘要忠實度、單步工具呼叫正確率),兩邊的 log 各自累積,彙整進同一張比較表。選擇時真正該問的不是哪個框架比較熱門,而是失效模式長在哪一層:答案錯,先看 Inspect 類;事情沒做完,先看 Harbor 類。
這組選擇也能放回更大的版圖理解。政府機構用 Inspect 做前沿模型的能力評測,例如英國 AISI 參與的前沿模型網安聯合評測,走的正是「明確計分+可回查執行紀錄」這條路;而新創團隊驗證自家 agent,多半從 Harbor 這類沙箱基準起步,先拿到端到端的完成率,再往下拆元件。
從數字到判斷:可視化的正確順序
有了結構化評測與 log,可視化才有原料。順序建議固定四步。第一步定義決策:這份報表要回答什麼問題——該不該升級模型?提示改版有沒有效?沒有決策就沒有指標。第二步跑小樣本並人工讀 log:先確認計分規則真的在量你想量的東西,模型評審的偏誤、題目語意模糊,都在這一步暴露。第三步擴大樣本、把逐筆結果彙整成表:常見做法是先匯出成試算表中繼,再接 Looker Studio 這類 BI 工具做長期追蹤的圖表。第四步在圖上標註變因:模型版本、提示版本、環境版本,讓曲線的每個轉折可以被解釋。
這個順序的重點只有一句話:圖是拿來溝通已經成立的判斷,不是拿來代替判斷。平均分數的曲線不會告訴你為什麼掉分;能回答為什麼的,永遠是逐筆 log 加上親手讀過的錯誤樣本。
限制與值得追蹤的後續
最後把這套方法的邊界講清楚。其一,基準污染:熱門基準的題目可能已進入模型訓練資料,分數高不等於能力強,自建任務與私有資料集是最直接的解毒劑。其二,模型評審的偏誤:用模型判分要固定評審模型版本、定期抽樣人工覆核,否則評審模型一升級,歷史分數全部失去可比性。其三,沙箱不等於生產環境:終端機任務的完成率無法直接推論 agent 在你家系統上的表現,權限、資料與網路的差異要另外驗證。其四,成本:agent 評測一輪可能觸發數百次多步行動,樣本數要與預算一起設計,再按規模執行。
值得追蹤的後續:兩個框架都仍在活躍開發,Inspect 與 Harbor 的版本更新、Terminal-Bench 任務集的擴充,以及各模型在這些基準上的官方結果,都是判斷「一個分數該不該相信」的背景資訊。更多開發工具的橫向介紹,整理在工具主題分類。