正式版換上新版本號 0813
DeepSeek 把 API、網頁端與 App 三個介面的 deepseek-v4-pro 一次更新到 DeepSeek-V4-Pro-0813,等同宣告 V4 Pro 從預覽版邁入正式版。官方模型頁將 deepseek-v4-pro 更新為 DeepSeek-V4-Pro-0813,並標示支援思考模式(thinking mode,預設開啟)與非思考模式兩種推理路徑,可由開發者自行切換。
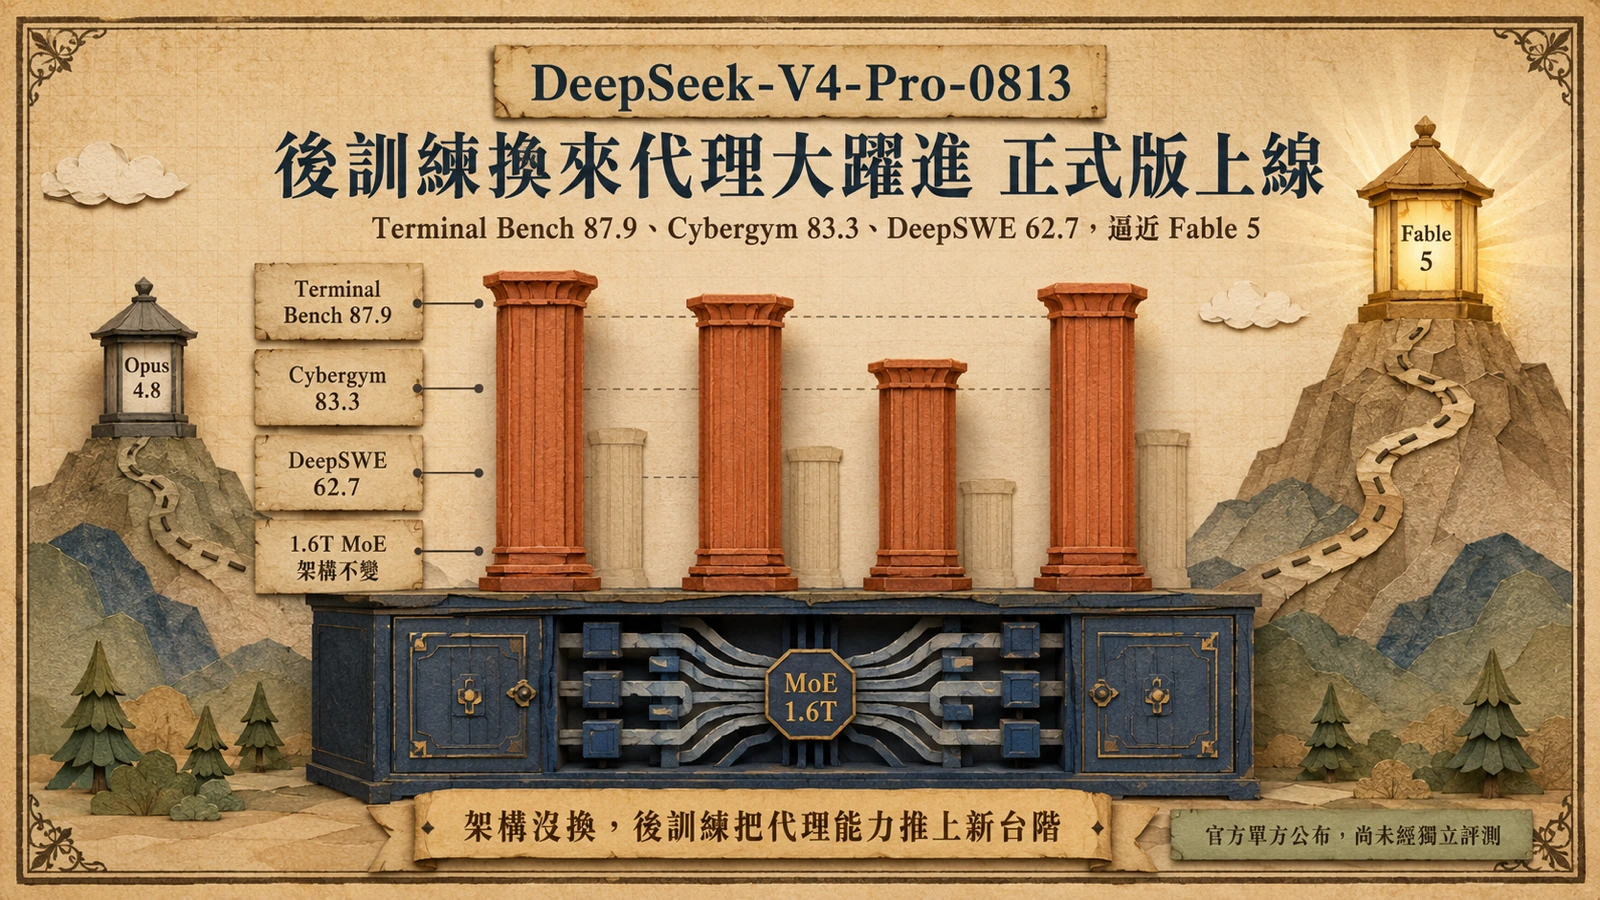
模型本身延續 4 月釋出的 V4 預覽架構——1.6T 總參數、49B 激活參數的 MoE,官方當時即定位為「效能比擬全球頂尖閉源模型」,並標榜 1M token 上下文。換句話說,0813 正式版的硬體規格與預覽版一致,這次改版的重點幾乎全部落在後訓練(post-training),升級幅度被多家實測與社群討論形容為「像換了一個模型」。
代理評測全面躍進
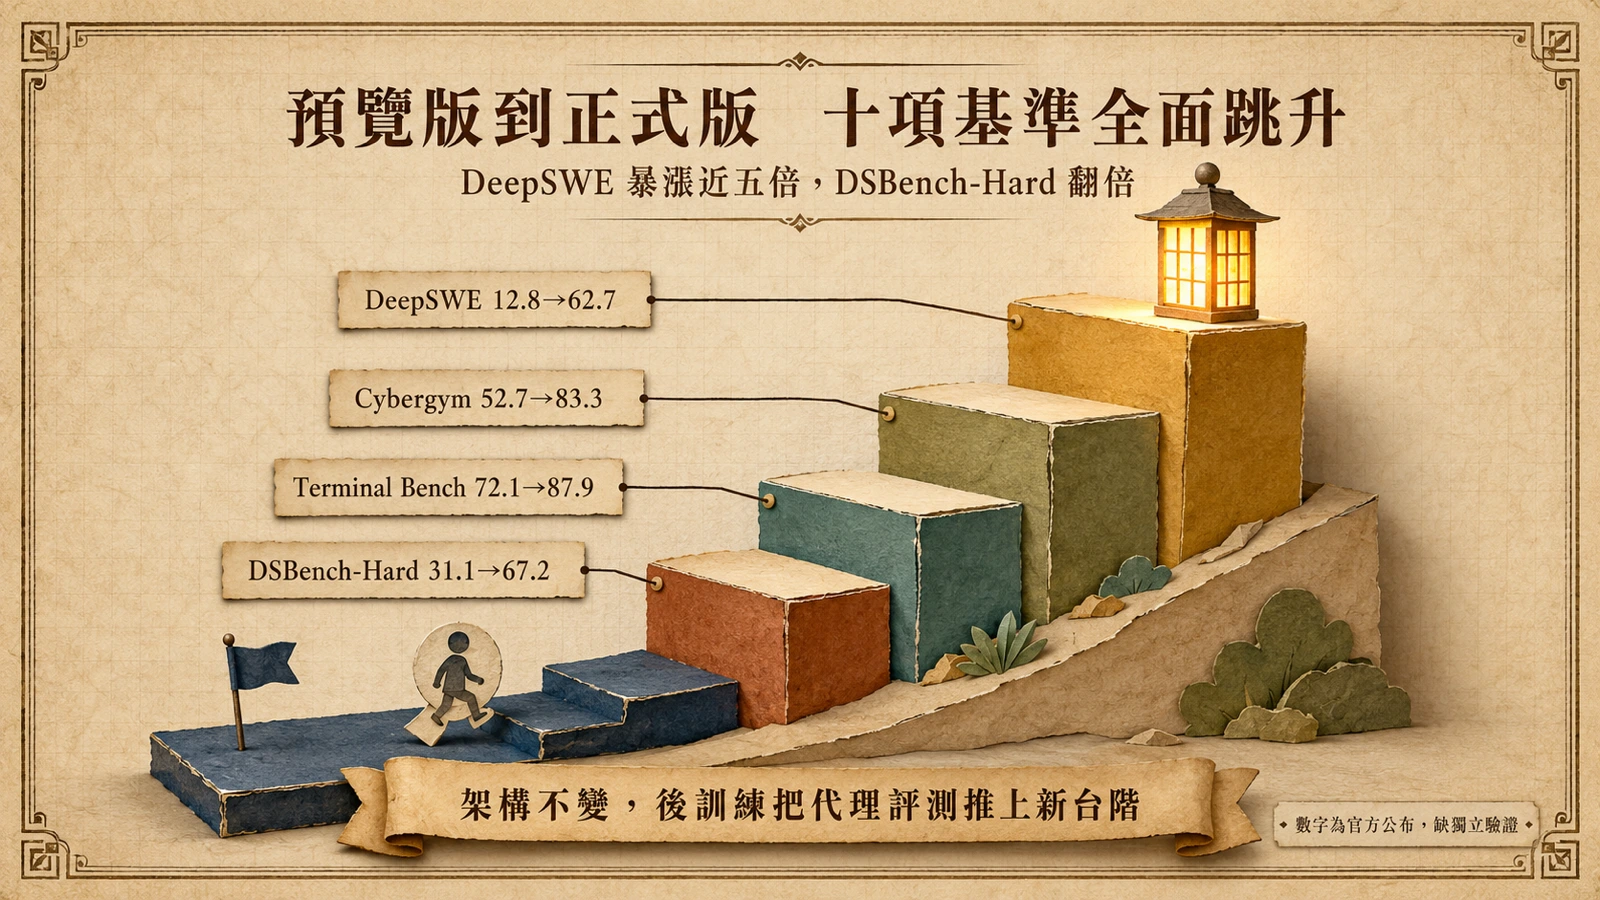
正式版最明顯的進步在於 Agent(智能體)能力。根據 DeepSeek 官方公布的評測,正式版在 Terminal Bench 2.1 從預覽版的 72.1 躍升至 87.9、Cybergym 從 52.7 升到 83.3、DSBench-Hard 從 31.1 翻倍到 67.2,NL2Repo 從 38.5 推到 61.5;變化最劇烈的是長鏈編碼代理基準 DeepSWE,從約 12.8 暴漲到 62.7,提升近五倍,整體十項基準沒有一項倒退。HLE(Humanity’s Last Exam)在使用工具情境下達 60.0、不使用工具為 42.7。
值得留意的是,DeepSeek 自家的 V4-Flash-0731 先前才以較小的激活參數量,在多項基準超越 V4-Pro 預覽版;這次 V4-Pro 正式版把差距補回來,也讓 V4 系列內部「旗艦對決輕量」的分工重新確立。V4 系列的多模態支線則另有已開放 API 的 V4-Flash-Vision-Exp,不能把兩者視為同一產品定位。
超越 Opus 4.8、逼近 Fable 5
把這些數字放回競爭座標,DeepSeek 官方評測圖表顯示,V4 Pro 正式版在 HLE、Terminal Bench、Cybergym、DeepSWE 等 Agent 基準上的得分全面超過 Anthropic 的 Claude Opus 4.8——以 Terminal Bench 2.1 為例,87.9 高於 Opus 4.8 的 85.0;在 AutomationBench 甚至反超 Claude Fable 5,Terminal Bench 也僅以約 0.1 分之差落後 Fable 5。換言之,DeepSeek 在長鏈終端操作、程式碼修改、工具呼叫這類複雜自主任務上,已推進到逼近頂尖閉源前沿的位置(見〈Anthropic 的 IPO 溢價難題〉)。
DeepSeek 一直是開源陣營的代表,這波代理升級也延續了開源模型與閉源前沿差距持續收斂的趨勢。不過要留意,0813 正式版目前主要透過官方 API、App 與網頁端提供,權重尚未在其他平台同步開放,是否會如預覽版般開源仍待官方確認。
定價與取得方式
取得方式相當直接:把模型名稱設為 deepseek-v4-pro 即可呼叫,App 與網頁端同步更新。新版本相容 OpenAI ChatCompletions 與 Anthropic Messages 兩種介面格式,方便既有應用遷移,並新增 Responses API 與 Codex 接入。
定價方面,正式版暫時維持預覽版水準,但官方模型與定價頁已預告近期將大幅調漲 DeepSeek API 整體定價,建議用量大的開發者預先規劃。