首次進榜就站上第一:發生了什麼
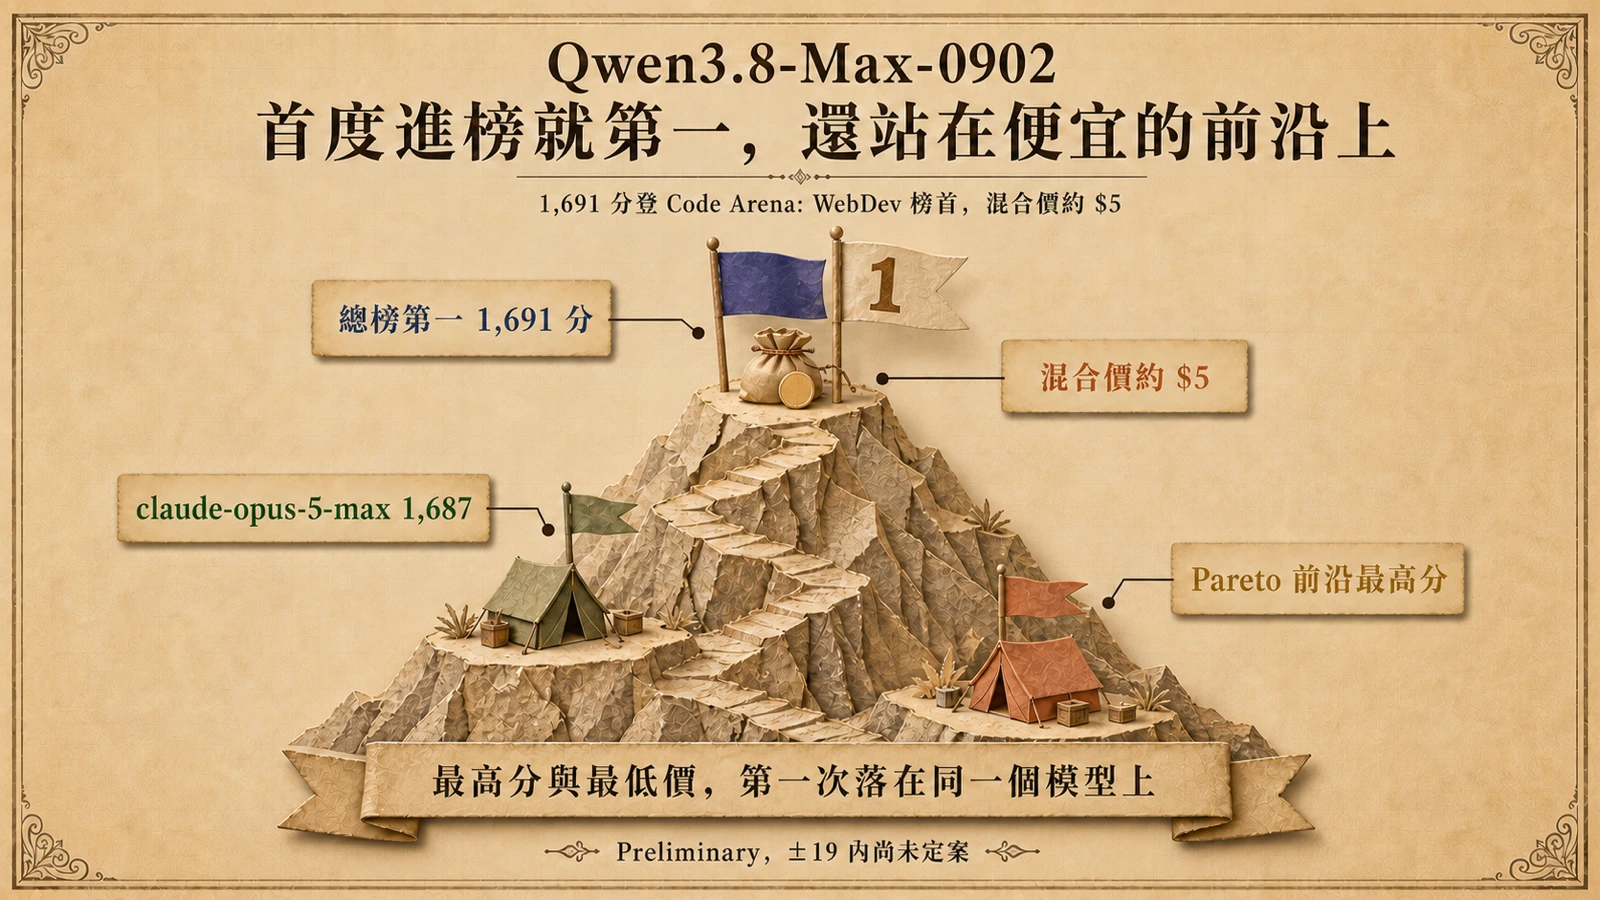
9 月 2 日,arena.ai 經營的 Code Arena: WebDev 排行榜上出現一個新名字:qwen3.8-max-0902。這個 Alibaba 通義千問旗艦模型的最新快照首次進榜,就以 1,691 分直接坐上總榜第一。第二名的 claude-opus-5-max 以 1,687 分緊追在後,第三名是 Moonshot 的 kimi-k3-max(1,674 分),第四名則是被這次升級取代的前代版本 qwen3.8-max(1,669 分),第五名是 claude-opus-5-high(1,661 分)。Arena 的公告確認這是該模型的首次登場,並補上一句更有分量的註解:它同時成為 Pareto 前沿上得分最高的模型。
Code Arena: WebDev 是針對網頁開發任務的模型排行榜,排行榜頁面自述涵蓋前端開發與代理式編碼工作流的整體排名。模型已在 QwenCloud 上提供服務,官方部落格把 Qwen3.8-Max 系列定位為編碼與協作的新標竿,規格是 2.4 兆參數、約 950 億活躍參數的 MoE 架構,搭配 1M 上下文視窗。
1,691 分怎麼讀:盲測計分與 ±19 的意義
要看懂「首次進榜即第一」,得先知道這類分數怎麼來。Arena 榜單的計分方式是把模型的實際產出放進匿名成對對決:使用者在不知道模型身分的情況下比較兩個結果,選出較好的一邊,選票累積後換算成分數。因此 1,691 不是「能力的絕對值」,而是「相對於對手的人類偏好強度」。
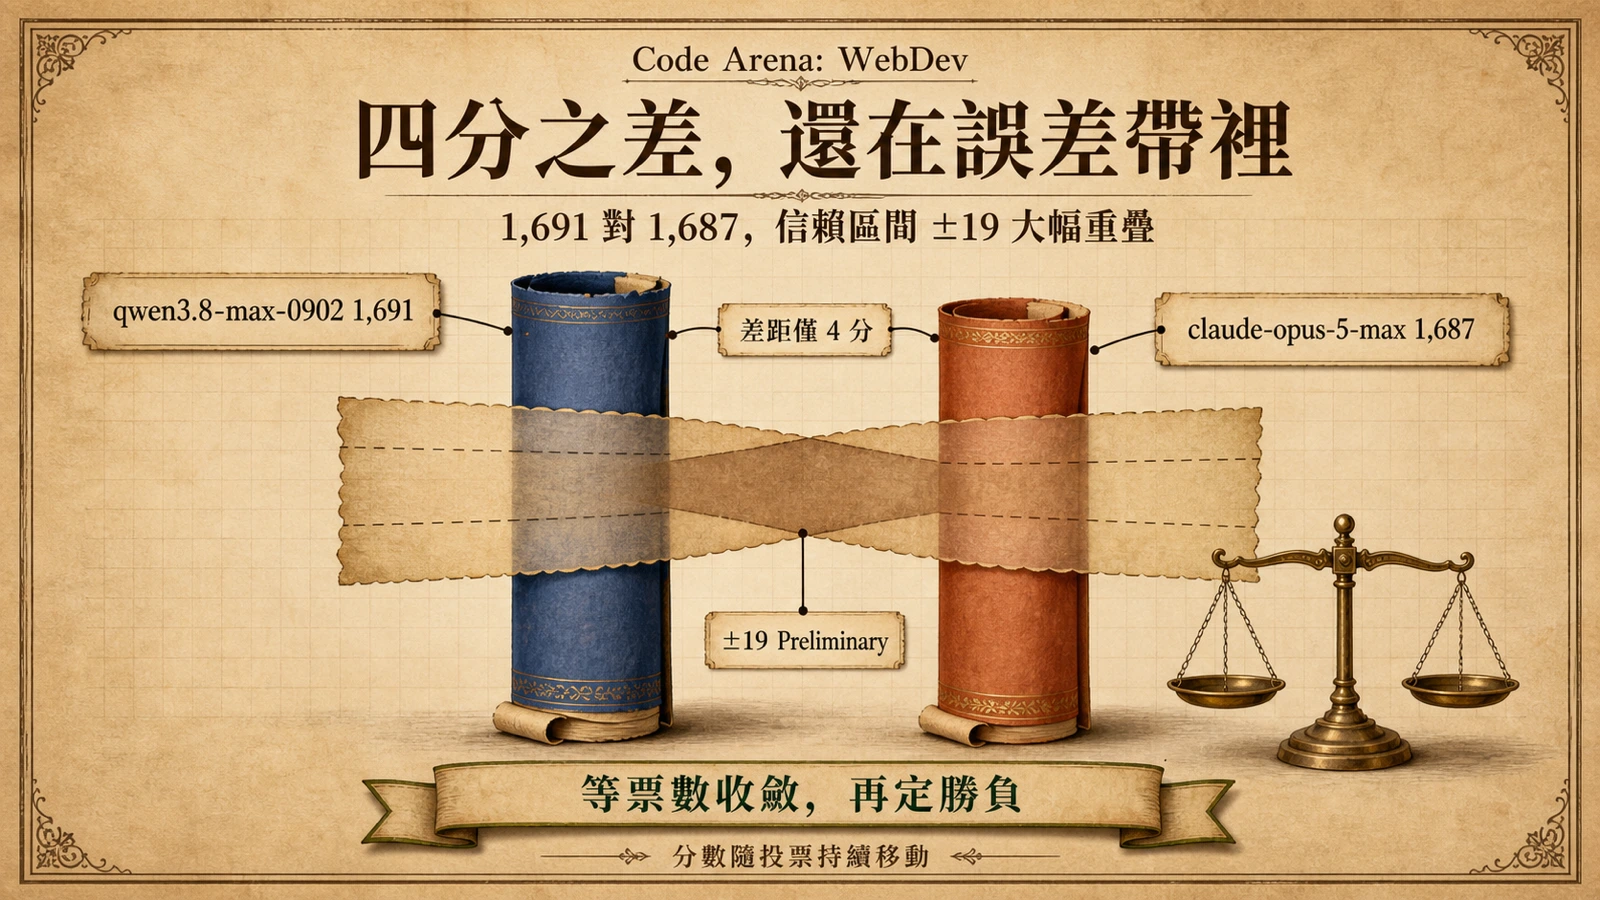
每個分數都附帶不確定性。排行榜為 qwen3.8-max-0902 標注的信賴區間是 ±19,並標記為 Preliminary(初步)——剛進榜的模型累積票數還少,區間自然偏寬。把這個區間放進來,榜首之爭就有不同的讀法:1,691 對 1,687 的差距只有 4 分,遠小於 ±19 的區間半寬,兩個模型的分數帶大幅重疊。「排名第一」是頁面上的事實,但「顯著優於 claude-opus-5-max」還不是這份資料能支撐的結論。同樣的邏輯也約束著對升級幅度的判斷:對前代 qwen3.8-max 的 22 分差距看似明顯,仍貼著區間邊緣,需要更多票數收斂才能定案。
Pareto 前沿:把分數和混合價放在同一張圖上
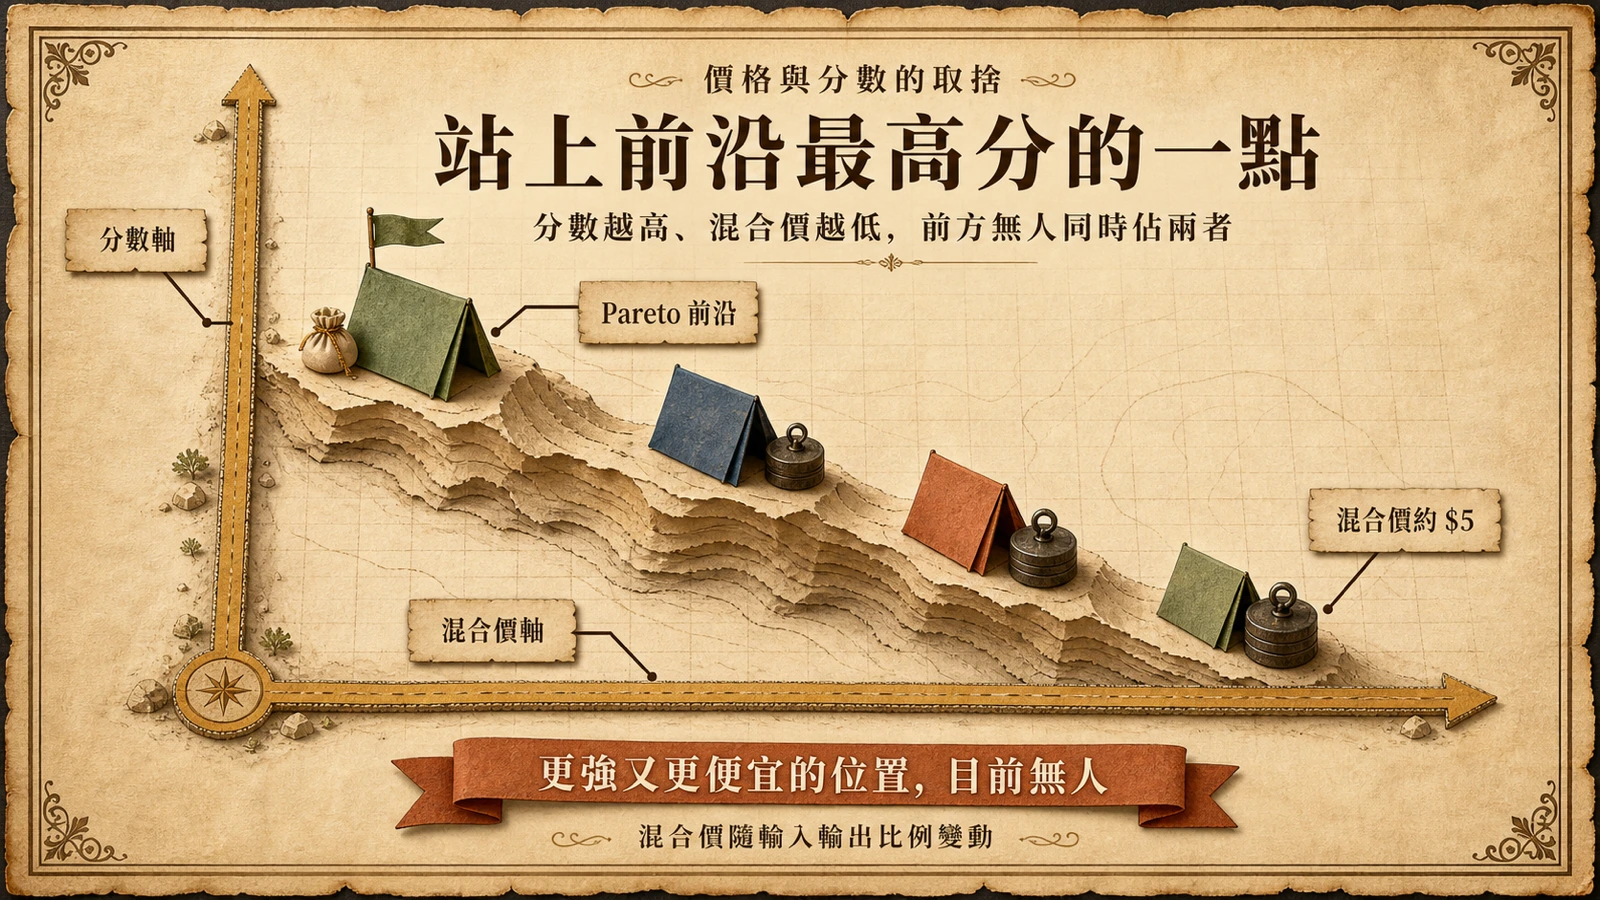
這次公告裡更有資訊量的說法,是「Pareto 前沿上得分最高的模型」。Pareto 前沿是把每個模型畫在「分數—價格」平面上之後,沿左上角畫出的一條邊界:站在邊界上的模型,意味著沒有其他模型能同時做到分數更高且價格更低。qwen3.8-max-0902 被特別點名,是因為頂尖分數通常伴隨頂級價格,而它在拿到榜上最高分的同時,混合價只有約 $5。
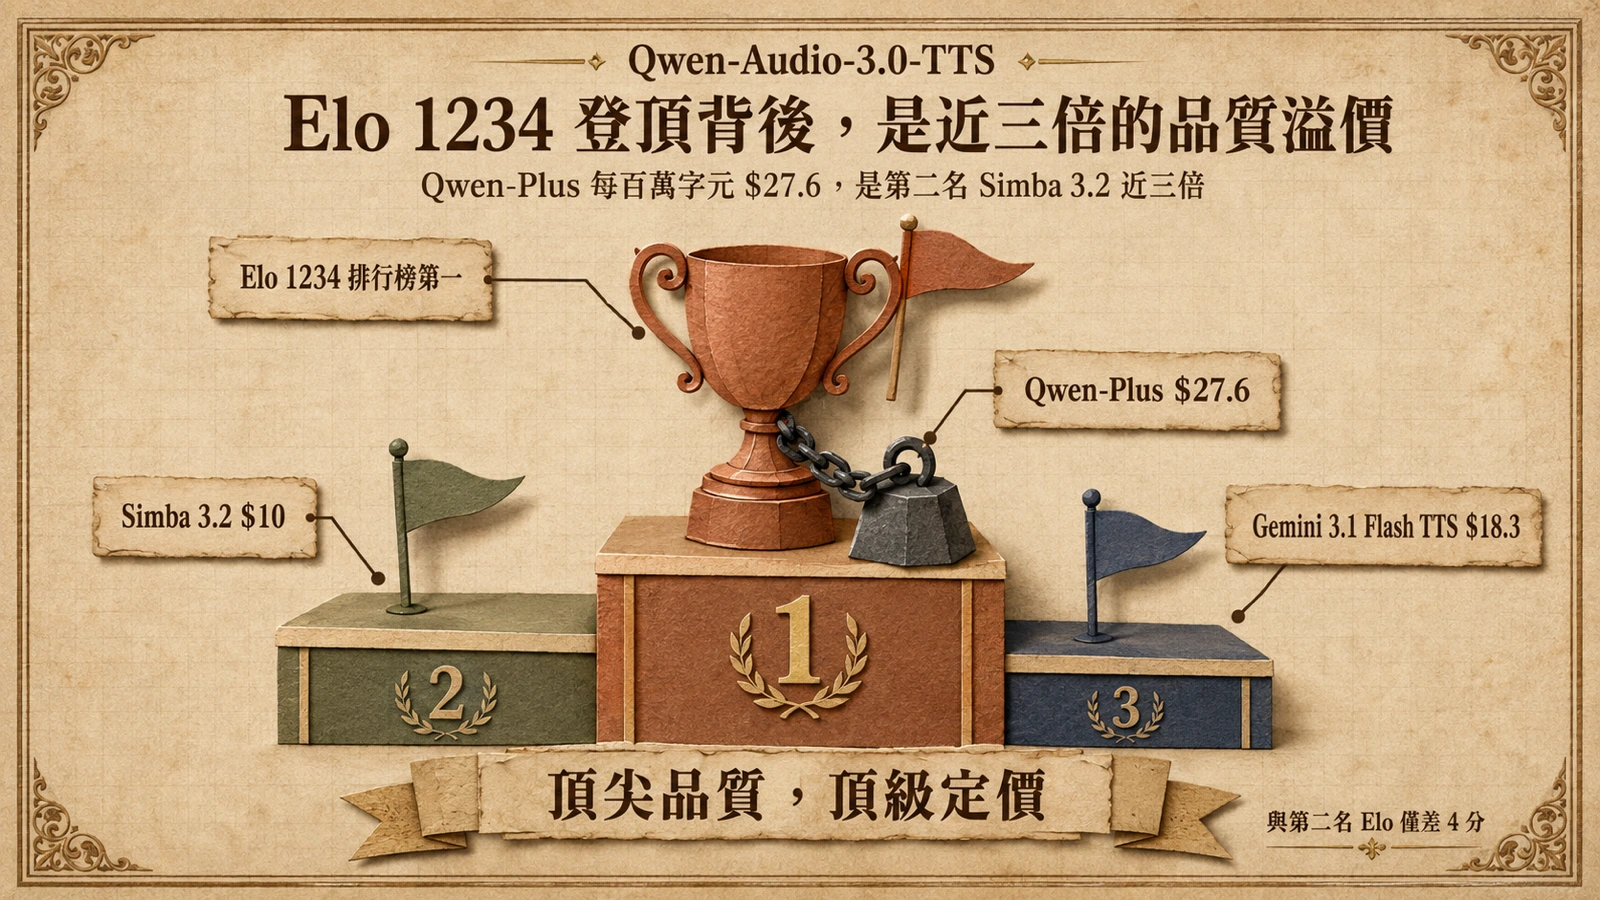
混合價是把輸入與輸出單價按典型使用比例加權後的單一數字。排行榜為它標注的 API 價格是輸入 $2、輸出 $6(每百萬 tokens),依各家工作流的輸入輸出分布不同,加權結果落在 $5 上下。對照同門產品線,這個定位更顯得刻意:前一個以排行榜第一登上新聞的 Qwen 家族模型是 Qwen-Audio-3.0-TTS,走的是每百萬字元 $27.6 的品質溢價路線;這次 0902 反向操作,把「夠便宜」本身當成競爭主軸。同一個團隊在不同賽道分別驗證兩種定價策略,本身就是模型市場進入分眾競爭的訊號。
從 1,669 到 1,691:一次快照升級動了什麼
榜單把新舊版本並列,給了一個少見的對照組:同一個模型家族、同樣的架構規格,只差一次快照迭代,分數從 1,669 推到 1,691。「-0902」這種日期戳版本的意義在於:模型架構不動,更新的是後訓練階段的資料與策略,讓同一條產品線可以定期推進而不重新發表。對使用者的實際影響是,API 上的模型行為會隨快照推進而改變,把成果定型在特定版本上的應用應該鎖定版本號,而不是永遠跟著預設別名走。
這條產品線的來源也值得拆開看。HuggingFace 上的模型卡說明,Qwen3.8-Max 是以開源權重的 Qwen3.8-2.4T-A95B 為基底的官方版本,額外加上視覺輸入、非思考模式與 1M 上下文等能力。開源基底已經公開,這代表想要凍結版本、自行部署的團隊有一條替代路徑:用開源權重自建推理,代價是自行承擔 2.4 兆參數規模的運維成本,且 Max 版本的額外能力未必完全對齊。
榜單格局:與 Claude、Kimi 的四分之差
攤開前五名可以看出這張榜的擁擠:qwen3.8-max-0902(1,691)、claude-opus-5-max(1,687)、kimi-k3-max(1,674)、qwen3.8-max(1,669)、claude-opus-5-high(1,661)。五席裡中國團隊佔三席(Alibaba 兩個版本加 Moonshot),Anthropic 佔兩席,而第一名到第五名只差 30 分。在分數帶大幅重疊的局面下,這種排名更接近並列領先,而不是清晰的優劣序。
這也解釋了為什麼單一榜單的名次要小心讀。當榜上前幾名的差距小於本身的不確定性,跨榜共識往往比單榜名次更能反映真實排序,可參考 LatentRank 以十張公開榜算出共識分的做法。對正在選型的團隊,務實的結論是:0902 證明了它在人類偏好盲測裡具備第一梯隊的競爭力與明顯的價格優勢,但「最強」與「最適合」之間,還隔著自有任務的實測。
定價與取得方式:兩套幣別的帳要分清楚
0902 的價格要分兩條線看。國際通路 QwenCloud 以美元計價,排行榜標注輸入 $2、輸出 $6 每百萬 tokens;中國區的阿里雲百煉模型資訊頁則列人民幣定價:輸入 ¥12、輸出 ¥36 每百萬 tokens,快取命中的輸入降到 ¥1.5。牌價之外,百煉的計費說明載明兩個對帳單影響更大的規則:支援批次呼叫的模型,輸入輸出單價一律以即時推理價的 50% 計費;上下文快取的折扣只及於輸入端,兩者不能同時生效。
對代理式編碼工作流來說,這些折扣結構常比牌價更關鍵。代理任務會反覆送出帶著長前綴的請求,快取命中比例高時,實際輸入成本可以壓到牌價的一小部分;離線批次處理則直接半價。換句話說,同樣標著 $2/$6 的模型,在不同工作流裡的真實成本差距可能達到數倍,混合價 $5 只是一個便於比較的中央估計,不是任何一家使用者會實際付到的數字。
未定案的部分與值得追蹤的指標
這次第一有幾個尚未定案的角落。首先,Preliminary 標記與 ±19 區間意味著排名仍會移動,接下來一兩週區間是否收窄、榜首是否易位,是判斷這次登頂成色的直接指標。其次,這張榜衡量的是人類對前端產出的偏好,不等於代理任務的正確率、長程穩定性或安全性,選型時仍需交叉比對其他評測。第三,官方並未揭露 0902 相對前代改了哪些訓練內容,22 分的提升無法歸因到具體變更,只能作為結果觀察。
對持續追蹤的人,有三個值得看的後續:claude-opus-5-max 與 kimi-k3-max 是否以新一輪快照回應;開源基底 Qwen3.8-2.4T-A95B 與 Max 版本的行為差距是否有人做出系統性量測;以及混合價 $5 的位置會不會引發前排模型跟進降價。榜首輪替在這個市場已是常態,真正新的變化是「最高分」與「最低混合價」第一次同時落在同一個模型上——這才是 0902 這條新聞裡最值得記住的訊號。