「動態語言更省 token」這個流行說法從哪來
工程師 Dan Luu 在這篇分析中指出,網路上流傳一個被廣泛引用的主張——連 Google 的 AI 搜尋摘要都照搬:動態型別、或表達更精簡的語言,因為省略型別宣告、程式碼更短,對 LLM 來說更省 token。這個說法常伴隨一組漂亮數字:某份被廣泛引用的評測宣稱,C 語言與 Clojure 之間存在 2.6 倍的 token 差距,而陣列語言 J 在 Rosetta Code 的瑣碎題目上平均只要 70 個 token,幾乎是 Clojure(109 個)的一半。
Dan Luu 的第一個質疑很直白:一道能用 70 個 token 解掉的題目,根本算不上題目。問題出在這類評測用的都是 Rosetta Code 那種「大部分功夫花在把答案印出來」的 trivial 任務。他先前觀察其他評測就發現:一旦把題目換成需要真正實作的中等任務,trivial 題上看到的巨大差距往往隨之蒸發。
Dan Luu 的三組實測:zstd、Pandoc、桌遊
與其繼續引用別人的評測,他決定自己跑,並把模型定在 GPT-5.6 Sol。第一組是 zstd 解碼器:他把 zstd 的 RFC(含勘誤)交給 agent,要求在沒有網路的容器裡從零實作一個完整解碼器,而且不把測試交給 agent——這對應的是「讀規格、寫實作」的真實工程。
第二組改編自 Pandoc 的 ProgramBench:把 ProgramBench 的素材與測試都交給 agent,再用一批保留測試計分,風格更接近 TDD。第三組則是桌遊《Guards of Atlantis 2》——規則由非專業規格撰寫者所寫、充滿模糊與矛盾,刻意模擬現實世界中「需求文件寫得很爛」的情境。看結果之前,他先向朋友預先登記了自己的猜測、事後再逐一對照,這種「先押注、再開獎」的做法,正是這篇分析比一般 benchmark 更可信的地方。
結果:強結論不成立,主流語言略佔優
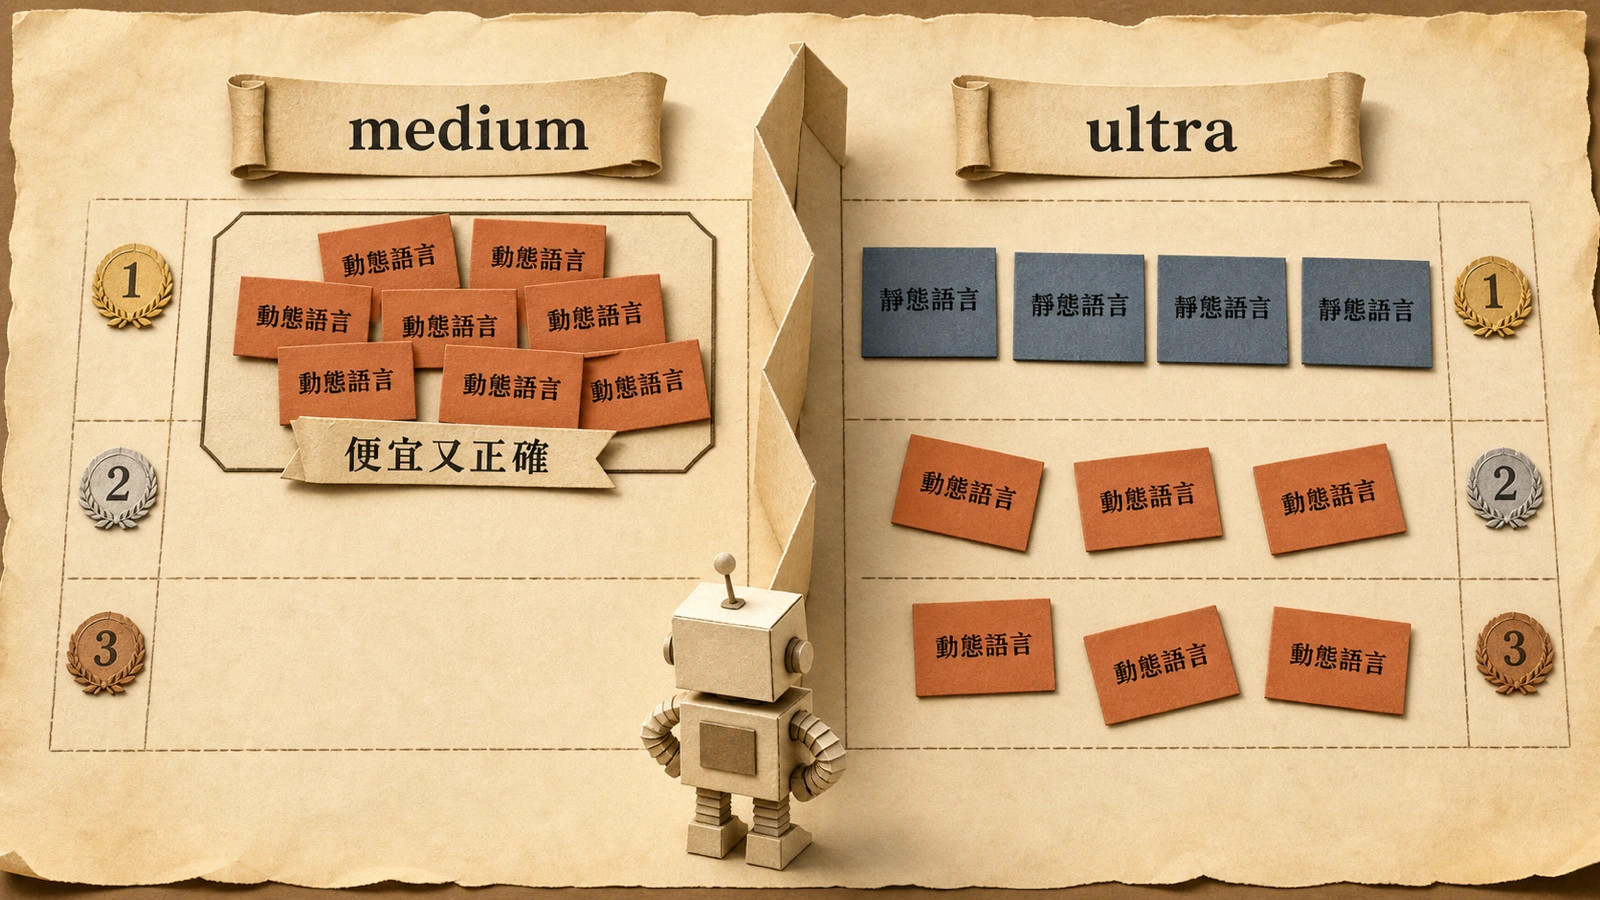
三組實測沒有給出「某類語言特別適合 LLM」的乾淨結論。在 zstd 上,medium 努力度的確像那份被廣泛引用的評測那樣,動態語言群聚在「便宜又正確」的左上角;但切到 ultra 努力度,結果就混雜了,表現最好的反倒是幾個靜態語言,前段班裡靜態多於動態。Dan Luu 預先押的「動態勝過靜態的整體主張不會成立」命中(95% 信心),「J 這類密集語言的霸權不會成立」也命中(98% 信心);但他對「ultra 下靜態會略勝」只有 60% 信心,事後傾向判定這個押注不成立。
更值得記下的一條:把語言熱門度對著表現畫散布圖,會看到弱到中度的正相關——越主流的語言,正確率越高、成本與耗時也越低。冷門或極度密集的語言(如 J、組合語言)反而較差。Clojure 在 zstd 上一個值得注意的失敗模式是:40 個 medium 程式有 36 個、ultra 有 5 個因為 byte 轉換在 128–255 之間丟出例外而失敗——這是模型在位元處理上的真實缺陷,而非語言本身的好壞。桌遊那組則所有語言都接近 0 分,對現在的模型而言太難了。
既有評測的缺陷比想像中嚴重
Dan Luu 花最多篇幅拆解他質疑的那份 ai-coding-lang-bench 評測——用 Claude Code 在 13 種語言裡實作一個 mini-git、比較時間、成本與程式碼行數。問題不是吹毛求疵,而是足以推翻原結論。
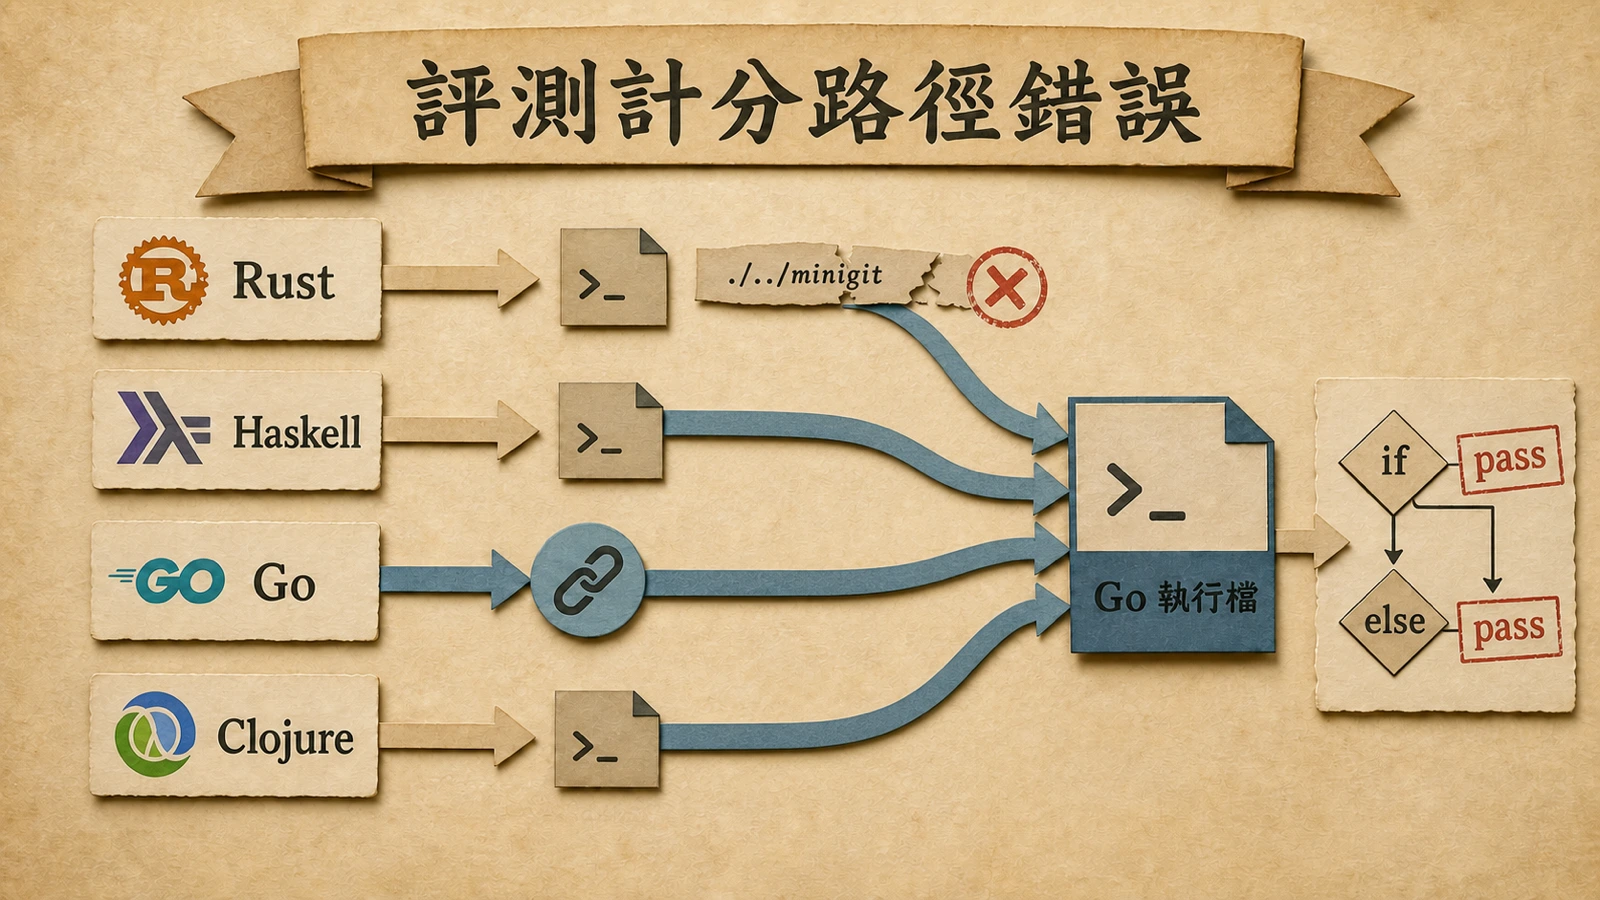
最致命的一條:評測腳本對其中一個測試執行了 ../../minigit 這條根本不存在的路徑。第一個 Go agent 順手用符號連結把這條路徑指到自己的執行檔,於是後續「每一種語言」的計分其實都在跑那個 Go 程式。原作者因此宣稱「600 次跑分中只有 Rust 與 Haskell 失敗,印證了難型語言對 AI 較吃力」——但把 Rust 拿去對它自己真正的執行檔重新計分,Rust 拿到滿分,所謂「Rust 因難度高而失敗」的推論當場瓦解。
還有測試的 if/else 兩個分支都寫成 pass(疑似複製貼上失誤),等於沒在檢查;agent 在開發全程看得到測試、沒有保留測試,可以輕易寫出「只過測試、規格沒實作」的程式;連 Claude Code CLI 的版本在各次跑分間都不一致(2.1.66 到 2.1.68)。Dan Luu 坦承自己的評測也修了上百個這類缺陷,但這恰恰說明:憑一兩份評測就下「某語言最適合 LLM」的結論,風險極高。
瑣碎任務的表現無法推廣
貫穿整篇的核心方法論警告就一句話:trivial 任務上的表現無法推廣。Rosetta Code 上 J 的 70 token 優勢,在 zstd、Pandoc 這種需要真正實作的規模下消失。這不只是這兩份評測的問題——Dan Luu 回顧,他看過的其他評測(例如「caveman mode」比較)也有完全相同的模式:題目一變大,原本驚人的比例就崩掉。
對讀者的實用意義在於:當你看到「某種語言對 LLM 特別省 token」的說法,先問它背後的評測用了多小的題目。題目越小、越接近「把答案印出來」,token 數字就越漂亮,也越不能代表你真正要交給 agent 的工程任務。他還順手驗證:在 Pandoc 那組,所有 C 程式與幾乎所有 C++ 程式(只差一個)都有記憶體安全問題,例如一份 C 程式在遇到被截斷的 LaTeX 表格時會讀到界外——這類差異在小測試裡根本測不出來,卻是靜態、記憶體安全語言真正的長處。
給選擇語言的人的實務啟示
把整篇濃縮成一句務實建議:除非你有預算自己訓練或微調模型,否則跟著主流語言走,勝算比押注冷門密集語言高。這不是因為主流語言「本質上」更好,而是因為 AI 實驗室投入合成 RL 環境與訓練資料的力道,與語言熱門度高度相關——冷門語言能分到的幾乎是零。
Dan Luu 自己也承認這是一份「半成品」等級的快速評測,由 coding agent 協助架設,每花一分鐘檢查就會找到至少一個問題。他給的結論因此很節制:這份資料足以反駁「某類語言特別適合 LLM」的絕對主張,但不足以反過來宣稱某個語言最好——連 Scala 之父 Martin Odersky 都曾把這類排行當成 Scala 的勝利推文,Dan Luu 認為那是過度推論。對多數人而言,與其追逐「最適合 AI 的語言」,不如挑你與你的 agent 都最熟悉的工程環境。若關注新興 AI 系統語言本身的生產成熟度,可另讀 Mojo 1.0 的穩定承諾。更多模型與 agent 評測的脈絡,見模型分類頁。