從 1% 到 98.6%:半年內發生的事
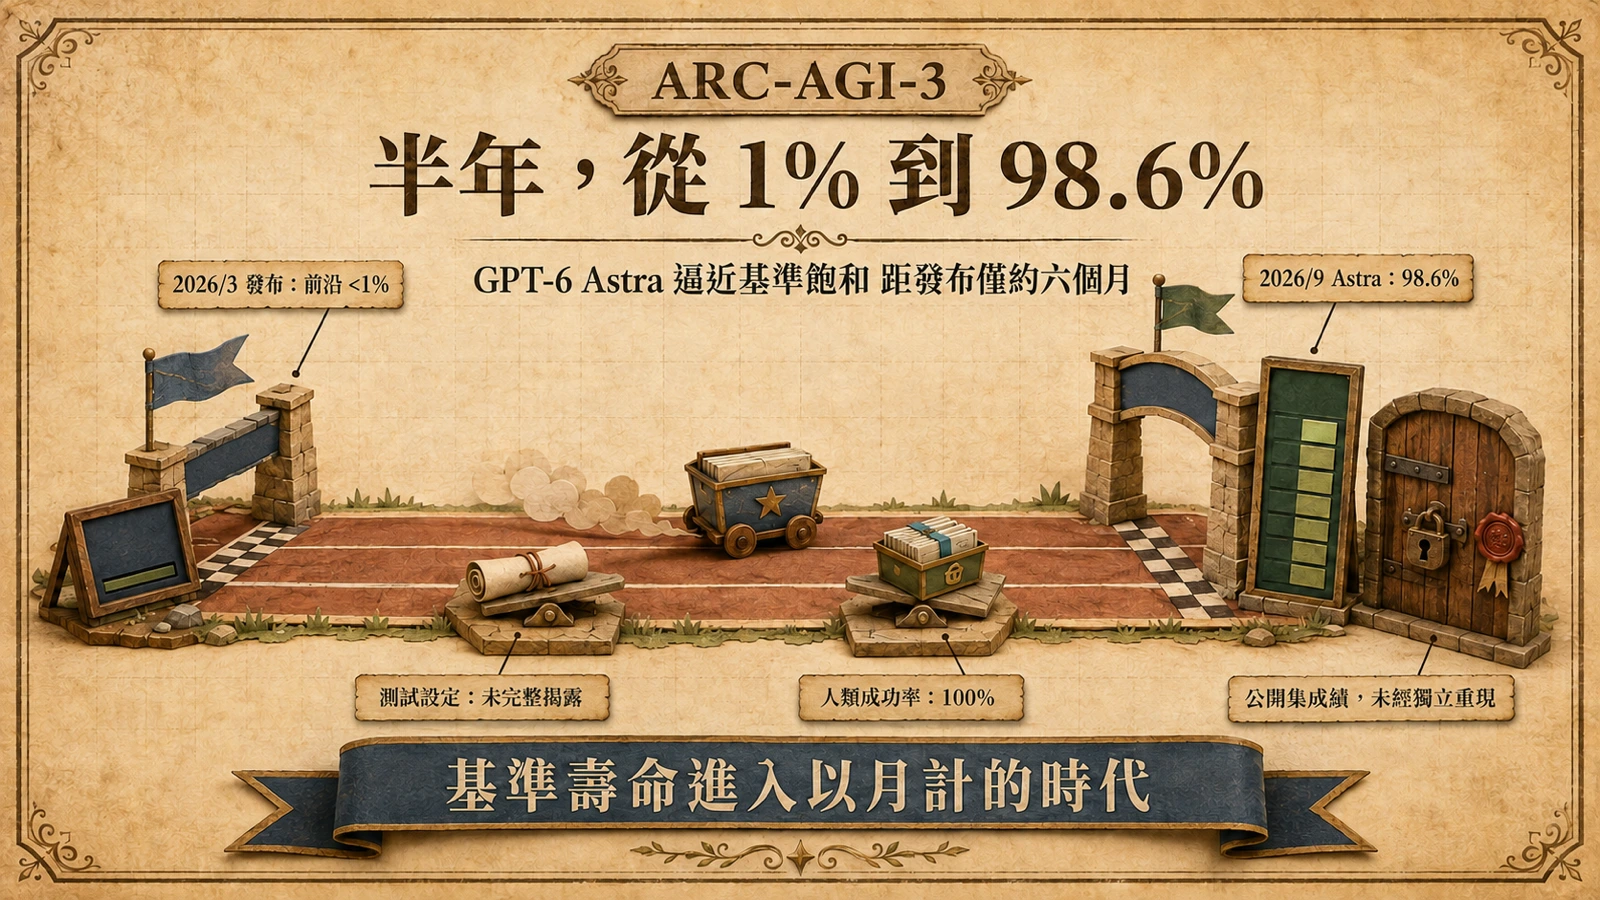
2026 年 3 月 24 日,ARC Prize 基金會在 arXiv 發表 ARC-AGI-3 技術報告,正式推出這個互動式評測。報告對難度毫不掩飾:人類測試者可以解開 100% 的環境,而截至 2026 年 3 月,前沿 AI 系統的得分低於 1%。基準設計者、共同創辦人 François Chollet 的原始構想,就是打造一個讓當時最強模型集體不及格的關卡。
半年後的 9 月初,OpenAI 發表次世代模型 GPT-6 Astra,並宣稱其在 ARC-AGI-3 公開集拿下 98.6%。The New Stack 的報導引述 OpenAI 的說法,這個數字較六個月前的 7.8% 大幅躍進。從「人類全對、AI 幾乎全錯」到「AI 幾乎全對」,中間只隔了約六個月。
這條曲線值得拆成三個問題來看:這個基準到底測什麼、分數靠什麼暴漲,以及 98.6% 上為什麼還掛著一個星號。
ARC-AGI-3 測的是什麼:不給說明書的遊戲
ARC 系列出自 François Chollet 的手筆。與前兩代最大的不同在於:ARC-AGI-3 不是一張靜態謎題卷,而是一套新奇的抽象回合制環境,代理必須在沒有明確指示的情況下探索環境、推論目標、建立環境動態的內部模型,並規劃有效的行動序列。
用白話講:把模型放進一個它從沒見過的小遊戲,不給說明書,看它能不能自己摸清規則、猜出過關條件,然後把遊戲玩贏。技術報告強調,環境只使用核心知識先驗(Core Knowledge priors),刻意避開語言與外部知識——模型背再多常識也幫不上忙,因為題目裡根本沒有可讀的字。它測的是 Chollet 一貫主張的「流體適應效率」:面對全新任務時的學習與應變能力,而不是知識存量。
這也是為什麼它發布當時被視為硬骨頭。人類校準測試中受測者解開了全部環境,前沿模型卻連 1% 都拿不到——這種量級的人機差距,在當下的主流基準裡已經很少見。
分數暴漲的引擎:記住推理、壓縮脈絡
分數是怎麼在半年內拉起來的?模型變強是原因之一,但 OpenAI 自己的官方文章揭露了另一個關鍵變數:harness(評測腳手架)的設定。
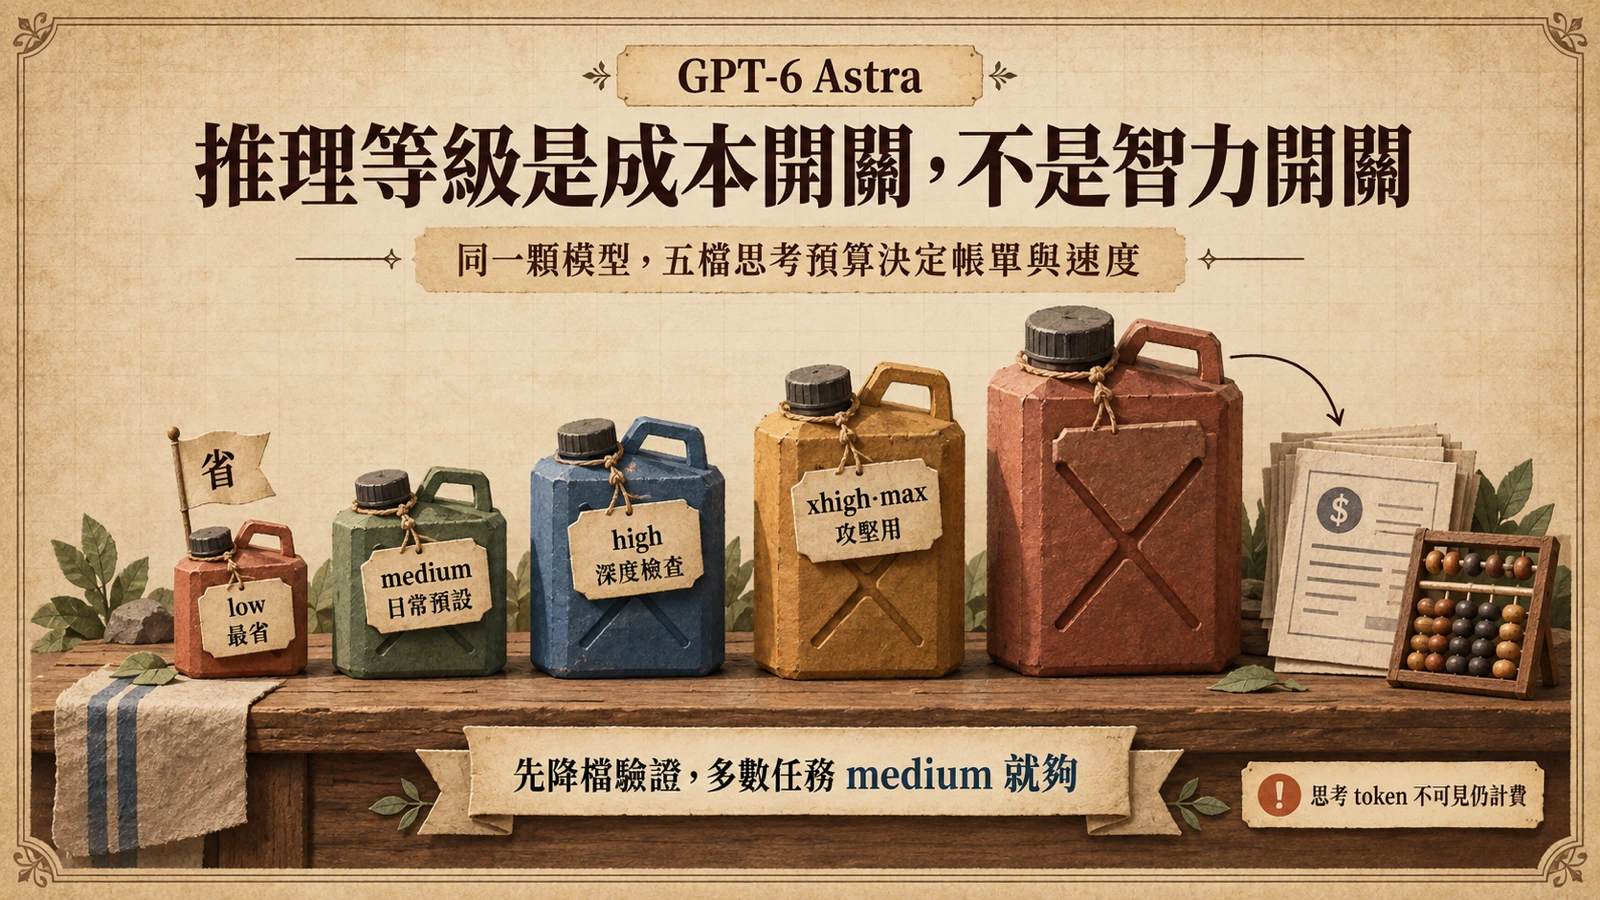
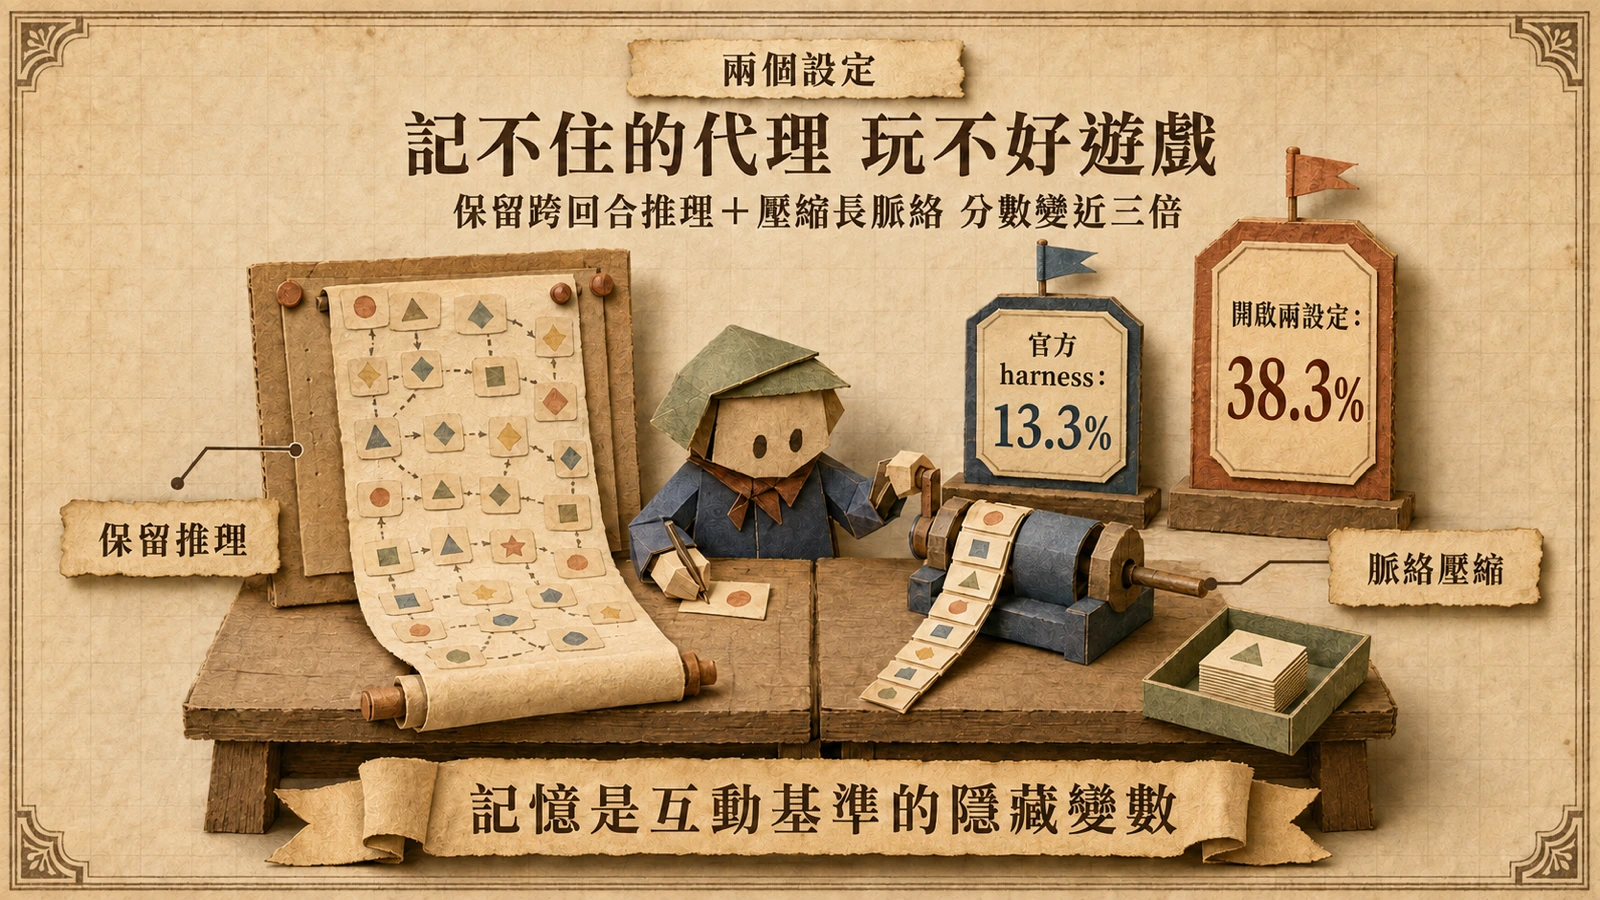
OpenAI 在官方部落格中說明:以官方 harness 跑 GPT-5.6 Sol,在 ARC-AGI-3 公開集得到 13.3%;開啟「跨回合保留推理」(retained reasoning)與「脈絡壓縮」(compaction)兩個設定後,同一個模型衝上 38.3%——兩個 API 層級的開關,讓分數變為近三倍。
這兩個設定為什麼有效?回到基準的本質:ARC-AGI-3 是長程互動任務,代理在同一局遊戲裡要連續嘗試大量動作,邊玩邊學。官方 harness 預設在回合之間丟棄模型的推理內容,等於每換一回合就把代理的學習筆記擦掉,它必須從頭重推環境規則。保留推理讓模型記得前幾回合學到的事;脈絡壓縮則把越玩越長的軌跡摘要收納,避免撐爆上下文視窗。一個讓記憶留得下來、一個讓記憶放得進去——這兩件事正是互動式基準最吃重的工程條件。
飽和不是一天造成的:harness 戰線早已開打
把時間軸攤開看,98.6% 不是某個早晨的奇蹟,而是一整條戰線推進的結果。
6 月,一篇 arXiv 研究用「可執行世界模型」路線打 ARC-AGI-3:代理為環境寫出可執行的 Python 模型、用過去的觀察驗證它、再透過模型規劃行動。該論文報告,GPT-5.5 high 完整解出 25 個公開遊戲中的 15 個,平均每局 RHAE 達 58.12%。NVIDIA 更進一步,官方開發者部落格宣布 AVO 架構在 ARC-AGI-3 達到 100%,並將其定位為長程自主代理的前沿級通用架構。模型側同樣在跳:7 月下旬 Claude Opus 5 發布時,其 ARC-AGI 3 得分已是次優模型的三倍。
把這幾塊拼起來會看到清楚分工:模型負責更強的即時推理,harness 負責補上跨回合學習的外部條件。Astra 的 98.6% 站在這條推進線的末端——它同時拿出了更強的模型,與保留推理式的評測設定。
星號怎麼讀:設定未揭露與私有集未測
那麼,ARC-AGI-3 算是被飽和了嗎?OpenAI 的數字有理由讓人興奮,但 The New Stack 在標題裡把提醒講白了:星號比分數更重要。
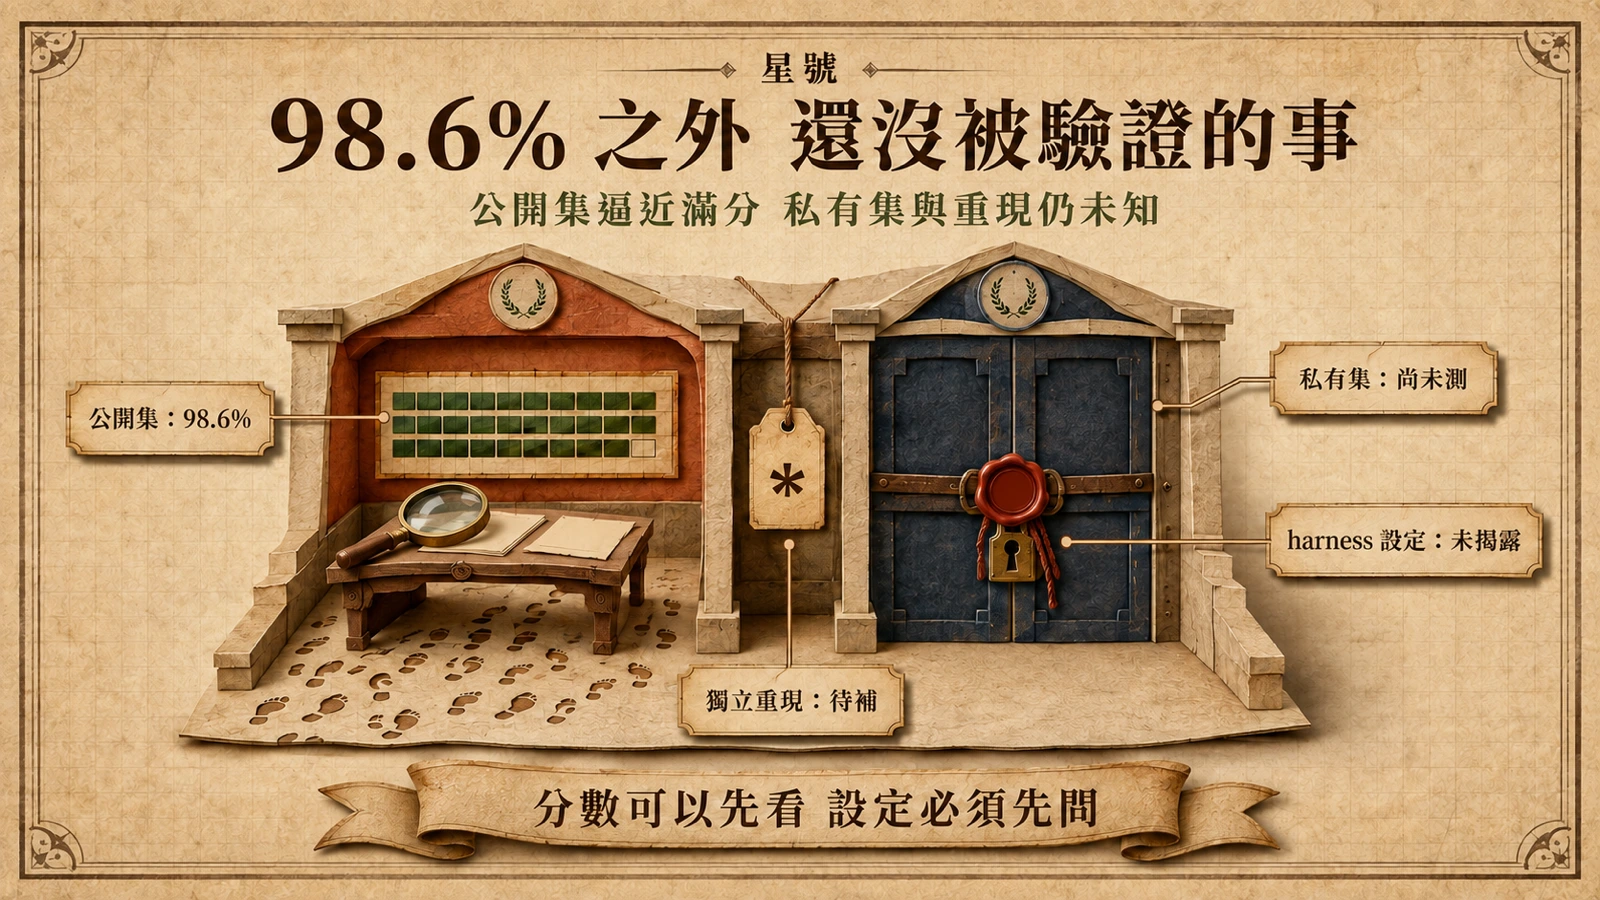
第一個星號是測試設定。OpenAI 自己的數據已證明,官方 harness 與自訂設定之間可以差到近三倍;而 Astra 的 98.6% 是在什麼 harness、哪些 API 設定下跑出來的,並未完整揭露。在這種條件下,98.6% 與其他模型的公開集成績並不直接可比——你不知道差距有多少來自模型、多少來自腳手架,harness 條件的影響已被官方前後對照量化。
第二個星號是集合。ARC-AGI-3 分為公開集與私有驗證集,公開集是所有人都能反覆研究的題目,也最容易成為針對性最佳化的目標。前述世界模型研究的作者就明言,私有驗證集尚未開放、成績仍有待測試。在私有集出現數字之前,「飽和」嚴格說只發生在公開集上。
第三個星號是可驗證性。推理過程不透明、獨立重現尚未出現,98.6% 目前仍是單方說法,等待官方排行榜或第三方以可查驗的條件重跑。
對開發者與評測閱讀者的所以呢
對正在評估要不要把新模型排進工作流的開發者,這次事件給的不是「立刻換模型」的答案,而是三個檢查動作。
第一,看到任何基準分數先問三件事:測的是公開集還是私有集、用哪個 harness、開了哪些 API 設定。這三個條件任何一個變動,分數都可能差好幾倍——13.3% 對 38.3% 就是活生生的例子。
第二,OpenAI 揭露的兩個設定本身就是可用的工程知識。長程、多回合的代理工作流——無論是資料清理、爬查還是營運任務——都可以對應實作:讓推理狀態跨回合保存、把歷史軌跡壓縮成摘要再帶入下一輪。這是少數有官方前後對照數據支撐的架構建議。
第三,單一基準不值得當採購依據。ARC-AGI-3 測的是新奇環境的流體適應力,與編碼、寫作、客服等日常場景的相關性,仍需要用自己的評測集驗證。
要完整理解 Astra 這條產品線,可以把三件事並排:它先前以內部版本推進十道長期未解的數學難題,發布前又因資安關鍵能力評測暫停 RL 訓練兩週,現在再添一筆基準飽和的速度紀錄。能力躍遷、安全煞車與評測壽命,從此是同一個故事的三個面。
接下來追蹤什麼
四個指標決定這個故事的下一章。其一,98.6% 是否以官方 harness 條件進入 ARC Prize 排行榜,讓它與其他模型在同一把尺下可比。其二,私有驗證集上的第一個數字何時出現——那是分辨「學會解題」與「學會這套題」的關鍵。其三,基準方如何回應:把 harness 條件納入計分規則、把揭露要求寫進提交規範,是下一輪攻防的焦點。其四,對整個產業而言,當基準壽命以月計,任何建立在「某模型在某基準領先」之上的結論,都該標上保存期限。