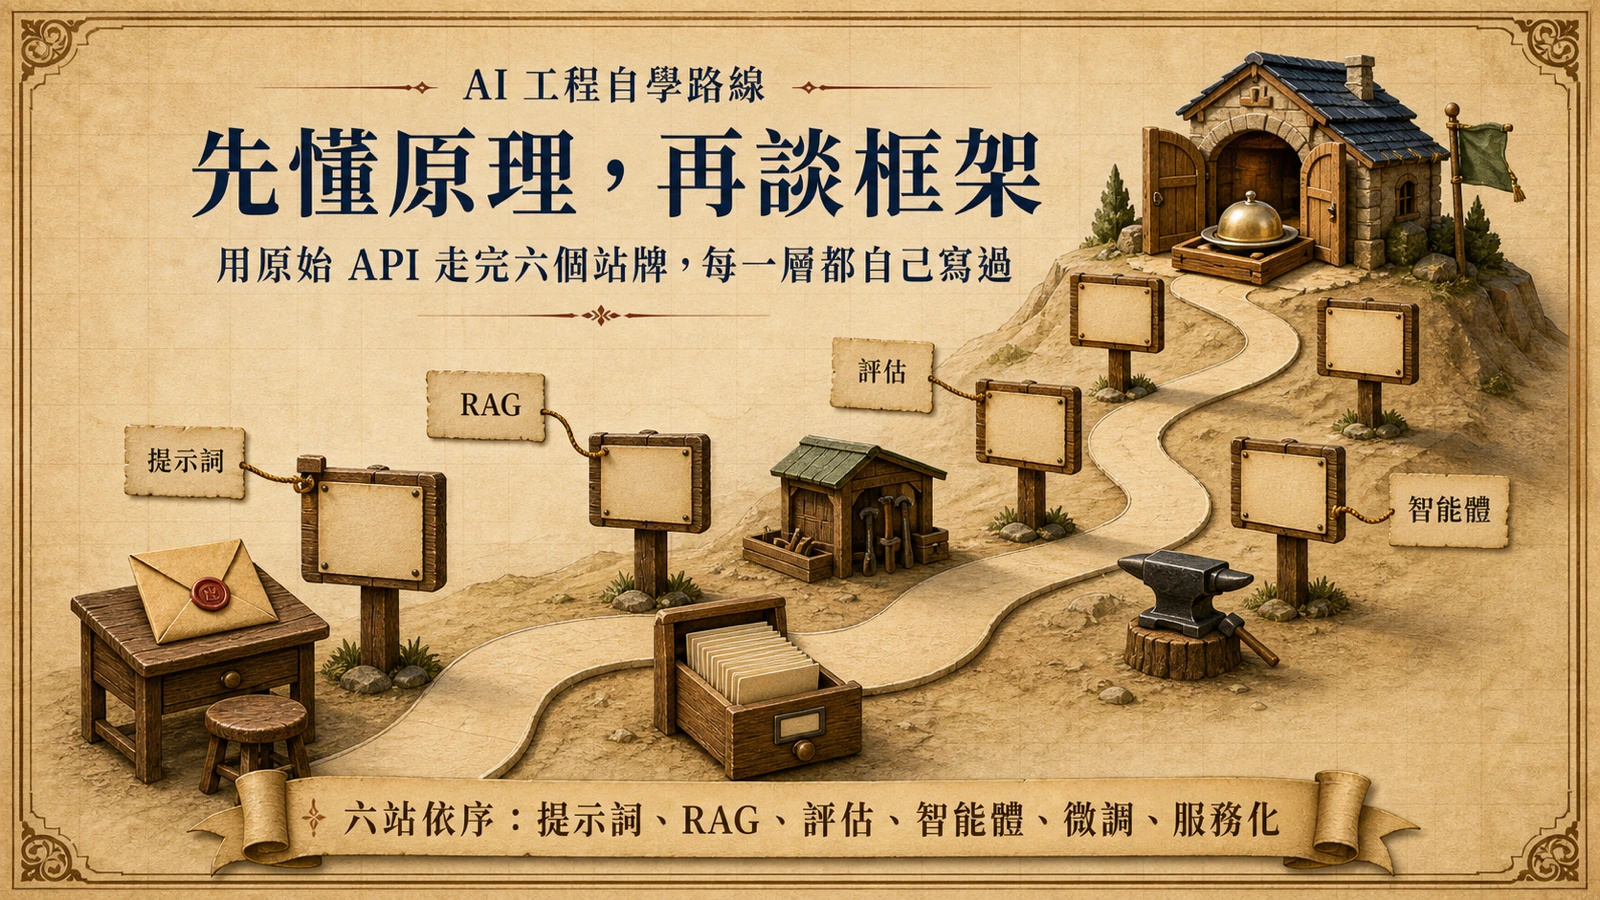
為什麼第一課是「先不裝框架」
學 AI 工程最常見的岔路,是第一週就裝上框架。LangChain、LlamaIndex 這類工具在生產環境有它們的位置,但作為第一課,它們把最值得親眼看到的東西藏進了抽象層:請求怎麼組、上下文怎麼塞、工具結果怎麼回填。剝掉框架之後,呼叫一個大型語言模型的真相非常樸素——對一個 HTTP 端點送出 JSON、拿回另一個 JSON。
這件事不需要任何框架,瀏覽器裡的雲端筆記本就夠。Android Police 對 Colab 的定義是「一套網頁式的 Jupyter 筆記本環境,讓你直接撰寫並執行 Python 程式」,也是 AI 與機器學習專案最常使用的環境之一;繁中入門教材同樣把它定位為 Google 提供的免費雲端運算環境,底層就是互動式 Jupyter 平台。於是起步成本被壓到兩樣東西:一支 API 金鑰、一份筆記本。工具鏈愈短,出錯時能懷疑的對象愈少——這在學習階段是優點,不是缺陷。
把提示詞當成可量測的輸入
第一個要建立的習慣,是把提示詞當成「可量測的輸入」,而不是咒語。模型 API 的交談介面本質上是一個 messages 陣列:system 訊息定義角色與規則,user 與 assistant 訊息輪流出現;所謂 few-shot 範例,就是把正確的一問一答直接寫進這個陣列,讓模型照著格式走。溫度參數控制取樣的隨機程度,同一個提示詞配不同溫度,輸出的穩定度會明顯不同。
具體練法:在筆記本裡準備十到二十個固定題目,寫兩個版本的提示詞,各跑一遍、並排放著比對。哪一版比較好,看的不是單一輸出的觀感,而是整批題目的通過率。這個「固定題目、比較版本」的習慣,會直接延伸成後面的評估流程——差別只在規模與嚴謹度。
用三十行程式手寫一個 RAG
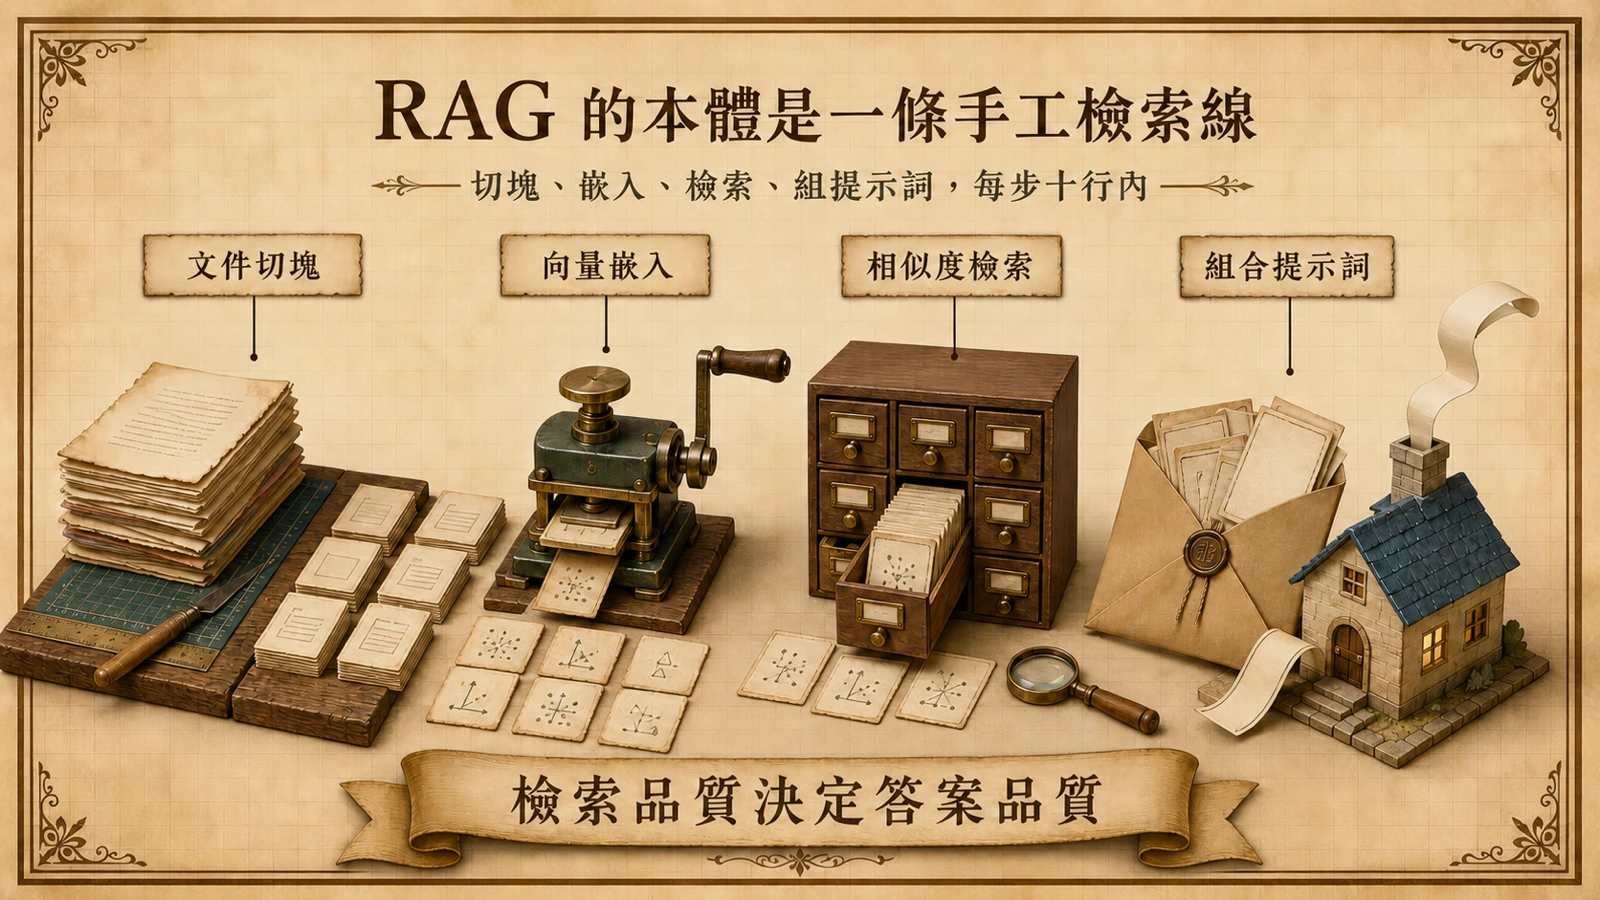
RAG(檢索增強生成)聽起來像一個產品,拆開來是一條任何人都能手寫的流水線,總長度三十行以內。第一步切塊:把文件切成數百字左右的區塊。第二步嵌入:呼叫嵌入端點,把每個區塊變成一條向量——語意相近的文字,向量在空間裡也相近。第三步檢索:使用者提問時,把問題同樣變成向量,用餘弦相似度(兩向量點積除以範數乘積)找出最相近的幾個區塊;這一步用 numpy 就能寫,練習階段完全不需要向量資料庫。第四步生成:把檢索到的區塊連同問題塞進提示詞,要求模型只根據這些材料作答。四步各是十行內的程式,卻已覆蓋 RAG 的全部骨架。
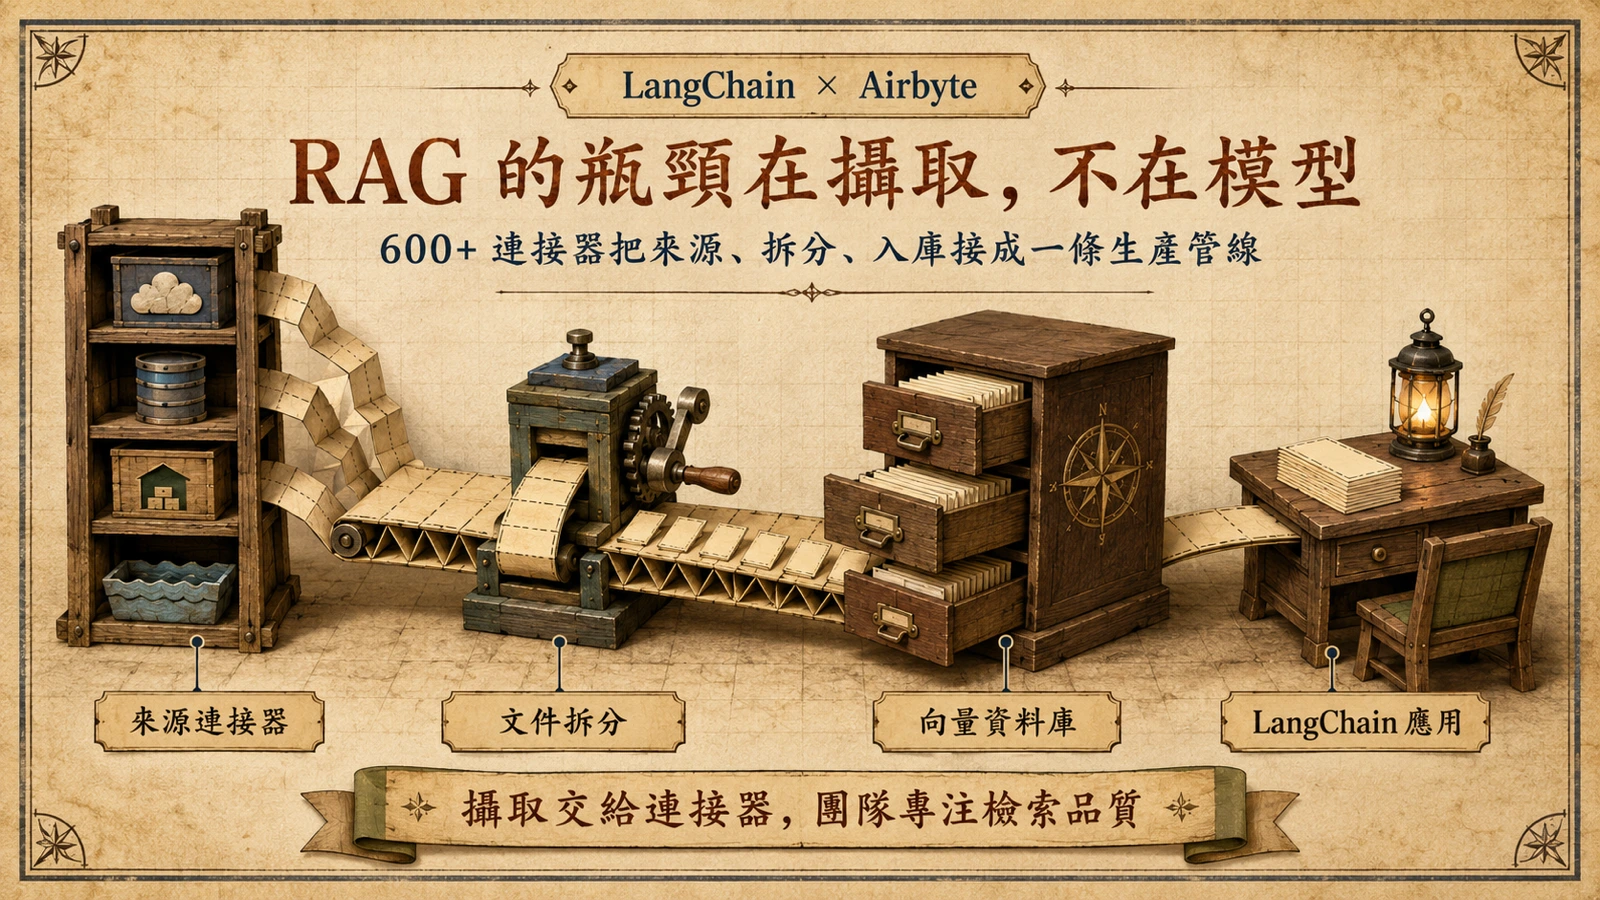
Google Cloud 的架構文件中心也維護整組以 RAG 為骨幹的生成式 AI 架構指引,從向量搜尋到圖資料庫都有專章——但那些是規模化之後的事。手寫版本的價值在於:當檢索品質不好時,你確定知道要調的是切塊大小、嵌入模型還是提示詞,而不是在某個框架的設定檔裡亂試。要理解多步檢索如何從這條骨架長成產品,可對照 Mistral Agentic Search 的五工具流程;當文件來源變多、資料持續變動,攝取與同步就該交給現成生態,站內先前的 LangChain × Airbyte 生產級攝取做法則是那個階段的參考。
評估先行:沒有測試集的提示詞都是猜的
沒有測試集,所有提示詞修改都只是猜。評估不需要平台,需要的是紀律:固定一組二十到五十題的測集,每一題寫下可檢查的期待,之後任何修改都重跑同一組題目。計分有兩個層次:確定性檢查(答案是否包含關鍵事實、格式是否正確)優先;需要主觀品質判斷時,才用另一個模型照評分規則當評審。但要誠實面對這種審判的偏誤——它偏好較長的答案、容易被流暢的語氣說服,所以固定比例抽樣人工複查不可省略。
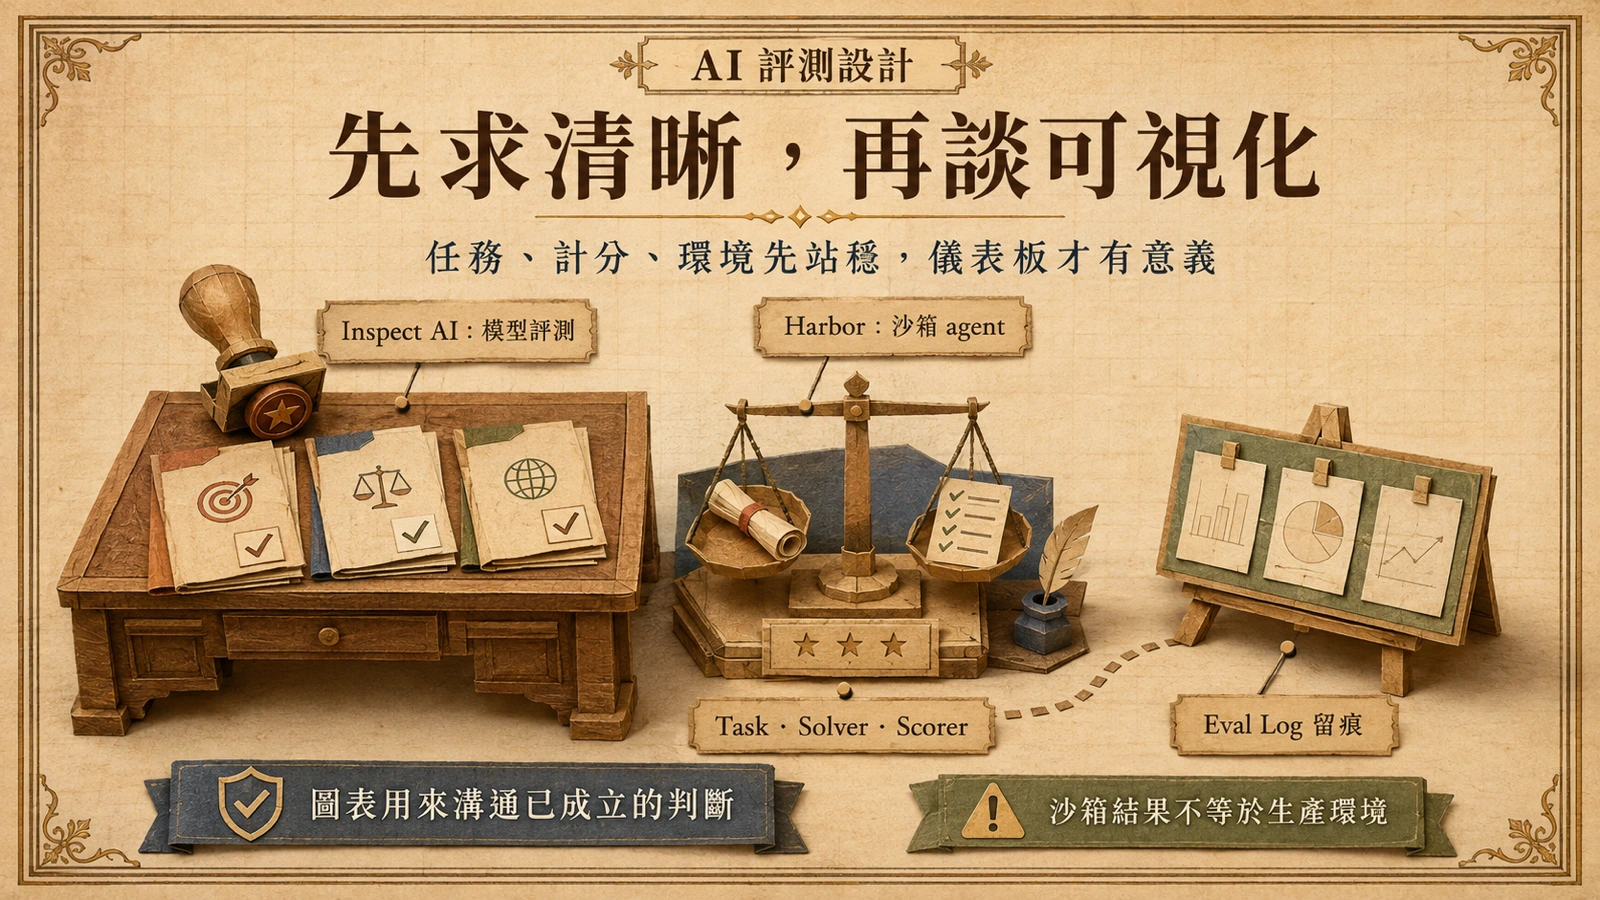
這套流程在筆記本裡就是幾個 cell:一個放測集、一個放提示詞版本、一個跑分並印出失敗案例。當測集長大、需要沙箱環境與可回查的執行紀錄時,再升級到正式的評測框架——站內介紹過的 Inspect AI 與 Harbor 實作指南,走的正是「先求清晰、再談可視化」的同一條紀律。
智能體:一個迴圈加一組工具
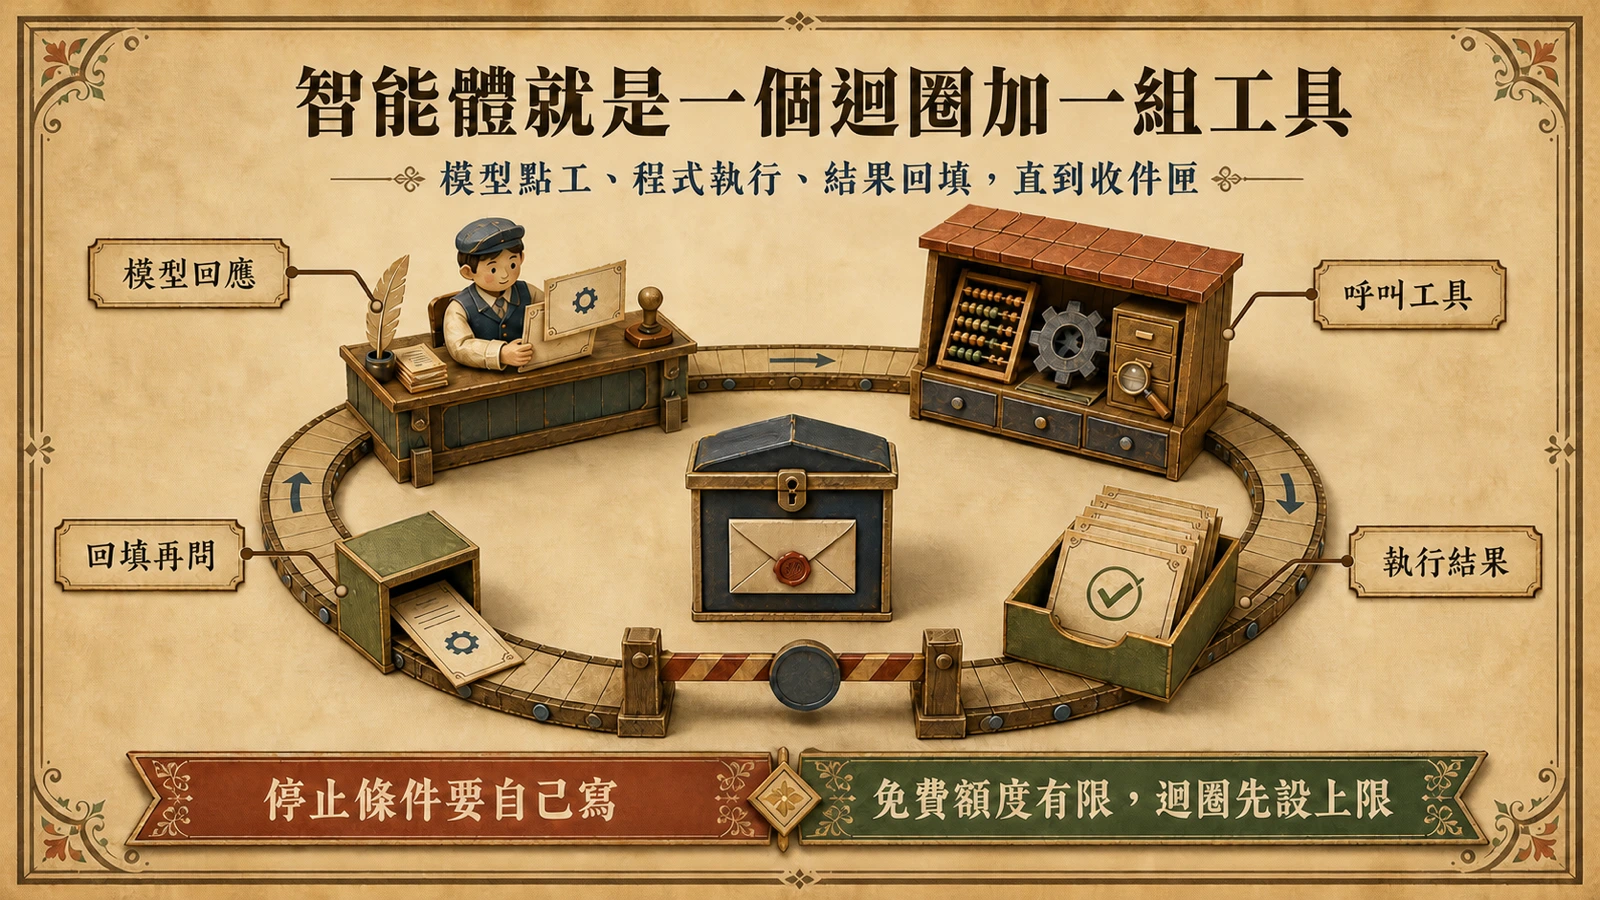
「智能體」是這個領域最常被神祕化的詞,它的本體卻是一個 while 迴圈。流程是:先把工具定義清楚——名稱、用途說明、參數的 JSON 結構——連同使用者的問題一起送給模型;模型不直接回答,而是回覆「請幫我呼叫某工具,參數如下」;你的程式碼執行這個呼叫,把結果以工具訊息回填給模型;模型看完結果,可能再點下一個工具,也可能給出最終答案。所謂 agent,就是把這一來一往包成的迴圈。
親手寫過一次之後,框架裡的 Agent 類別就不再是黑箱——它幫你做的是工具註冊、訊息輪替、錯誤重試與停止條件這些行政工作。企業端看智能體的角度也很務實:Google Cloud 架構中心把「實現資料科學工作流自動化」列為智能體 AI 的代表性用例之一,重點是讓工作流自己跑完,而不是對話本身。工程上有一件事必須自己負責:停止條件。最大輪數、token 上限、連續失敗即中止——沒有這些,一個打轉的迴圈會把額度燒完才停。
LoRA 微調:提示詞與檢索都不夠的時候
當問題出在「模型的行為」而不是「模型的知識」,提示詞與檢索都會到頂。要模型穩定遵循某種格式、某種語氣、某個領域的判斷方式,這時才輪到微調。LoRA(Low-Rank Adaptation)是入門成本最低的路線:凍結預訓練權重,只在每一層注入成對的小型低秩矩陣,訓練這些矩陣就等於學習任務需要的權重更新。提出這個方法的論文量測,可訓練參數可減少約一萬倍、GPU 記憶體需求降到約三分之一,而且訓練後可合併回原模型,推論不增加延遲。
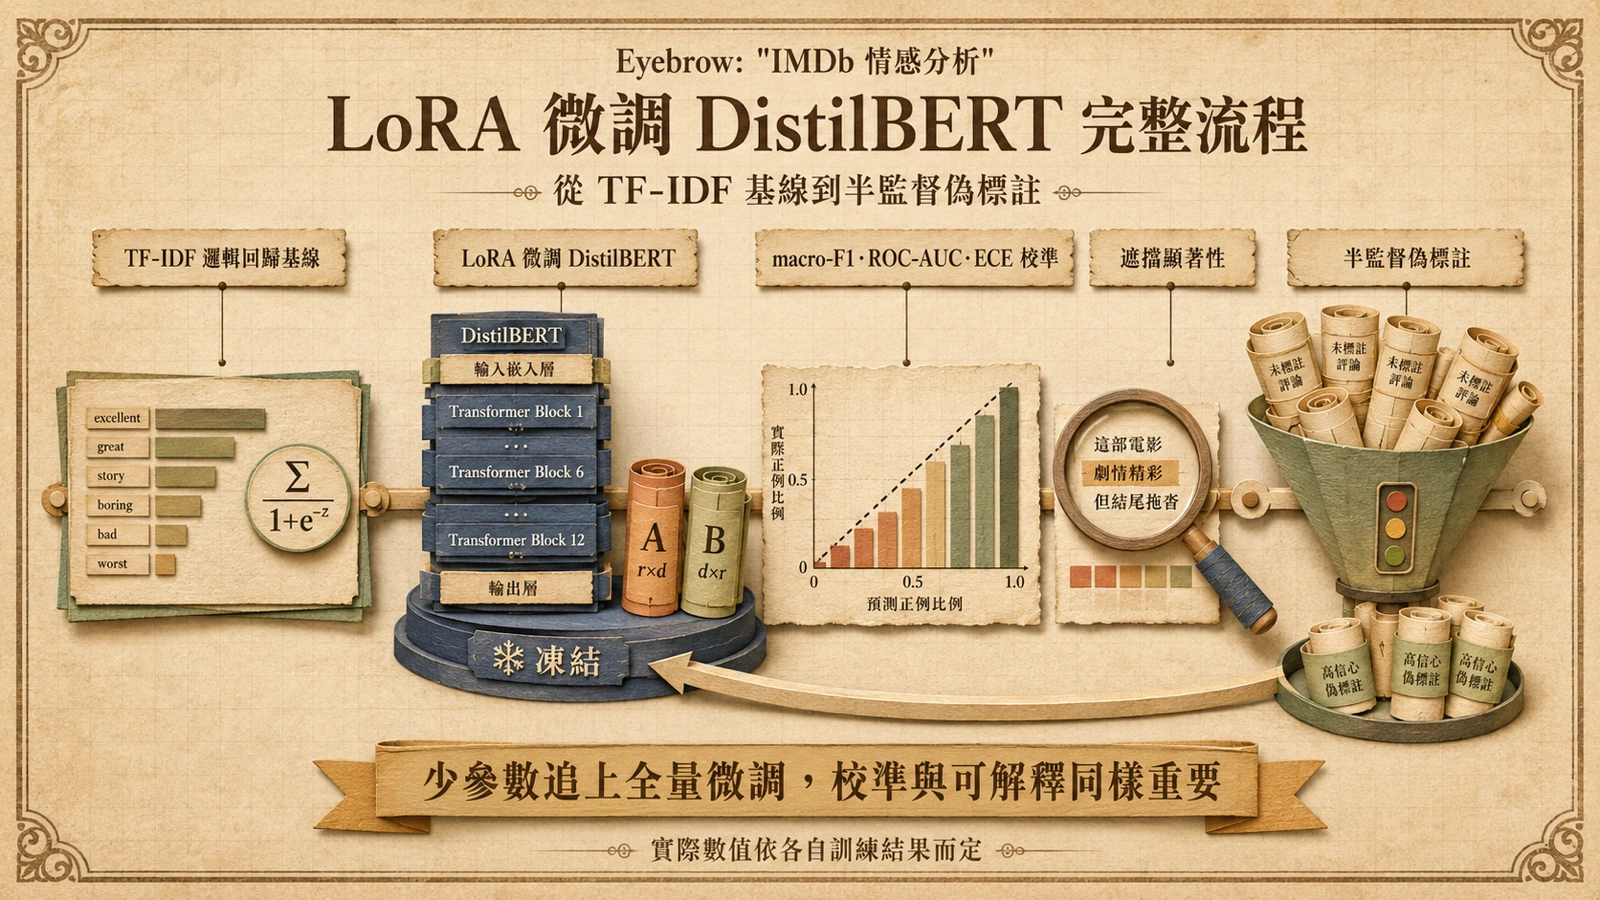
這些數字讓「在免費 GPU 筆記本裡微調一個小型開放權重模型」成為可行的練習,例如以知識蒸餾縮小、沿用 WordPiece 分詞器的 DistilBERT 這一級的模型。站內先前的 IMDb 情感分析實作走完了從 TF-IDF 基線、LoRA 微調到置信度校準的整條流程,可作為微調專題的延伸。判斷順序保持簡單:缺知識先用 RAG,改行為才微調;兩者可以並用,但不該混用動機。
從筆記本到服務:最後一哩比想像中短
最後一哩比多數人想的短。把筆記本裡的 cell 改寫成函式,用 FastAPI 包一層端點,就是一個可部署的服務;因為全程沒有框架依賴,整個專案的相依套件往往只有一個 HTTP 客戶端函式庫與幾個小工具。這也是原始 API 路線在維運上的回報:手上就只有一個 HTTP 呼叫,換模型供應商時改的是端點位址與金鑰,而不是整條管線;除錯時要看的東西也一樣少——請求的 JSON、回應的 JSON、中間自己寫的那幾十行。
服務化的練習題很實際:把手寫的 RAG 包成一個 POST 端點,輸入問題、輸出附引用的答案,再加上重試與逾時,就是一個最小的產品雛形。做到這一步,六個站牌——提示詞、RAG、評估、智能體、微調、服務化——就全部親手走過一遍。
這條路線的限制與回頭學框架的時機
這條路線有明確的邊界。免費雲端筆記本的資源與連線時數有限,大型嵌入批次與長迴圈要分次跑,重要輸出要即時存檔而不是留在記憶體裡;筆記本的執行環境每次重啟都是新的,資料與套件要能重抓、重裝。手寫也意味著重試、退避、逾時、觀測這些生產必備的雜事全在自己身上——練習時它們是學習素材,上線後就是負債。
更誠實的說法是:框架的價值會隨規模回來。當資料攝取要排程、檢索要快取、多模型要路由、評估要常態化執行,現成生態的密度就超過手寫的合理邊際。所以判斷回頭的時機很簡單:當你發現自己反覆在寫同樣的重試與攝取邏輯,而且能說得出框架每一層在幫你做什麼——那就去用框架。這條路線的目標從來不是反框架,而是讓你在框架出錯時,知道該去哪一層找原因。更多開發工具面的報導,整理在工具主題分類。