礦世界變考場:813 個人工驗證多跳任務
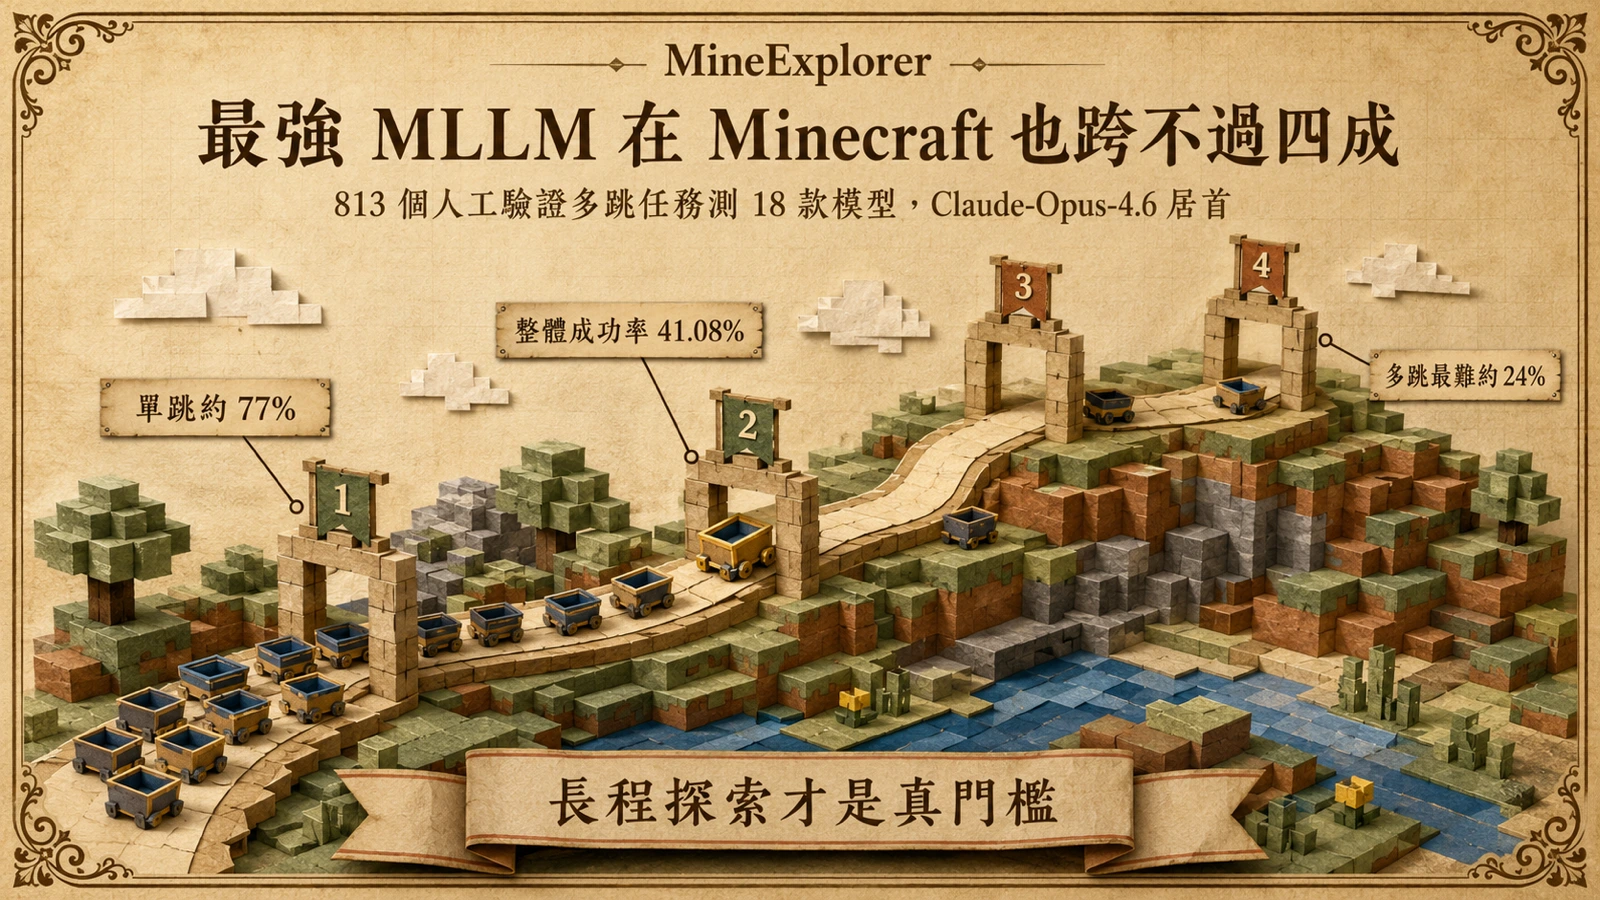
arXiv 2605.30931 由 LongCat 團隊等研究者發表 MineExplorer 基準,鎖定一個過去被忽略的問題:多模態大模型(MLLM)能不能在動態開放世界裡維持分鐘級的長程探索。團隊先從 3,382 個 Minecraft 任務中剔除過度依賴遊戲特定知識的項目,留下 1,497 個「知識可控」原子任務,再以多智能體合成流程組合成 813 個一跳至四跳的人工驗證實例,並用規則化里程碑評估器逐階檢查進度。關鍵設計是把任務難度藏在「隱性前置條件」裡——代理人必須自己推斷要先做什麼、再去哪裡找資源,而非把答案直接寫在提示中。
18 款 MLLM 實測:最強仍只過四成
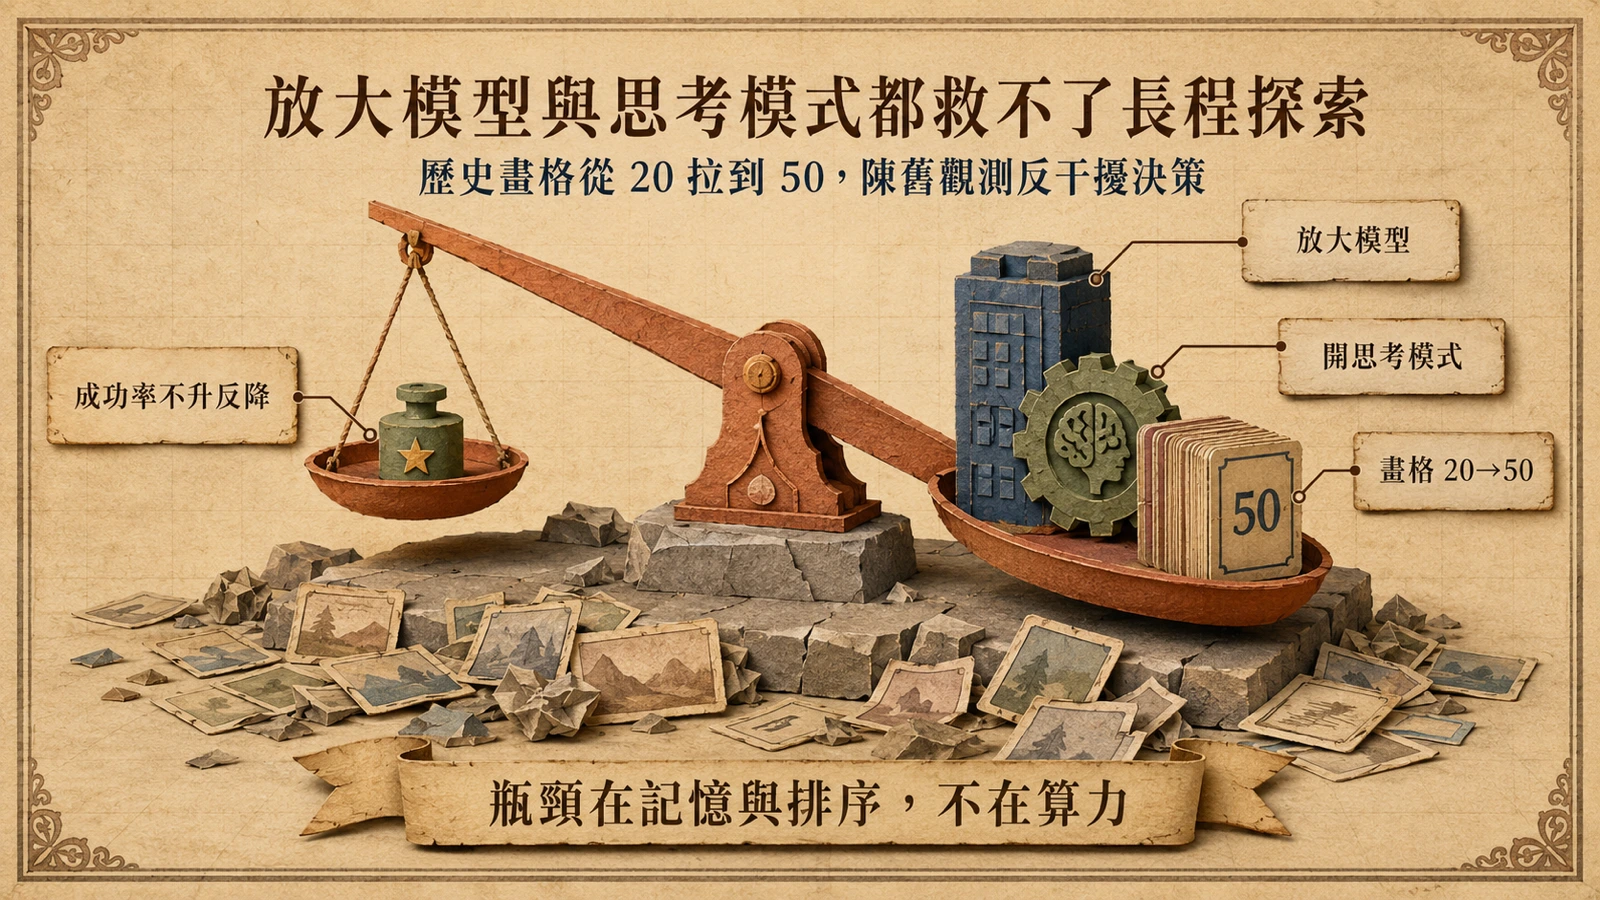
論文評測涵蓋 18 款主流 MLLM,涵蓋 Anthropic Claude 全系列、OpenAI GPT 系列、Google Gemini 系列、Qwen-3-VL、Doubao-Seed-2.0-Pro、GLM-5V-Turbo、Kimi-K2.6 與 LLaMA-3.2-90B-Vision。結果顯示 Claude-Opus-4.6 與 Gemini-3.1-Pro-Preview 表現最強,但 Claude-Opus-4.6 整體成功率也只有 41.08%;單跳任務約 77% 過關,到了需要協調多個隱性前置條件的多跳場景,最難一檔驟降至約 24%。論文進一步指出,放大模型或開啟思考模式並未穩定換來更好成績,把歷史畫格緩衝從 20 拉到 50 反而因陳舊觀測干擾當下決策而變差。感知分數普遍高於推理分數,代理人看得見物件,卻常無法決定下一步。
放大模型與開思考模式為何失效
MineExplorer 最反直覺的發現,是「放大模型」與「開啟思考模式」這兩條當前最常見的能力提升路徑,在長程探索上幾乎失效。論文顯示,從較小模型放大到 Claude-Opus-4.6,整體成功率只推到 41%;在同一模型上開啟思考模式也未帶來穩定提升。更值得注意的是歷史畫格緩衝的實驗:把可見的過去畫格從 20 拉到 50,成績反而下滑——原因不是模型「看不到更多」,而是陳舊觀測混入當下決策,讓代理人根據已過時的環境狀態行動。這組結果共同指向一個結構性問題:長程探索的瓶頸不在單步推理的深度或感知的廣度,而在能否正確維護與更新一份「目前世界處於什麼狀態、我正在哪個子目標上」的動態表徵。堆疊算力與拉長上下文無法直接解決這個問題,反而可能注入更多雜訊。
感知強、推理弱的診斷意義
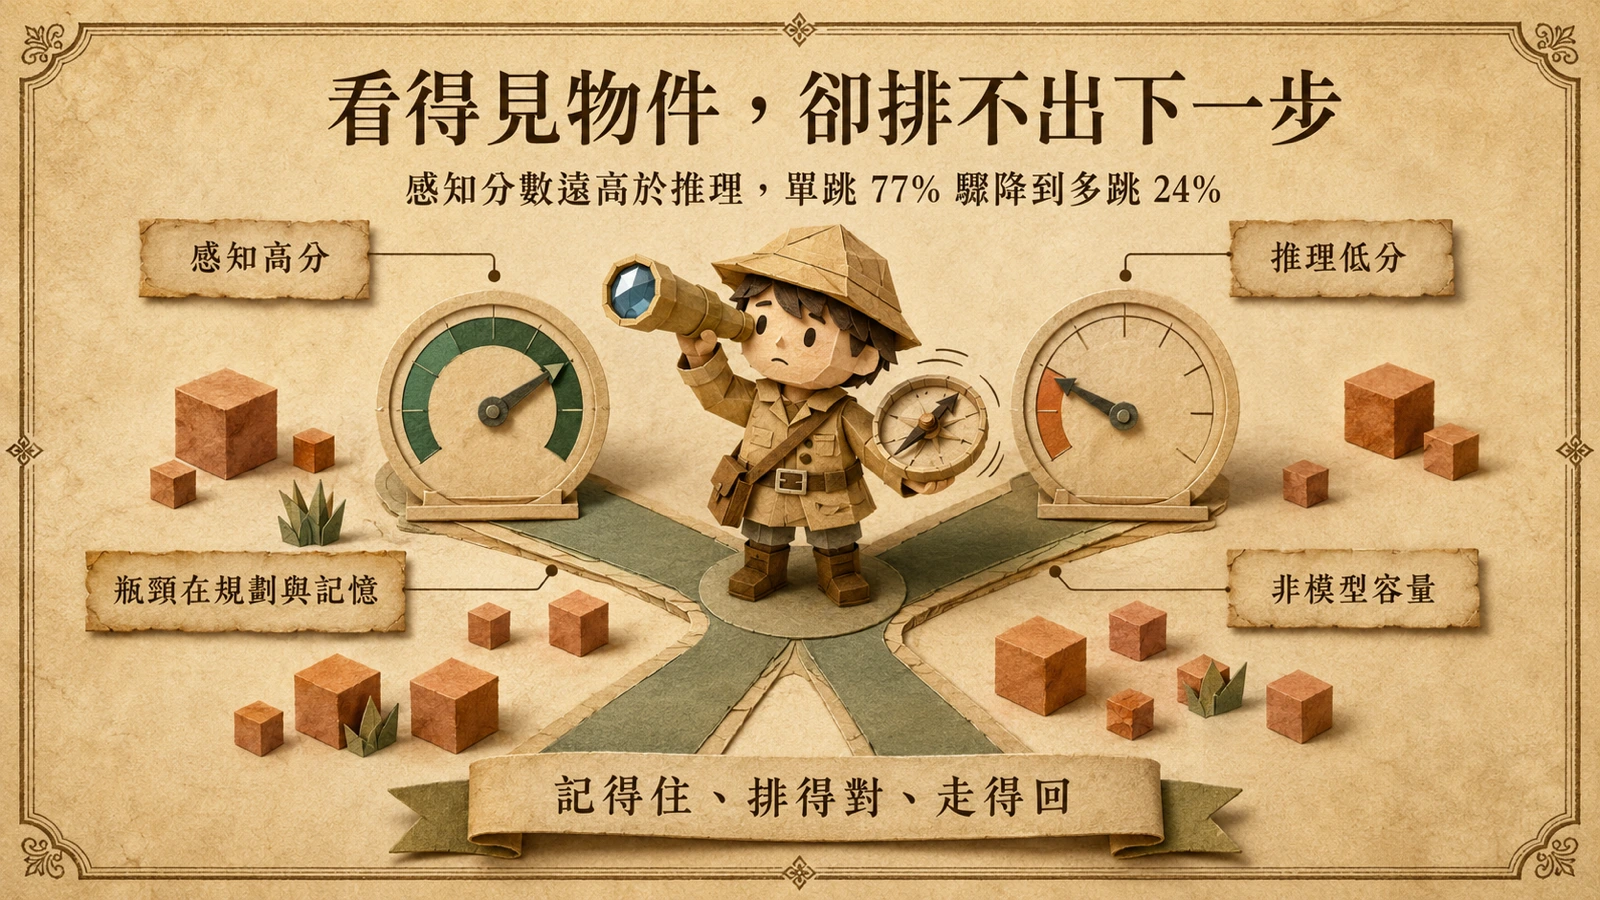
論文另一個值得拆解的訊號是感知分數普遍高於推理分數:代理人大多能正確辨識眼前有什麼物件,卻常無法決定下一步該做什麼。這個落差把「具身智能」的困難定位得很精確——視覺理解已不是主要短板,真正稀缺的是把「看見的物件」轉譯成「正確動作序列」的規劃與記憶能力。在多跳場景中,代理人還需自行推斷隱性前置條件(例如要先有工具才能採礦、要先到特定地點才有資源),任何一環判斷錯誤都會讓整條任務鏈斷裂。最難一檔從單跳的約 77% 驟降到約 24%,跌幅遠大於模型規模差距所能解釋,進一步印證瓶頸的性質是組合性與時序性,而非容量。對研究方向選擇而言,這暗示下一階段的突破更可能來自記憶架構、子目標排序與回溯機制的設計,而非單純更大的模型。
所以呢:長程探索才是真門檻
MineExplorer 把「分鐘級、多跳、隱性依賴」明確化為可量測指標,等於對業者遞出一份警訊:當前 MLLM 在短程問答與單步工具使用上看似強悍,一旦要在持續變動的環境中串接多個子目標,仍接近隨機失敗。對於押注具身智能、自動代理人與遊戲/機器人決策的團隊而言,瓶頸不在「看得見」,而在「記得住、排得對、走得回」,見〈FLUX-mimic 的 Audi 部署〉。若要看另一條改善多模態代理的方法,可延伸閱讀以語音、螢幕與標註組成完整「任務」上下文的互動設計。論文程式碼與資料集已由 meituan-longcat 團隊公開,便於後續以同一座標軸追蹤長程探索進展。