五個月第四版:Muse Spark 1.3 正式上線
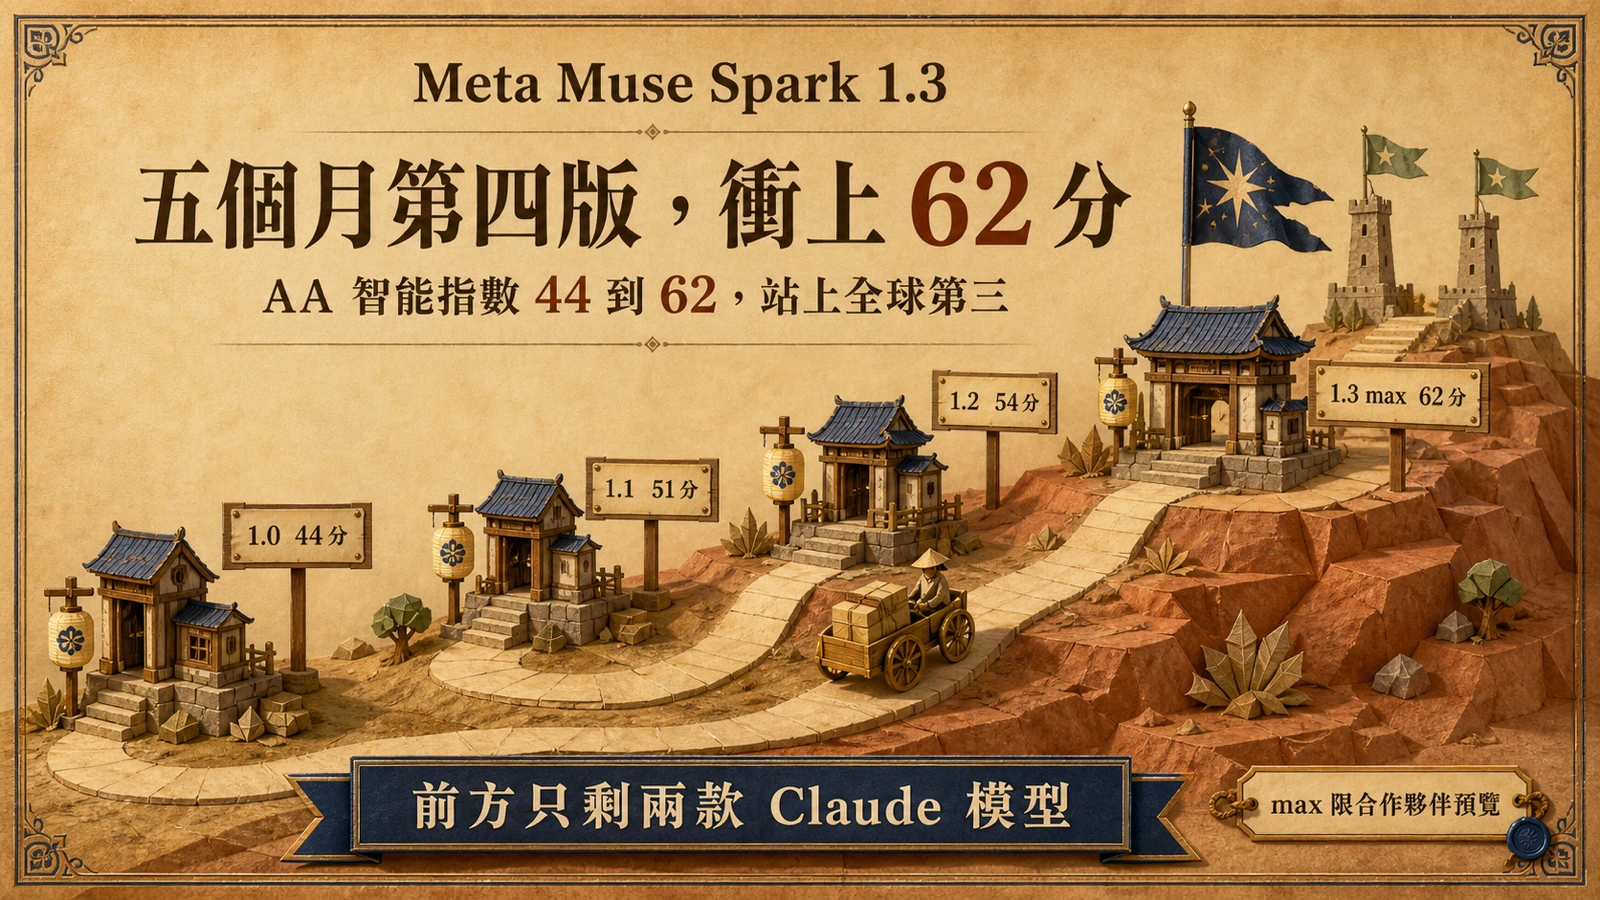
Meta 超級智慧實驗室(MSL)9 月 2 日(週三)發布 Muse Spark 1.3,是這條產品線五個月內的第四個版本。回看節奏:4 月 8 日的原始 Muse Spark 確立了 MSL 背離 Llama 的閉源起點;7 月的 1.1 帶來 Meta Model API 的開發者預覽;8 月 5 日的 1.2 隨終端編碼代理 Muse Code 登場;1.3 在一個月後接棒。據Meta 官方發布文章,1.3「在代理與編碼任務上帶來效能提升」;Meta 開發者頁寫得更白:模型為代理工作流而訓練、針對競技級編碼效能最佳化,開發者可以期待更高的首次嘗試成功率。
取用管道與定價都延續上一代:1.3 已進駐 Muse Code 與 Meta Model API,token 單價不變。與其問「這次多了什麼功能」,更值得注意的反而是改版節奏本身——多數前沿實驗室以季為單位推旗艦,Meta 把版本週期壓到五、六週,把「追趕」做成了一條生產線,而不是一場單獨的事件。對正在評估模型選型的團隊,這意味著任何針對 Muse Spark 的結論都有約一個月的有效期限。
44 到 62:Artificial Analysis 榜上的追分曲線
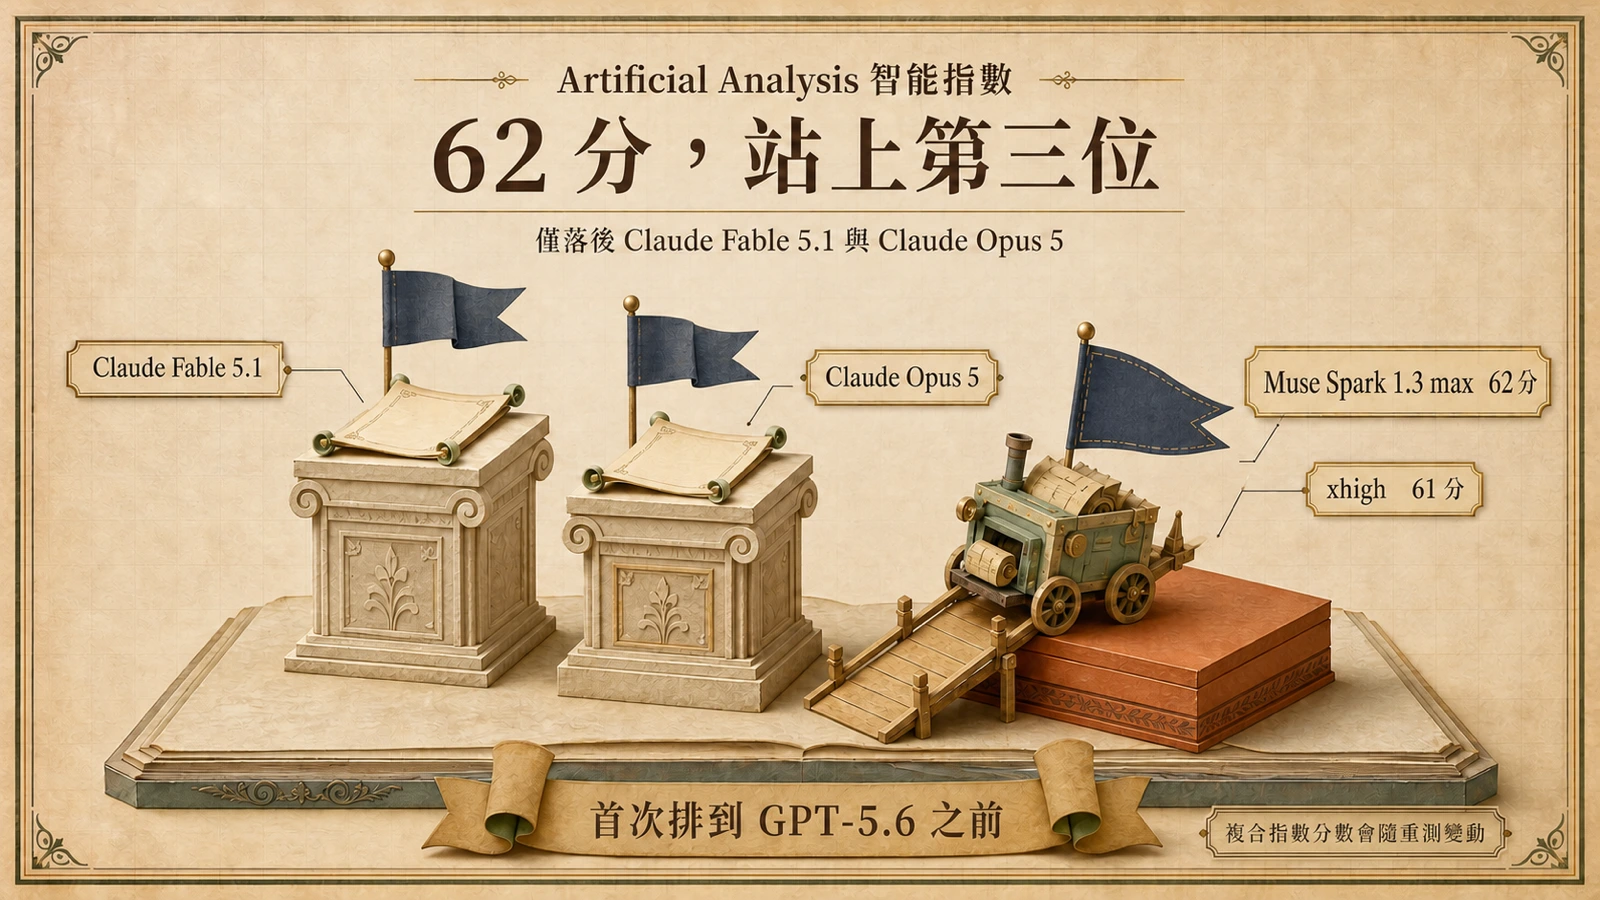
獨立評測機構 Artificial Analysis 的智能指數(Intelligence Index)是一個複合基準,其模型頁說明該指數橫跨推理等多個面向加權計分。把 Muse Spark 家族放上這條軸,曲線相當陡:1.0 得 44 分、7 月的 1.1 得 51 分、8 月的 1.2 得 54 分,這條追分軌跡見於 Gigazine 整理的 AA 分數曲線;到了 1.3,一般開發者可用的 xhigh 變體得 61 分,限合作夥伴預覽的 max 變體得 62 分。五個月、四個版本、18 分。
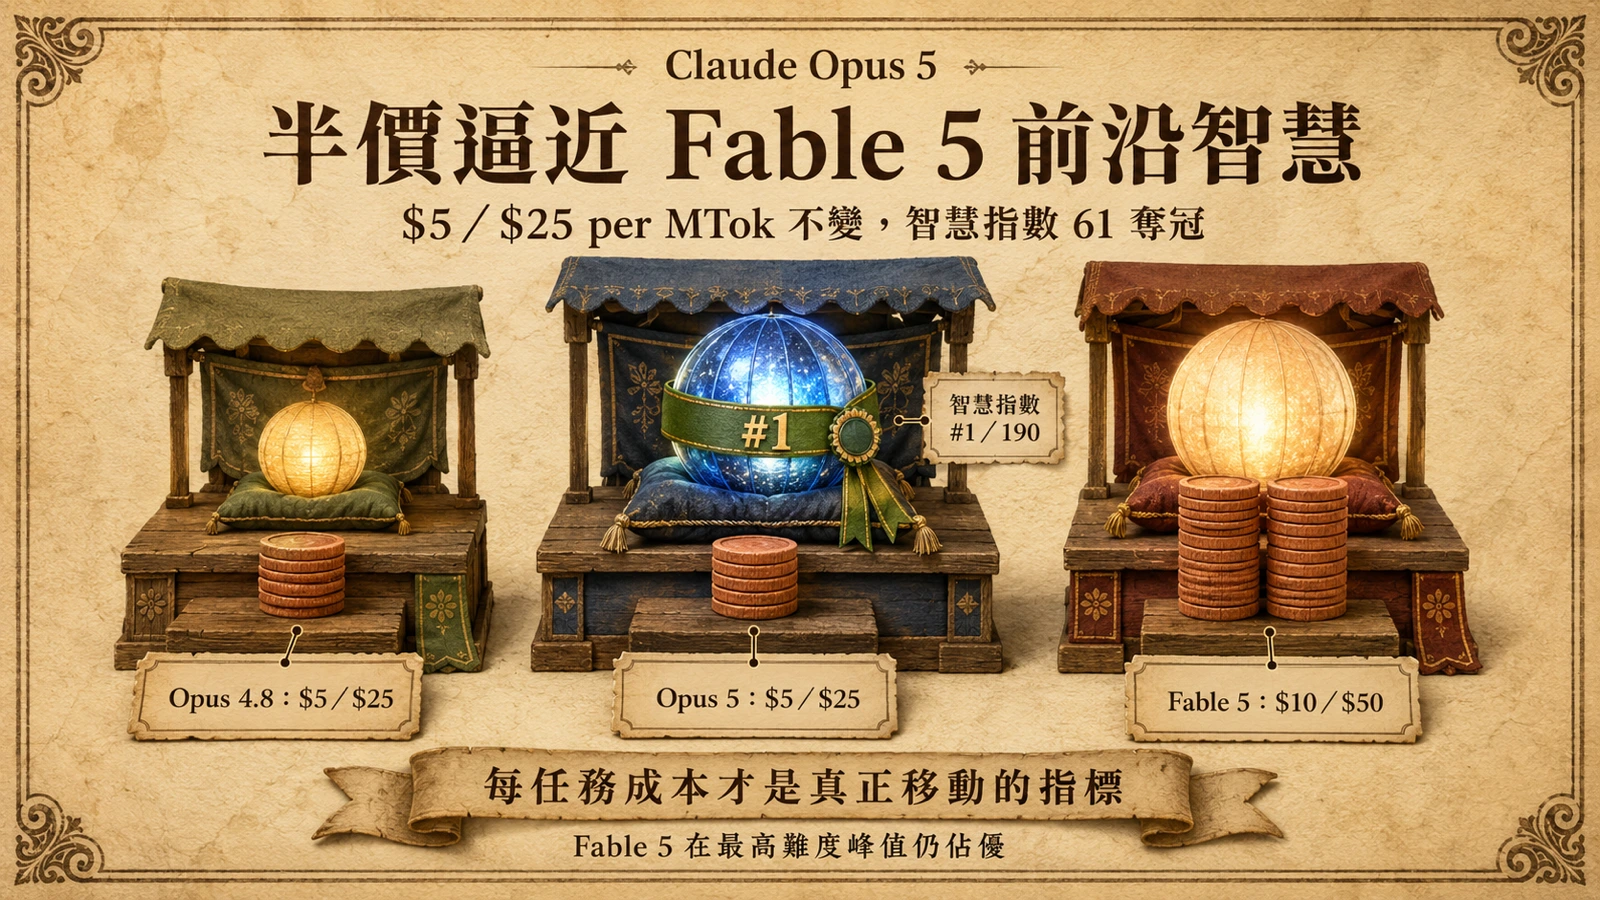
位置比幅度更重要。據 Artificial Analysis 的發布,62 分的 1.3 max 在該榜上「僅落後 Claude Fable 5.1 與 Claude Opus 5」——換句話說,在這個複合指數上,Muse Spark 首次排到 GPT-5.6 Sol 與 Gemini 系列之前,擠進全球前三。對一家今年 4 月還常被描述為掉隊的公司,這是榜單結構的實質變化,而不是邊際修正。
不過複合指數本身就是個需要小心的工具。它把多個公開基準加權成一個總分,好處是防止任何單一榜單被過度解讀,代價是細節被平均掉——一個模型可以在某個子項特別突出而總分平平,也可能相反。AA 的發布也未同步列出前方兩款 Claude 的具體分數,1.3 落後的差距是一分還是五分,從現有資訊無從得知,而這個數字恰恰決定了該讀成「追上」還是「逼近」。
xhigh 與 max:最強變體先給合作夥伴
xhigh 與 max 是同一模型的兩種推理強度:思考預算不同、輸出 token 數不同。1.2 世代就已有 xhigh 變體,1.3 保留它給所有開發者,新增的 max 則只在 Meta 合作夥伴的限時預覽中供應。把最強變體先留給夥伴,如今是前沿實驗室的共同做法——算力緊俏時,最貴的推理優先餵養自家產品與簽約客戶,一般 API 用戶排隊等開放。
對 Meta,這一步有兩層含意。算力經濟上,max 的推理成本高,限縮供應等於控制支出;商業上,「最強版本暫時拿不到」本身就是把企業推向合作方案的推力。對照 Meta 一路鋪陳的個人超級智慧願景,max 先進夥伴預覽,合理推測是優先服務需要長程穩定度的內部與合作場景。可以確定的是:短期內想在 API 上用到 62 分那個版本,門票不是價格,而是合作關係。
這與整個前沿市場的走向一致:當最強模型成為稀缺資源,訪問權本身取代價格成為分層工具——誰先拿到、以什麼條件拿到,比單價更能決定競爭位置。我們先前對前沿 AI 訪問權稀缺化的分析指出,頂級算力與最強變體正在向簽約夥伴與大額客戶集中;max 的限時預覽,是同一個趨勢在 Meta 身上的最新實例。
價格不變、成本結構在變:token 用量的兩本帳
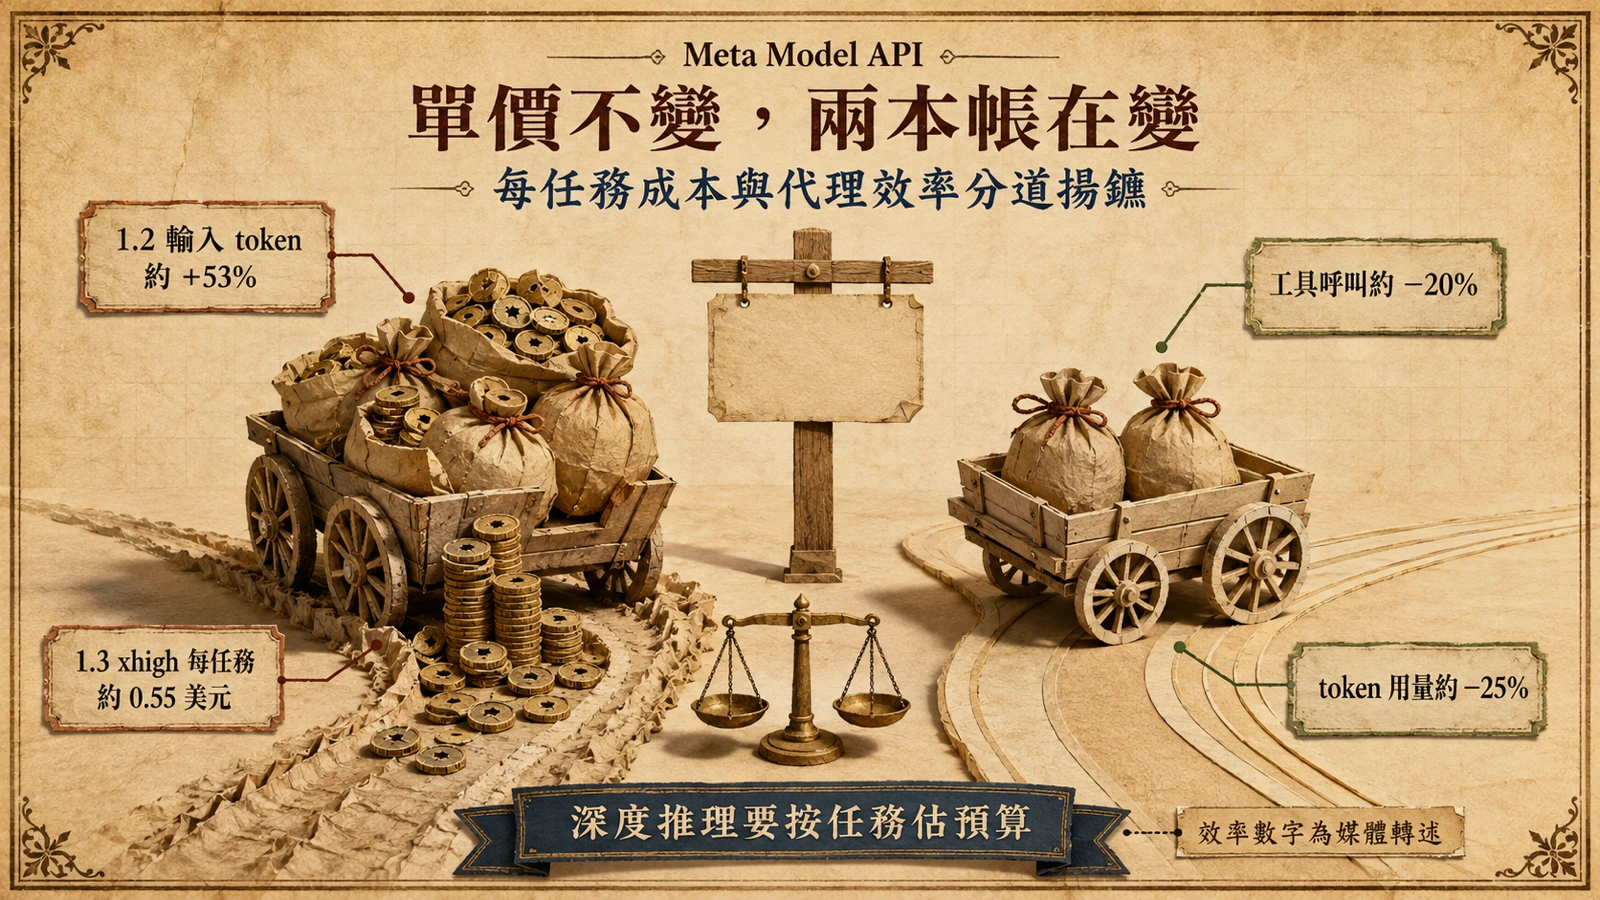
token 單價確實沒動:每百萬輸入 1.25 美元、輸出 4.25 美元,與 1.2 相同。但單價不等於帳單。AA 對 1.2 的成本分析指出,1.2 每任務成本較 1.1 的 0.29 美元上升,原因不是調價,而是每個任務吃掉的輸入 token 增加約 53%;同一套量測下,1.3 xhigh 的每任務成本來到約 0.55 美元——推理變體把省下來的往返,花在了更長的思考上。
另一本帳方向相反。據 Crypto Briefing 報導,Meta 稱 1.3 在編碼代理場景的工具呼叫減少約 20%、token 用量減少約 25%。兩者並不矛盾:AA 的指數任務量的是「把難題做到對」的總開銷,Meta 的數據量的是「代理完成工程任務」的互動效率。對開發者的實際意義是:跑深度推理的場景,預算要按每任務成本估,不能只看單價表。
與 Claude 的差距:從自家基準全敗到榜上第三
一個月前,Meta 在自家發布的三張基準圖上全數落後 Claude Opus 5:Terminal-Bench 2.1 是 82.9% 對 86.7%、DeepSWE 1.1 是 59.3% 對 65.0%、內部編碼基準是 70.6% 對 79.4%。一個月後,AA 的複合指數把 1.3 max 放在僅次兩款 Claude 的位置。這兩件事可以同時為真,因為它們量的東西不同:單項編碼基準量深度,複合指數量廣度——推理、數學、多輪指令與代理任務加權後的總分。Meta 開發者頁同時宣稱 1.3 在 SWE-Bench Verified 等真實編碼任務上超越更大的閉源模型;這類自報數字在上一代就伴隨方法論疑點——1.2 的部分進步來自更換了量測用的 harness——獨立複核出現之前,宜當方向參考而非定論。也因為單一榜單的排名變動參考價值有限,把多張榜單折成共識排名的方法,值得在決策時一併考慮。
開發者現在能用什麼:管道、價格與資料條款
實務上,今天就能用到的 1.3 只有 xhigh:Muse Code 與 Meta Model API 皆已可供使用,Muse Code 用戶升級後即可碰到新模型;這個終端代理在 macOS 與 Linux 上以一行指令安裝,首次執行會開啟作業系統沙箱。定價沿用 1.2 的兩層結構——Standard 與 Contributor——差別不在功能而在資料:Standard 聲明不用於訓練;Contributor 便宜十餘倍,但 Meta 可用你的提示與產出改善模型,且安裝流程曾把新用戶預設導向此層,當時的定價拆解已提醒過這道陷阱。接觸客戶或專有程式碼的團隊,在繫結付款與選擇 model id 之前,應先確認自己落在哪一層。max 則沒有公開價格與開放時程,限時預覽僅能經 Meta 合作夥伴管道取得。
值得追蹤的後續:開源承諾與 max 開放時程
第一個觀察點是開放權重。Meta 在 8 月中預告將開源 Muse Spark 1.2 權重,兌現與否仍待 Hugging Face 上出現實際檢查點;1.3 的發布未伴隨任何開源宣示。若 1.2 權重落地,蒸餾鏈下游的 Muse Glimmer 與 SGLang 這類推論框架生態會直接受惠;若持續延後,開發者社群對「即將」二字的信任會折損。第二個觀察點是 max 的開放時程——何時從合作夥伴預覽轉為一般 API 供應,決定了 62 分那個版本何時能被獨立驗證。第三個是分數的穩定性:AA 指數會隨重測與方法調整而變動,1.0 的分數在不同時間點的紀錄就出現過 43 與 44 之差,61/62 是發布當下的快門,不是定妝照。