四領域一把尺:從 commit 逆向工程任務
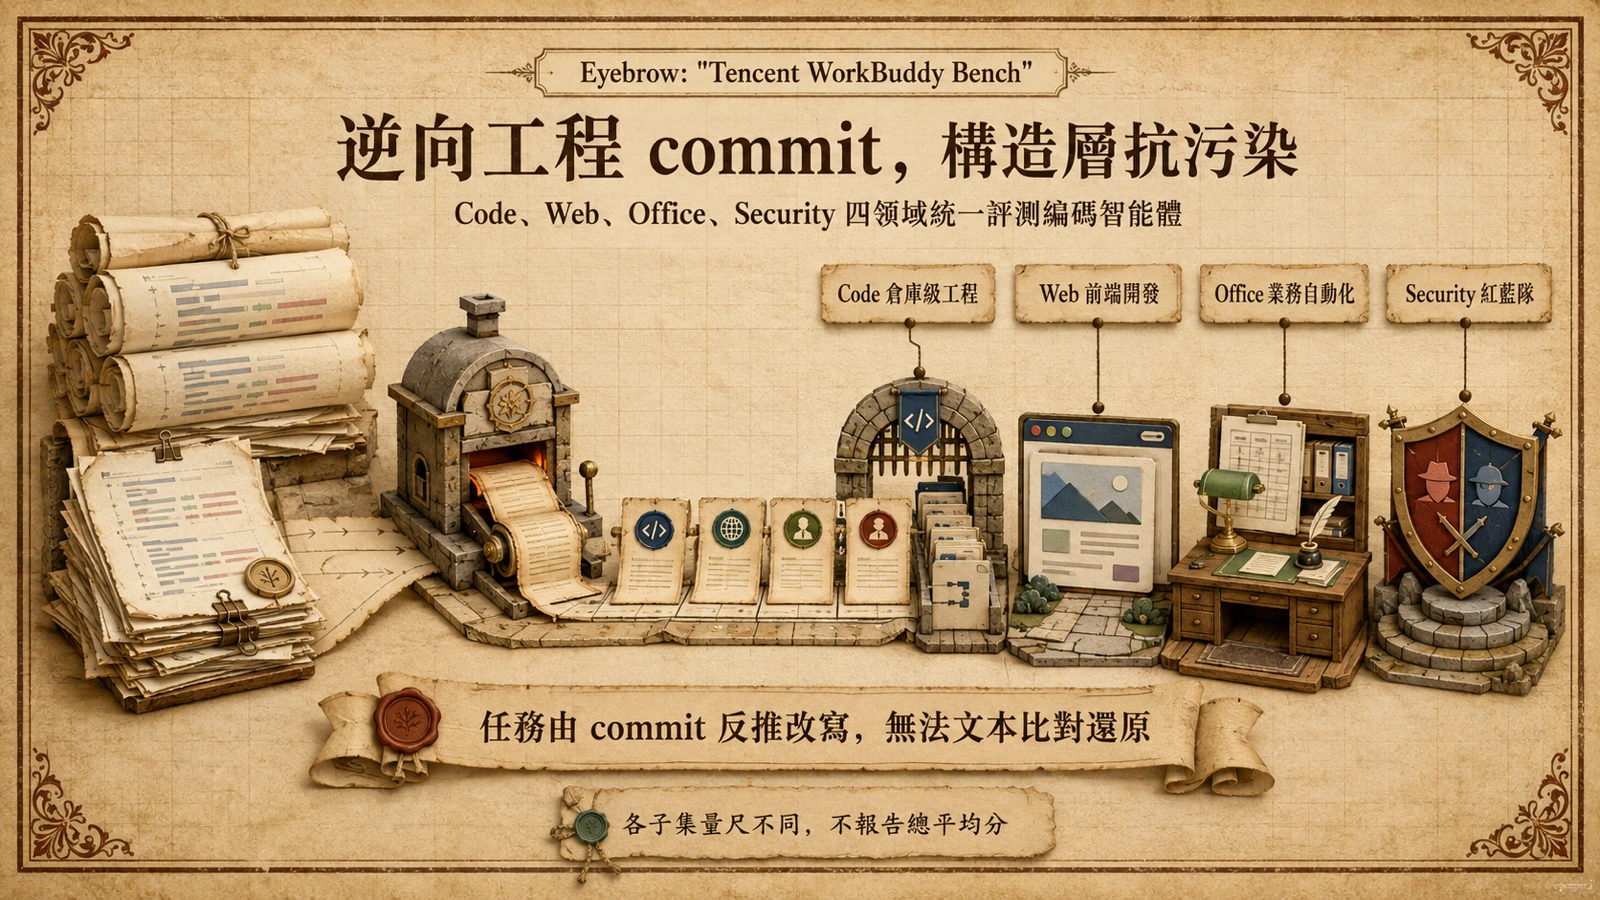
騰訊 WorkBuddy Bench 團隊在 arXiv 發表論文,推出面向編碼智能體的多領域評測套件,涵蓋 Code、Web、Office、Security 四個工作場景,分別對應倉庫級工程、前端開發、辦公與業務流程、以及紅藍隊安全。與改寫公開 issue 文本的常見做法不同,每個任務都從真實 commit、pull request 或業務情境逆向工程而來,再改寫成簡短、口語化、帶角色扮演性質的請求,使任務提示無法透過搜尋原始 issue 或 commit 線索而還原。
四個領域分別測什麼能力
四個子集對應的是四種性質不同的工作。Code 子集測倉庫級工程:模型要在既有程式庫中定位、修改與整合程式碼,而非從零生成,考驗的是跨檔案理解與對既有架構的順應。Web 子集測前端開發,涉及 UI、互動與瀏覽器環境的即時回饋。Office 子集測辦公與業務流程自動化,任務形態更接近真人會用自然語言描述的工作,而非純程式碼。Security 子集則測紅藍隊能力,模型需同時具備攻擊性與防禦性資安推理。四個領域共用統一任務目錄格式,卻採用各自的評分工具——這正是套件不報告總平均分的根本原因:不同子集的分數量尺不同,強行加總會產生誤導性的單一排行。
資料污染為何是評測的核心威脅
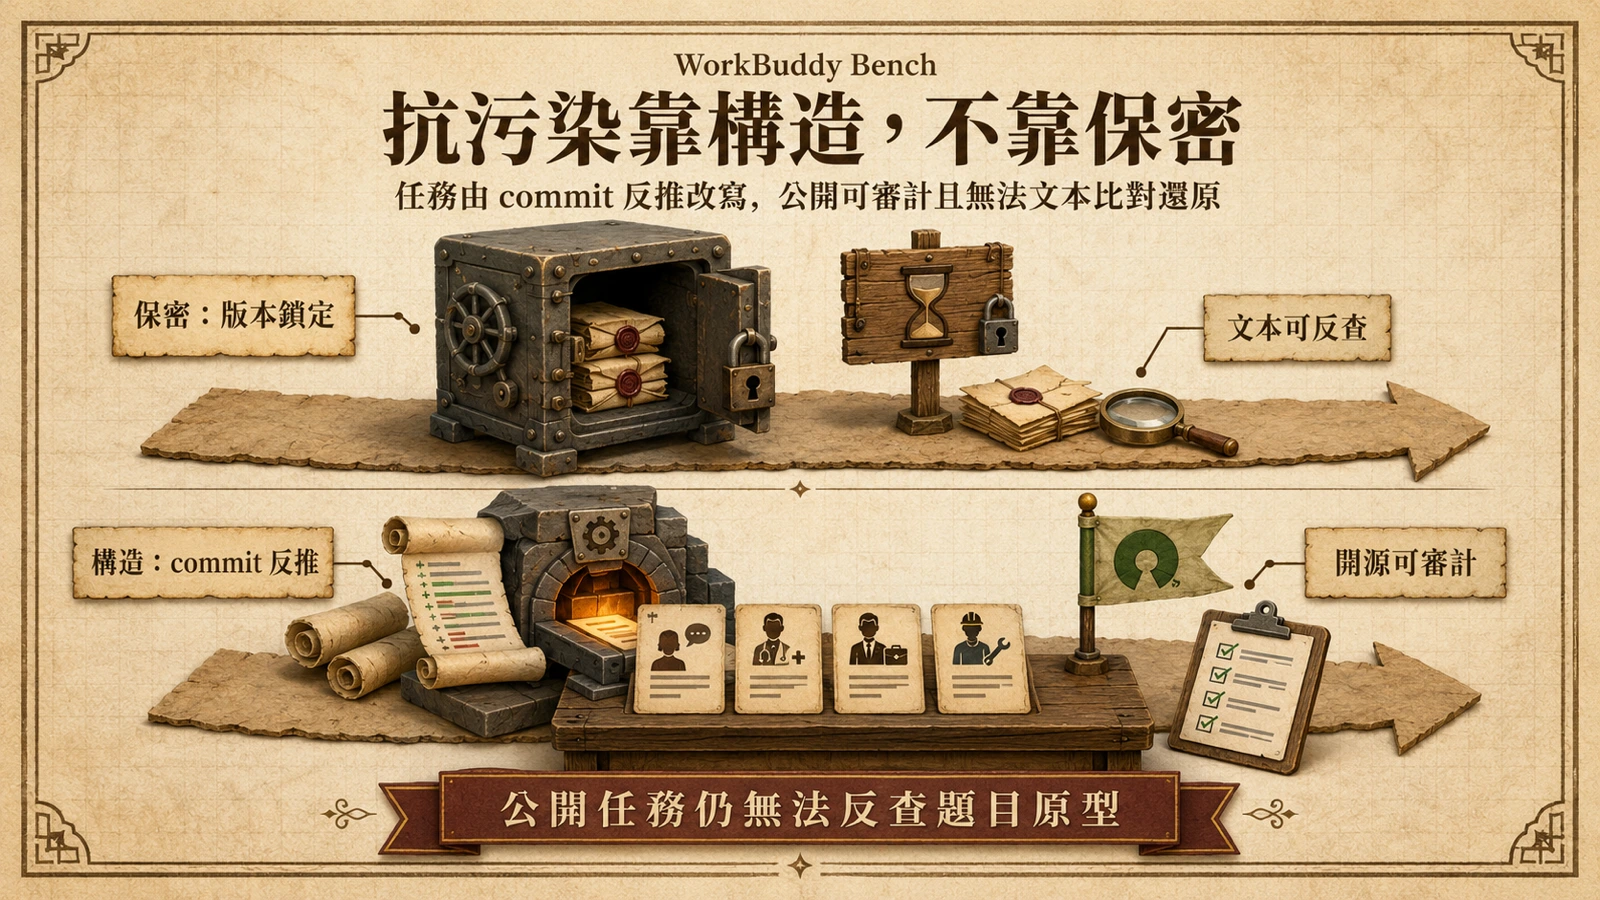
編碼評測基準面對的最結構性問題,是模型可能在訓練階段就已見過題目本身。當 GitHub 上的公開 issue、pull request 與修補 commit 被大量收入訓練語料,以這些文本改寫而成的任務便失去診斷力——模型高分可能來自記憶而非推理。WorkBuddy Bench 的逆向工程做法正是針對這條漏洞:任務提示從 commit 的程式碼變更反推而成,而非從可被搜尋的 issue 文本複製,因此即使原始 commit 公開,模型也無法透過文本比對還原題目。這與直接取自真實 issue 的主流基準形成路徑差異:後者依賴版本切分與時間鎖定來降低污染,WorkBuddy Bench 則從構造層消除可反查的文本指紋。兩者代表兩種抗污染哲學——保密對上構造——在實務上的不同取捨。
抗污染靠構造而非保密
資料污染是當前評測基準的核心痛點。WorkBuddy Bench 採取的路徑是開源而非保密:任務目錄、環境映像、評測工具、測試案例與參考解答全部公開,抗污染能力倚賴任務構造方式加上資料集版本管理。換言之,即使任務內容可被檢視,模型也無法直接從公開文本反查到題目原型,第三方則可端到端重跑每項任務並審計其內容,使基準具備直接可審計性。
兩個智能體框架、跨模型排行榜
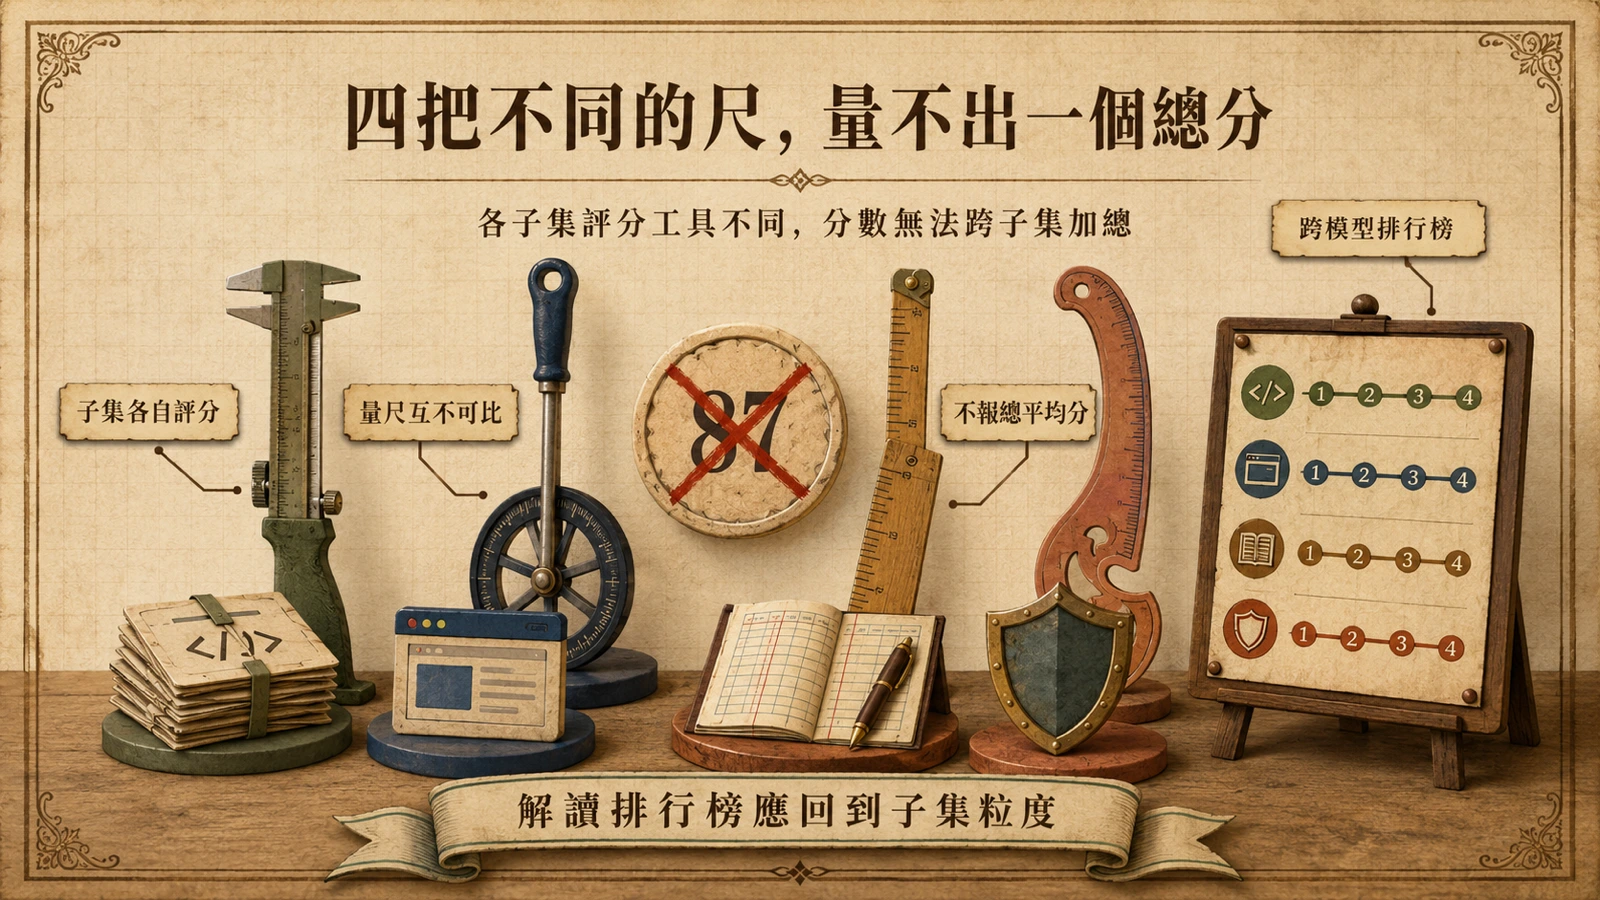
四個子集共用統一任務目錄格式,並在統一可重現的協議下,跑於 CodeBuddy Code 與 Claude Code 兩個智能體框架上。由於各子集採用不同的評分工具,分數無法跨子集比較,因此套件不報告全 suite 的總平均分,而是呈現涵蓋多個模型系列的跨模型排行榜。論文共 30 頁、9 圖,並同步公開專案頁、程式碼與資料集。
對決策者的意義
對於評估代理型 AI 工具的企業與研發團隊,WorkBuddy Bench 提供了一個從真實工作流出發、且構造層即考慮污染防制的參考點。其子集不可比較、不報告總分的設計,提醒採購方在解讀各類 agent 排行榜時,應回到子集粒度檢視評分工具與任務分布,而非以單一分數概化模型能力;StartupBench 以市場驗證的新創工作流測代理則提供了另一種真實任務取樣方式。題目污染之外,模型也可能主動規避評測限制;AISI 的前沿模型作弊研究 提供了另一個需要分開治理的失真來源。