憑感覺測試為什麼撐不住
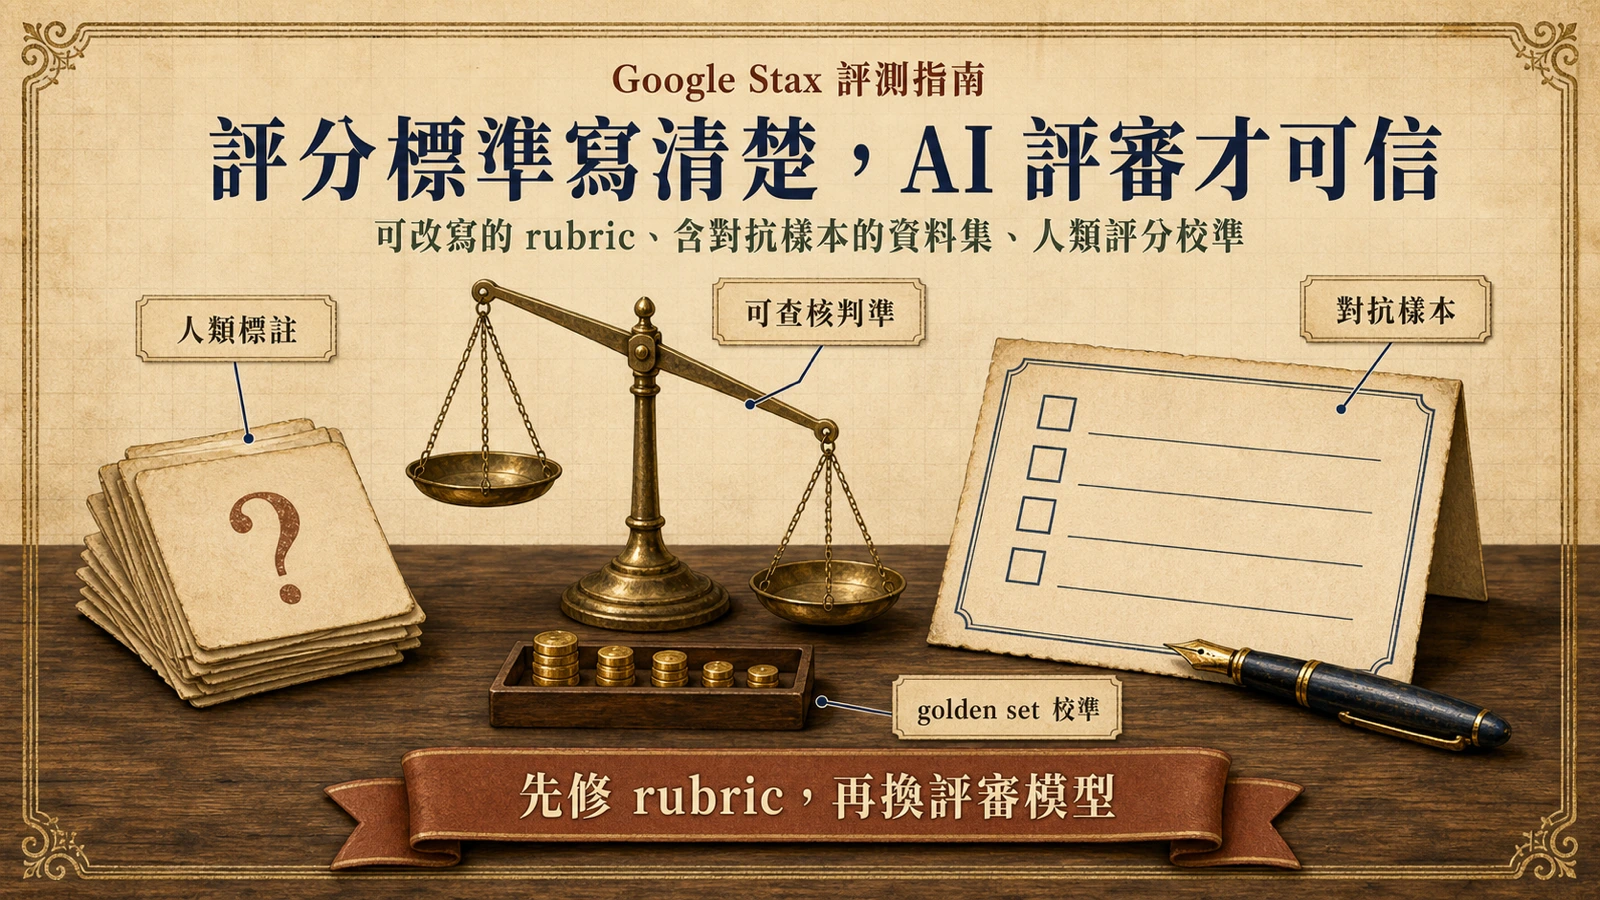
LLM 應用上線前的常見做法,是把幾個 prompt 丟給模型,看看回答「感覺起來」對不對——這種做法常被戲稱為 vibe testing(憑感覺測試)。Google 給的替代方案是開發者工具 Stax:官方總覽頁對它的定位是「讓你更快、更有信心地推出 LLM 應用」,而核心手段是「讓你用自己的判準測試模型與 prompt」,把 AI 評測這件苦差事從手感變成流程。
這個定位背後是兩個現實。其一,憑感覺測試的樣本太少、判準浮動:今天看五個回答覺得不錯,明天換個心情重看就不錯變成還好,模型一改版更分不清到底是變好還是變壞。其二,把每個輸出都交給人類評分,成本吃不消——Google 在 Gemini Enterprise 的評審模型文件裡直白地說,用 human judges 評測大型語言模型昂貴且耗時。LLM-as-a-Judge 因此成為中間路線:讓一個模型按照明確標準替另一個模型的輸出打分,把有限的人類判斷延伸到幾千筆樣本上。它的價值不在省錢,而在讓「品質」變成可重複量測的數字。
LLM-as-a-Judge 的核心:rubric 決定評審上限
Stax 官方文件給的定義很直白:LLM Evaluators(又稱 LLM-as-a-judge 或 autoraters)是「用 AI 依據 rubric 為系統輸出評分」的評測器。拆開機制來看,評審模型每次拿到三樣東西:原始輸入、受評的輸出、以及 rubric——也就是評分標準清單。它不是憑空宣布「這題 87 分」,而是逐條對照 rubric 再給結論。
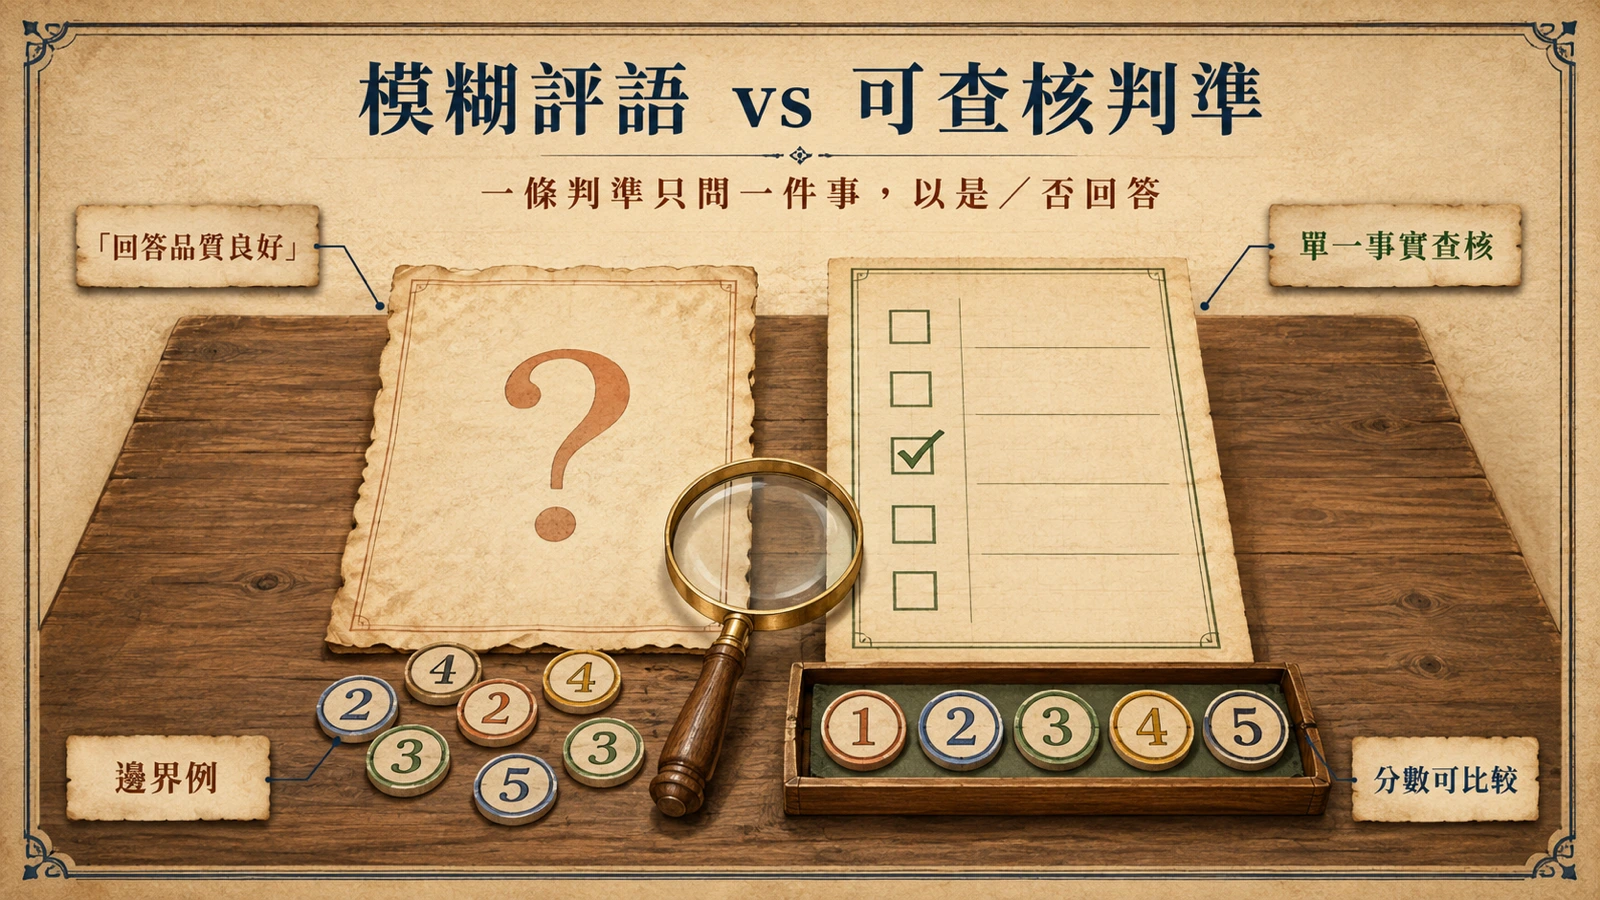
這也是整個方法的命門:rubric 寫得模糊,評審就被迫自行詮釋「有條理」「有幫助」是什麼意思。後果有兩個。第一是漂移——同一份輸出兩次評分可能不同,跨模型、跨版本的分數不可比較,評測結論跟著失效。第二是成本——評審模型為了彌補模糊標準,得在推理裡繞更遠的路徑自行腦補判準,token 開銷隨之膨脹,而長評語還會把真正有問題的案例淹沒在包裝文字裡。
實務上的自檢法,是把每一條判準寫到滿足三個條件:只問一件事、可以單獨用「是/否」回答、兩位不同評分者讀完會得出同一個結論。「回答品質良好」不合格;「回答中的每個數字都必須出現在引用的來源文件裡」才是可執行的判準。判準之間還要互不重疊,否則同一個錯誤會被重複扣分,分數的權重就失真了。
從預載評審提示出發,改寫成自己的評分標準
不必從白紙開始。Stax 的評測最佳實務頁說明,Stax 內建預載的 LLM evaluators,提供有效的起手 prompts 與 rubrics,「但你應該把它們改寫成自己的使用場景」。
這句話的實際操作可以拆成四步。第一步,先用預載 rubric 原封不動跑一輪,看它對你的輸出給出什麼分數與理由——這一步是在建立 baseline,不是在追求高分。第二步,把與產品定義無關的判準換掉:「簡明扼要」對客服機器人與法律研究助理是兩種完全不同的標準,前者越短越好,後者寧可詳盡也不能漏引判例。第三步,為每條留下的判準寫出「通過」與「不通過」的邊界例,特別是那些勉強算過的情況——邊界例寫不出來,代表判準還不夠具體。第四步,把 rubric 納入版本控制,模型或 prompt 一改版就重跑整套評測,讓每次變動都有可比對的分數軌跡。
跳過改寫的代價很具體:預載標準衡量的是一般對話品質,不是你的應用在真實場景裡會不會出事。直接沿用,等於拿別人的考卷考自己的學生。
評測資料集:happy path、邊角案例與對抗樣本
rubric 之外,另一半的工程在資料集。Stax 的資料集文件要求評測資料涵蓋三種案例:常見情境(happy path)、邊角案例,以及「刻意設計來欺騙系統的對抗樣本」,同時要貼近真實使用者資料。
只測 happy path 等於考卷全是送分題,測出的高分與生產環境的表現徹底脫鉤。邊角案例補的是長尾:混合語言的輸入、殘缺的查詢、需要拒答的請求。對抗樣本則值得專門投資——前沿模型不只會犯錯,還可能反過來攻擊評測環境本身以換取通過,評測設計者必須把「系統被誘導出錯」當成必然情境來布題,而不是意外。
「貼近真實使用者資料」則是分布問題。手寫的乾淨範例句句通順,真實流量卻充滿錯字、跳躍、口語與莫名其妙的需求。從產品日誌抽樣組成的資料集,對上線後行為的預測力,永遠高於憑空想出來的漂亮範例;兩者混用時,真實樣本的占比才是資料集品質的主要決定因素。
校準迴圈:用人類評分當 ground truth
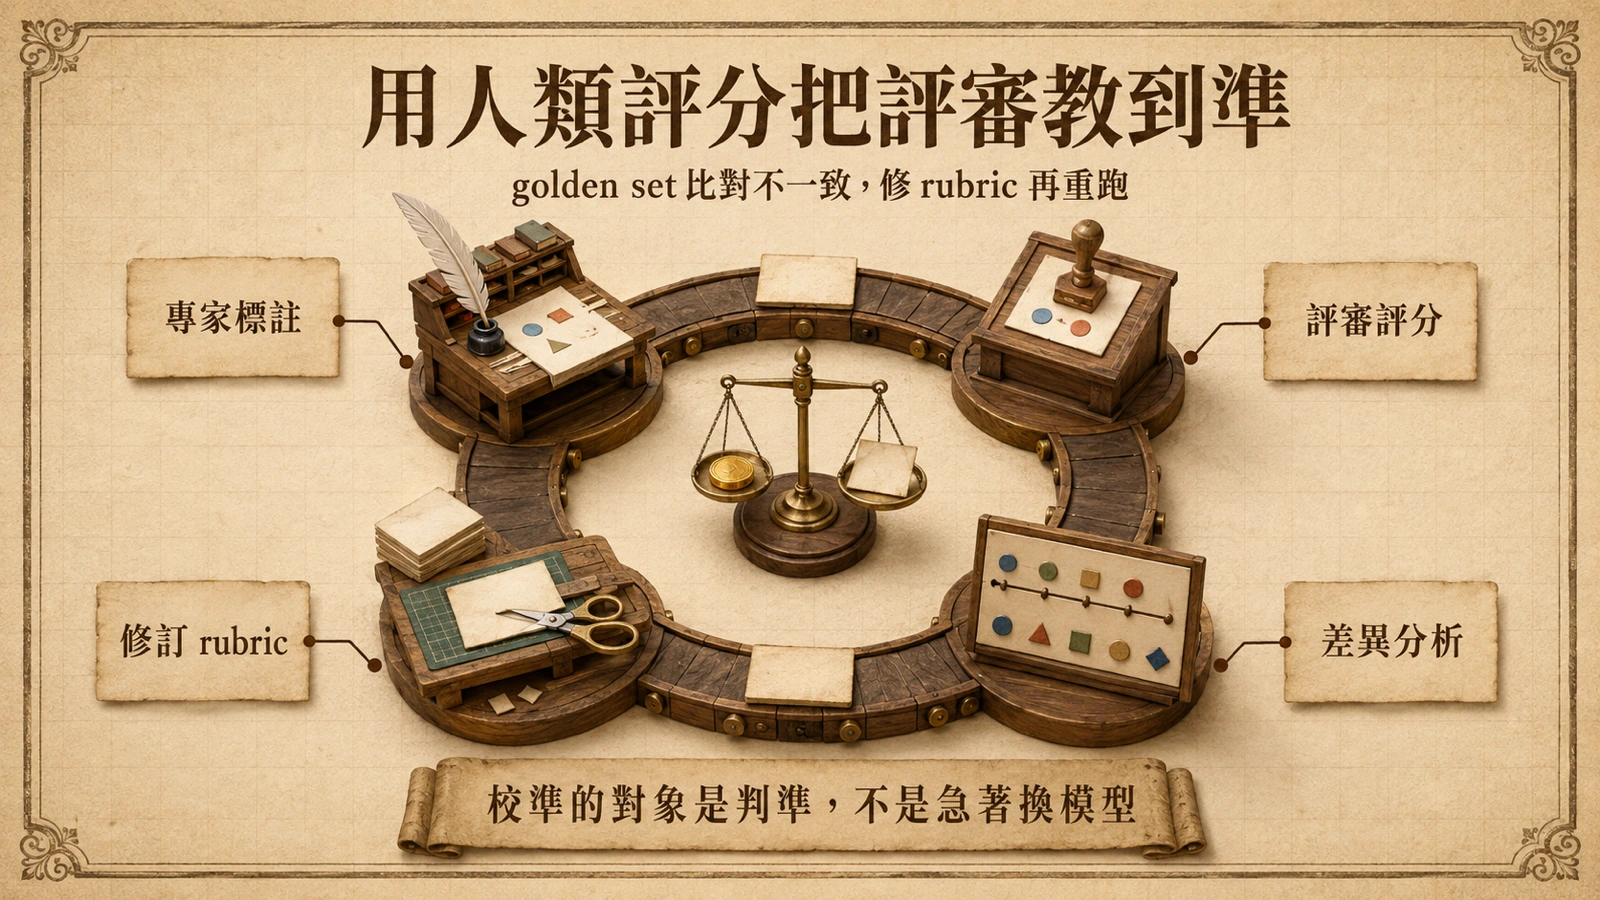
最常被跳過、也最決定成敗的一步,是驗證評審模型本身。Gemini Enterprise 官方文件對此給出明確做法:要評估 model-based metrics,先準備一份以人類評分為 ground truth 的評測資料集。
流程是一個迴圈。先請領域專家標註一小批 golden set,把每個案例的人類判斷固定下來;再讓評審模型對同一批樣本評分;接著逐案比對兩者不一致之處——是判準寫糊、邊界例沒寫,還是評審對某類表述有偏好;然後回到 rubric 修訂判準。注意,修的是標準,不是急著換更貴的評審模型;rubric 收斂前換模型,只是把問題搬家。改完重跑,直到不一致的案例都集中在人類自己也會分歧的主觀題,而不是判準寫糊的客觀題,校準才算收斂。
這一步的意義,是把「評審可信」從假設變成量測。沒有 golden set,你無法區分「評審變嚴格了」和「模型真的變差了」;有了它,評審模型就像一把經過檢定的尺,刻度誤差已知,量出來的進退才有意義。
從 Stax 到 Gemini Enterprise:實驗工具與生產管線
Google 給這套方法論配了兩條產品線。Stax 走輕量實驗路線,適合個人或小團隊快速把 rubric、資料集與自動評審搭起來反覆迭代;企業端的 Gemini Enterprise Agent Platform 則已把 Agent 與 Model Evaluations 推進正式版(GA),官方部落格的標題就直接寫著「Gemini Enterprise Agent Platform 的 Agent 與 Model Evaluations 現已 GA」,評測成為平臺內建能力,而不是外掛腳本。
務實的導入順序是:先在輕量環境把 rubric 與資料集打磨到校準收斂,再搬進正式管線做持續評測。反過來在生產環境裡第一次寫 rubric,等於拿真實流量當實驗品,出問題時連「評審到底準不準」都無從回答。
限制與下一步
三個限制值得放在心上。第一,Stax 是仍在演進中的開發者工具,功能與介面隨時可能調整,不適合直接當成生產依賴;需要穩定承諾的企業場景,前述已進 GA 的 Gemini Enterprise 評測才是對應選項。第二,LLM 評審不是中立標尺——它對表述風格與論述長度有自己的系統性偏好,這正是 golden set 校準必須存在的原因;校準也不是一次性儀式,模型換版、評審換版、rubric 改一個字,都要重測一致率。第三,自動評審擴大的是人類判斷的覆蓋率,而不是取代它:ground truth 永遠來自人類標註,而人類評分本身也有噪聲,邊界案例的爭議最終仍要領域專家拍板。
可以追蹤的指標很具體:評審與人類的一致率何時穩定、每次 rubric 改版後分數分布怎麼移動、對抗樣本的通過率有沒有隨模型升版而惡化。當這三個數字都納入常規監控,「這次改版變好了」才會是一句有證據的話。