常駐本機代理:Muse Glimmer 的設計起點
Meta 超級智慧實驗室(Meta Superintelligence Labs,MSL)在 8 月 10 日以 Apache 2.0 釋出 Muse Glimmer,把它定位為一款「為常駐本機代理工作流程最佳化」的 30B 開放權重模型。在官方公告裡,Meta 直陳這款模型的出發點:多數基礎模型部署仍仰賴雲端與網路,而「在本機運行,意味著不論身在何處、有沒有連線都能運作的 AI」,見〈ESP32-S3 的離線端側推理〉。換句話說,Muse Glimmer 不是又一顆比拚雲端旗艦的通用模型,而是刻意做小、做給本機常駐的代理——一個會留在你機器上、離線也能持續工作的代理。
這個定位也寫在 Meta 的開發者頁面:它是為常駐本機代理打造的開放 30B 模型,跑在單張 GPU 上、Apache 2.0 授權,並針對工具呼叫、長任務與失敗恢復調校。三個關鍵詞——工具呼叫、長任務、失敗恢復——正是代理有別於一般聊天模型的所在,也是理解 Muse Glimmer 設計的線索。
蒸餾自 Muse Spark:30B 多模態架構
架構上,Muse Glimmer 是一顆具備專屬感知編碼器的 300 億參數因果語言模型,總參數約 29.6B,其中包含一個約 1.8B 參數的 ViT-G/14 視覺編碼器,賦予它看圖、理解螢幕畫面與文件的多模態能力;上下文視窗達 131,072+ token,足以承載一個橫跨多個工具、多份文件的長任務。模型卡把它描述為「從 Muse Spark 蒸餾、專為消費級硬體上的自主代理任務打造」——也就是說,Muse Glimmer 是學生,能力來自較大的教師模型 Muse Spark。
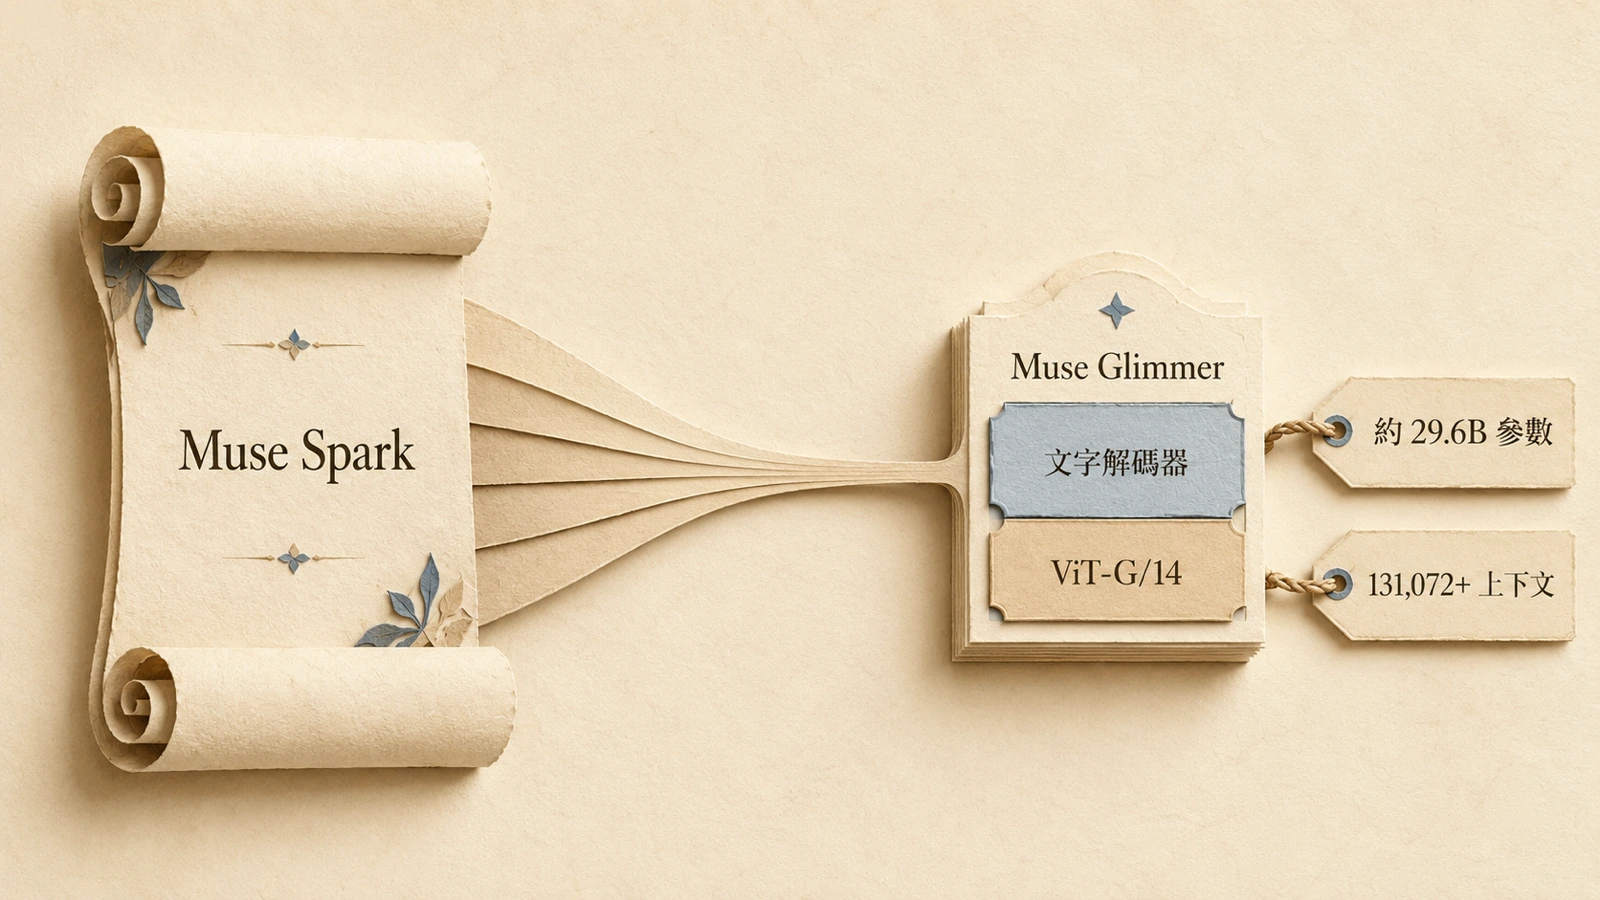
把教師 Muse Spark 的開放權重也算進來,這條蒸餾鏈的源頭已逐步交到社群手上;我們在 Muse Spark 1.2 開放權重預告裡追蹤過這一步對 Meta 開源路線的意義。Muse Glimmer 屬於同一家族——它與終端編碼代理 Muse Code、基礎模型 Muse Spark 共用同一條血脈,只是被裁切到能在消費級硬體上常駐的尺寸。
三根能力支柱:工具呼叫、長任務、失敗恢復
Muse Glimmer 對「代理」的承諾,具體落在三根支柱上。第一是可靠的工具呼叫——模型能處理範圍廣泛的函式呼叫。第二是長任務,能在 13 萬以上的上下文裡維持多步規劃。第三、也是最關鍵的一根,是失敗恢復:模型卡寫道,當工具呼叫失敗或回傳非預期結果時,模型會「診斷錯誤並重試」。模型卡並把本地代理的能力總結為「多步規劃、循序工具呼叫、失敗恢復」。
失敗恢復之所以是分水嶺,在於真實的代理任務幾乎從不一次成功——工具會逾時、回傳格式會跑掉、環境狀態會變動。一個只會發出第一次呼叫的模型,遇到第一次出錯就停擺;一個能自行診斷問題所在、再次嘗試的模型,才稱得上能在本機長時間常駐、少人看顧地跑完一個任務。把這個迴圈放進設計目標,正是 Muse Glimmer 有別於通用聊天模型的地方。
同尺寸代理基準:領先與落後之處
模型卡把 Muse Glimmer-30B 與同尺寸的 Gemma4-31B、Qwen3.6-27B 並列評測,結果頗為混合。在代理編碼上,它在 SWE-Bench Pro 拿到 51.2,明顯領先 Gemma4-31B 的 36.9 與 Qwen3.6-27B 的 50.2,SciCode 亦以 43.6 居首;但在 SWE-Bench Verified(76.0 對 Qwen 77.2) 與 TerminalBench(51.7 對 Qwen 60.7) 則落後 Qwen。一般代理領域它亦多數領先:MCP Atlas 75.5(Gemma 54.2、Qwen 62.5)、DeepSearch QA 74.6、WildClawBench 47.6、Gaia2 43.3 皆居首;但 OSWorld-Verified(65.9 對 Qwen 75.6)、GDPVal-AA(953 對 1141) 與 SkillsBench(44.3 對 46.6) 三項落後 Qwen——電腦操作(GUI 自動化)與部分工具密集任務是它偏弱之處。
通用推理面,Muse Glimmer 在 AIME 2026 拿 94.7、長脈絡 Beam128K 拿 65.1、IFBench 77.0 皆領先,但 GPQA Diamond(83.5)與 HLE(22.0)略遜 Gemma。綜合來看,它「在關鍵代理用例與基準上、相較同尺寸領先模型表現強勁」的官方說法,在代理編碼與多數一般代理任務上站得住腳,但電腦操作、部分已驗證編碼基準與工具密集任務仍是對手的舞台。
不過有一點必須看清楚:上述分數全部來自 Meta 自家模型卡的評測,AIDM 並未獨立重測。比較對象與基準的選擇也由 Meta 決定,因此「領先」的解讀應放在這個前提下。
塞進單張 GPU:24/32/64GB 的硬體門檻
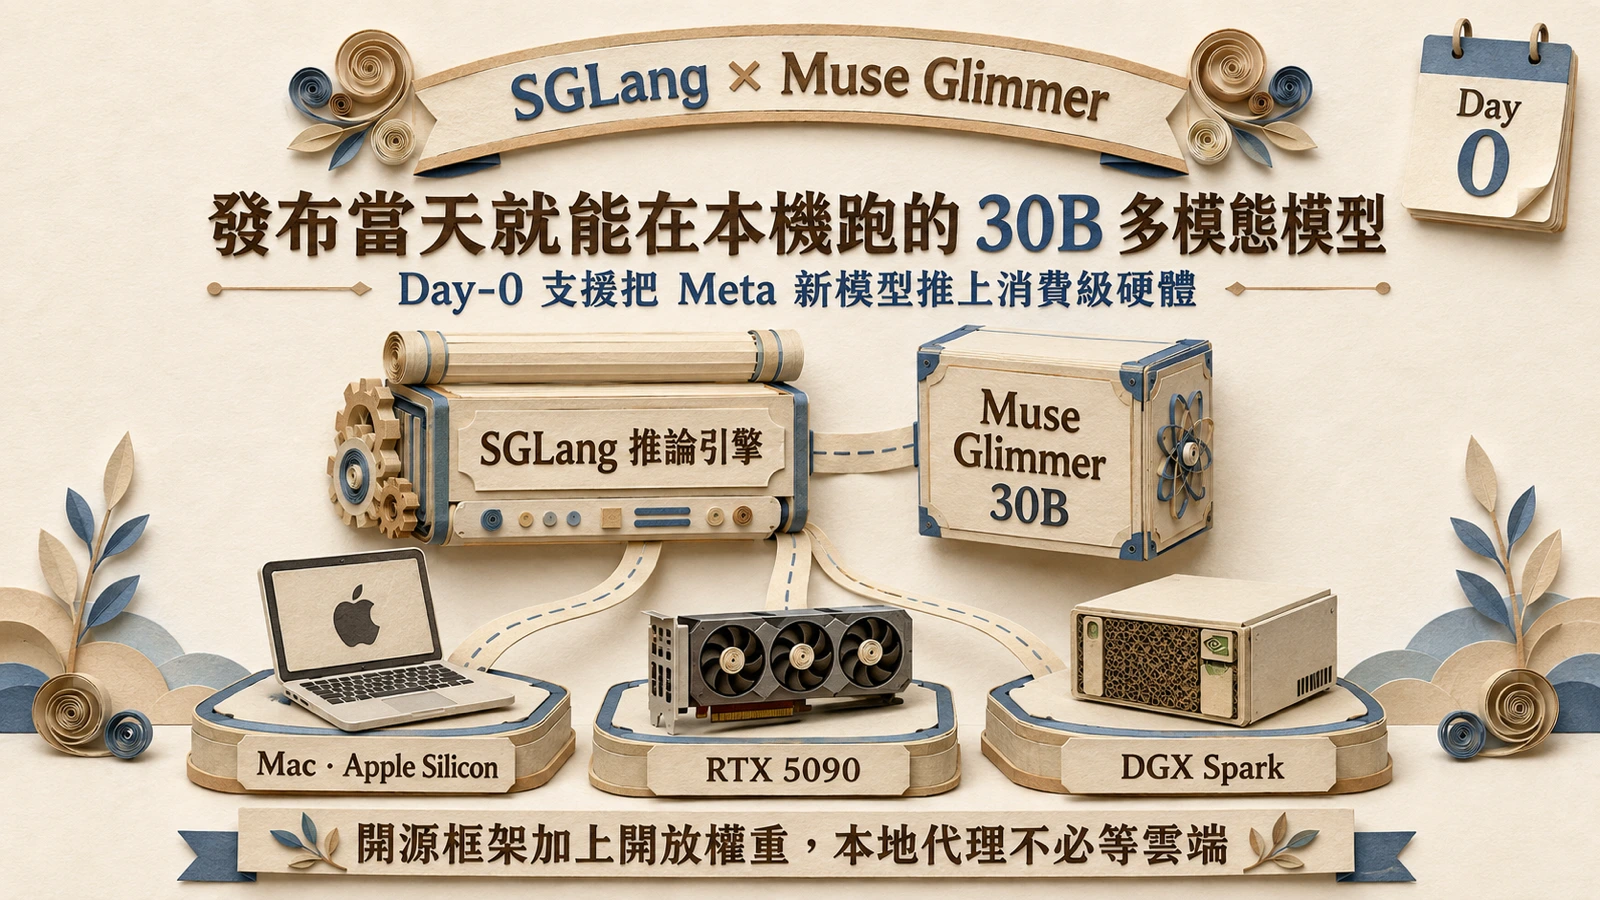
要讓一顆 30B 模型常駐本機,硬體是繞不過的現實。模型卡把語言模型壓到「20GB 以下」,讓它能在「24GB 或 32GB 的記憶體範圍內同時運行」,並開列三檔目標硬體:64GB、32GB、24GB VRAM。量化方面,K-Quant-Dynamic 在 32GB 機器上僅 0.2% 精度衰減,K-Quant-17GB 在 24GB 機器上為 1.0%——這兩個數字是在 15 個常見基準上取平均得出。Meta 同時釋出 BF16 全精度、兩種 4-bit 量化、DFlash 推測解碼頭與凍結的 ViT-G/14 視覺編碼器,外加 GGUF k-quant 與 ExecuTorch 版本,覆蓋從研究微調到蘋果 Silicon、單卡 PC 的部署路徑;需要把更大模型完整留在桌面工作站時,則可對照最高 512GB 統一記憶體的 Mac Studio。
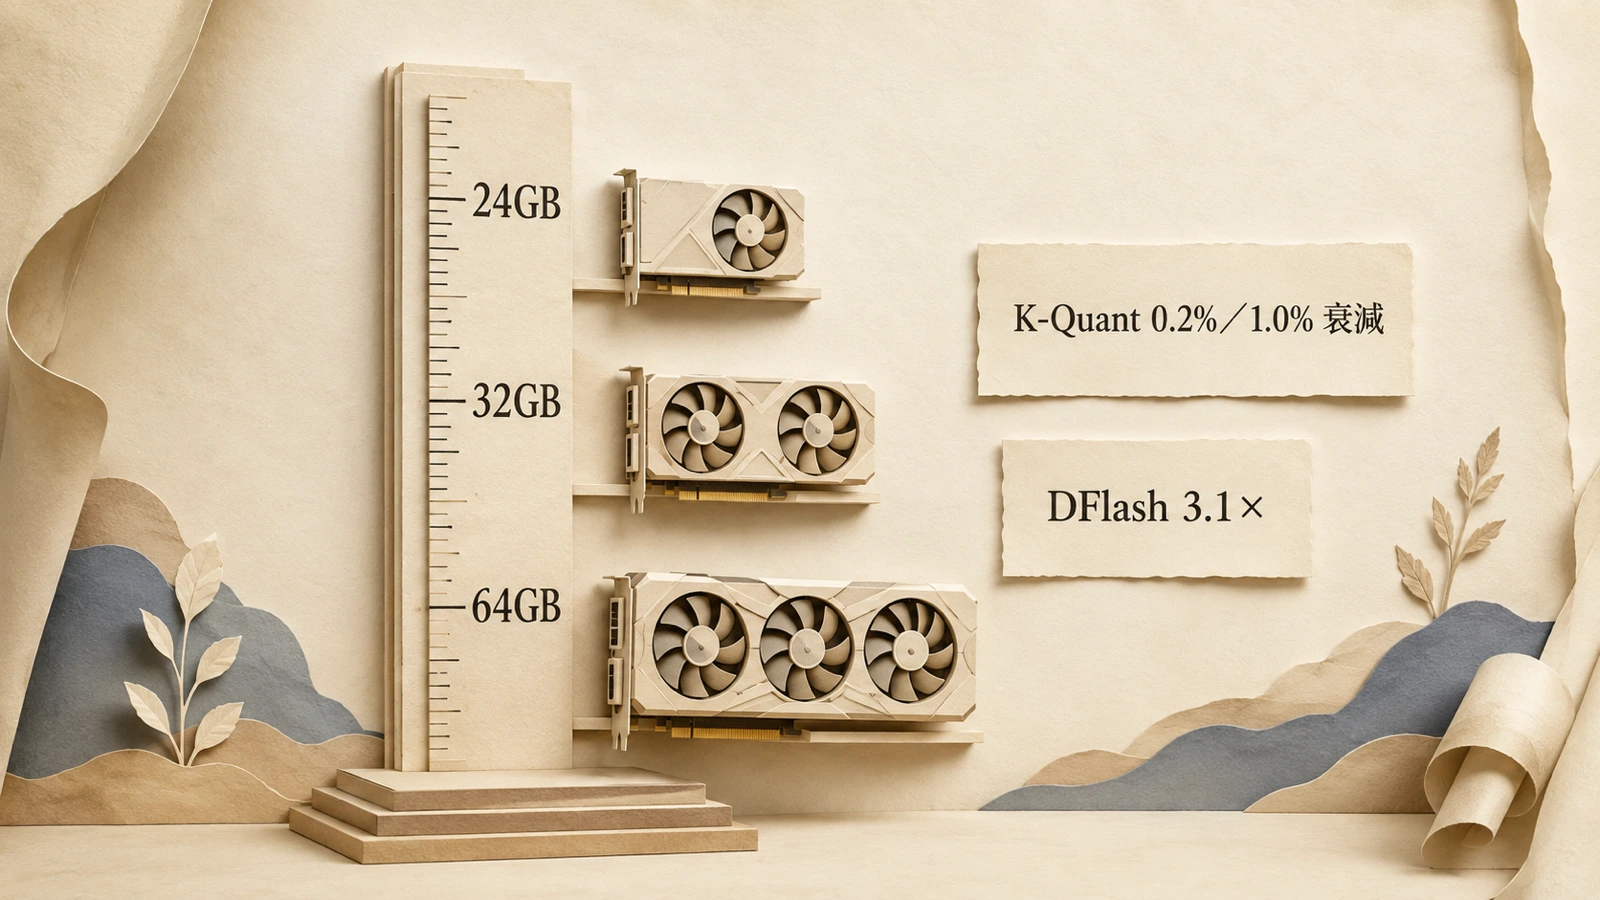
DFlash 推測解碼進一步把互動吞吐拉上來:在 RTX 5090 上從每秒 74.9 token 提升到 233.4(3.1 倍),Apple M5 Max 從 26.6 提升到 50.2(1.8 倍)。要把它推到更高吞吐、接進完整代理服務框架,可參考我們對 SGLang 為 Muse Glimmer 提供 Day-0 支援的報導——裡面記錄了在 RTX 5090 上以推測解碼與前綴快取繳出更高吞吐的工程細節。
開放權重本機代理的現實與未盡之處
把 Muse Glimmer 放回大局,它代表的是一個明確的押注:代理的下一站,會朝本機、常駐、離線的方向移動。一款 30B、多模態、Apache 2.0 的模型,意味企業與個人都能在自家機器上起一個會用工具、會從錯誤中恢復的代理,商用也無需另談授權。對重視隱私、低延遲或不穩定連線的場景,這是一條比純雲端 API 更自主的路徑(見〈祖克柏的完全隱私承諾〉)。
但讀這份成績單有幾個前提。最該留意的是評測出處:上述所有基準分數,以及比較對象 Gemma4-31B、Qwen3.6-27B 的選擇,都來自 Meta 自己的模型卡,AIDM 並未獨立重測——換言之,「領先」是建立在 Meta 自己開列的考題上。其次是硬體門檻:示範機型 RTX 5090、Apple M5 Max 屬高階消費級,13 萬以上的上下文在滿載下對記憶體的壓力不小,「本機常駐」的承諾仍要搭配夠份量的機器才成立。最後,模型 8 月 10 日才剛釋出,它在真實長程任務裡的穩定度、失敗恢復的可靠度,都還有待社群實測。Muse Glimmer 把「本機代理」從概念推到了可下載、可運行的權重;至於它能不能真正常駐、夠不夠穩,是權重落地之後才答得上的問題。