7.9B 總參、1.3B 激活的稀疏 MoE
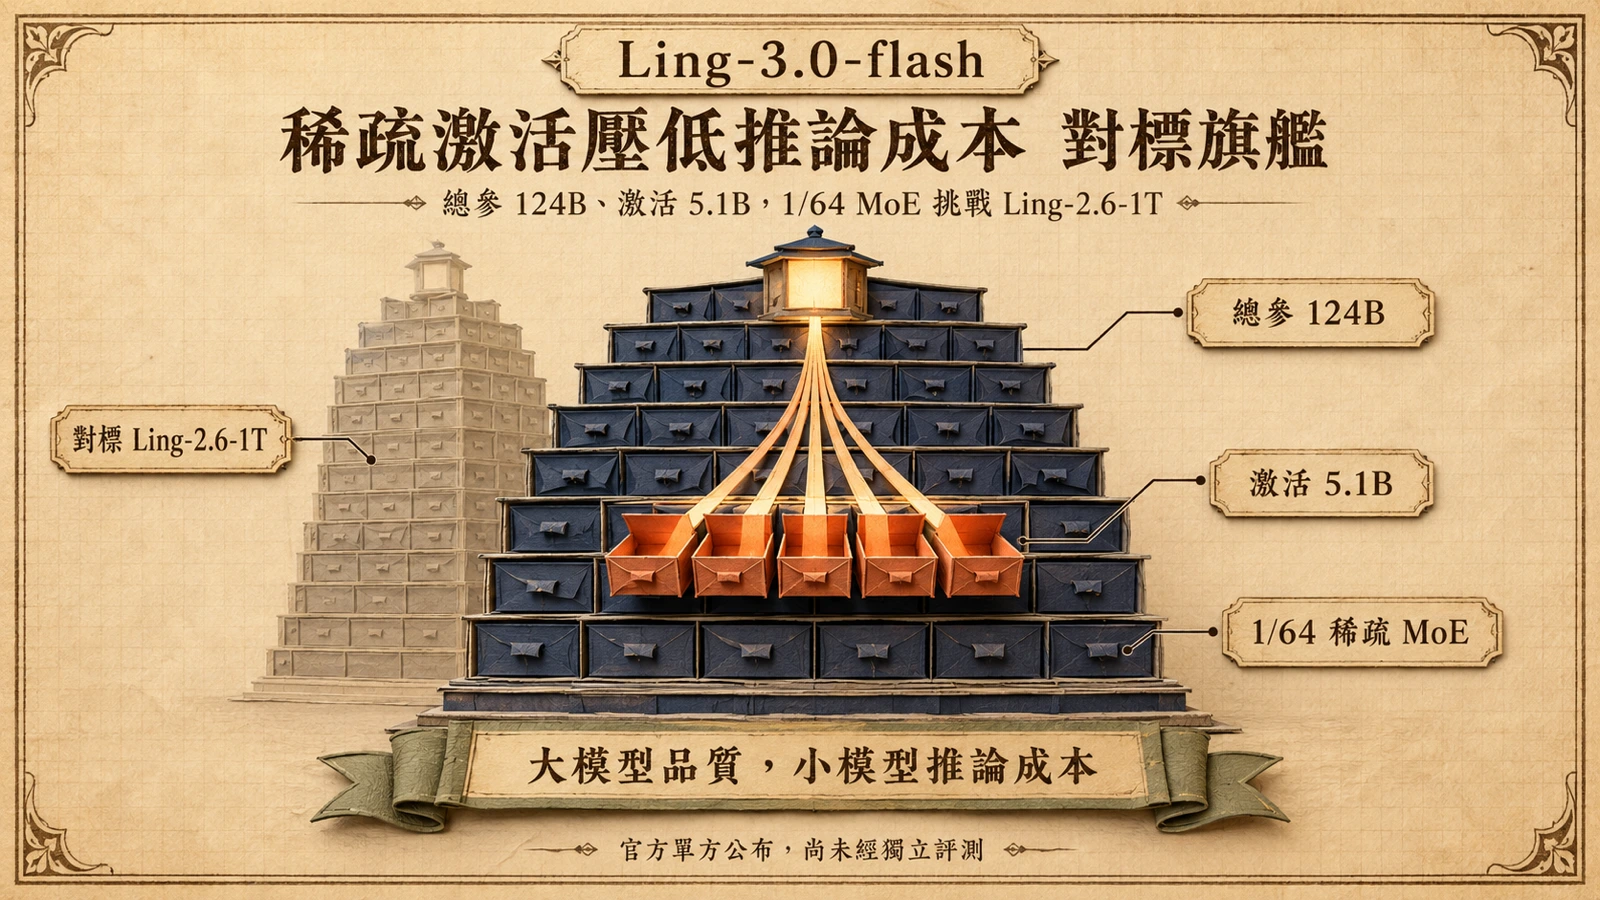
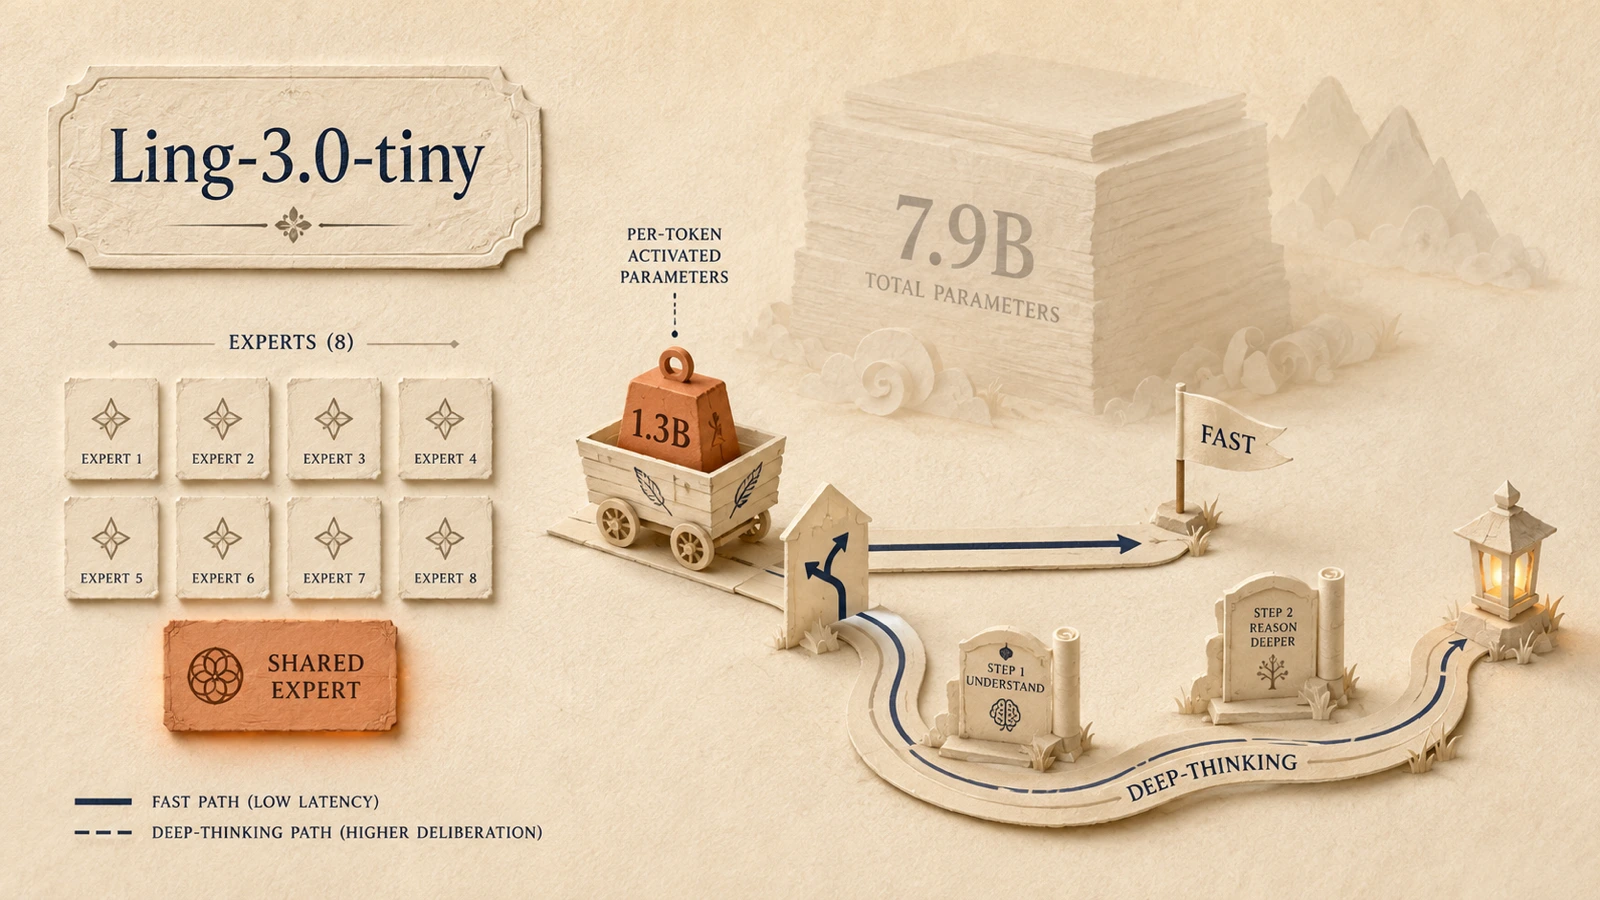
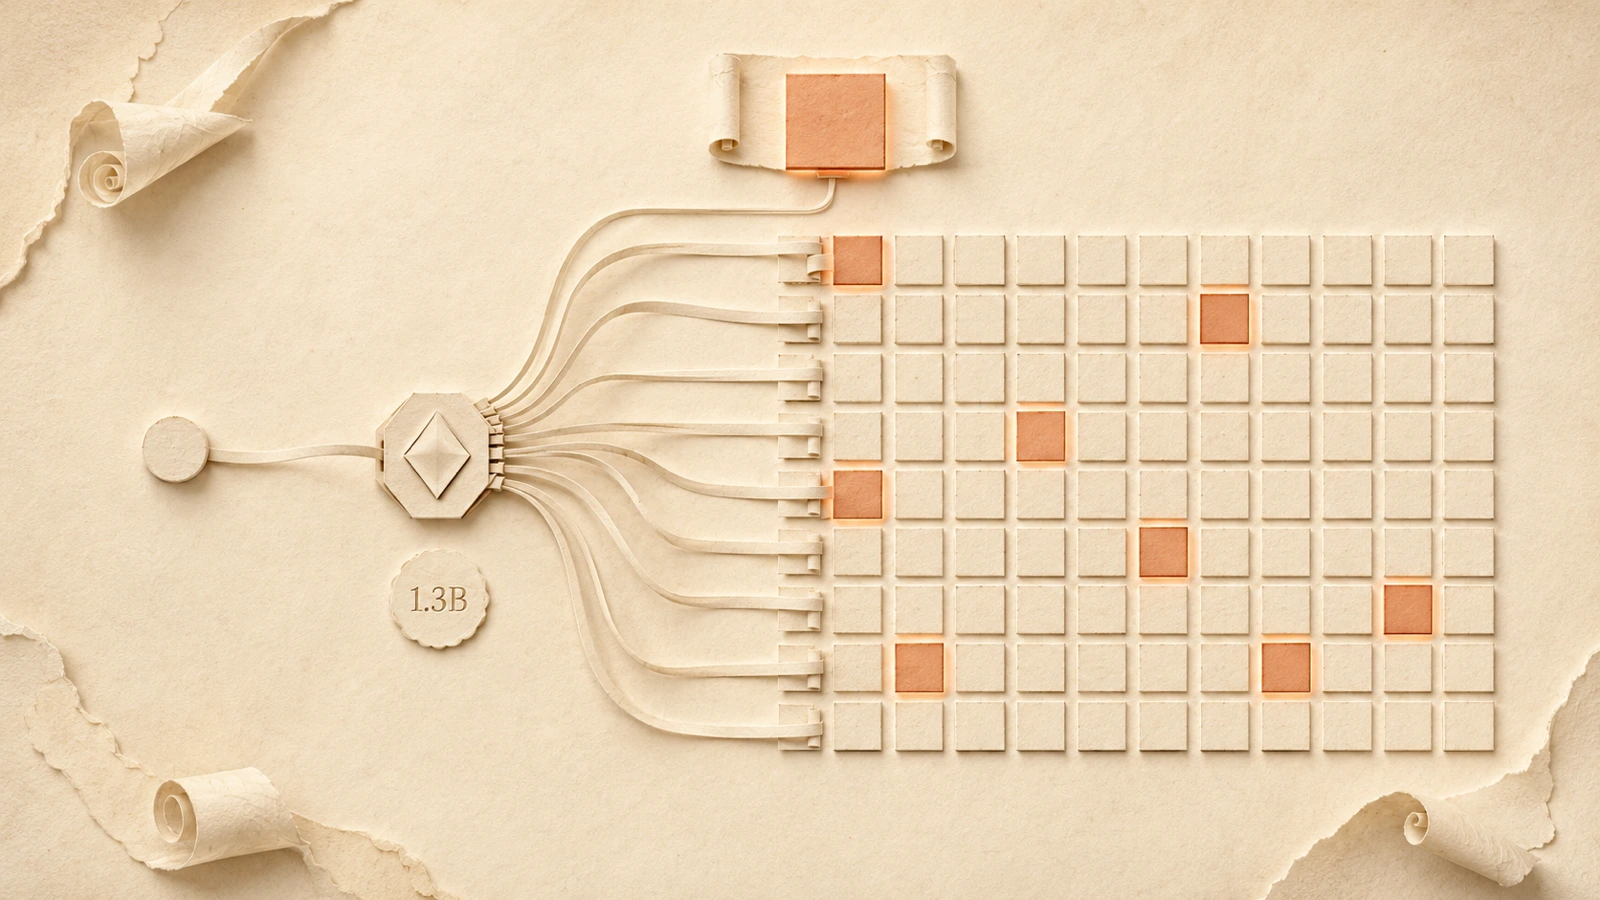
螞蟻集團旗下 InclusionAI 於 8 月 11 日開源 Ling-3.0-tiny,定位為輕量級原生混合推理模型。依官方模型卡載明的參數,模型總參數量 7.9B,每次推理每個 token 僅激活 1.3B。前饋網路採稀疏 MoE:128 個路由專家搭配 1 個共享專家,每個 token 只激活 8 個路由專家加 1 個共享專家。這是 Ling-3.0 系列繼 124B 總參、5.1B 激活的 Ling-3.0-flash 之後,向下延伸的小型變體——同一架構血統,卻把激活量壓到約四分之一。
原生混合推理:逐請求切換快速回應與深思
Ling-3.0-tiny 的核心賣點是「原生混合推理」。與傳統模型固定輸出思維鏈不同,它能在單一架構內依請求決定要走快速回應或多步推理:透過 enable_thinking 參數,每個請求可個別開關思維模式。設計誘因明確——多數查詢不需要長鏈推理,強制每題都「想很久」會推高推論成本與首字延遲;混合架構理論上讓簡單題省算力,把資源留給難題。對一個每 token 激活量只有 1.3B 的小模型而言,這條路線尤其關鍵:它必須在極有限的每步算力下,自行判斷何時該深思。
KDA+MLA 混合線性注意力:長上下文的效率支柱
架構面,Ling-3.0-tiny 採 3:1 交替堆疊的 KDA 與 MLA——每 4 層為一組,前 3 層為 Kimi Delta Attention(KDA,源自 Moonshot 的線性注意力),第 4 層為 Multi-Head Latent Attention(MLA,源自 DeepSeek 的潛伏注意力)。這條混合線性注意力路線並非憑空出現:Ling 系列最近的技術報告就提出整合 Lightning Attention 與 MLA 的混合線性設計,用以改善長上下文訓練與解碼效率,Ling-3.0 的 KDA+MLA 是同一思路的演進。線性注意力把注意力成本從平方級壓到近線性,使長序列處理在小型模型上也負擔得起;代價是線性注意力在精確回憶上的表現通常弱於完整注意力,因此仍須穿插 MLA 層補強。
BF16、FP8、INT4:一個模型、三種部署門檻
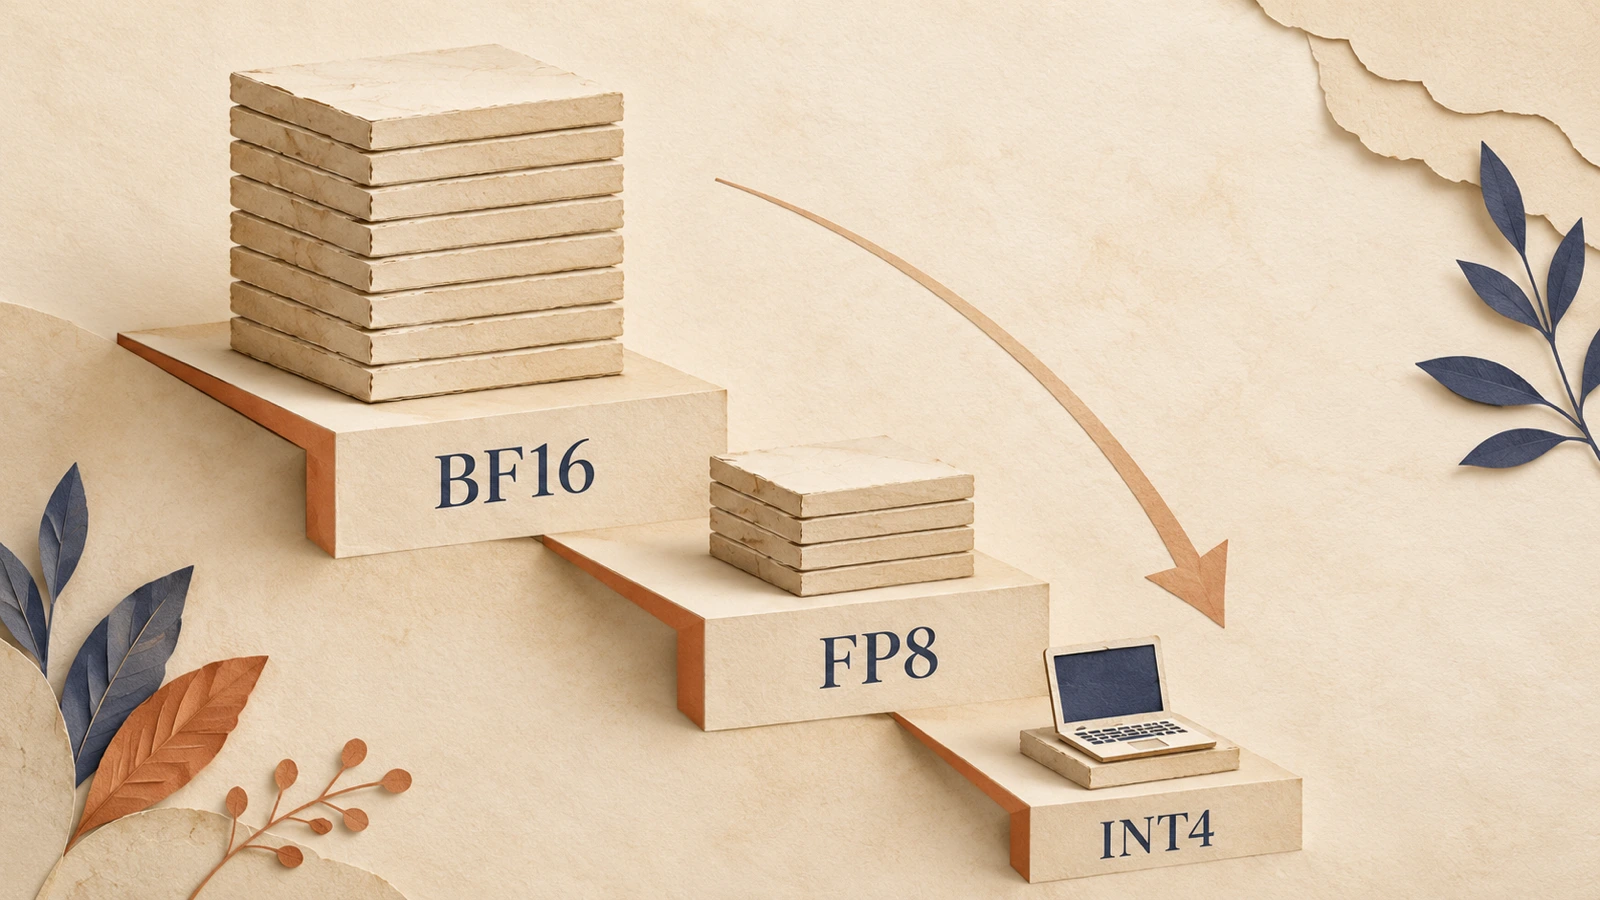
InclusionAI 依模型卡所述同步提供 BF16、FP8、INT4 三種權重,分別對應不同的硬體與部署設定。BF16 是完整精度、門檻最高;FP8 把權重壓到八位浮點,適合支援 FP8 的較新 GPU;INT4 則把每個權重量化到四位元,顯存佔用最低,讓 7.9B 總參的模型有機會塞進消費級顯卡。推論服務方面,InclusionAI 維護一個 vLLM 的官方 fork,引擎支援 FP8、INT4 等量化格式,對應這三種權重的部署需求。
1.3B 激活的意義:把混合推理推進到邊緣硬體
每 token 1.3B 的激活量,是這次開源最值得注意的訊號。混合推理——模型自行決定何時深思——過去多見於大型旗艦模型,門檻在於:即使單次推理只激活一小部分參數,完整權重仍須駐留記憶體,大 MoE 的總參量決定了硬體門檻。Ling-3.0-tiny 把總參壓到 7.9B,意味完整權重對應的顯存需求進入消費級顯卡的可達範圍,再搭配 INT4 量化進一步降低佔用——這讓「在本地硬體上跑一個會自己判斷要不要深思的小型推理模型」成為現實可行的部署樣態。不過稀疏 MoE 的品質高度依賴專家路由是否把 token 送對分流;在 8B 這個規模、且尚無獨立第三方評測的情況下,它在邊界案例與罕見領域的穩定性仍待社群實測。
開源狀態與未驗證之處
Ling-3.0-tiny 的模型卡為公開頁面,權重可下載,不像同系列的 Ling-3.0-flash 在發表初期曾為有限存取。授權方面,HuggingFace 模型卡標記為 MIT。需留意的是,Ling-3.0 系列(flash 與 tiny)目前並沒有像前代 Ling-2.6 那樣的技術報告或論文,架構與規格的細節以 HuggingFace 模型卡與其 config.json 為第一方依據,尚未有獨立第三方評測或可回查的基準分數。換句話說,1.3B 激活的混合推理是否真能在小規模下穩定運作、與同級稠密模型相比孰優,仍須等權重公開後的社群實測才能定論。