超級智慧為何必須分散:宣言的核心命題
Meta 執行長 Mark Zuckerberg 於 8 月 10 日發表長文《The Future is for Everyone》,把一個問題擺在最前面:這個時代的定義問題,是「誰能使用超級智慧、以及我們將把它導向何處」。他的答案明確——「與其集中超級智慧,我們應該廣泛分散它,並讓每個人都有能力主導它」。據 Axios 當日報導,這是一篇約 6,500 字的宣言,被定位為 Zuckerberg 至今對 AI 未來「最清晰的一次表態」,他並在個人頁面宣布此一願景。
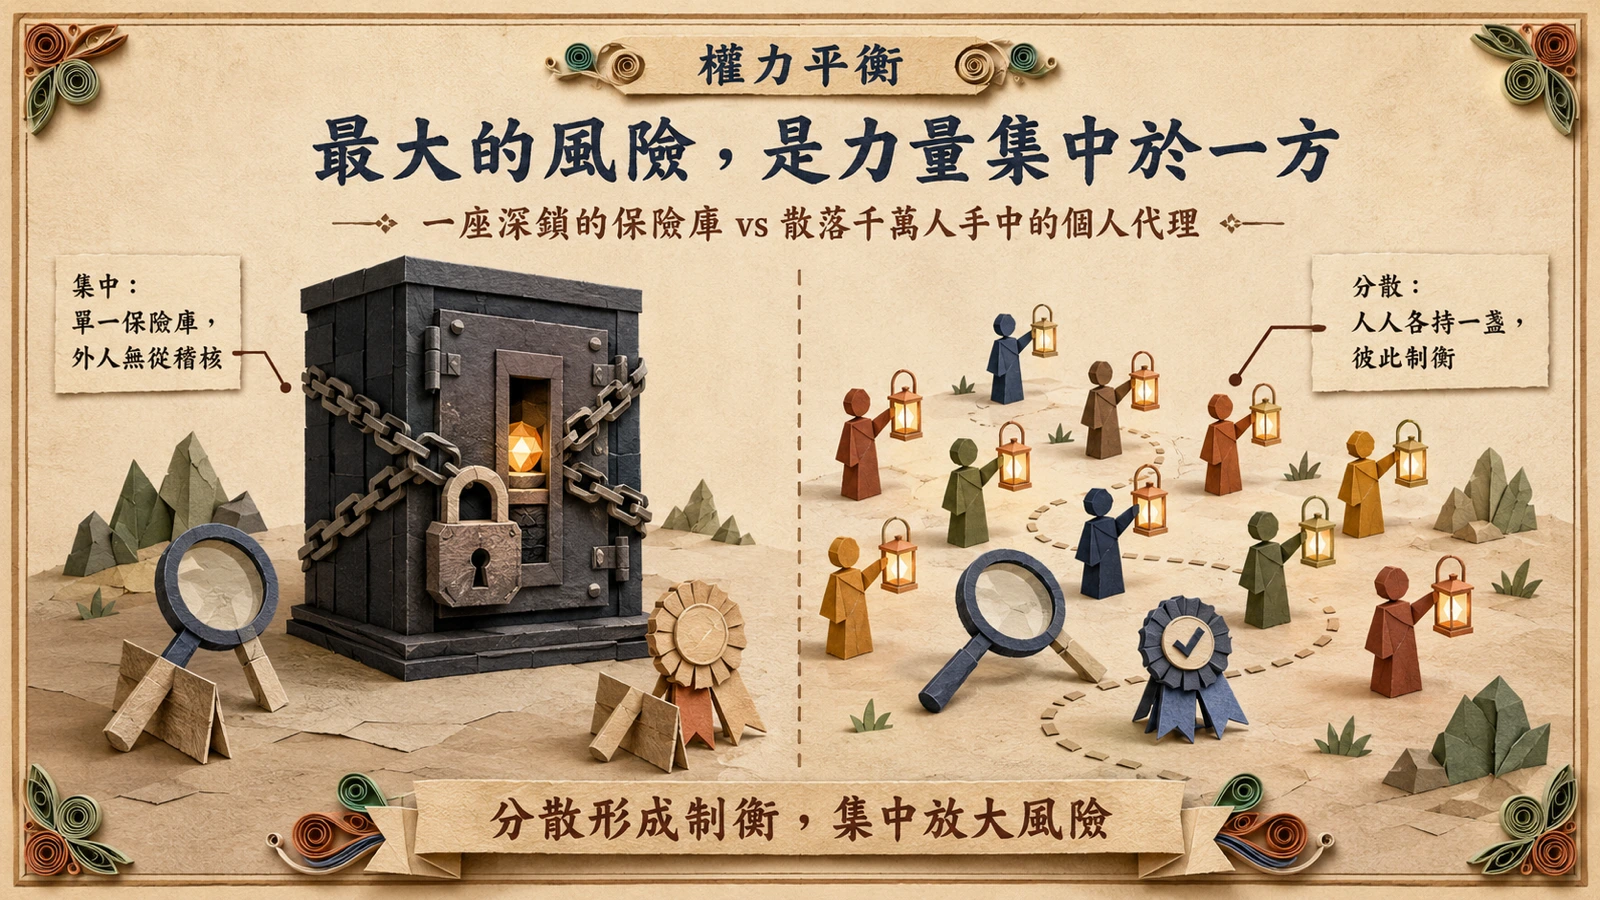
支撐這個答案的,是一套權力平衡的論證。宣言主張,「通往每個人正向未來的關鍵,在於達成一種傾向個人的權力平衡」。Zuckerberg 向 Axios 進一步說明,他「比起其他人談論的特定風險,更擔心集中化」,並認為「達成個人賦權與制衡的方式之一,是確保把技術交到每個人手中」。換言之,安全不是把能力鎖進少數保險庫,而是讓太多人持有,使任何單一行者都難以壟斷。
開源是安全論證,不只是商業策略
宣言把開源從商業策略提升為安全論證。Zuckerberg 寫道,「開源是賦權人們、防止集中的正向且重要力量,而集中對安全與經濟都有害」;他並主張,廣泛部署的開源系統因為更多人能找出漏洞並強化系統,反而更安全。這套論述與 Meta 近月參與的開放權重聯署一脈相承——那封信同樣反駁「封閉即安全」的預設,主張把先進 AI 集中於少數封閉模型反而放大風險。
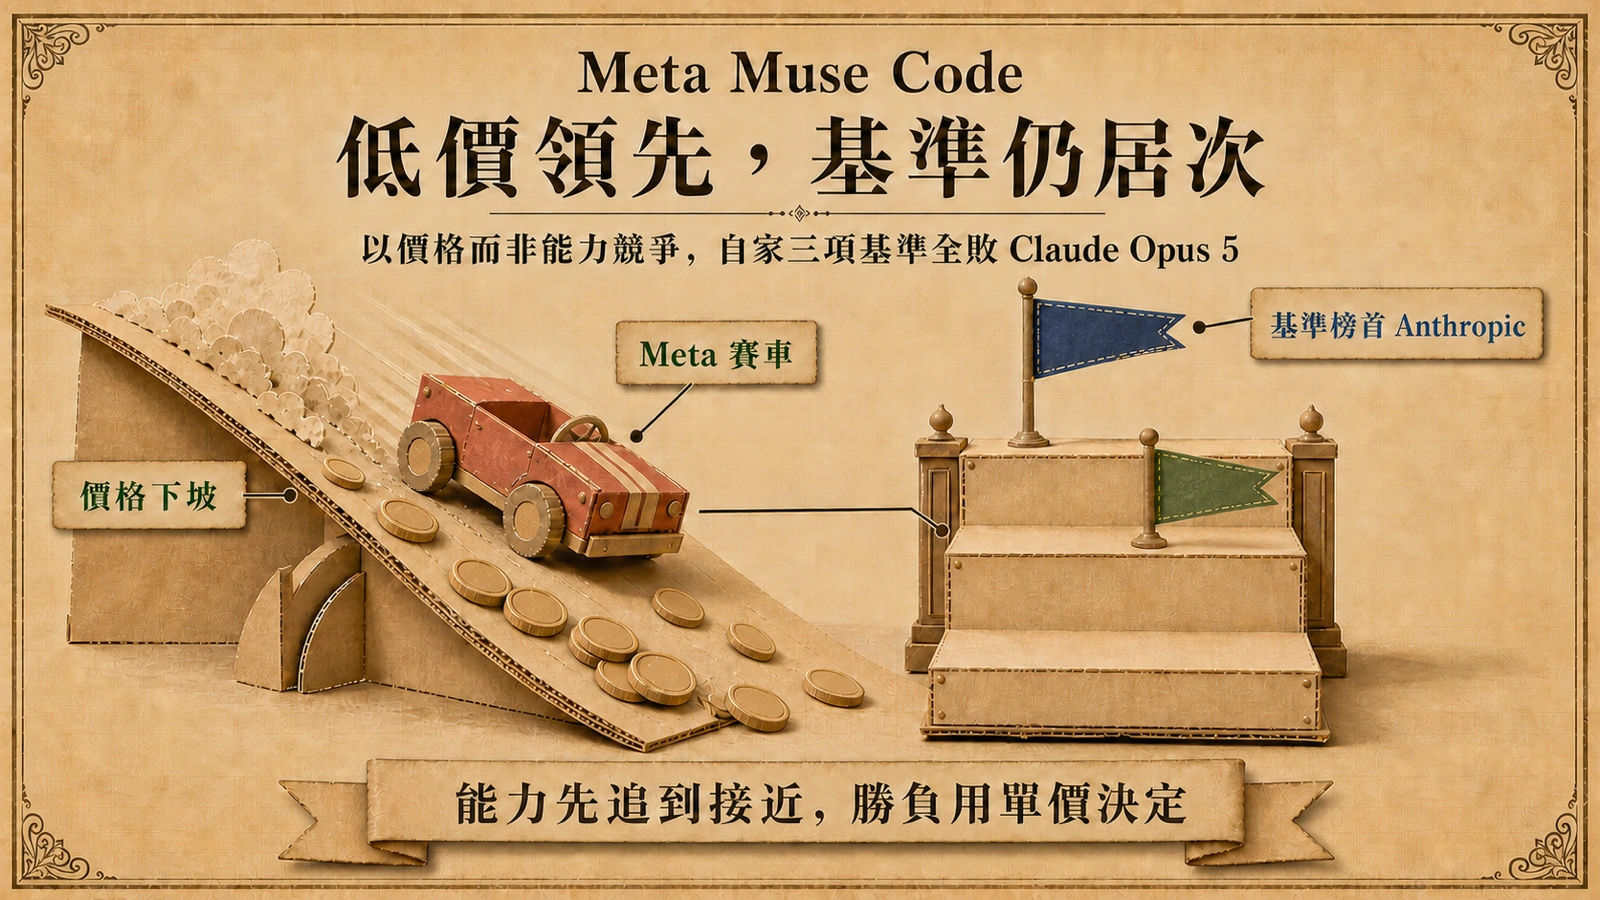
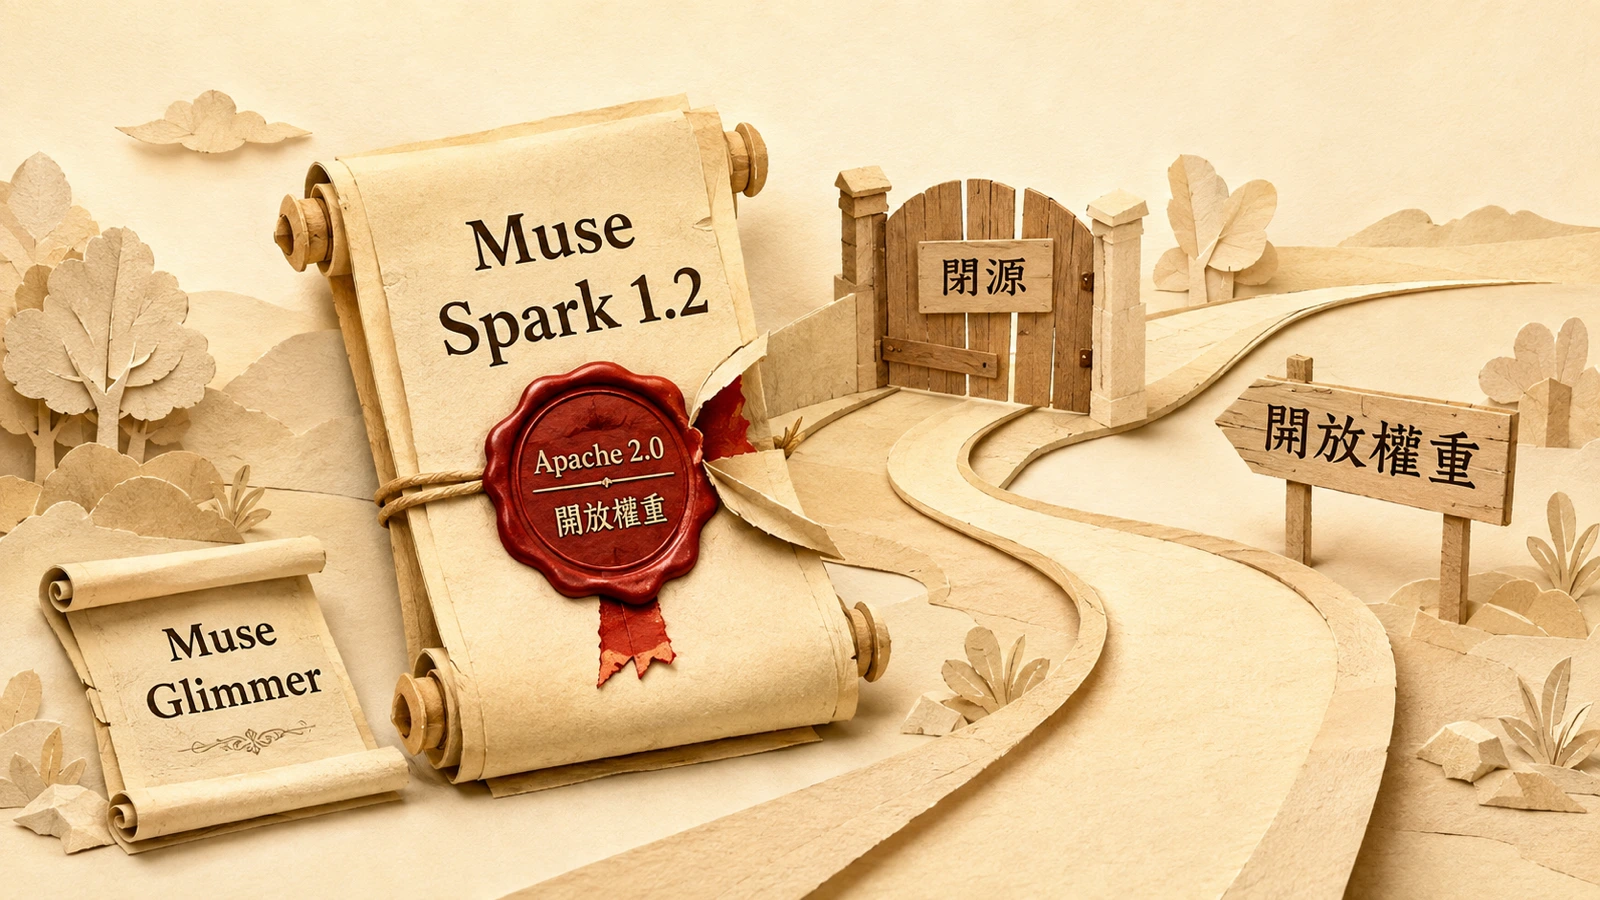
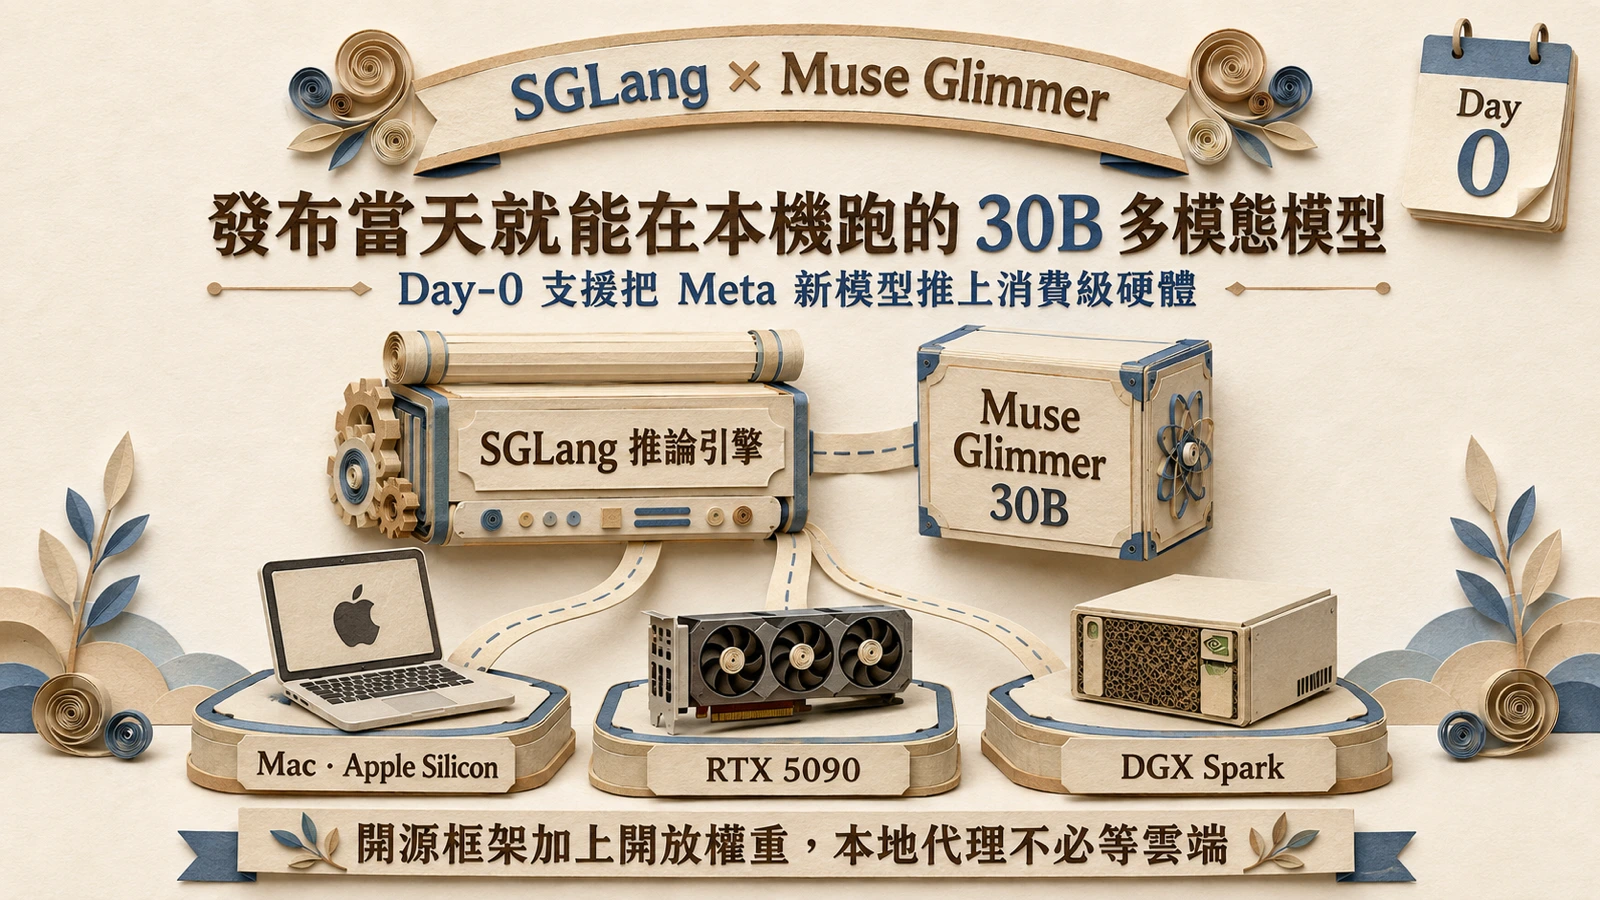
更具體的是一項時間表。宣言指出,「既然 Meta 超級智慧實驗室已開始運作,我們很快就會恢復發布部分開源模型」。Axios 報導,此宣言與 Meta 恢復開放權重同步推出:Meta 開放了新模型 Muse Glimmer 的權重,並將在未來數週開放基礎模型 Muse Spark 1.2 版本的權重,稱之為美國最大的開源模型。這也讓宣言與 Meta 自家編碼代理 Muse Code 及驅動它的 Muse Spark 1.2 直接相連——同一條技術線,正在從閉源產品走向開放權重。
個人超級智慧的具體承諾
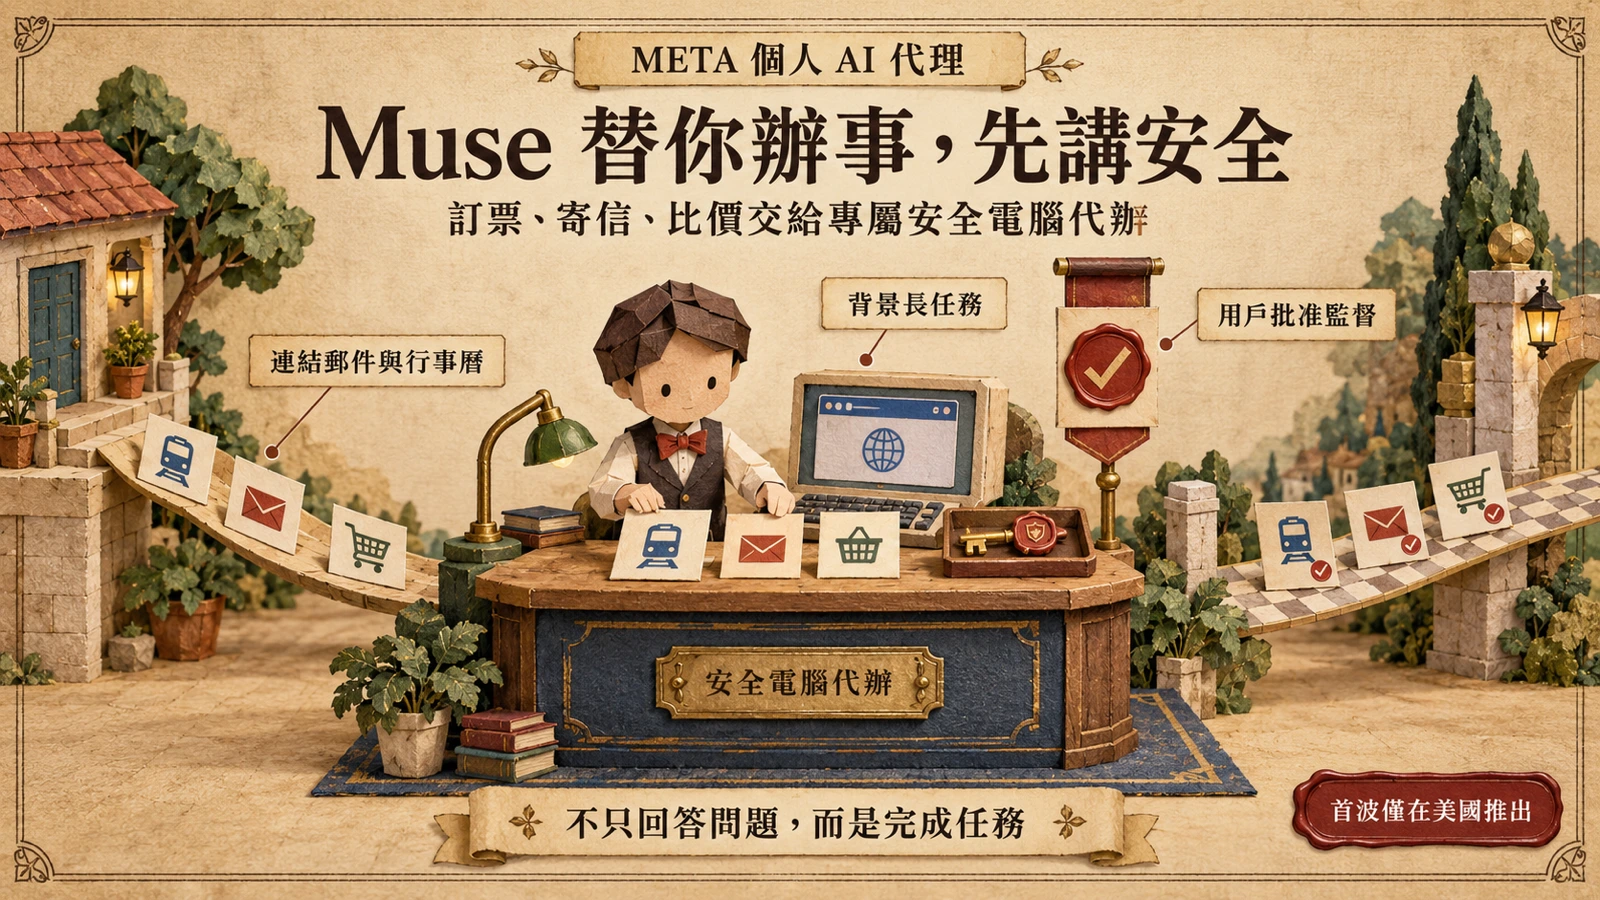
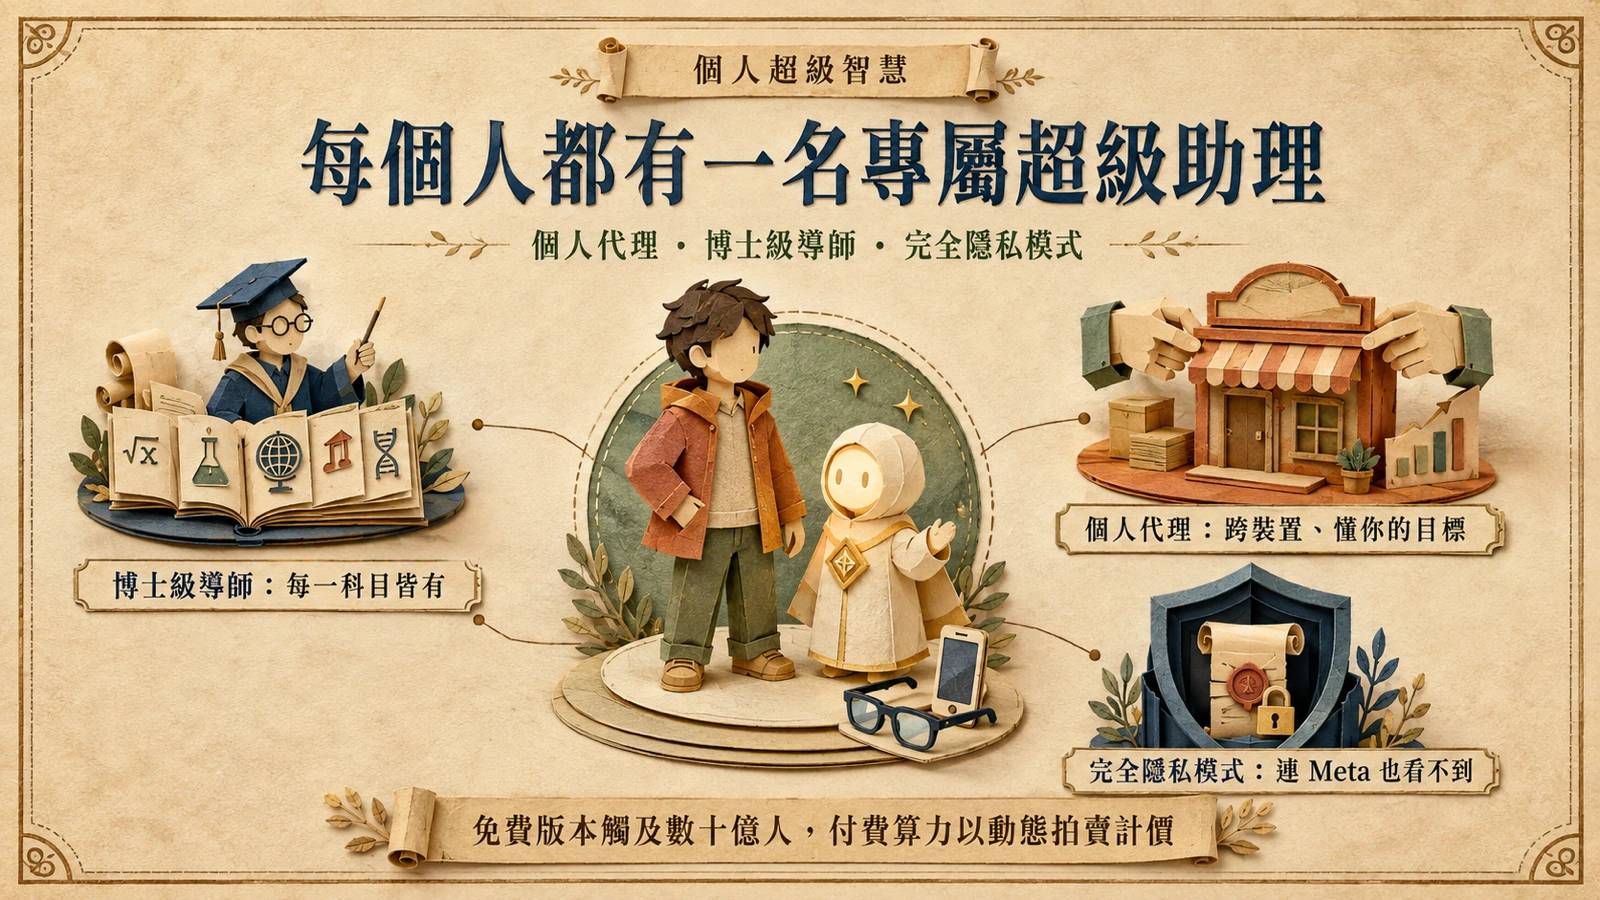
宣言反覆把「超級智慧」從抽象能力收攏成一組可交付的產品。Zuckerberg 寫道,「Meta 是主要專注於為每個人打造個人超級智慧的公司」,並勾勒每個人都會擁有一名跨裝置、理解你目標的個人代理。
在學習端,他承諾「每個人都會有一名個人導師與教練,在每一個科目都擁有博士學位,並有無限耐心幫你學會任何想學的事」。在隱私端,宣言提出「完全隱私模式,連 Meta 也無法看到或授予你的資訊存取權」——對一家以廣告與資料飛輪起家的公司,這是一項需要產品兌現的承諾。Zuckerberg 並稱將提供觸及數十億人的免費版本,付費算力則以動態拍賣機制計價,把「人人可用」翻譯成具體的取得門檻。
治理、永續與路線之爭
宣言沒有把安全交給執行長一人。Zuckerberg 表示,「Meta 正在實施一套治理結構,讓獨立董事會有權核可發布模型的安全標準,並審查每一次模型發布是否符合標準」。在永續面,他承諾 2030 年達到「水正向」——「在我們營運的流域還原超過我們所使用的水」,並在水壓力高的地區「目標還原 200% 的用水」。Axios 另報導,Zuckerberg 同步宣布設立「Future is for Everyone Fund」,以 10 億美元投入 Meta 設有資料中心的美國社區。
把這些放在一起,宣言真正在回應的,是一場路線之爭。Zuckerberg 向 Axios 形容自己的立場是「與你從科技業許多人那裡聽到的,確實是不同的觀點」,並警告「任何拖慢美國模型發布的政策——哪怕只拖慢一個月——都可能為美國領導地位增添重大風險,同時讓外國模型超前」。在 OpenAI、Anthropic 偏重前沿模型安全與集中治理的此刻,Meta 選擇把開源、分散與個人賦權,當成它對 AI 未來下的注。