為什麼是 DistilBERT 加 LoRA
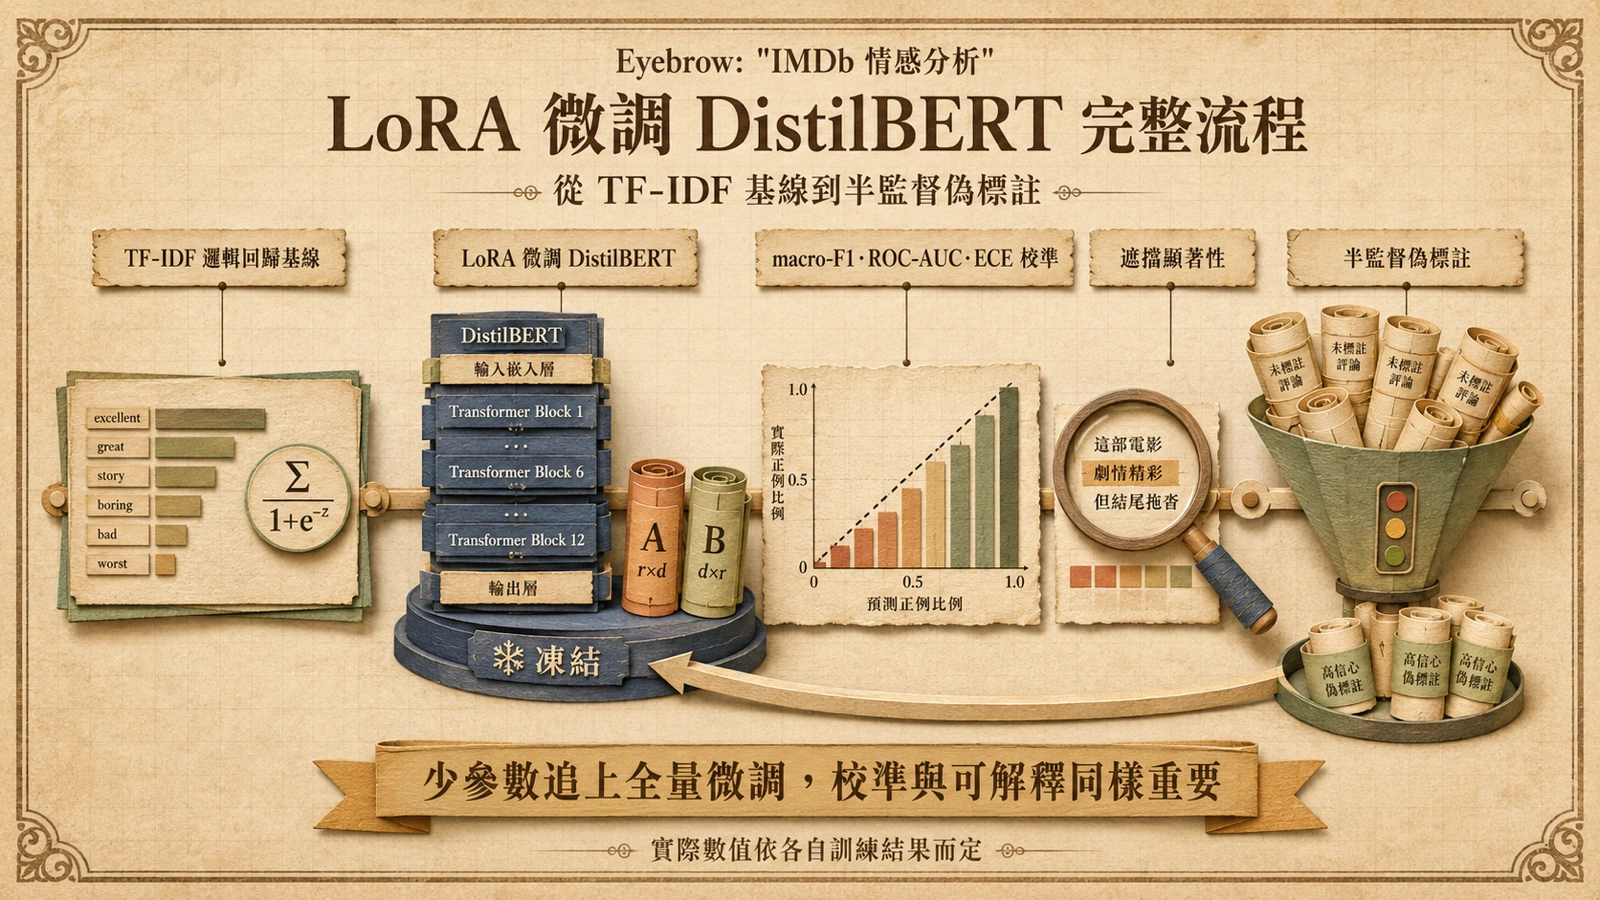
IMDb 情感分析是檢驗一條文字分類流水線最直接的題目:每筆樣本是一則影評,標籤只有正面或負面,資料量充足、標註乾淨,而且 Stanford 發布的資料集還附帶 5 萬則未標註影評,正好拿來做半監督實驗。模型選擇會直接決定後續的訓練成本與部署方式。
DistilBERT 是 BERT 的蒸餾精簡版本,透過知識蒸餾以 BERT-base 為教師,訓練出體積更小、速度更快的學生模型,並保留與 BERT 相同的 WordPiece 分詞器與最大 512 的序列長度,細節見 Hugging Face 上的 DistilBERT 模型卡。對單句情感這類任務它已綽綽有餘,而且作為開放權重模型,可在本地端完整微調與部署,不必把資料送往外部服務。
但全量微調一個蒸餾模型,仍是為了改動一小部分能力而更新所有參數。LoRA(Low-Rank Adaptation)換了思路:凍結預訓練權重,只在每一層注入成對的小型低秩矩陣,訓練這些矩陣就等於學習任務所需的權重更新。提出這套方法的 LoRA 論文指出,它能把可訓練參數減少約一萬倍、GPU 記憶體需求降到約三分之一,而且因為更新可合併回原權重,推論時不增加任何延遲。換句話說,這是成本接近特徵擷取、表現卻能追上全量微調的做法。
TF-IDF 與邏輯回歸:先立一條基線
在動用 Transformer 之前,永遠先立一條簡單基線。TF-IDF(詞頻─逆文件頻率)把每則影評轉成稀疏的詞彙權重向量:常見但缺乏區辨力的詞(the、movie)權重被壓低,能區分正負面的詞(boring、masterpiece)權重被抬高。再把向量餵進邏輯回歸,就得到一個能在 CPU 上幾秒鐘訓練完、部署成本接近零的分類器。
這條基線的價值不在最高分,而在提供參考點。它回答兩個問題:這個任務裡「詞彙層級的線性訊號」能解釋多少變異?後續花更多算力微調的 DistilBERT,提升幅度是否值得?基線若已經很強,微調的邊際收益可能有限;基線與微調差距很大,代表序列上下文與非線性特徵確實帶來關鍵訊息。評估時不要只看準確率,類別若不平衡,macro-F1 會比整體準確率更誠實。
用 LoRA 微調 DistilBERT
基線立好,主力模型登場。流程是載入 DistilBERT 的編碼器與分類頭,在注意力與前饋層注入 LoRA 適配器(adapter),設定秩 r 與縮放係數 alpha,然後只更新這些低秩矩陣、讓預訓練權重保持凍結。訓練資料是 IMDb 的 2.5 萬則標註影評,分詞沿用模型原生的 WordPiece,序列截斷在 512 以內。
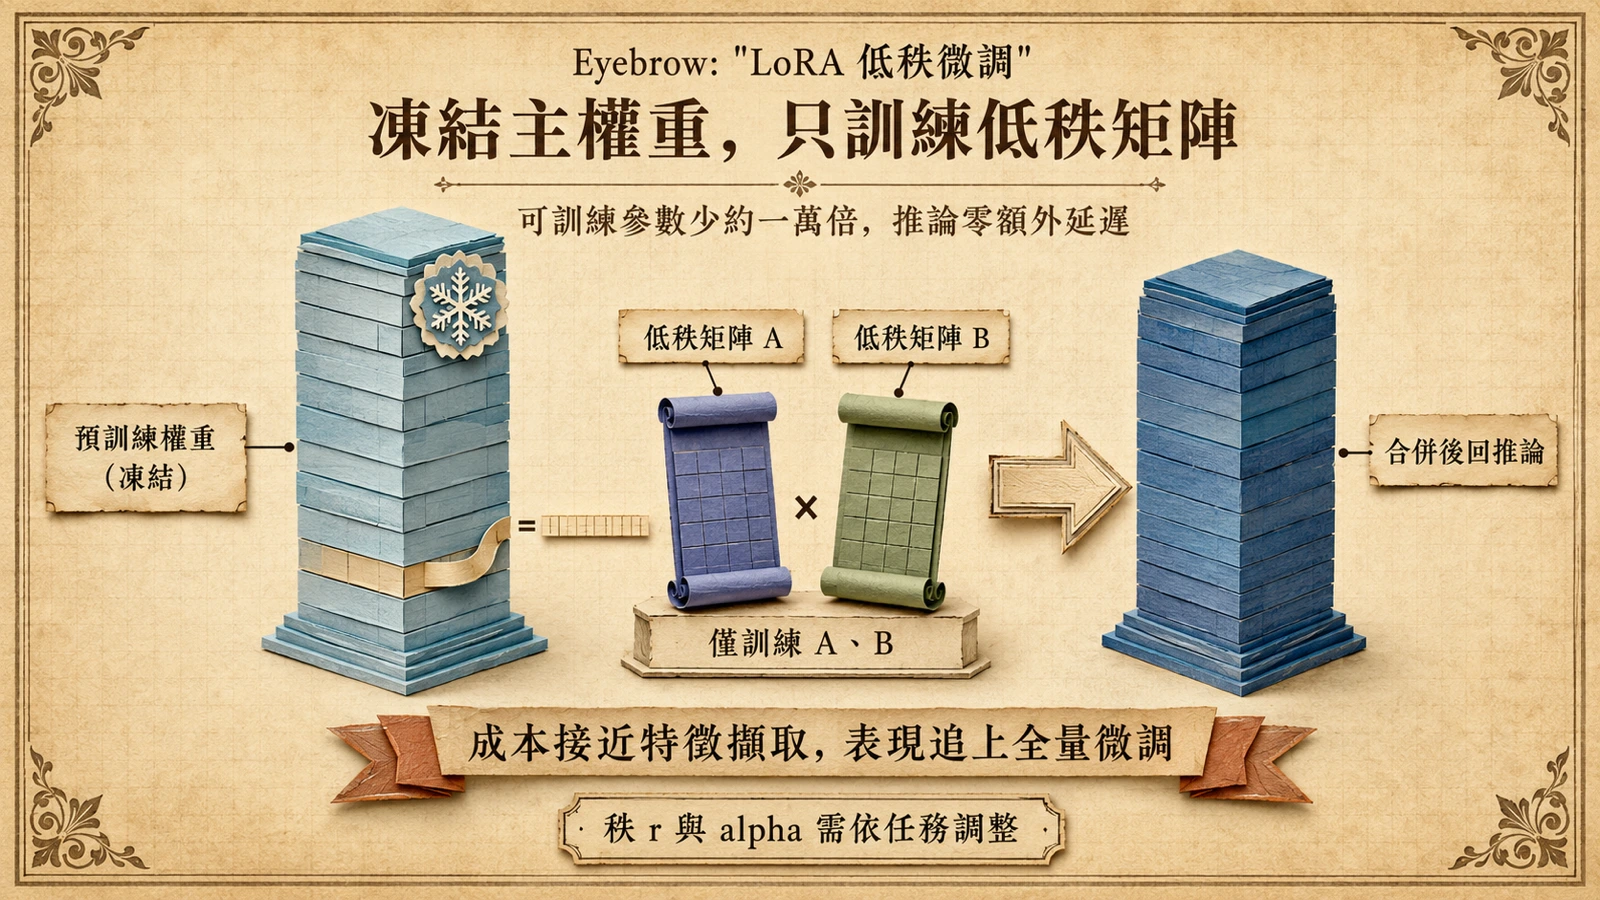
秩 r 是核心旋鈕:r 愈大,適配器能表達的更新愈複雜,可訓練參數也愈多;r 愈小愈省資源,卻可能擬合不足。對情感分類這種相對單純的任務,很小的 r 通常就夠。訓練完成後把適配器權重合併(merge)回基底模型,輸出的就是一個獨立、可直接用於推論的 Transformer,部署時與原版 DistilBERT 無異——這正是 LoRA 不增加推論延遲的原因。
macro-F1、ROC-AUC 與 ECE:超越準確率的評估
模型訓練完,真正的工程問題才開始:你怎麼知道它「好」?單看準確率會漏掉三件事。macro-F1 對每個類別算 F1 再取平均,避免多數類吃掉分數,在正負樣本不均衡時尤其重要。ROC-AUC 衡量模型區分兩類的排序能力,不依賴單一切分閾值,能看出模型對正負面的整體分離程度。
第三個、也最常被忽略的是校準(calibration)。一個分類器可能準確率很高,卻自信地犯錯——它輸出 0.99 的機率時,實際正確率可能只有 0.8。Guo 等人的研究明白指出,現代神經網路與十年前相比校準明顯變差,這項發現見於他們的 校準論文。衡量這個落差的指標是期望校準誤差(Expected Calibration Error, ECE):把預測依置信度分桶,比較每桶的平均置信度與實際準確率,差距愈大代表模型愈過度自信。把置信度與準確率畫成可靠性圖(reliability diagram)就能視覺化這個落差;該論文提出的溫度縮放(temperature scaling)只用一個參數,就能在推論前把置信度拉回合理區間,是成本極低的後處理校正。
校準不只是學術指標。當你接下來要用模型自己的置信度替未標註資料打標籤,一個過度自信的模型會把大量錯誤預測誤判為高置信而納入訓練,把錯誤放大——這正是半監督偽標註要處理的風險。
遮擋顯著性:讓預測可解釋
可信的模型還要能解釋。遮擋顯著性(occlusion saliency)的做法直觀:逐一遮蔽(mask)影評中的詞或片段,觀察預測機率變化,變化最大的詞就是模型做決定時最依賴的線索。一句負評拿掉 boring 後機率翻轉,代表模型確實抓對了關鍵訊號;若它依賴的是與情感無關的詞(例如演員名字、片長),那即使準確率高,也是脆弱的捷徑學習(shortcut),換到新資料上會失效。
這一步也能檢驗長度影響:極短的影評訊號稀薄,模型容易游移;過長的影評在截斷後可能丟失關鍵段落。逐詞顯著性讓這些失效模式從黑箱裡現形,是比任何單一指標都更有價值的診斷工具。
半監督偽標註:善用未標註影評
IMDb 資料集最有價值的一塊,其實是那 5 萬則沒有標籤的影評。Stanford 在資料集頁面寫明,除了用於訓練與測試的各 2.5 萬則標註影評,還附帶 5 萬則未標註影評,供非監督或半監督學習使用。半監督偽標註(pseudo-labeling)就是利用這批資源的標準做法:用已訓練好的模型對未標註影評預測,挑出高置信度的預測當作偽標籤,連同原始標註資料重新訓練,再比較新模型與基線的表現。
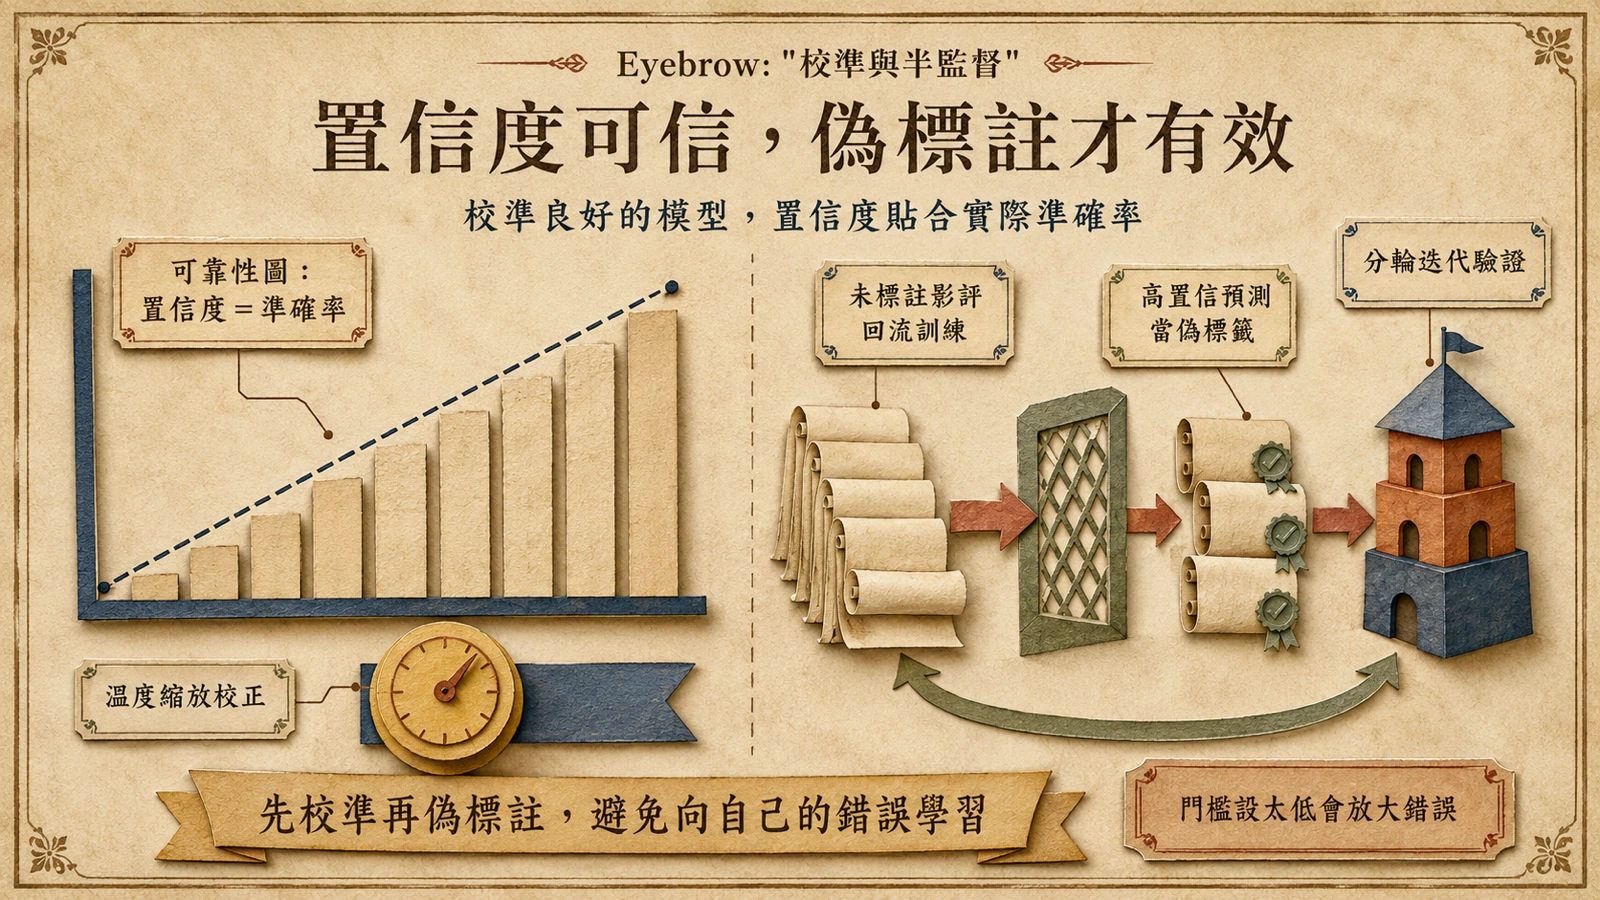
這個迴圈能否帶來淨收益,高度依賴前面幾步的品質。置信度門檻設太低,會引入大量錯誤偽標籤,讓模型向自己的錯誤學習,產生確認偏誤(confirmation bias);設太高,則幾乎沒有資料被納入。這就是為什麼 ECE 校準在這裡不是裝飾而是前提:一個校準良好的模型,其置信度才可信到足以當作篩選標準。實作上通常會迭代多輪、每輪重新校正門檻,並在獨立測試集上驗證半監督模型是否真的優於純監督基線。
這條流水線的取捨
把整條流程串起來看,幾個取捨值得記住。TF-IDF 基線成本極低,應永遠優先建立,它的強弱直接告訴你後續投資的邊際價值。LoRA 把微調一個開放權重 Transformer 的成本壓到接近特徵擷取,讓中小型團隊也能在消費級 GPU 上訓練生產級分類器;想從提示詞、RAG 一路補到微調,可接著看不用框架學 AI 工程的原始 API 路線。校準與遮擋顯著性則提醒:模型的價值不只是分對答案,而是它的置信度可不可信、它的理由站不站得住,尤其在要把置信度餵進下游決策(如偽標註)時。最後,未標註資料不是棄料,搭配可信的置信度,半監督能把現成資料的價值進一步榨出來。更多模型選型與微調實作,整理在 模型主題分類。