模型 / MODELS分析 / ANALYSIS
Meta 開源 Muse Glimmer 30B:同尺寸代理基準多項領先的本機模型
Meta 以 Apache 2.0 開源 30B 多模態模型 Muse Glimmer,蒸餾自 Muse Spark、為常駐本機代理設計,在 SWE-Bench Pro、MCP Atlas 等同尺寸代理基準多項領先,單張 GPU 即可運行。
端側與裝置端 AI 推論:微控制器、量化與邊緣部署的實測。
共 4 則文章,依發布時間排序
Meta 以 Apache 2.0 開源 30B 多模態模型 Muse Glimmer,蒸餾自 Muse Spark、為常駐本機代理設計,在 SWE-Bench Pro、MCP Atlas 等同尺寸代理基準多項領先,單張 GPU 即可運行。
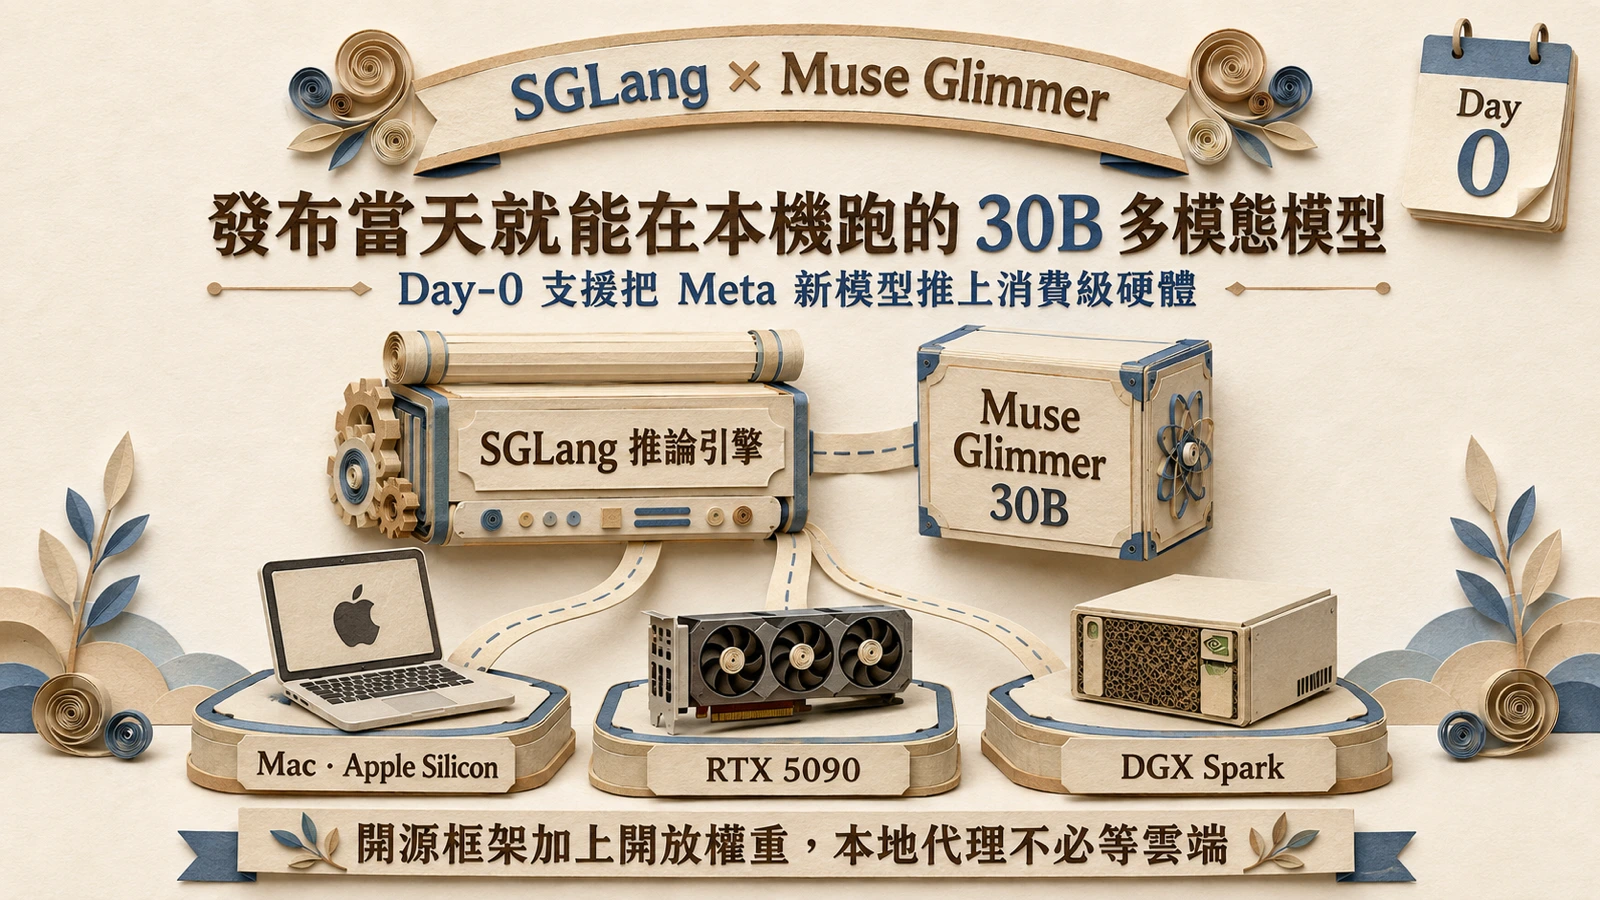
Meta 超級智慧實驗室發布 30B 多模態模型 Muse Glimmer,SGLang 同日推出 Day-0 支援,以 DFlash 推測解碼、RadixAttention 前綴快取與 CUDA graphs 在 RTX 5090 繳出每秒 1,452 token,把多模態代理搬上消費級硬體。
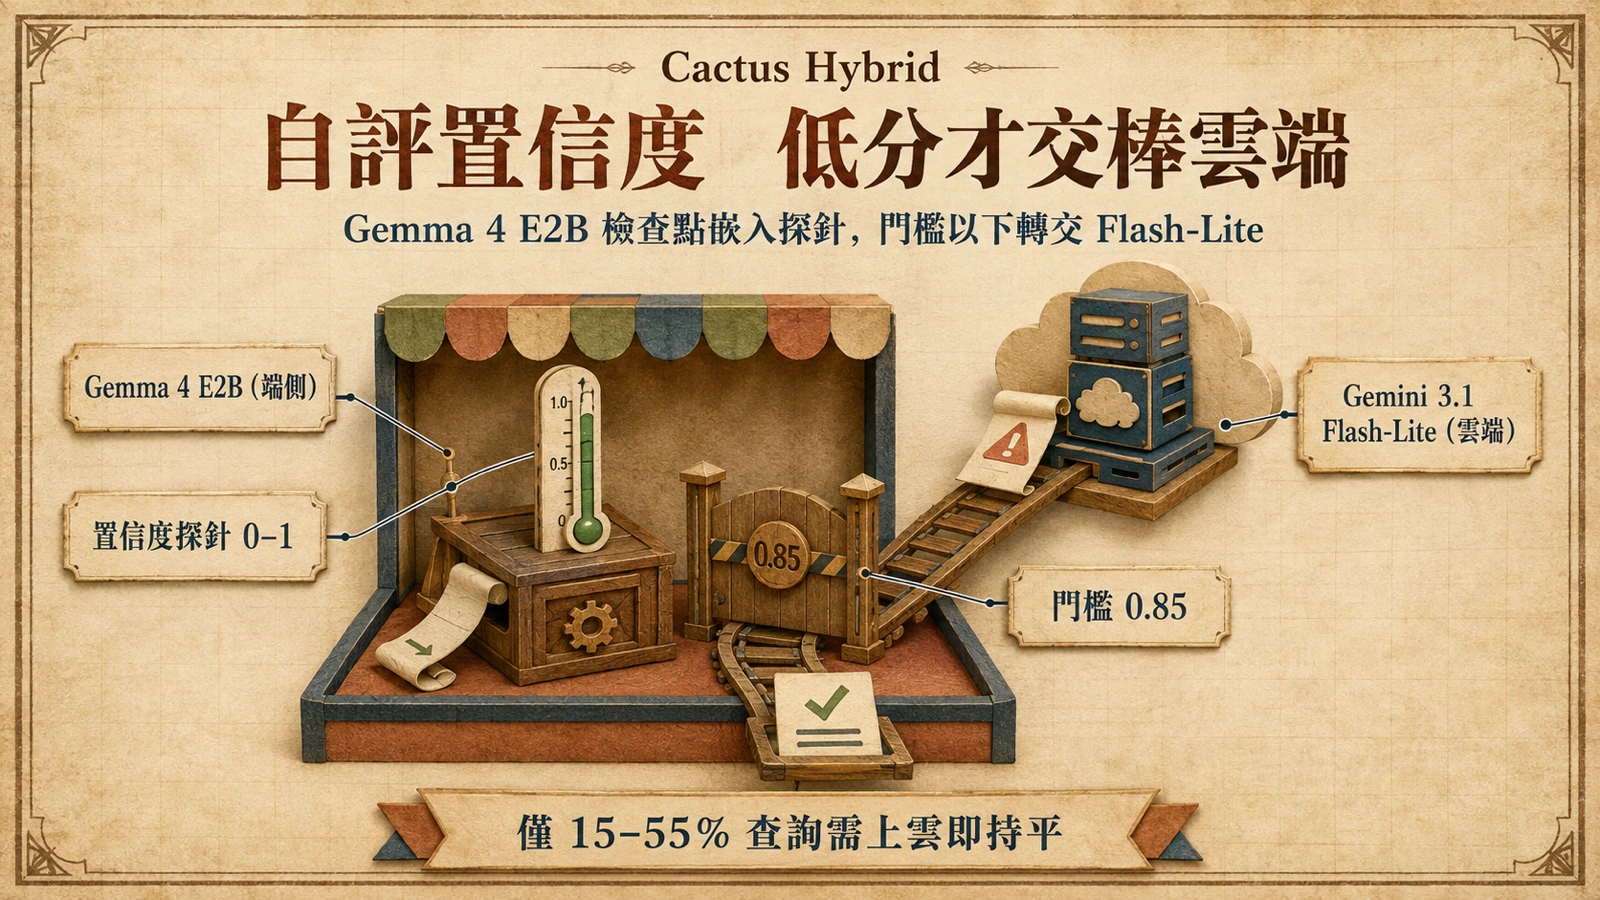
Cactus 以 Gemma 4 E2B 為基礎推出 Hybrid,在檢查點內嵌入置信度探針,為每個回答輸出 0 到 1 的結構化分數,低置信度時自動路由至 Gemini 3.1 Flash-Lite,多數基準僅需切換 15–55% 查詢即可持平。
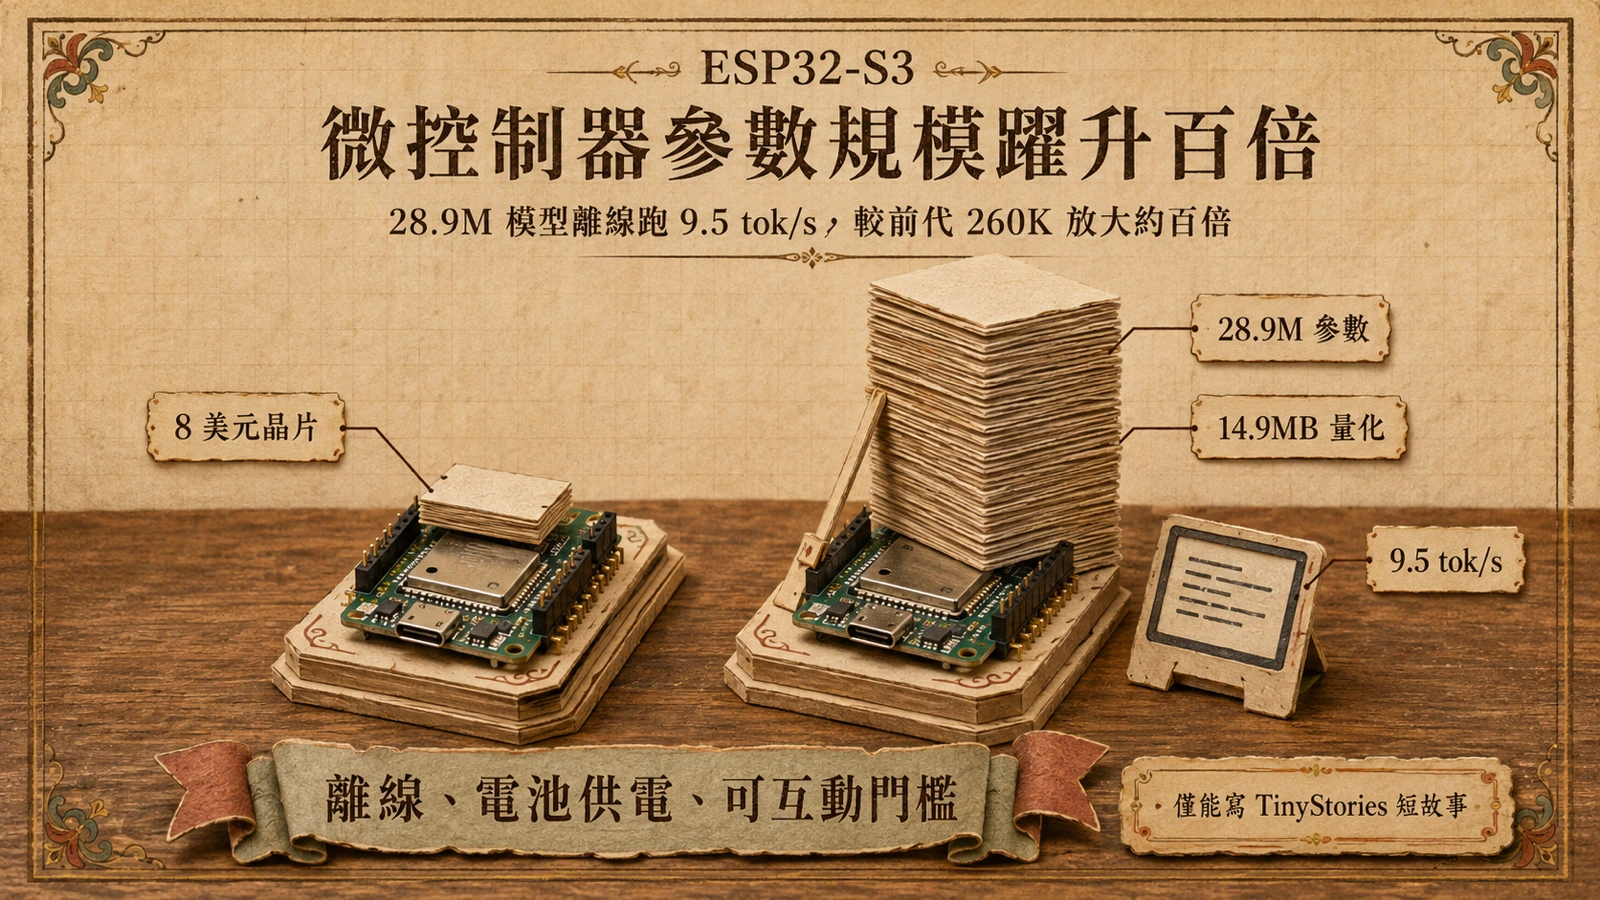
開發者 slvDev 把 28.9M 參數語言模型塞進約 8 美元的 ESP32-S3,靠 Per-Layer Embeddings 將 25M 參數留在快閃記憶體,端到端約 9.5 tok/s 完全離線生成。