28.9M 參數塞進 8 美元晶片
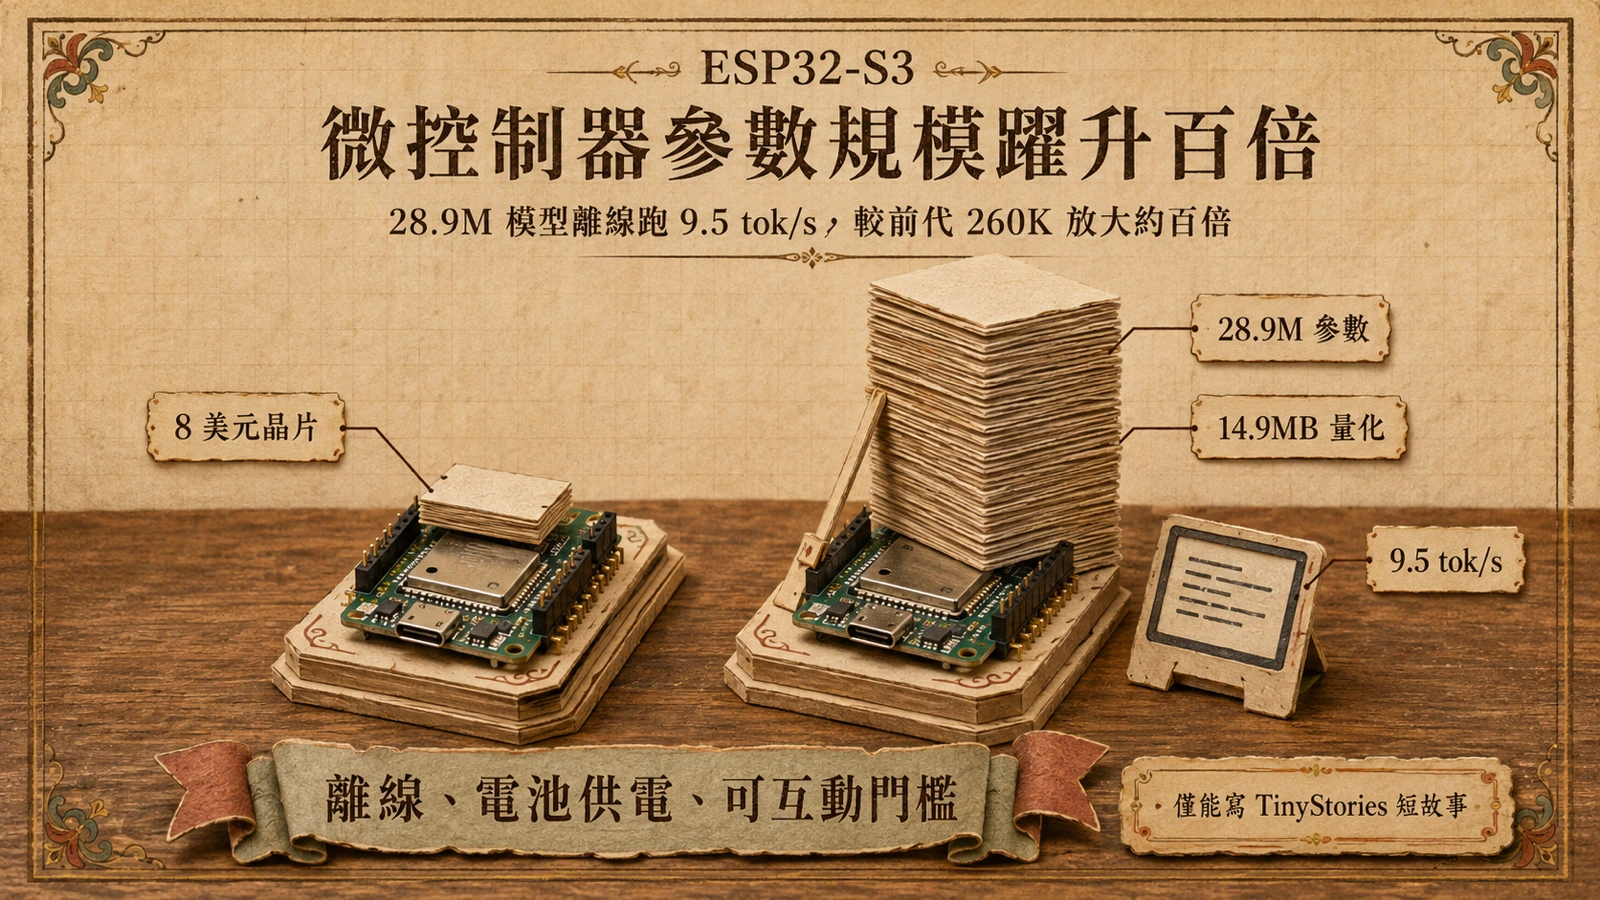
開發者 slvDev 在 GitHub 開源的 esp32-ai 專案中,於一顆售價約 8 美元的 ESP32-S3 微控制器上,跑起一個 28.9M 參數的語言模型。晶片配備 512KB SRAM、8MB PSRAM 與 16MB Flash,全程離線運算,不上傳伺服器,每秒約 9.5 token 把文字寫到外接小螢幕上。模型以 4-bit 量化後僅 14.9MB。相同等級晶片上的前一個公開語言模型只有 260K 參數,這次足足放大約百倍。
Per-Layer Embeddings:把嵌入表搬進快閃記憶體
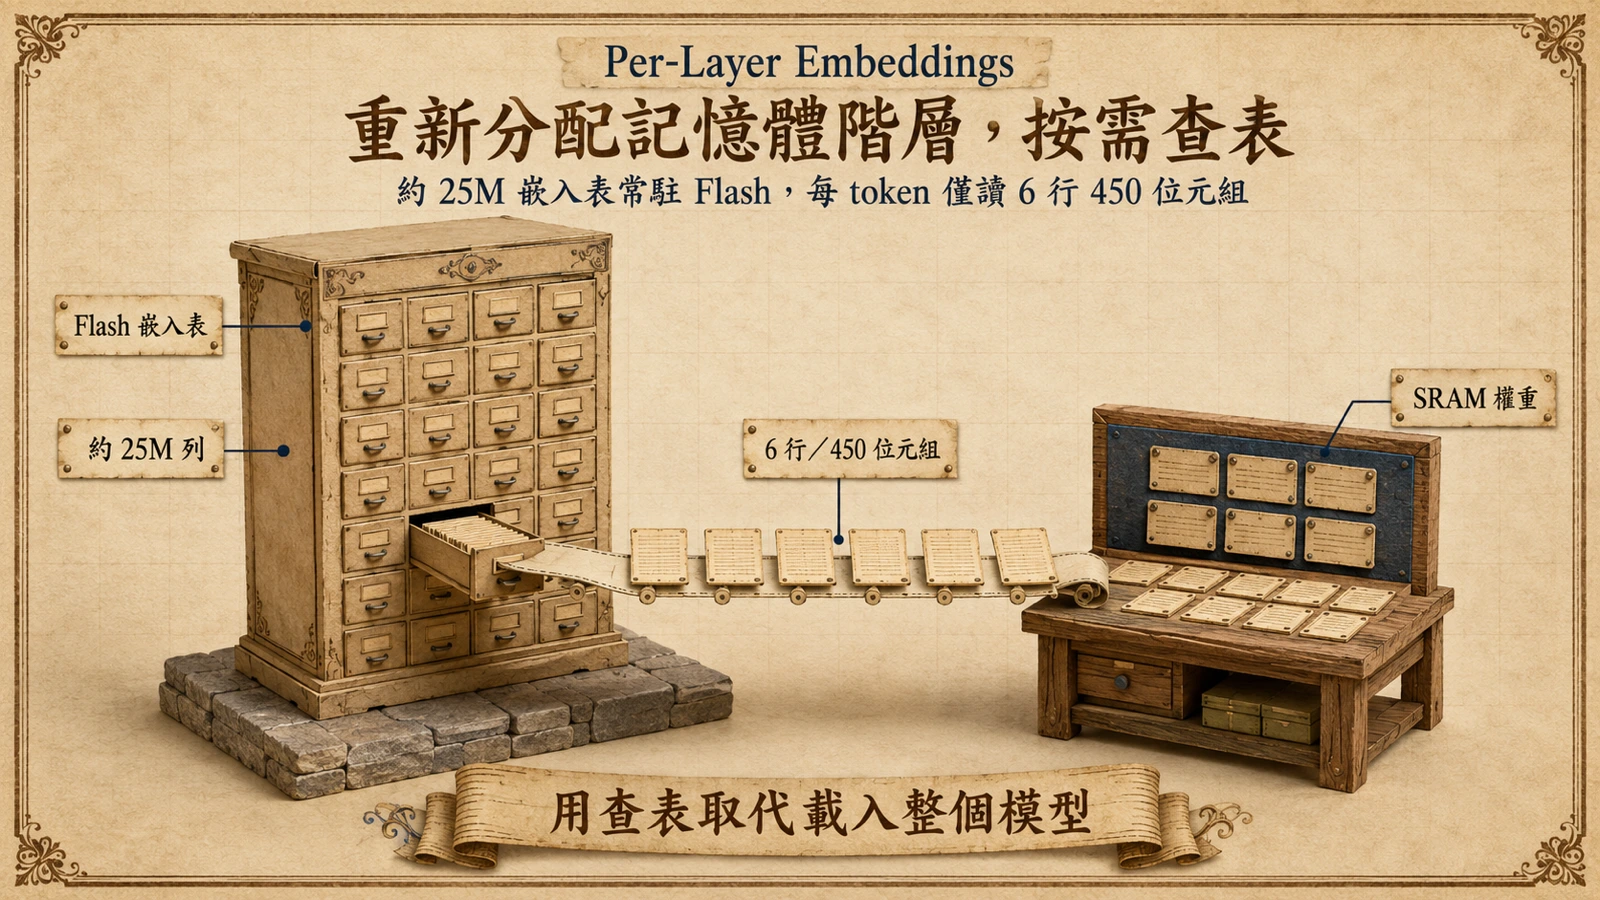
微控制器的瓶頸是快速記憶體。ESP32-S3 僅有 512KB SRAM,傳統做法要求整個模型都掛在這裡,因而只能跑極小模型。這個專案的關鍵是借用 Google 在 Gemma 3n 與 Gemma 4 提出的 Per-Layer Embeddings 設計:把語言模型中占比最高的嵌入表(約 25M 列)留在慢速 Flash,每個 token 只讀出所需 6 行、約 450 位元組,真正參與計算的少量權重才放進 SRAM。結果是大模型幾乎不用常駐快速記憶體,等於「用查表取代載入」。
記憶體牆與 MCU 推理的經濟學
微控制器推理的真正瓶頸從來不是算力,而是記憶體頻寬與容量,見〈Helmsman 全快閃向量檢索〉。ESP32-S3 的 512KB SRAM 在傳統部署模式下必須同時容納模型權重、KV 快取與中間激活值,這也是為什麼過去同等級晶片上能跑的語言模型被壓在 260K 參數。Per-Layer Embeddings 的突破不在於發明新運算,而在於重新分配記憶體階層:把占比最高的嵌入表常駐在便宜、大容量但慢速的 Flash,僅在每個 token 需要時讀出 6 行約 450 位元組,把稀缺的 SRAM 留給真正參與矩陣運算的少量權重。這等於把「載入整個模型」改寫成「按需查表」,也讓 8MB PSRAM 與 16MB Flash 從單純的儲存升級為推理流水線的一部分。9.5 tok/s 的速度在雲端標準下微不足道,但對於一支離線、電池供電、售價個位數美元的裝置而言,已是可互動的門檻——它的對標對象不是 GPT,而是無法聯網時完全失去能力的智慧家居與工業感測節點。
能做什麼、不能做什麼
模型以微軟研究院的 TinyStories 資料集訓練,能寫出結構大致連貫的短篇故事,但無法回答問題、遵循指令、寫程式或陳述事實。作者明說,真正有趣的是架構——把大模型塞進微小晶片,而非這個 28.9M 模型能說出什麼。選擇 TinyStories 是刻意的:它合成自極受限的詞彙與句型,訓練成本可控,剛好足以驗證「大模型能否在 MCU 上跑起來」這個命題,而不被通用語言能力的評比綁架。要讓端側模型跨過「寫故事」走向「聽指令」,瓶頸不在這顆晶片能塞多大的權重,而在指令微調資料、上下文長度與 KV 快取空間——後者在僅 512KB SRAM 上仍是硬限制。repo 亦公開訓練、量化、消融實驗與片上實測,並保留作者自行更正早期參數統計錯誤的提交歷史。
9.5 tok/s 的延遲拆解:能否支撐即時互動
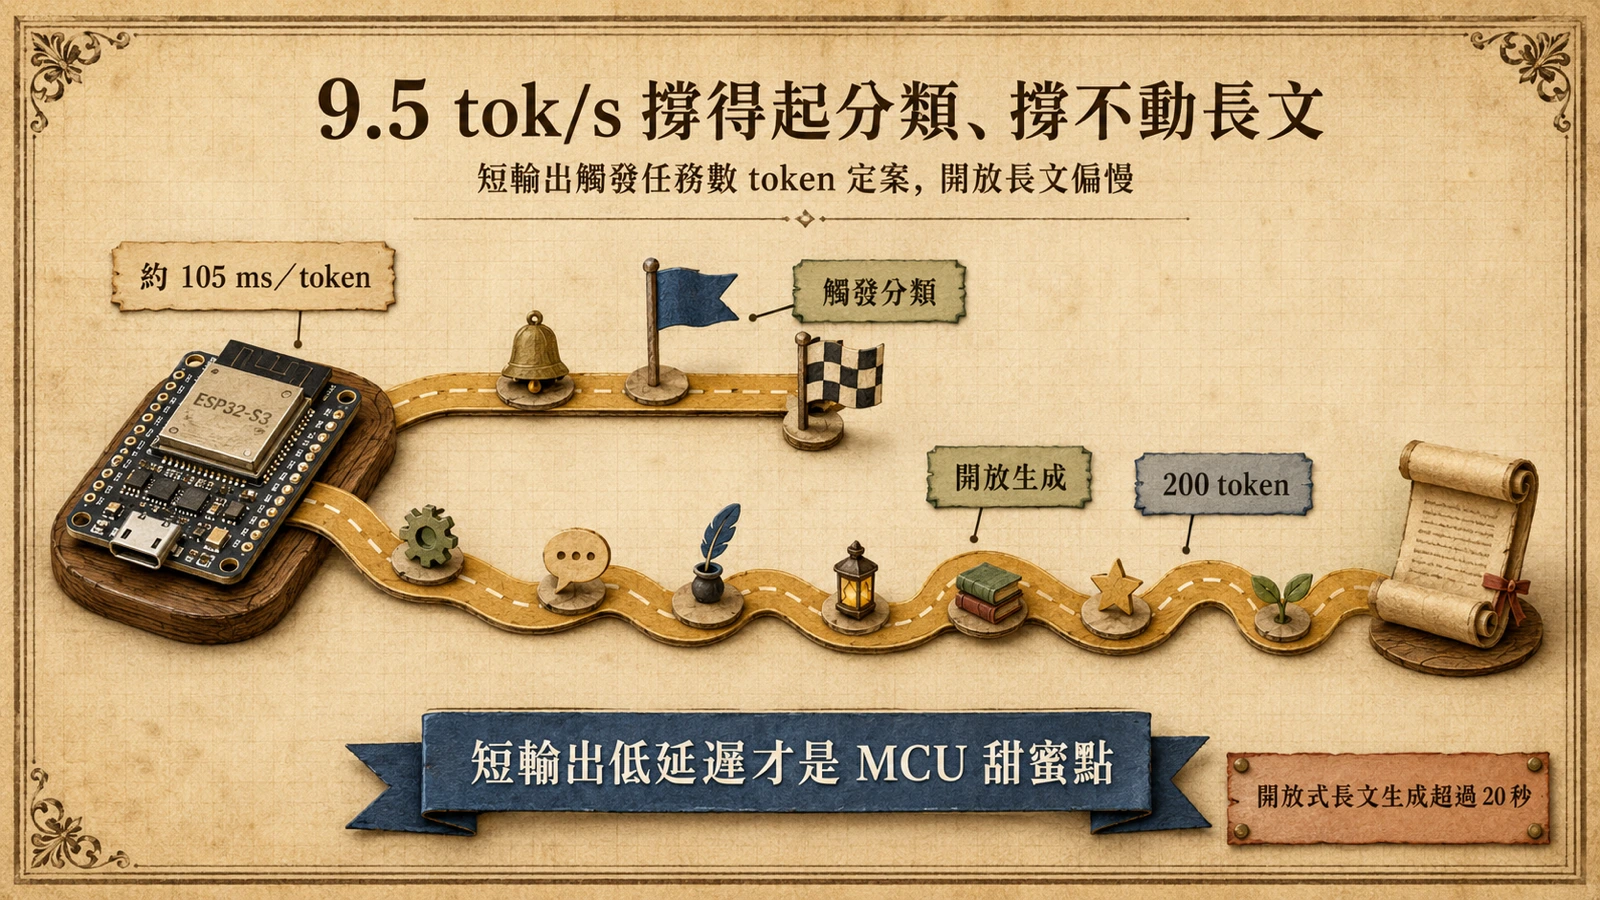
9.5 tok/s 換算約每 token 105 毫秒,生成一篇 200 token 的短故事需連續運算超過 20 秒,對開放式文本生成顯然偏慢。但若把視角從「寫故事」換到分類與觸發式任務——例如喚醒詞辨識、意圖分類、異常偵測——這些只需數個 token 即可定案的工作,9.5 tok/s 其實已落在可互動區間,真正的產品瓶頸並不在這裡。更值得分析的是 Flash 讀取的隱藏成本:每 token 雖僅讀約 450 位元組的嵌入列,但權重存取、PSRAM 換頁與量化反量化都疊加在同一條記憶體匯流排上,實際功耗與延遲取決於 Flash 的隨機讀取效能與 SRAM 命中率,而非乘加算力。這也解釋了作者選擇 TinyStories 作為驗證載體的理由:開放式長文生成本就不是 MCU 的甜蜜點,以它來證明「架構可行」而非「實用輸出」,是更誠實的命題設定。對產品團隊而言,與其複製寫故事示範,更該鎖定短輸出、低延遲、離線優先的分類與觸發場景,來評估這條路線的落地價值。
對硬體決策者的意義
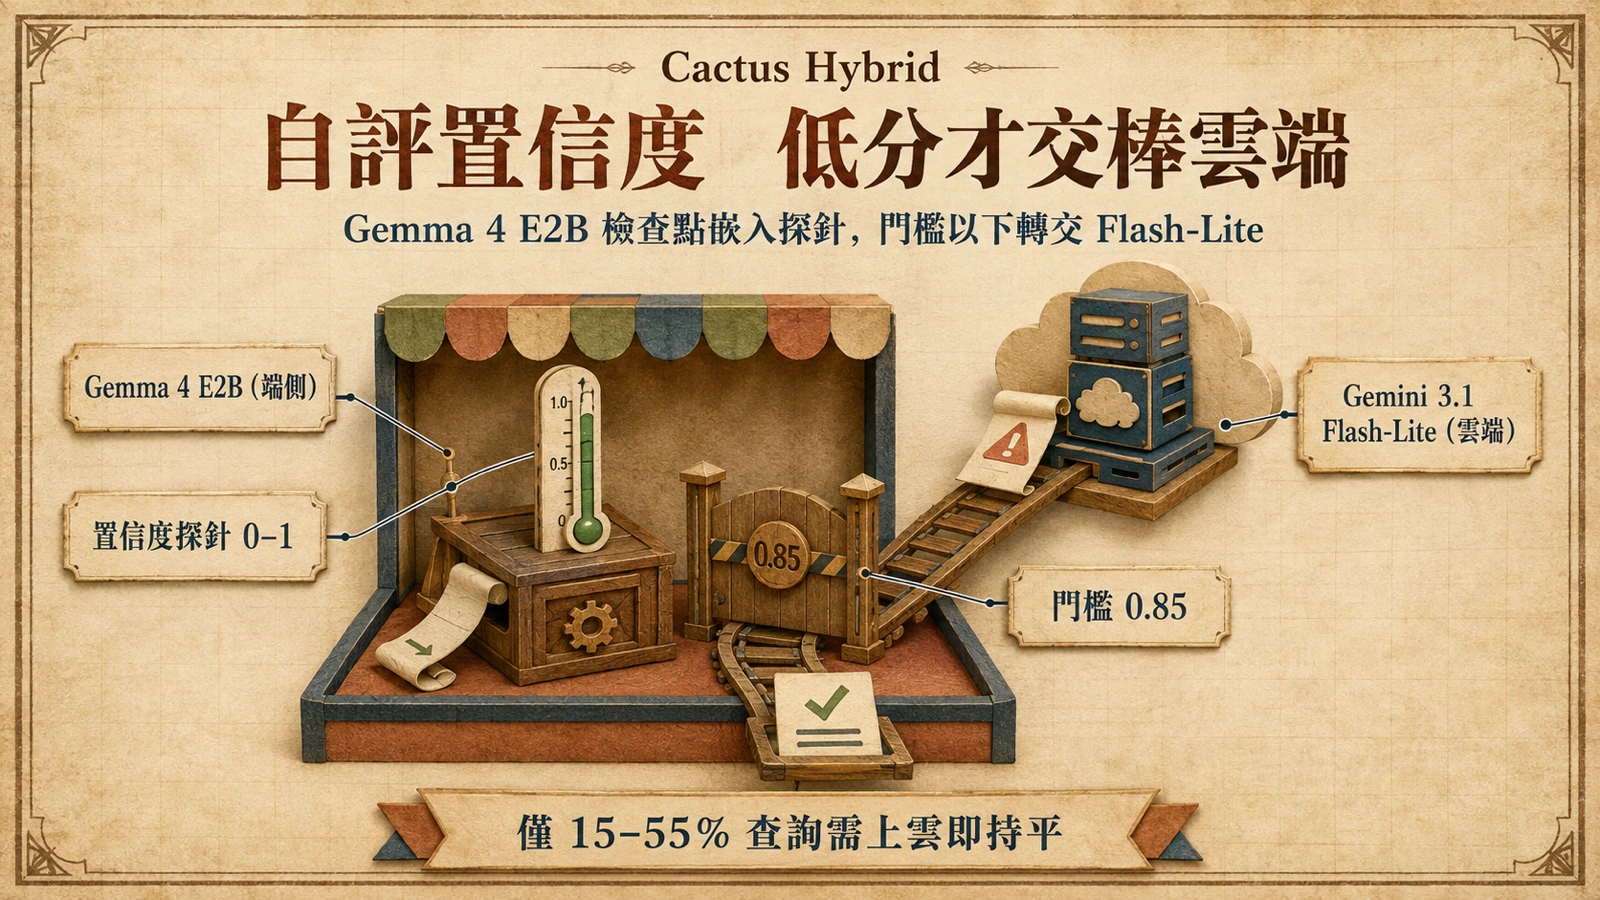
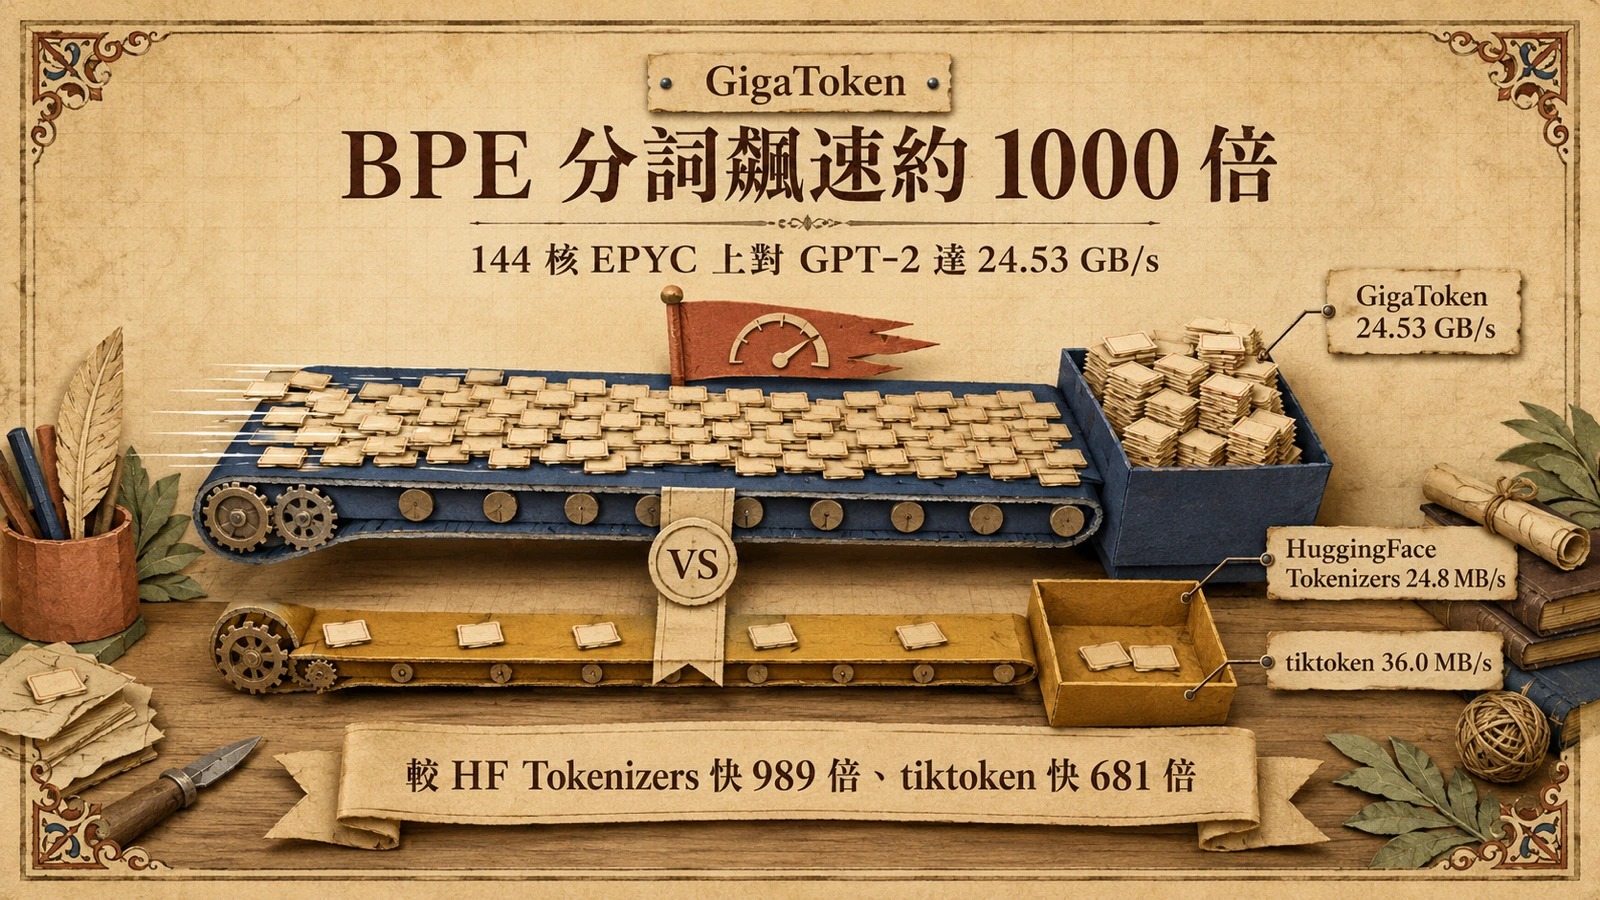
這個專案不是要挑戰雲端 LLM,而是把 Per-Layer Embeddings 從手機、GPU 拉到 MCU 級硬體的工程示範。對物聯網、智慧家居、離線語音與邊緣裝置團隊而言,它指向一條可落地的路徑:在數美元的晶片上保留端側推理能力,同時把雲端依賴與資料外傳風險降到最低。若端側模型需要在信心不足時把任務交給雲端,Cactus Gemma 4 E2B Hybrid 的置信度路由展示了另一種混合架構。專案已獲 1.2k stars、121 forks,採 MIT 授權。若工作負載擴大到大量訓練資料前處理,瓶頸會轉向另一端,可對照〈GigaToken 的 BPE 分詞吞吐實測〉。