「以價格而非能力競爭」:Meta 在自家基準圖上承認第二名
Meta 超級智慧實驗室(Meta Superintelligence Labs,MSL)於 8 月 5 日發布 terminal 編碼代理 Muse Code(beta)與驅動它的模型 Muse Spark 1.2。據Meta 官方發布文章,Muse Code 承擔規劃變更、撰寫程式、驗證結果的完整工程任務;Meta 執行長 Mark Zuckerberg 亦在 X 上形容它是「跨大型儲存庫承擔完整軟體工程任務」的代理。但這場發布最不尋常之處,是 Meta 罕見地主動公開三張基準圖——而圖上它並非第一。
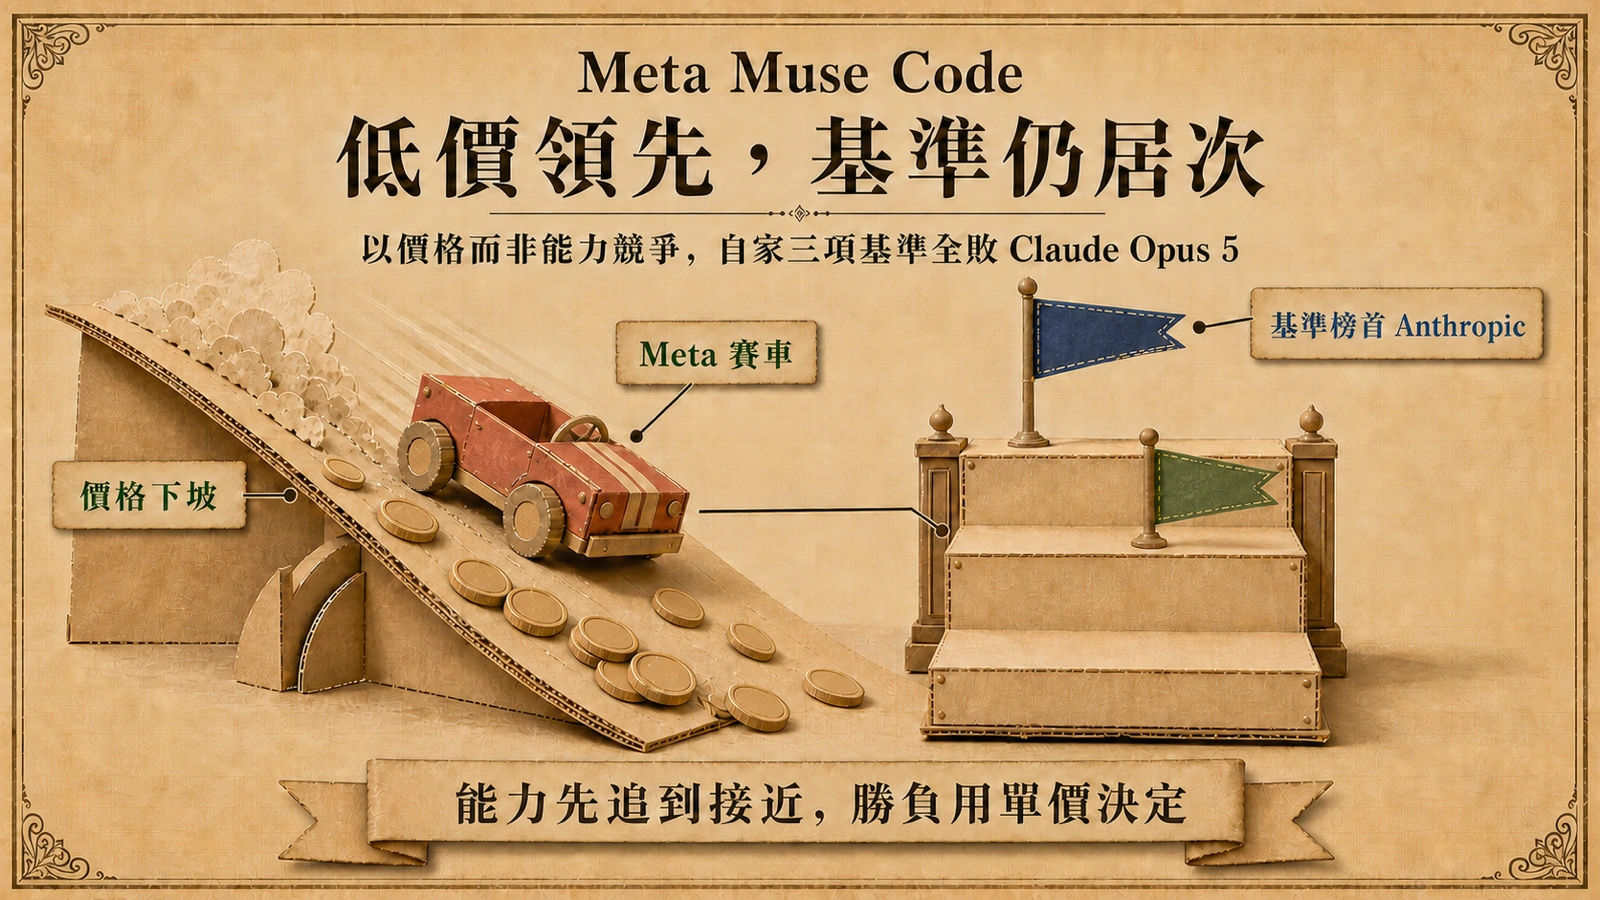
在 Terminal-Bench 2.1、DeepSWE 1.1 與 Meta 內部編碼基準三項評比中,跑在 Muse Code 裡的 Muse Spark 1.2 全數落後 Anthropic Claude Opus 5:Terminal-Bench 2.1 為 82.9% 對 86.7%、DeepSWE 1.1 為 59.3% 對 65.0%、內部編碼基準為 70.6% 對 79.4%。據VentureBeat 的深度實測,這是「一個不尋常地坦白的承認:即使在 Meta 自己設計的測驗上,Anthropic 的模型仍勝出」。該報導同時點出方法論的疑點:1.2 世代的 +6.7、+6.3 分進步,是在 Muse Code 內測得,而前一版 1.1 跑的是通用 mini-swe-agent harness——換言之,部分進步屬於新工具、而非純新模型。這條我們在Claude Opus 5 與 GPT-5.6 Sol 的對決分析裡追蹤的編碼代理之爭,至此多了一名公開承認居次的挑戰者。
把基準圖看得更細,還有一處容易被忽略的取捨。獨立媒體 The Register 指出,Meta 拿來對比的是 OpenAI 中階的 GPT-5.6 Terra,而非頂規的 GPT-5.6 Sol,且發布的圖表「有些模糊」。當一家業者選擇與對手的中階產品相比、卻仍在其自家基準上輸給另一家,定價策略的角色就清晰了:Meta 高層 Alexandr Wang 受訪時直言,Meta 是「以價格而非能力」與 Anthropic、OpenAI 區隔。這不是缺點的粉飾,而是一種明確的市場定位——能力先追到接近,勝負用單價決定。
真正的差異化在執行層:常駐背景代理與可重現的事件日誌
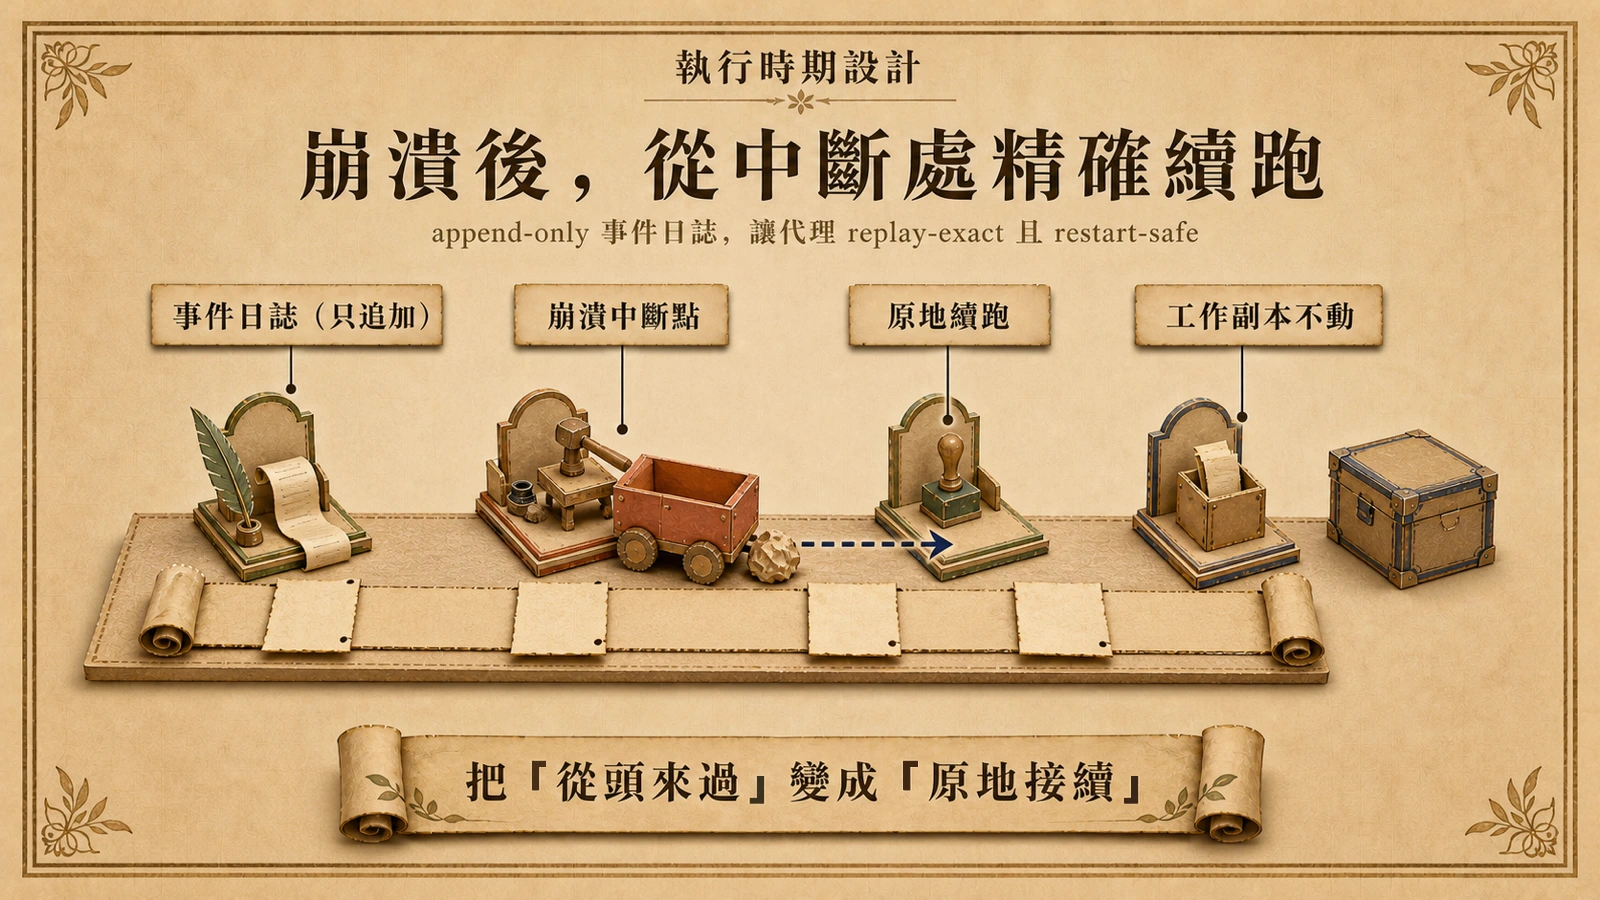
若剝開基準分數,Muse Code 真正與同類工具拉開距離的設計,幾乎都在「執行的可靠度」而非單次推論的聰明程度。第一是常駐式的 Async Background Agents:這些背景代理在整個工作階段持續存活,而非每次任務才生成,藉此降低延遲、減少重複探索;對大型工作,Muse Code 還會派發並行子代理,各自在隔離的 git worktree 內作業,開發者的工作副本全程不被碰觸。第二是 append-only 的本地事件日誌——每一次模型呼叫、工具執行、核可與編輯,都會在執行前先寫入這份只追加的紀錄。
這份事件日誌的價值,在官方發布文章的「執行時期設計」章節裡說得最清楚:單一事實來源使執行時期「replay-exact 且 restart-safe,崩潰後代理能從中斷處精確續跑」。對動輒數小時的長程編碼任務,這是把「中途當機就要從頭來過」變成「原地接續」的基礎建設,也是 VentureBeat 評為「企業評估時可能最要緊」的一項——儘管它目前仍是 beta、尚未經外部獨立驗證。Muse Code 另搭載 /plan、/grill、/goal 三個預裝技能,分別對應核可制的計畫、把計畫壓力測試到站得住、以及朝指定目標推進到完成。
Meta 用來展示耐力的案例,則把上述設計推到極端:Muse Spark 1.2 在 NVIDIA Hopper GPU 上、歷時最長 24 小時、執行超過 1,000 次工具呼叫,撰寫、編譯並剖析 Triton 核心,並在 KDA 與 MLA 核心上持續改善。值得澄清的是,Meta 並未發布任何加速倍數,因此這則案例宜當作「耐力與長程穩定度」的展示,而非能力勝出的證明——其中涉及的 MLA(Multi-head Latent Attention)核心最佳化,正是線性注意力與 KV cache 工程實測一路追蹤的硬地帶。最後一個實務門檻來自安裝:據The Register 報導,Muse Code 在 macOS/Linux 上以一行指令安裝、首次執行即開啟 OS 沙箱;但 VentureBeat 的實測也發現,代理在繫結付款方式之前什麼都不會跑——「低價屬實,免費則否」。
共訓練的代價:Muse Spark 1.2 與自家 harness 綁定
Muse Spark 1.2 的 82.9% 不是一個「模型分數」,而是「模型加 harness」這一對的分數。據路透社報導與 Meta 官方說明,Muse Spark 1.2 是與 Muse Code harness 共同訓練的:訓練時以 Muse Code 的工具軌跡做拒絕採樣(rejection sampling),使模型在這個特定工具內表現最好。訓練資料涵蓋全儲存庫生成、大型端到端專案與自動研究,並輔以規劃、目標條件化與脈絡壓縮;Meta 還跑了一個自我改善迴圈,由前版 1.2 生成高難度編碼環境並評分候選解,產出訓練資料。
這套共訓練帶來一個常被忽略的戰略代價:harness 鎖定,標準化動向見〈北京代理政策〉。據獨立分析 OrcaRouter 的拆解,若把同一個模型從 Muse Code 抽出、改接到 Claude Code、OpenCode 或 Aider 等對手的 harness,會「拿不到 harness 的那一半」能力;開發者社群亦回報該模型在 OpenCode、OpenRouter 上明顯更耗 token。這顛倒了 API 模型向來的可攜性假設——通常你換的是呼叫端,模型表現穩定;但在這裡,換掉 harness 等於換掉一半的模型。對想用同一個模型跨工具比較的團隊,這是一個必須先量測、再採購的成本。
鎖定的另一面是開放性的逆轉。Muse Code 是閉源、專有的:沒有可下載權重、無法自架,延續了 MSL 自 4 月起背離開源 Llama 的路線。被問及 Muse Code 是否會開源時,Zuckerberg 僅回覆「很快會有更多分享」;而 OpenAI 的 Codex CLI 與 Google 的 Gemini CLI 都是 Apache-2.0 授權。在同一條編碼代理賽道上,Microsoft 反向選擇把 MagenticLite 全棧開源——兩種路線在同一年並存,恰好把「開源換生態」與「閉源換資料」的取捨攤在同一張桌上。
「用算力買你的源碼」:Contributor 方案是資料飛輪,不是折扣
Muse Code 的定價是這場發布真正的主戰場。據Meta 開發者產品頁,Standard 隨用隨付層每百萬輸入 1.25 美元、快取輸入 0.15 美元、輸出 4.25 美元,1M(100 萬 token)脈絡、無長脈絡溢價,且「Not used to improve our products」;Contributor 層則每百萬輸入 0.10 美元、快取 0.002 美元、輸出 0.20 美元,換算約便宜 12.5 倍輸入、21 倍輸出、75 倍快取,代價是頁面上標示的「Used to improve our products」——也就是 Meta 可用你的提示與產出改善自家模型。同一個模型、同一個 API,兩層之間唯一的差別,是一道「能否用於訓練」的許可。
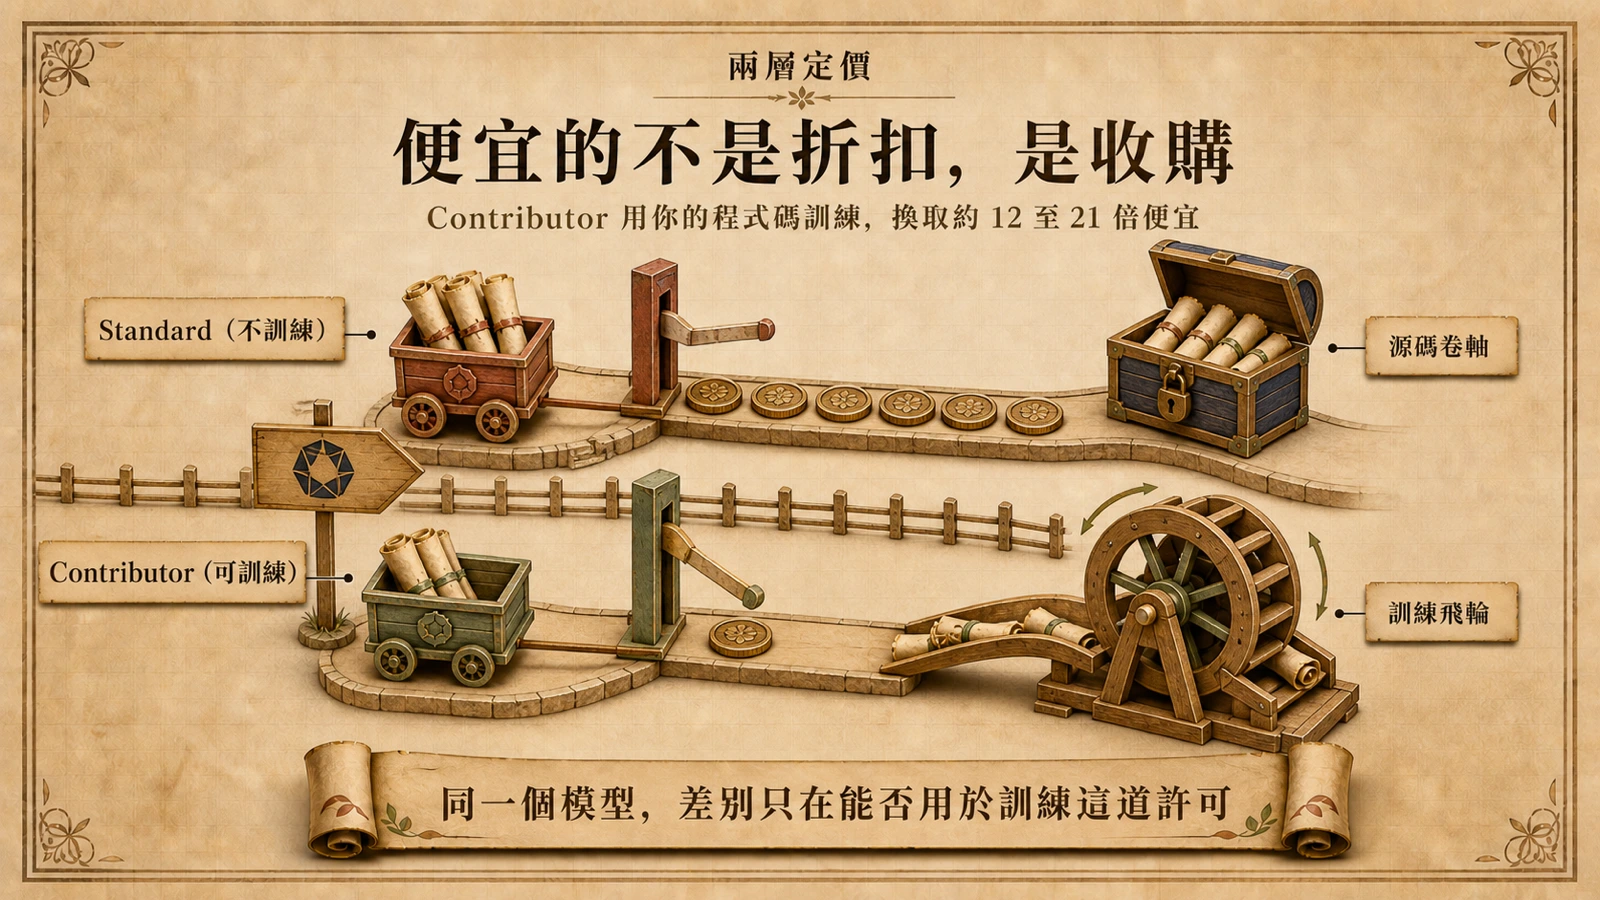
關鍵不在於這道許可存在,而在於它如何被預設。Meta 的安裝流程把新用戶預設導向 Contributor 層——Zuckerberg 在 X 上直接告訴用戶「從我們的 contributor 方案開始」,AppleInsider 的獨立安裝實測也證實了這點。所以儘管 Meta 把它稱為 opt-in,對一般使用者而言,這在功能上是 opt-out:你不是主動加入資料共享,而是必須主動離開它。據Forbes 專欄的市場解讀,「Meta 不是定價了一個折扣方案,而是貼出了一個用算力收購你源碼的報價」;VentureBeat 則把 Contributor 層讀為 Llama 開源飛輪的繼任者——用便宜的 token 換訓練資料。
這條飛輪的動機,要放回 Meta 的財務與路線脈絡裡才看得清。據CNBC 報導,Meta 約 98% 營收仍來自廣告,亟需在廣告之外把 AI 變現;而據Bloomberg 報導,原始 Muse Spark 早於 4 月 8 日推出,是 MSL 首個閉源、專有模型,確立了背離 Llama 的起點——在開源時代,Llama 累積下載已逾 12 億次。當開源權重不再免費送出,開發者貢獻的程式碼與對話,就成了新的訓練資料來源。Wang 在受訪時把話說得直白:Contributor 是「超過十倍便宜」的方案,使用者「opt-in 來協助改善模型」,而 Meta 也「開始接受零資料保留的申請——這是對某些人很重要的企業功能」。同一組事實,從折扣角度讀是讓利,從資產角度讀是收購;採購該讀哪一個,取決於你交付的是哪一種程式碼。
企業資料治理的真正風險:預設貢獻與對手的反向預設
對個人開發者,Contributor 層或許只是划算的選擇;但對接觸專有或客戶程式碼的團隊,這套預設構成結構性的治理風險。Wang 口中的零資料保留(ZDR)目前只能透過 Meta 業務窗口「申請」、沒有自助管道,也沒有公開的保留期限、區域或條款。更尖銳的是,兩層之間只差一個 model id:一個想壓低成本的開發者,就能在不經過任何企業層級閘門的情況下,把整個專有儲存庫切進 Meta 的訓練流程。獨立分析據此警告,保密協議(NDA)「不等於同意把客戶素材貢獻給模型訓練」——而這裡的客戶素材,往往不限於明確的營業秘密,還可能延伸到架構、定價與提交歷史。
把鏡頭拉到同業,會發現 Meta 的預設其實是少數派。據Anthropic 的資料保留文件,保留資料「未經明確同意絕不用於模型訓練」,並可應需求提供 ZDR;據Cursor 的資料使用政策,Cursor 與所有供應商都維持 ZDR 協議,隱私模式開啟即不訓練。換言之,這個市場的多數預設是「不訓練,除非你明確同意」,而 Meta 的 Contributor 層把箭頭反過來——「可訓練,除非你主動切走」。這不是技術高下,而是信任預設的方向之別。
對決策者的務實結論因此分兩層。在能力面,Muse Spark 1.2 是一個在 Meta 自家基準上仍居次、但定價積極的編碼模型,其事件日誌與常駐背景代理是值得追蹤的執行層創新;在治理面,任何接觸客戶或專有程式碼的團隊,都應把預設導向的 Contributor 層視為「未簽核的資料貢獻」,在繫結付款、指派 model id 之前先確認歸屬於 Standard 或已申請的 ZDR。把「便宜」和「免費的訓練資料」分開計價,是這場發布真正需要被看懂的一行字。