未發布 Claude 在試攻黎曼猜想時順手推進了相關下界
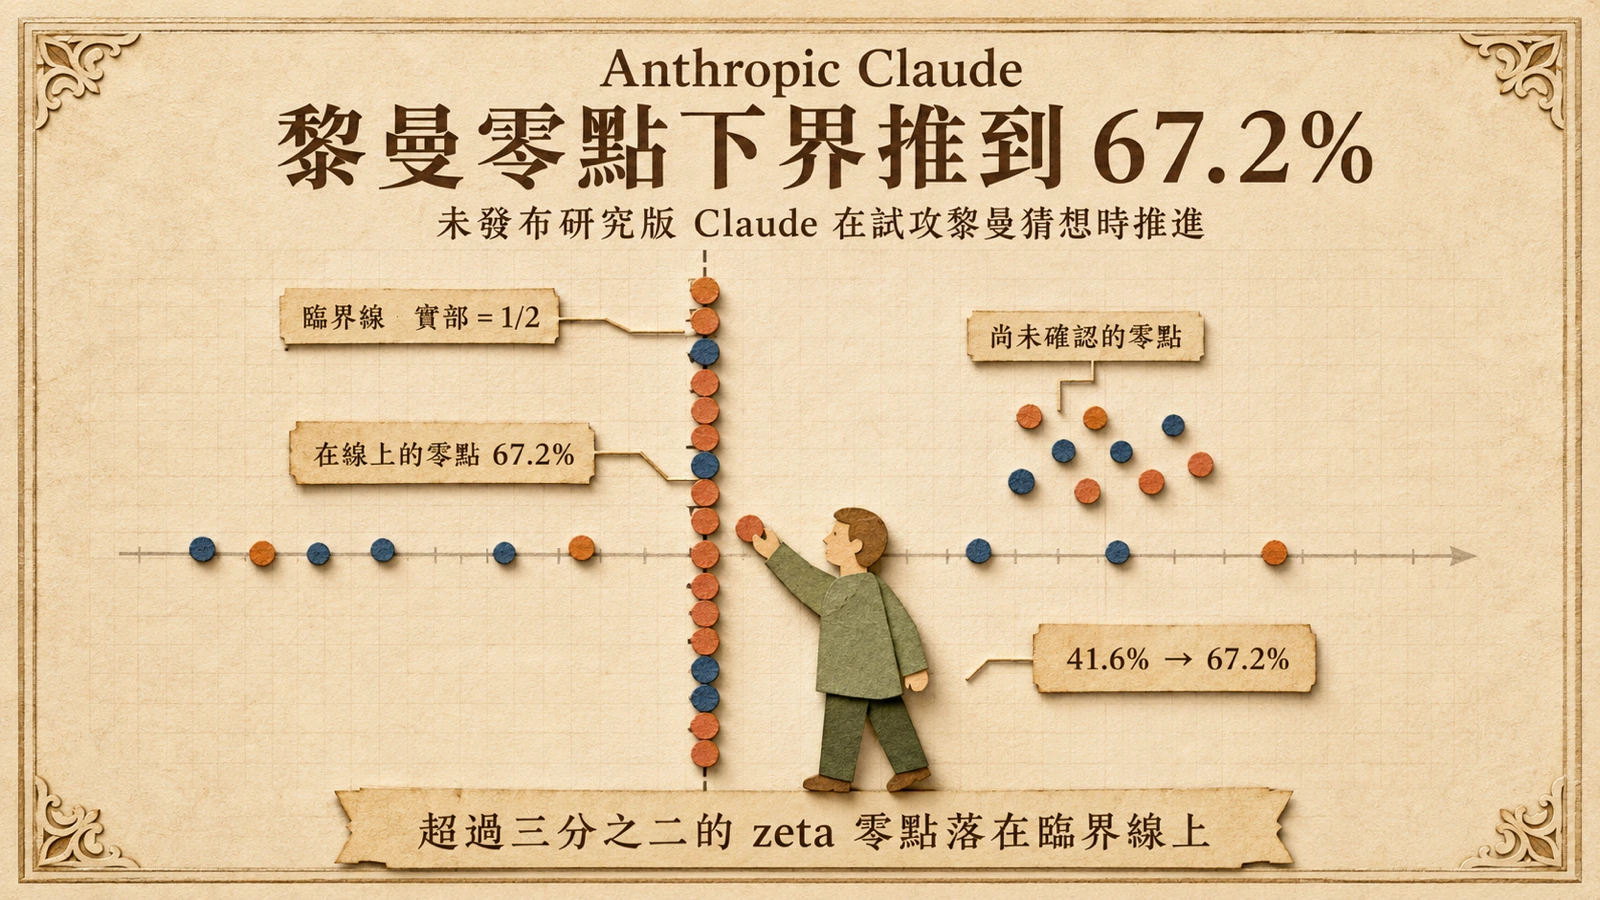
Anthropic 在研究公告裡描述了一場「不合理的挑戰」:一名並非數學家的員工 Jarred Sumner,要一個未發布的研究版 Claude「認真試攻黎曼猜想」。黎曼猜想自 1859 年提出至今未解,是克雷數學研究所的千禧年大獎難題之一。Claude 並沒有證出黎曼猜想,但在過程中把一個相關的下界,從 41.6% 推進到 67.2%——也就是「黎曼 zeta 函數的非平凡零點中,有多少比例落在臨界線上」這道長期問題的已知最佳下界。
這個結果的論文標題本身就把結論講明白:《More than two thirds of the zeros of the Riemann zeta function lie on the critical line》。它是在兩次 Claude Code 工作階段中找到的,總共用了 3,100 萬個 output tokens。第一輪 Claude 嘗試了 650 個想法,全部行不通;Jarred 要它再試一次,於是它花了一天半協調大約 60 個 subagents,總計執行 2,400 次指令、寫了數百個 Python 腳本,並下載 54 篇 arXiv 論文,確認自己的結果沒有人已經做過。Jarred 的介入大多只是反覆傳話鼓勵,要它「繼續下去」「相信自己」。
黎曼猜想與「臨界線上的零點比例」在問什麼
黎曼 zeta 函數與質數的分布密切相關:函數取值為零的每個位置,都為質數序列添上一層更細的結構。1859 年的黎曼猜想主張,決定質數行為的那些「非平凡零點」,全部落在一條垂直的臨界線上,也就是實部等於 1/2 的那一條。
至今沒有人能證明或推翻它,但數學家從兩個方向累積進展。其一是數值檢查,目前已驗證最先的數十兆個零點都落在線上,可是這只能涵蓋有限範圍。其二是理論下界:證明「至少有某個比例的非平凡零點落在臨界線上」,而且這個比例對任何高度的零點都成立。這次被推進的,正是第二條路線上的那個比例下界。
從 41.6% 到 67.2%:停滯十餘年的下界被推進
這個下界是一段超過半世紀的推進史。1914 年 Hardy 首先證明臨界線上有無限多個零點;1942 年 Selberg 把它推進到「某個正比例」;1974 年 Levinson 給出第一個明確的大常數,超過三分之一(約 34.74%);1989 年 Conrey 推到超過五分之二(約 40.88%);2011 年 Bui、Conrey 與 Young 再推到超過 41%。其後十餘年,這個數字只在邊際上緩慢推移,來到大約 41.6%。
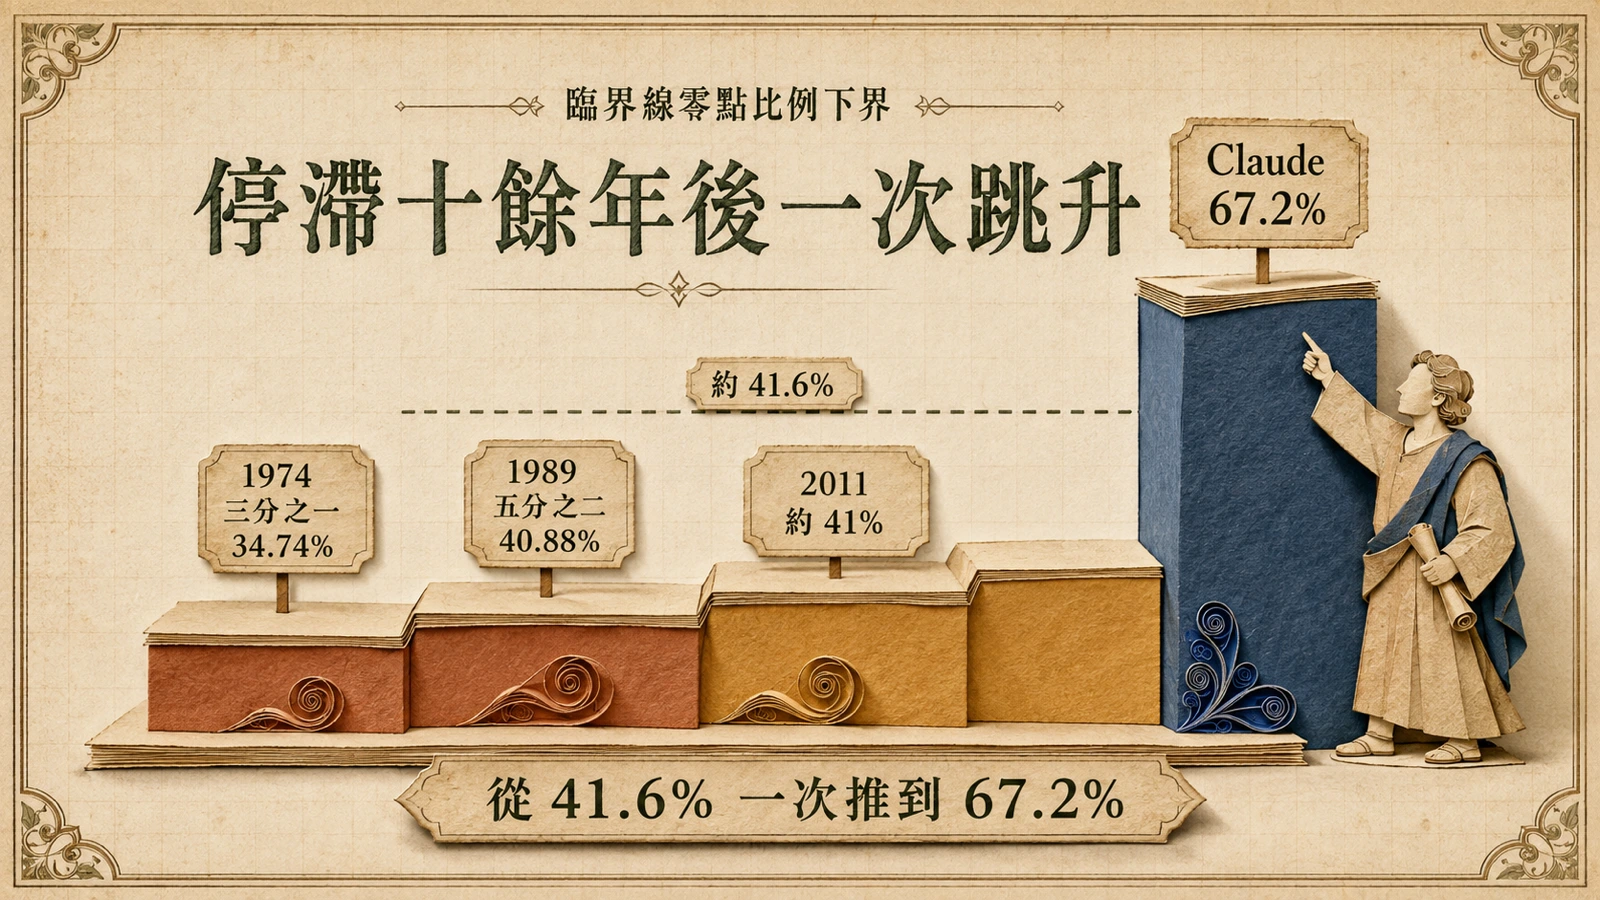
然後 Claude 一次把它推到 67.2%。在最佳化的測試族下,論文給出的常數是 0.6725;換句話說,非平凡零點當中、落在臨界線上的比例,被證明至少有這麼多。相較於過去十餘年只在 41% 附近盤桓,這是 25 個百分點以上的跳升。
Claude 的做法:用線性代數取代對黎曼猜想的依賴
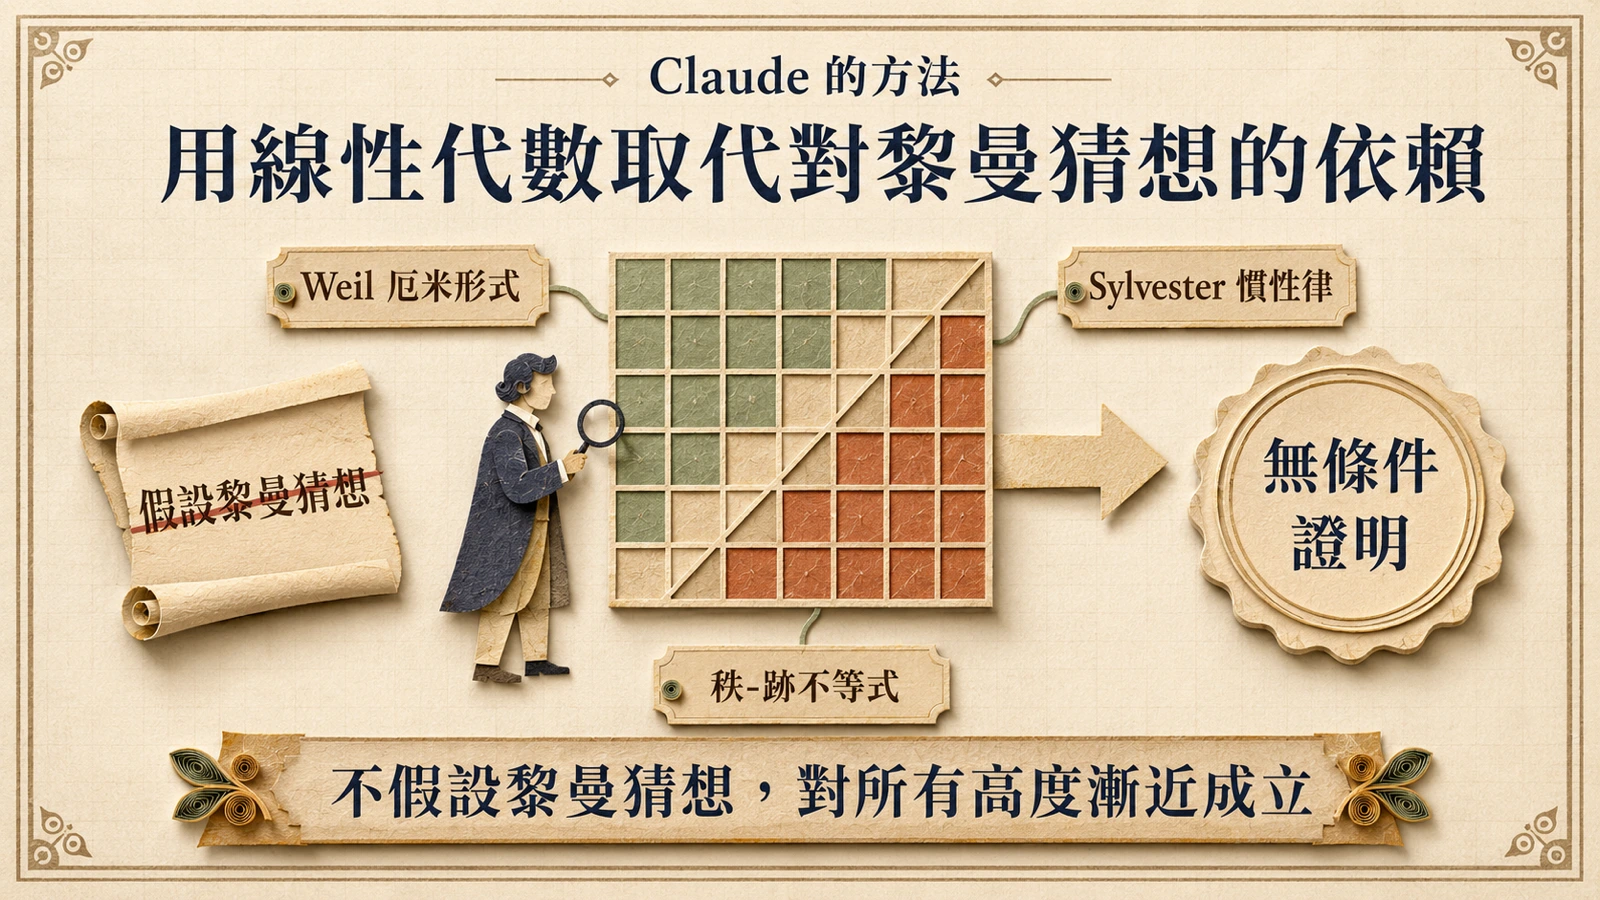
這個結果之所以成立,關鍵在於 Claude 換掉了一個過去非得依賴黎曼猜想的步驟。Claude 的論文在技術層面上是這樣說的:傳統上要把「零點那一側」讀成對實數縱座標的正值求和,必須先假設黎曼猜想;Claude 改用線性代數,去處理 Weil 厄米形式的一個有限壓縮——透過 Sylvester 慣性律,加上一個用 von Neumann 跡不等式證出的厄米矩陣秩-跡不等式,來取代那一步。
用白話講:它把整個函數空間一起看,同時考慮「在線上」與「不在線上」兩類零點所貢獻的正定與負定部分,並允許那個二次形式不必是對角的,再寫下一個關於秩的不等式。Anthropic 的描述也點出,「敢於把整個空間一起處理」正是讓它能跨過前人門檻的那一步。值得強調的是,整個證明是無條件的,不假設黎曼猜想,而且對所有高度的零點漸近成立。
驗證鏈:內部數學家、外部專家與 Lean 形式化
一個AI 自己產出的數學證明,可信度取決於驗證。這次有兩層人審:Anthropic 自己的兩位數學家 Levent Alpöge 與 Ralph Furman 讀過並理解了這個結果,寫成一份給專家的精簡筆記;外部兩位這個領域的專家 Brian Conrey 與 Dan Goldston 也在短時間內審視了論文。Brian Conrey 正是 1989 年把下界推到「超過五分之二」的那位學者。
更硬的保證來自形式化。Claude 與另一名員工 Eric Easley 合作,把結果寫成 Lean 4 證明,發布在 anthropics/zeta-23-lean 倉庫,並能通過 leanprover/comparator 這個獨立的可信驗證工具——它會檢查證明確實證明了指定的敘述、只用了允許的公理,並被 Lean 核心接受。換句話說,這不是「AI 自稱證對了」,而是一份可被機器獨立檢驗的證明。不過 Ralph Furman 本人在 Hacker News 上的補充說明也把話說清楚:他與 Alpöge 的角色比較像「高度關切的審查者」,會為這份結果負起數學責任,並承諾會把論文潤飾到可以正式發表。
不是證明黎曼猜想,也不代表 AI 已能通用做數學
有幾個界限必須畫清楚。第一,這不是黎曼猜想的證明;Anthropic 自己也明說,不預期 Claude 用的這套技術會導向黎曼猜想的證明。第二,即使這個比例下界有朝一日推到 100%,它仍然嚴格弱於黎曼猜想——因為它是漸近結果,只保證「違反猜想的零點比例隨高度趨近於零」,並不排除存在少數偏離的零點。
第三,這是一個特定問題上的、由特定規模的多智能體過程催生的單點突破,不代表 Claude 或任何模型已經能穩定地從事開放式的數學研究。Anthropic 把它定位為「AI 模型數學能力進展速度」的又一個訊號——連 Claude 自己一開始都對能否有意義地推進這個問題抱持懷疑,是在反覆的鼓勵提示下才走到這個結果。但一個停滯十餘年的解析數論下界,被一個未發布的模型在兩個工作階段裡推進 25 個百分點以上,這個訊號本身已經夠清楚。