一個模型四個環境:Qwen-UI-Agent 是什麼
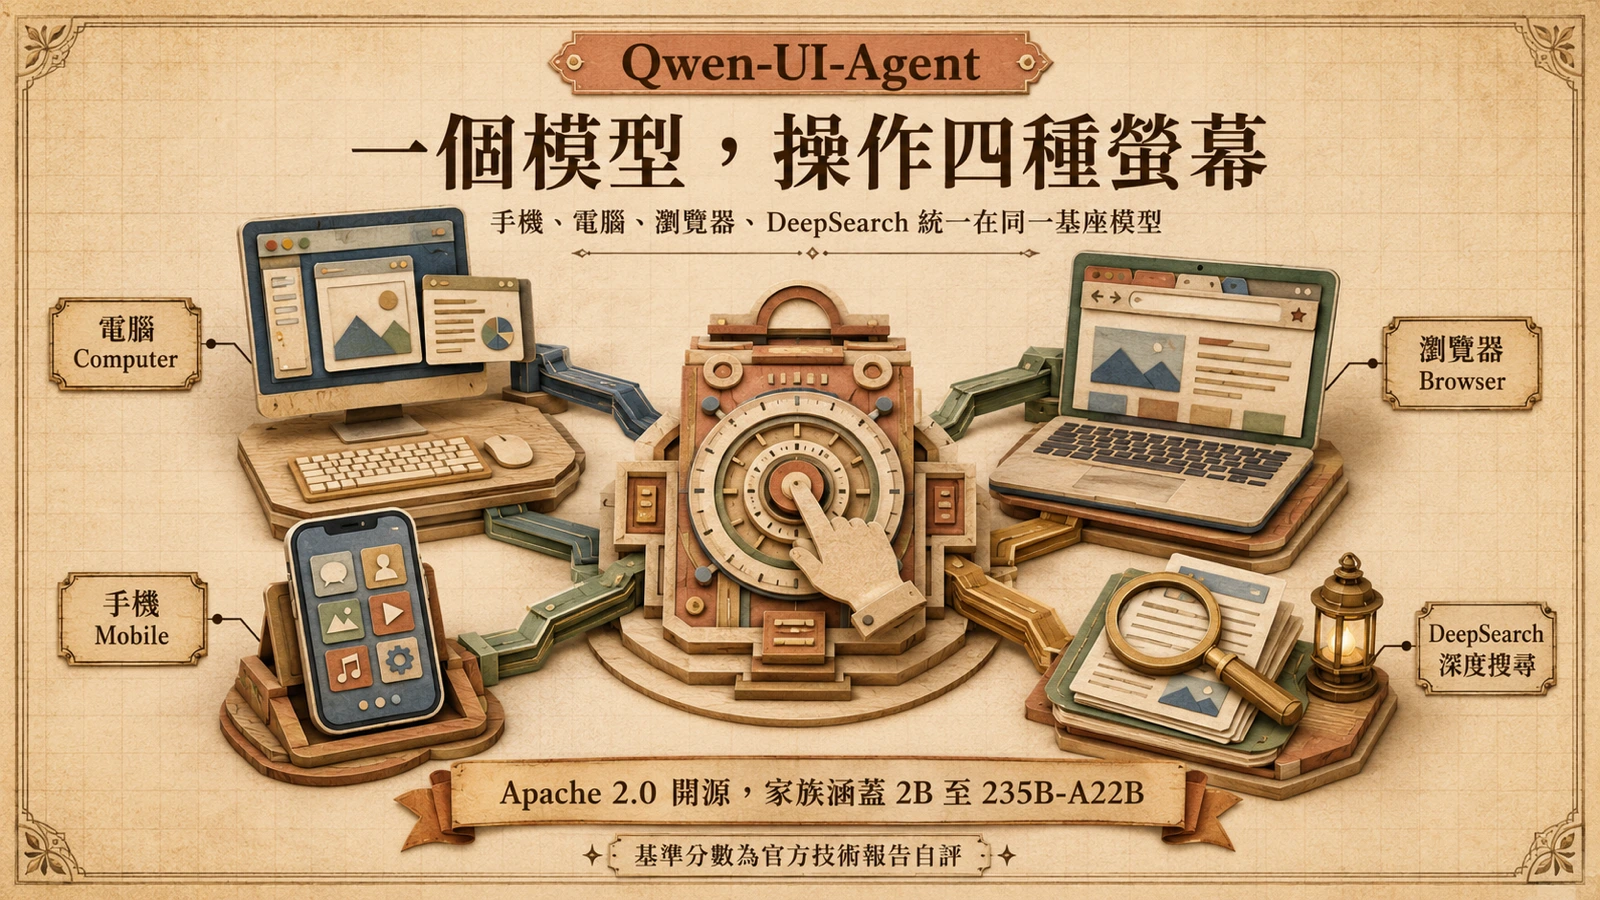
阿里巴巴通義 MAI 團隊把 GUI 代理這條產品線推到了新的一站。團隊在 GitHub 上的儲存庫如今以 Qwen-UI-Agent 為主角,開宗明義說明它是「由阿里巴巴開發、以 Apache License(Version 2.0)授權的基座 GUI 代理」。配套的技術報告(arXiv 編號 2607.28227,2026 年 7 月上線)則把它定義為「橫跨 mobile、computer-use、web 與 DeepSearch 環境、以真實世界為中心的基座 GUI 代理」。
換句話說,這不是又一個只會在網頁裡點按鈕的代理,而是想讓同一個模型真正「會用」每一塊螢幕:手機 App 的觸控介面、桌上型電腦的視窗與選單、瀏覽器的分頁與表單,以及 DeepSearch 這種需要多輪檢索、交叉比對的研究型任務,全部收進同一個基座模型的管轄範圍。開源釋出也代表權重與程式碼都拿得到:Apache 2.0 允許商用改作,對想自己架代理的團隊是一條現成的路。
「真實世界為中心」在講什麼:GUI 代理的運作原理
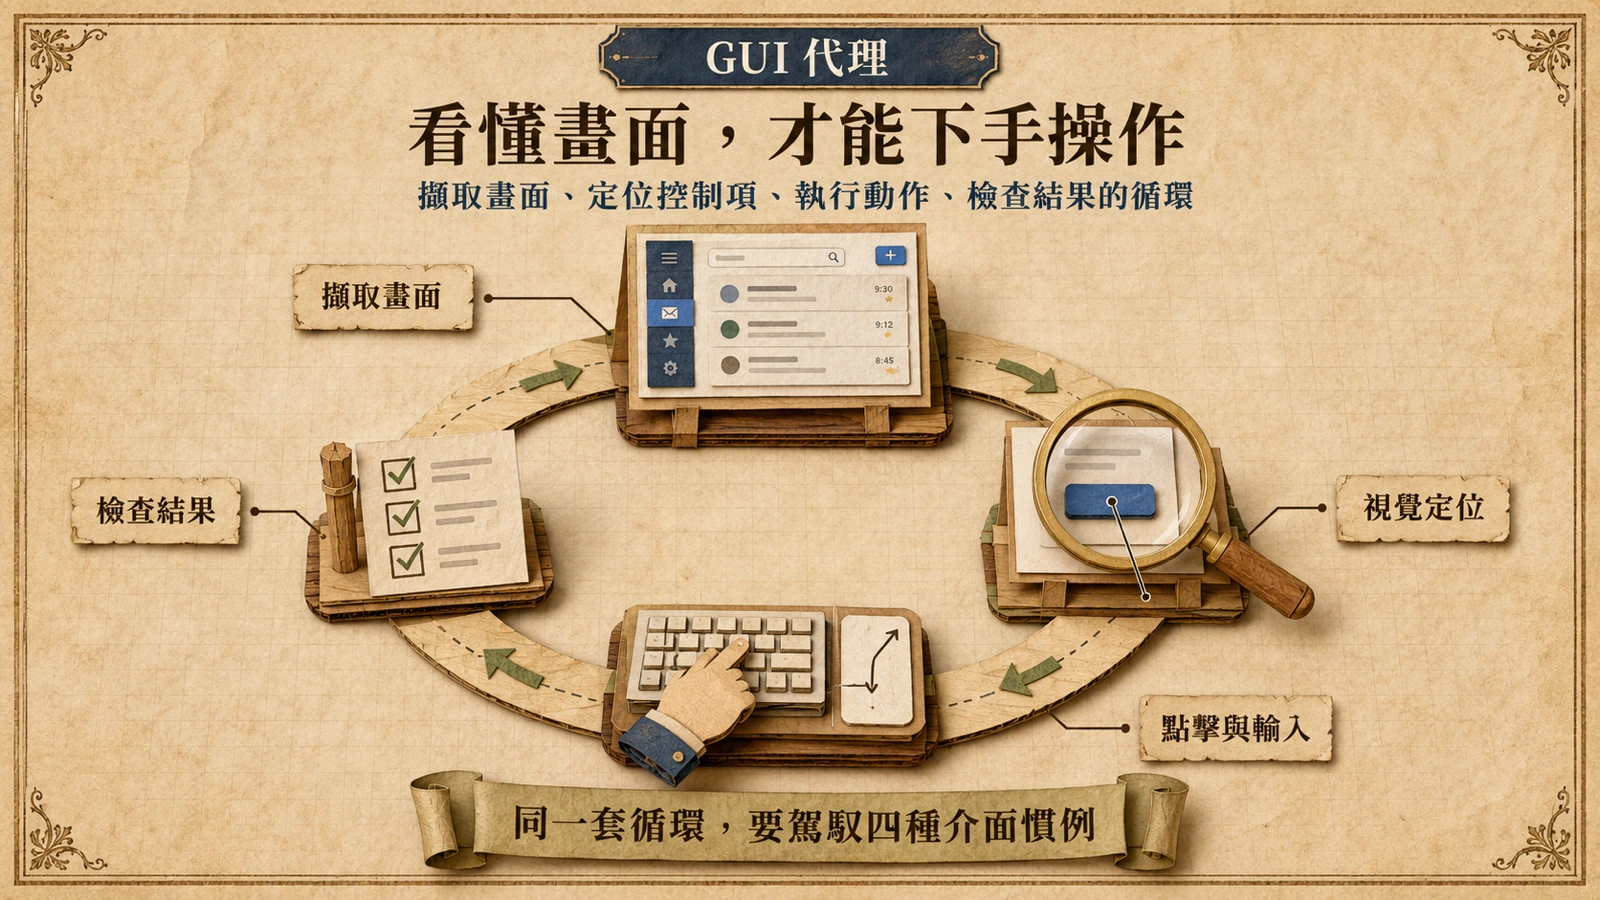
要理解 Qwen-UI-Agent 的企圖,得先弄清楚 GUI 代理與一般代理的差別。一般代理呼叫的是 API:工具回傳結構化的 JSON,模型在文字世界裡規劃下一步。GUI 代理面對的則是人類眼睛看到的畫面——它拿到的是螢幕截圖,必須先用視覺能力定位「訂閱按鈕在哪裡」「輸入框是哪一格」,再發出點擊、滑動、輸入文字等動作,接著觀察畫面怎麼變化,決定下一步。這個「擷取畫面、定位控制項、執行動作、檢查結果」的循環,就是 GUI 代理的基本心跳。
難的地方在於環境慣例各不相同:手機 App 靠觸控手勢與底部導覽,桌面軟體靠選單列與快捷鍵,網頁有捲動、彈窗與動態載入,DeepSearch 則是長鏈的檢索、閱讀與整理。過去常見的做法是為每種環境各訓練一個專用模型,結果是代理一換環境就得「換腦袋」,跨裝置的連續任務接不起來。Qwen-UI-Agent 選的路線是把四種環境統一放進同一個模型的訓練範圍;技術報告標題裡的「真實世界為中心」(real-world centric),指的正是以真實環境裡的真實任務、而非沙盒中的簡化版本,作為訓練與評測的基準。
從 MAI-UI 到 Qwen-UI-Agent:同一條研究線的兩份報告
翻開儲存庫與模型卡,會先撞上一個容易混淆的細節:GitHub 的 repo 名稱叫 MAI-UI,Hugging Face 上的模型也叫 MAI-UI,對外的技術報告與品牌卻是 Qwen-UI-Agent。兩者其實是同一條研究線的先後章節:2025 年 12 月,團隊發布 MAI-UI 技術報告(arXiv 編號 2512.22047),主題就是「真實世界為中心的基座 GUI 代理」;2026 年 7 月的 Qwen-UI-Agent 報告標題進一步掛上「下一代」(Toward Next-Generation),願景一脈相承,範圍則收攏為四大環境的統一。
模型家族的尺寸光譜在 Hugging Face 的模型卡上寫得明白:這是「涵蓋 2B、8B、32B 與 235B-A22B 全尺寸光譜的基座 GUI 代理家族」。從 20 億參數的密集模型,到兩千多億參數的混合專家架構,四個檔位對應的是不同的部署位置,而不是四種不同的能力定位。
基準成績:尺寸放大,AndroidWorld 分數跳升
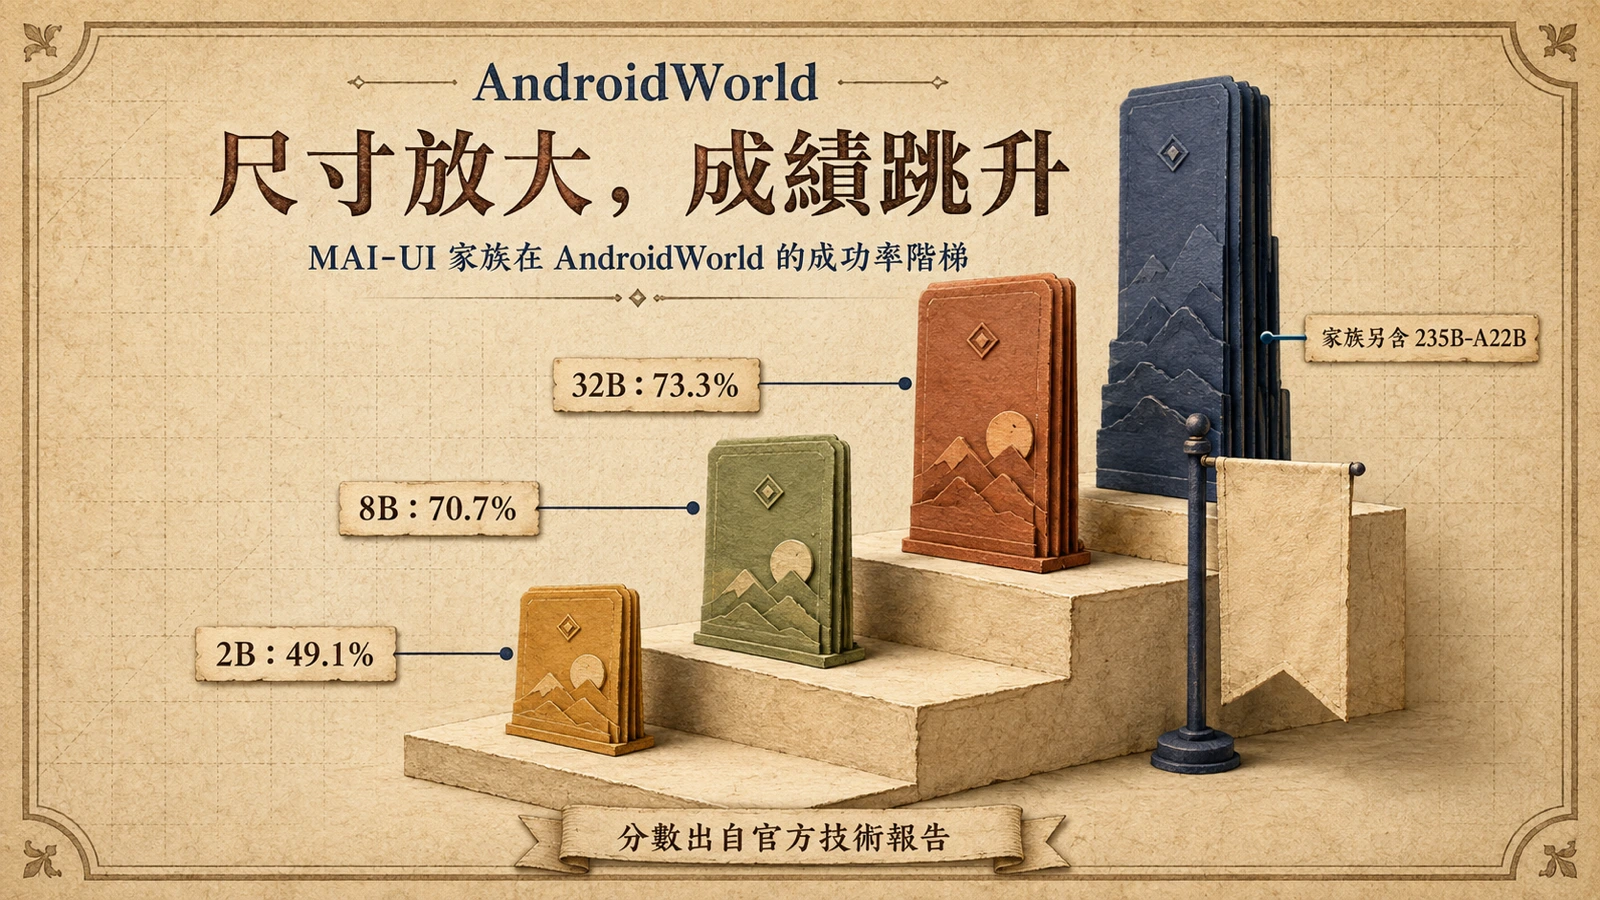
具體數字看家族的技術報告。在行動裝置操作基準 AndroidWorld 上,「MAI-UI-32B、MAI-UI-8B 與 MAI-UI-2B 分別達到 73.3%、70.7% 與 49.1% 的成功率」。這組數字透露兩件事:其一,尺寸效應非常明顯,2B 到 8B 之間一口氣跳了超過 21 個百分點,8B 到 32B 再小幅爬升;其二,要把 GUI 代理做到接近實用,模型容量仍是硬門檻,最小尺寸離可用還有一段距離。
「看懂畫面」的 grounding 基準方面,論文頁記錄家族最強成員「在 ScreenSpot-Pro 達 73.5%、MMBench GUI L2 達 91.3%、OSWorld-G 達 70.9%」。grounding 測的是給定目標後,模型能否正確指出畫面上的對應位置——它是 GUI 代理的基本功而非終點,但高分至少說明視覺定位這一環沒有拖後腿。
把鏡頭拉遠,這條賽道整體正在快速推進:我們先前報導過,電腦操作智能體在 OSWorld-Verified 的最佳成績一年內從 42% 衝上 85%,首度超過人類測試者的平均水準。Qwen-UI-Agent 的位置,就是在這波競賽裡為「開放權重」這一側補上籌碼。
開放權重的部署邏輯與開發者下一步
四個尺寸對應四種部署場景:2B 可以塞進手機或邊緣裝置做端側代理,8B 與 32B 適合單機與企業內部伺服器,235B-A22B 這個混合專家架構則是雲端服務的旗艦檔位。Apache 2.0 讓商用改作不需要另外談授權,對想把代理部署在自家機房、要求資料不出門的企業特別有吸引力——這正是閉源雲端 API 最難滿足的需求。
對開發者,起步路徑已經攤開:從 Hugging Face 拉模型權重、從 GitHub 儲存庫取得環境與評測程式碼,再接到自己的測試環境驗證成功率,最後按硬體預算選尺寸。阿里在開源生態的佈局也有脈絡可循,從把多模態能力接進代理框架的 MM-Plugins,到這次的 GUI 代理家族,Qwen 體系持續把「代理」往開放權重端推。
開源 GUI 代理在產業賽道上的位置
GUI 代理被視為通往通用數位勞動力的關鍵一哩路,理由很實際:多數既有軟體沒有開放 API,人類的操作介面就是最通用的介面,能操作 GUI 的代理等於能使用幾乎所有現存軟體。目前這個市場由雲端閉源模型領跑,開放權重陣營要追上,需要的正是 Qwen-UI-Agent 這種組合:完整的尺寸梯度讓不同預算的團隊都能進場,開源授權讓試點可以無痛轉成正式部署,大型旗艦檔位則證明能力上限不缺席。
對自動化測試、跨 App 工作流、內部系統操作這類需要「像人一樣用軟體」的場景,開放權重 GUI 代理給了一個可控的選項:模型在自己手上,操作的每一步可以留下紀錄,出錯時可以回放定位。這些是採購決策裡比單一分數更實際的考量。
分數之外:自評、線上落差與安全風險
讀這份成績單要留意三件事。第一,所有基準分數都出自團隊自家的技術報告與模型卡,比較對象與評測設定由發布方決定,尚無獨立第三方的複核。第二,離線基準與線上真實任務之間向來存在落差:真實 App 會改版、彈窗會亂入、任務鏈一拉長成功率就往下掉,AndroidWorld 的高分不能直接換算成生產環境的可靠度。第三,也是 GUI 代理特有的風險:能操作螢幕,就代表能接觸螢幕上看得到的資料。把代理接上真實帳號之前,權限控管、操作審計與誤動作的停損機制,都是部署方要自己補齊的功課。
值得追蹤的後續指標也很清楚:獨立評測會不會把這個家族納入排行、雲端服務商會不會直接上架旗艦檔位、以及開源社群在真實裝置上跑出的長任務成功率。Qwen-UI-Agent 把「四環境統一」的願景變成了可下載的權重;至於單一模型能不能真的駕馭每一塊螢幕,要由部署之後的實績來回答。