一份用下載數據說話的半年度觀察
Hugging Face 於 8 月 14 日在官方部落格發布《State of Open Models: Summer 2026 Observations》,以 2026 年前七個月 Hub 上的實際活動為本,整理出開源模型生態的一系列觀察。報告的原文 Markdown 同步公開在 huggingface/blog 官方儲存庫,每個主張都可以逐字回查。
與多數仰賴訪談或問卷的產業趨勢文章不同,這份報告的底層是平台數據:模型下載、按讚、衍生模型,以及 GGUF 這類本地推論格式的實際流量。Hugging Face 春季發布的前一份生態報告就曾點出 Hub 的長尾特性——約一半的模型總下載次數不到 200 次,少數頭部模型吃掉絕大多數流量。夏季這份續作把問題轉向更實用的方向:哪些模型真正被用,而不只是被討論。
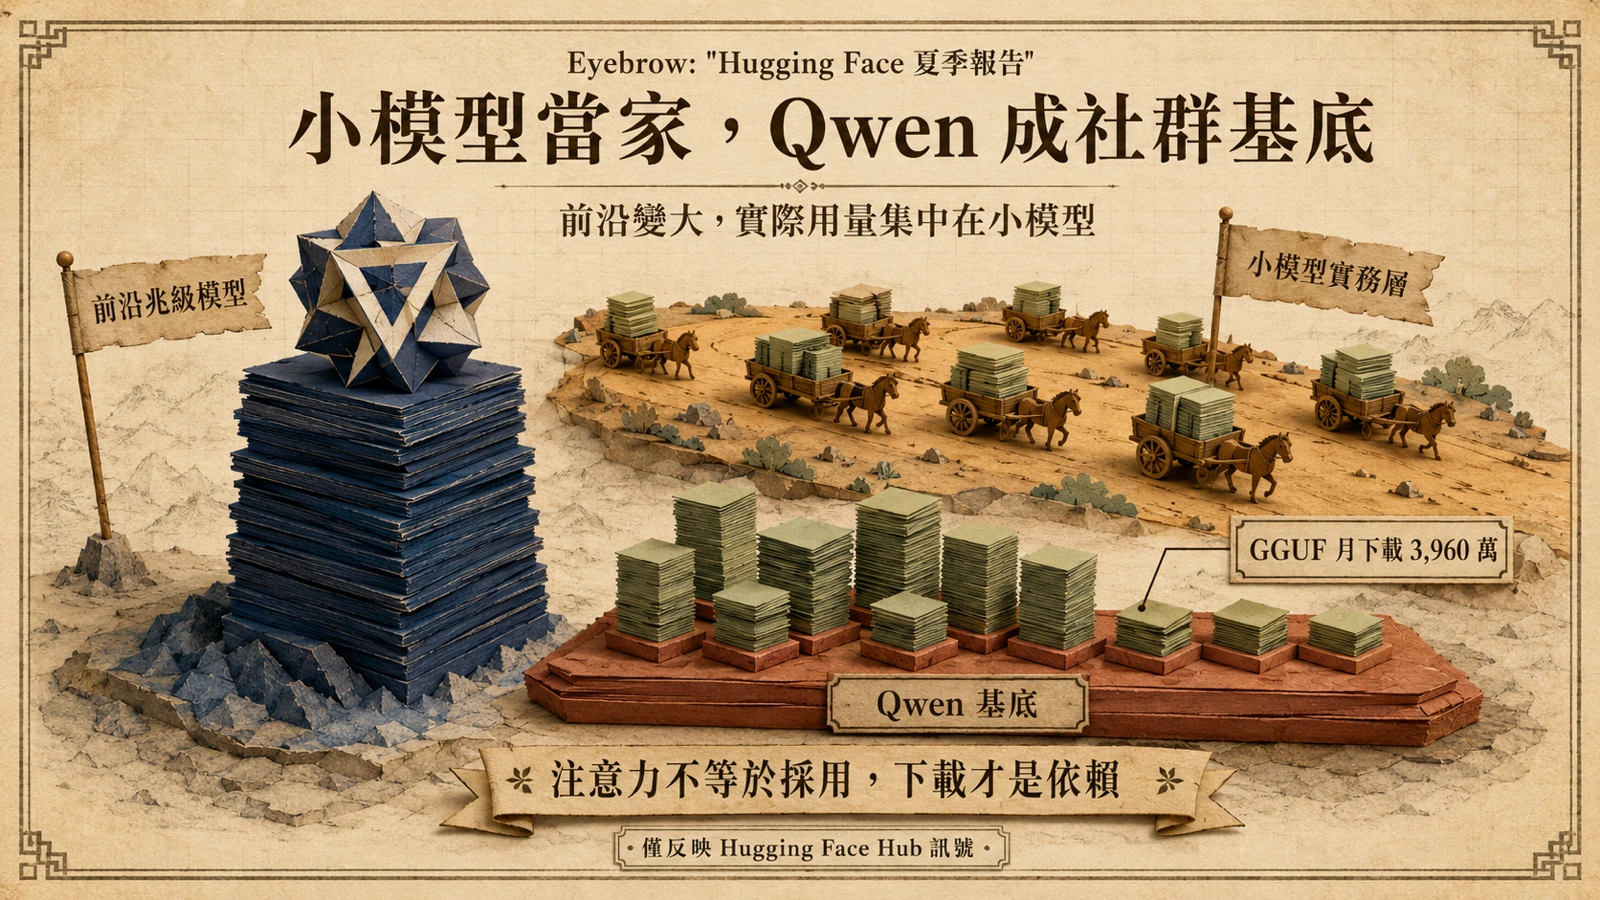
前沿愈來愈大,實務用量仍在小模型
報告開宗明義的觀察可以濃縮成一句話:前沿模型愈來愈大,但小模型仍主導實際使用。今年開放權重圈的頭條確實由超大模型佔據——小米與美團都交出了破兆參數的開放權重模型,規模競賽沒有降溫。但報告同時把「小模型仍是實務層」(Small models remain the practical layer)列為獨立觀察,明確指出真正被反覆拉取、部署的流量集中在小模型。
這個落差有清楚的成本結構原因。兆級模型即使免費開放權重,能夠載入與微調的組織仍然有限;相對地,小模型可以在消費級顯示卡、邊緣裝置與成本敏感的批次任務上直接落地,延遲與單位成本低一個數量級,例如 7.9B 的Ling-3.0-tiny。再疊加蒸餾與任務式微調的成熟,小模型在具體場景的表現往往「夠用」,讓規格表上的前沿差距與實務選擇脫鉤。對選型者而言,這等於提醒:看榜單選模型之前,先看自己的部署預算落在哪一層,見〈V4-Pro 上架矽基流動〉。
注意力不等於採用
報告第二項觀察的標題是「Attention ≠ Adoption」:注意力不等於採用。在 Hub 的指標設計裡,按讚衡量的是社群對一次發布的興奮程度,下載衡量的是開發者把模型放進工作流程的依賴。兩種訊號指向的榜單明顯錯位——按讚榜上的新星,與下載榜上的常勝軍,多半不是同一批模型。
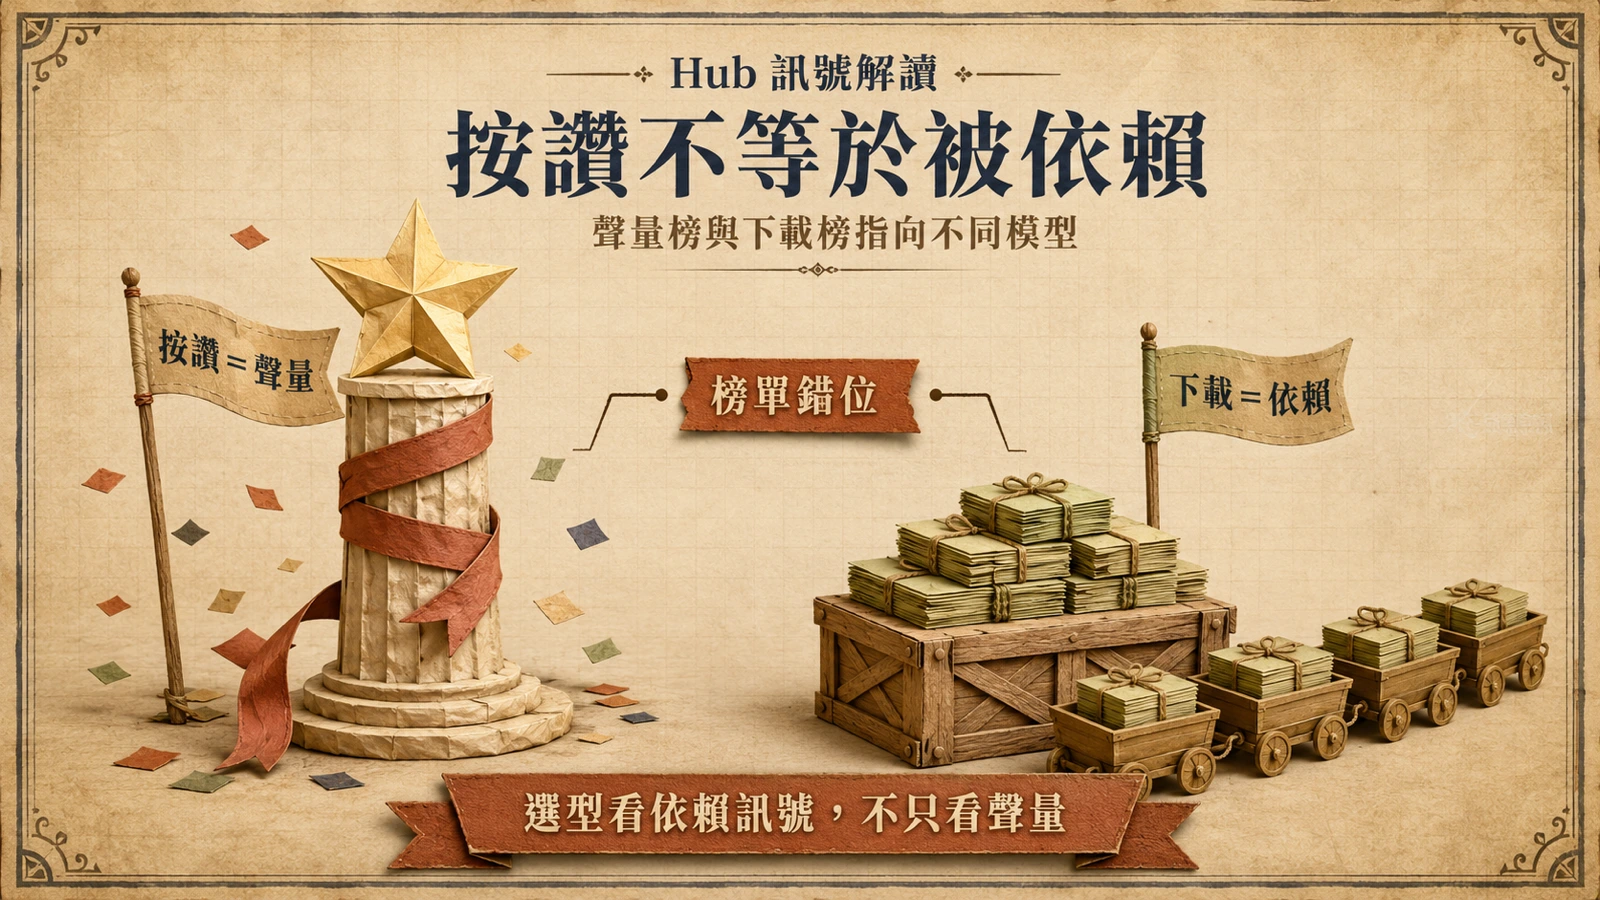
錯位的成因不神祕。新發布的大型模型自帶話題性,容易累積按讚與討論;但要把模型放進生產流程,團隊在意的是尺寸、授權條款、量化版本是否齊全、社群工具鏈是否成熟——這些條件往往由已在場上營運多時的模型家族滿足。於是「被談論的」與「被依賴的」自然分道揚鑣。這對採購與技術選型的啟示很直接:按讚數可以當作雷達,但依賴訊號(下載趨勢、衍生模型活躍度)才更接近風險評估的依據。
Qwen 成為社群的基礎模型
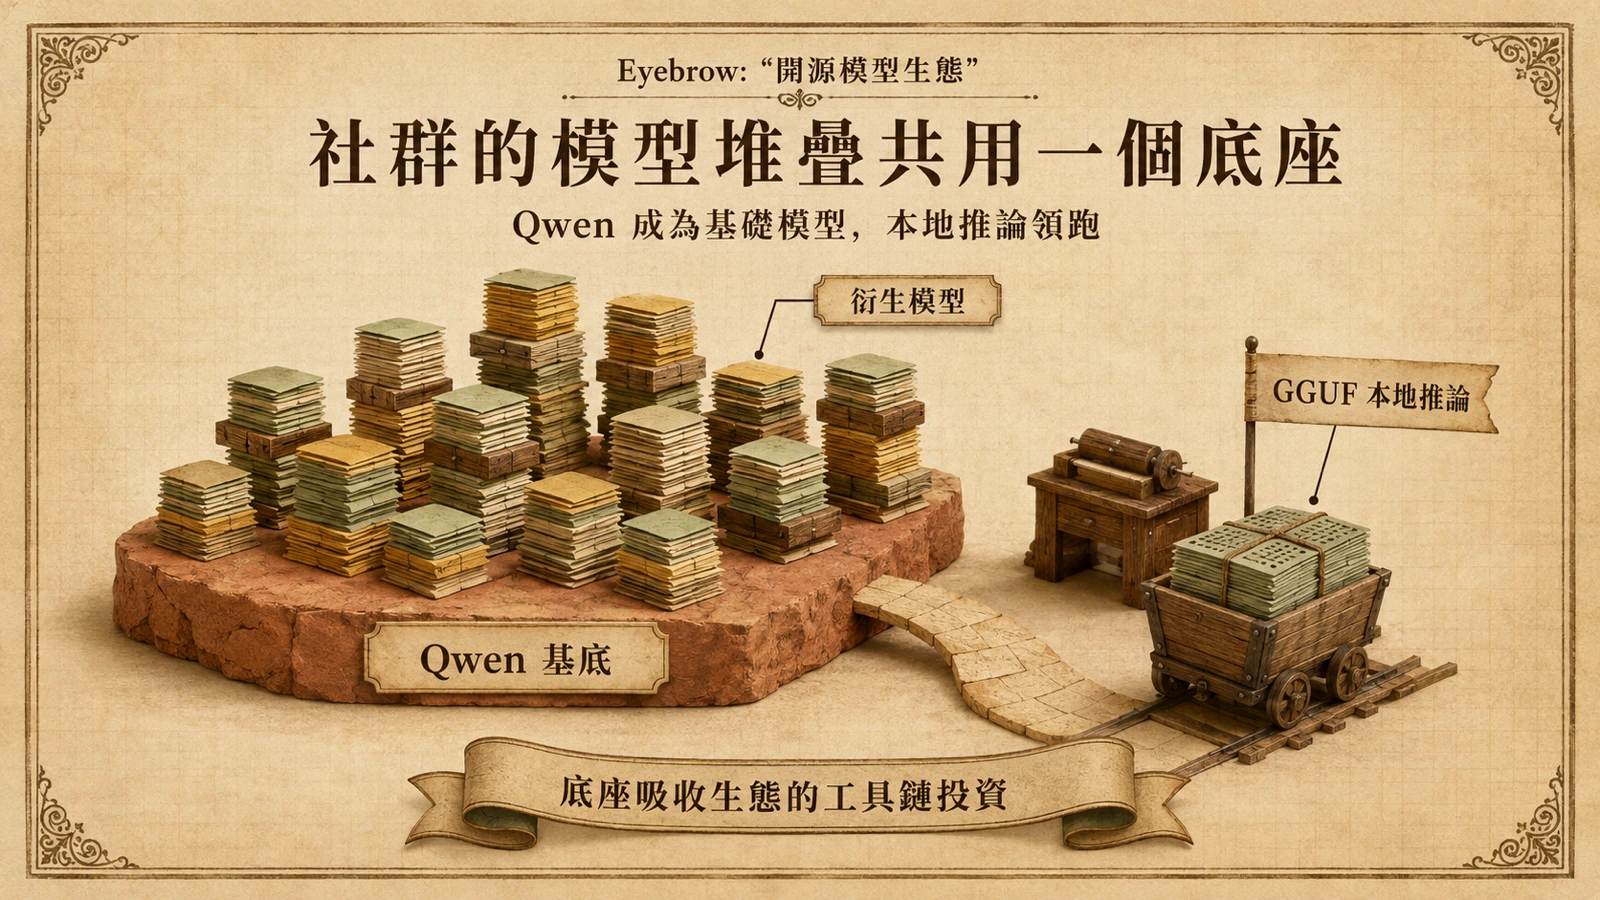
第四項觀察給出了這份報告最明確的單一結論:Qwen 已成為社群的基礎模型。所謂基礎模型,指的不是能力最強,而是最多人拿來當底座——微調、蒸餾、蒸出衍生模型的路徑都以它為起點,工具鏈與量化版本自然也最齊全。
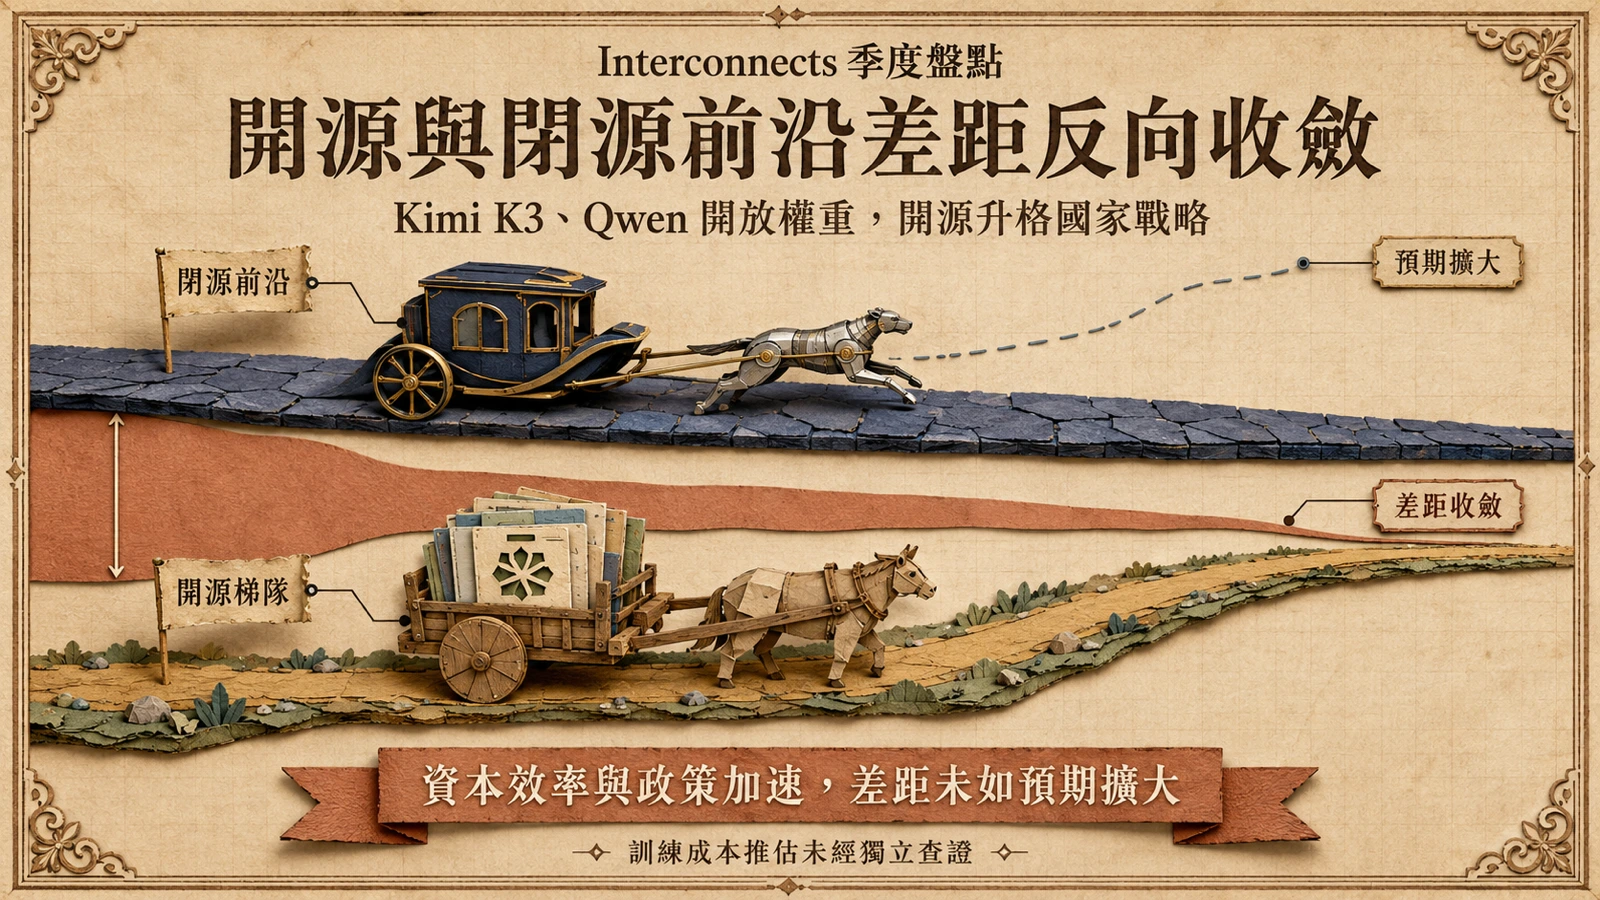
本地推論的數字最具體:報告寫明這條路線跑在 Qwen 上,每月 3,960 萬次 GGUF 下載。GGUF 是 llama.cpp 生態的模型格式,讓量化後的模型能在消費級硬體上推理;一份格式流量能大到以千萬計,反映的是本地部署已經不是極客嗜好,而是常規的使用路線。這與 Qwen 持續開放權重的策略互相強化——先前 Interconnects 的季度盤點就觀察到 Qwen 預告下一代大型模型將採開放權重,把開源當成生態戰略而非單次行銷,服務端可對照〈千問開放平台〉。
開放權重改變價值累積的位置
第三項觀察「開放權重改變價值累積的位置」把視角從單一模型拉高到產業結構。當頂級模型的權重可以免費取得,單純「提供模型存取」的價值被壓縮,價值往周邊層移動:推論引擎與量化工具、微調與蒸餾的下游應用、部署與維運的工程服務,以及圍繞熱門底座形成的資料與評測生態。
這解釋了為什麼 Qwen 成為基礎模型是一件有分量的結論:底座模型吸收生態的注意力與工程投資,後進者即使發布規格相近的模型,也要面對工具鏈與衍生模型數量的劣勢。開放權重的政治經濟學也隨之升溫,微軟今年對開放權重與美國 AI 領導地位的表態,就是同一條結構線上的政策訊號。價值正在重新分配,而且是在模型本身免費的前提下分配。
兆級參數不再是巨頭專利
報告原文點出一個十二個月前很難預期的景象:小米與美團今年都突破了一兆參數,而兩者在開放權重圈原先都不是知名角色。這句話的資訊量不在「兆級」本身,而在供給者的名單:開放權重的前沿供給已經從少數 AI 實驗室,擴散到消費電子與本地生活服務的大型科技公司,見〈小紅書開源 dots3-note〉。
供給多元化的直接效果,是讓「開放權重等於次一級能力」的假設愈來愈難成立。當破兆模型來自不同產業背景的公司,競爭軸線也從單純的規模,轉向授權條款、量化支援與生態維護的長期承諾。對使用者來說,這是談判籌碼的增加;對既有底座來說,則是護城河必須建立在生態而非參數量上的直接壓力。
對開發者與企業的實際意義
把四項觀察轉成可執行的判斷,大致是三條。第一,選型時把下載趨勢與衍生模型活躍度當成一級訊號,按讚數只當參考——依賴訊號比聲量訊號更接近長期維護的機率。第二,部署規劃先分層:兆級前沿模型與小模型的成本結構差異極大,大多數場景的效益最佳解仍在小模型層,本地推論路線(GGUF 加 llama.cpp 生態)值得納入成本模型。第三,若團隊要在開源底座上做微調或蒸餾,Qwen 生態的工具鏈完整度與衍生模型數量目前是報告數據支持的最穩選擇。
對供應商與平台方,訊號同樣明確:模型存取本身不再是價值所在,能在選型、量化、部署與維運哪一層提供可回查的工程價值,才決定位置。
數據的限制與後續值得追蹤的指標
這份報告的證據基礎是 Hub 指標,限制也來自 Hub 指標。它不涵蓋只發布在 GitHub 或官網的模型、企業內部鏡像的流量,也不包含 API 端點的實際用量;按讚與下載都是平台訊號,不能直接換算成營收或生產部署份額。報告定位是半年度的生態觀察,而非市占率調查,引用數字時適合講方向,不適合講精確份額。
後續值得追蹤的指標有三個:GGUF 月下載量的集中度變化,可以看出本地推論路線是否繼續向單一家族集中;衍生模型的淨增速度,檢驗 Qwen 底座優勢是在擴大還是被新底座稀釋;以及下一份冬季報告是否維持「小模型主導實務用量」的結論——若前沿模型隨量化技術進一步下放到消費級硬體,這條分界可能開始移動。