兩週承諾到期,權重在安全加固後開放
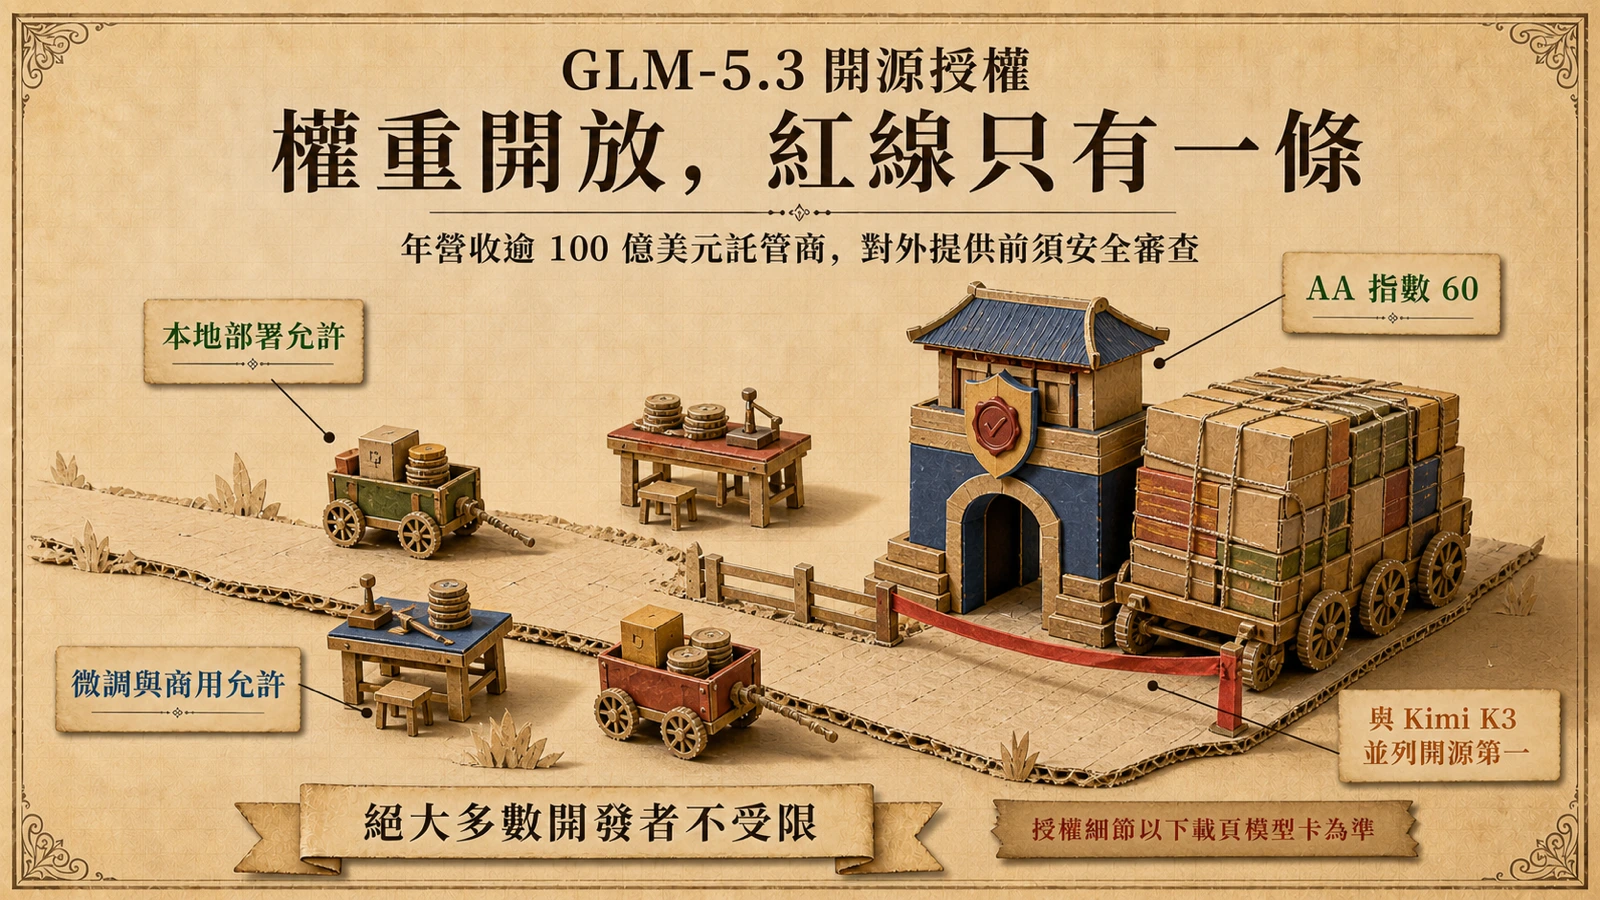
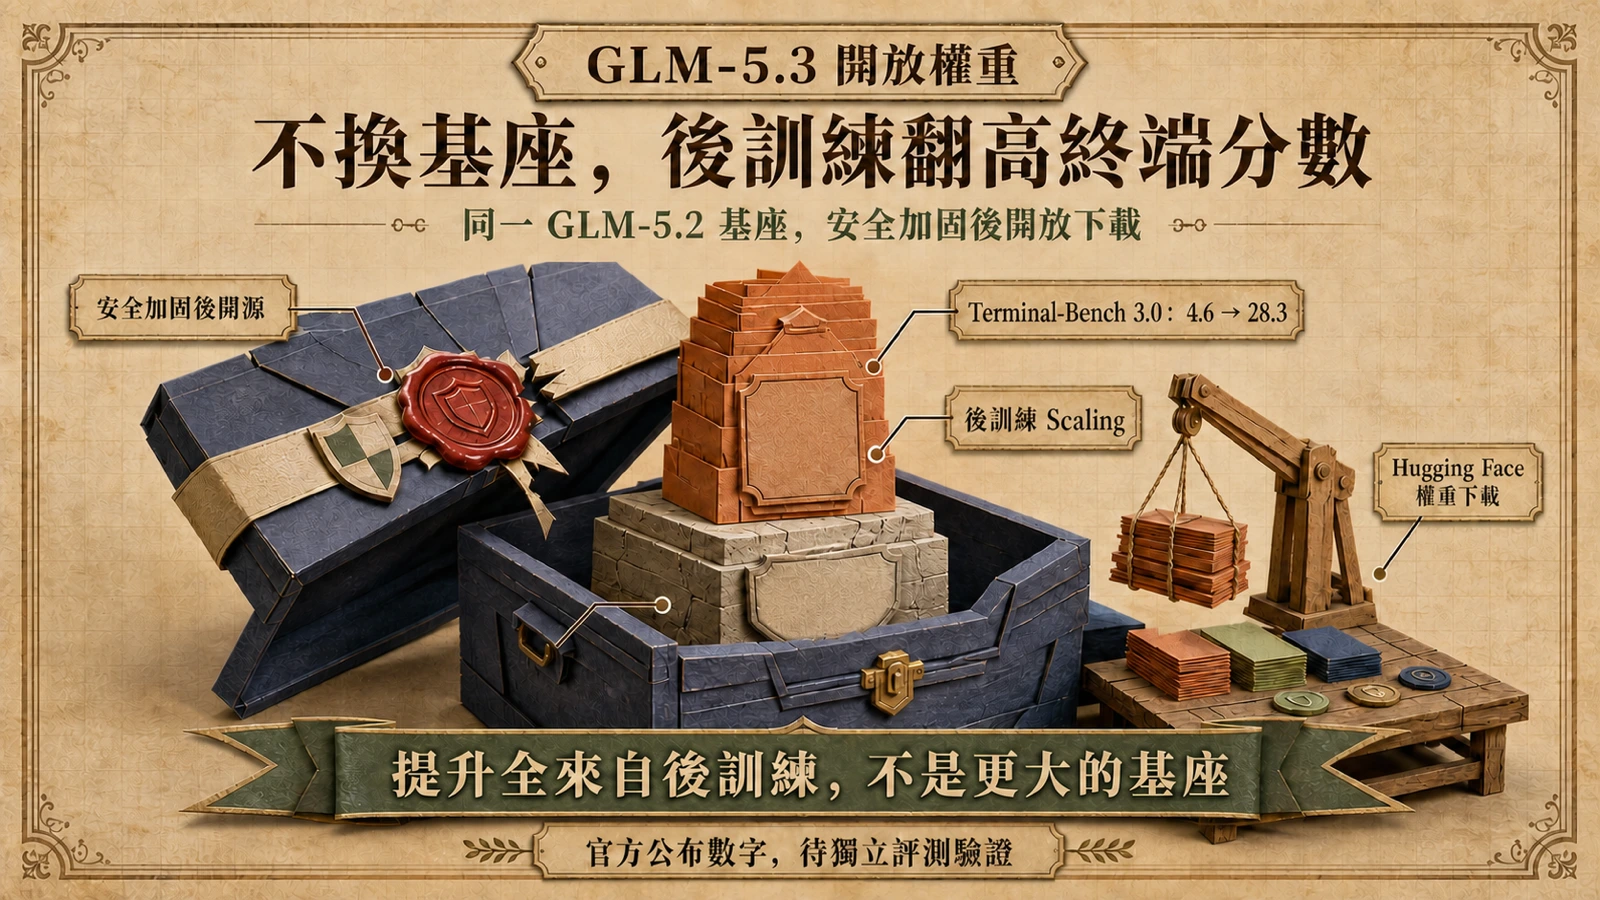
智譜(Z.ai)在 8 月 14 日發表旗艦模型 GLM-5.3 時,白紙黑字承諾發布兩週後開放模型權重,此前完成安全評估與模型加固。8 月 28 日、承諾到期當天,GLM-5.3 的權重正式開放下載,放在 Hugging Face 的 zai-org/GLM-5.3 儲存庫,技術說明同步發布於 Z.ai 官方部落格。從發表、上線編碼工具到權重開放,智譜在兩週內走完一個版本週期,GLM-5.3 也正式進入「可下載、可自架、可微調」的開源模型行列。
開放的條件值得注意。智譜在發布時說明,完整權重開源前需完成必要的安全加固,目標是盡可能限制模型的潛在攻擊能力、保留其防禦價值——因為 GLM-5.3 這一代最突出的新能力之一,正是網路安全任務。對一個標榜漏洞發現能力的模型,先加固再開放權重,本身就是發布流程裡的一道設計,也預告了高能力開源模型後續可能都要走的標準動作。
同一基座、純後訓練:提升從哪裡來
GLM-5.3 最反直覺的地方,是它沒有換基座。發布公告載明,GLM-5.3 使用與 GLM-5.2 相同的基礎模型,所有提升均來自後訓練。換句話說,預訓練階段的大量算力沒有重燒,效能躍進來自後訓練階段的強化學習工程。
根據智譜公布的路徑,後訓練 Scaling 的槓桿有三:數十倍擴充的長程任務環境、更豐富多樣的環境類型,以及超長的後訓練時間;底層則以 IndexShare 架構、SAO 與持續演進的新一代 Slime 框架,在與 GLM-5.2 完全相同的基座上推進強化學習。智譜還補了一句耐人尋味的話:這個基座的智能上界,可能還遠未被開發完。
對開發者的意涵是:模型世代的差距,正從「參數規模」移向「訓練後工程的深度」。同一組權重起點,靠任務環境設計與強化學習就能把終端任務分數拉高數倍。這對多數團隊是務實的好消息——追上前沿的門檻不在於更大的預訓練,而在於更會設計訓練環境;而權重開放之後,這些後訓練成果也變成任何人都可以拿去微調、蒸餾的起點。
基準成績:終端實作與長程工程的跳躍
具體數字上,GLM-5.3 在幾項強調真實環境與長程任務的基準都出現大幅躍進。在衡量模型於真實終端環境完成複雜任務的 Terminal-Bench 3.0,得分從 GLM-5.2 的 4.6 升至 28.3;聚焦長程軟體工程與持續程式碼修改的 DeepSWE v1.1,從 46.2 升至 66.9;強調跨工具協作與長程任務的 Agents’ Last Exam,從 23.8 升至 28.5;在覆蓋 44 種職業、考察高價值知識工作的 GDPval-AA v2 則拿到 1,769 分,顯示編碼能力正外溢為一般專業任務的執行力。
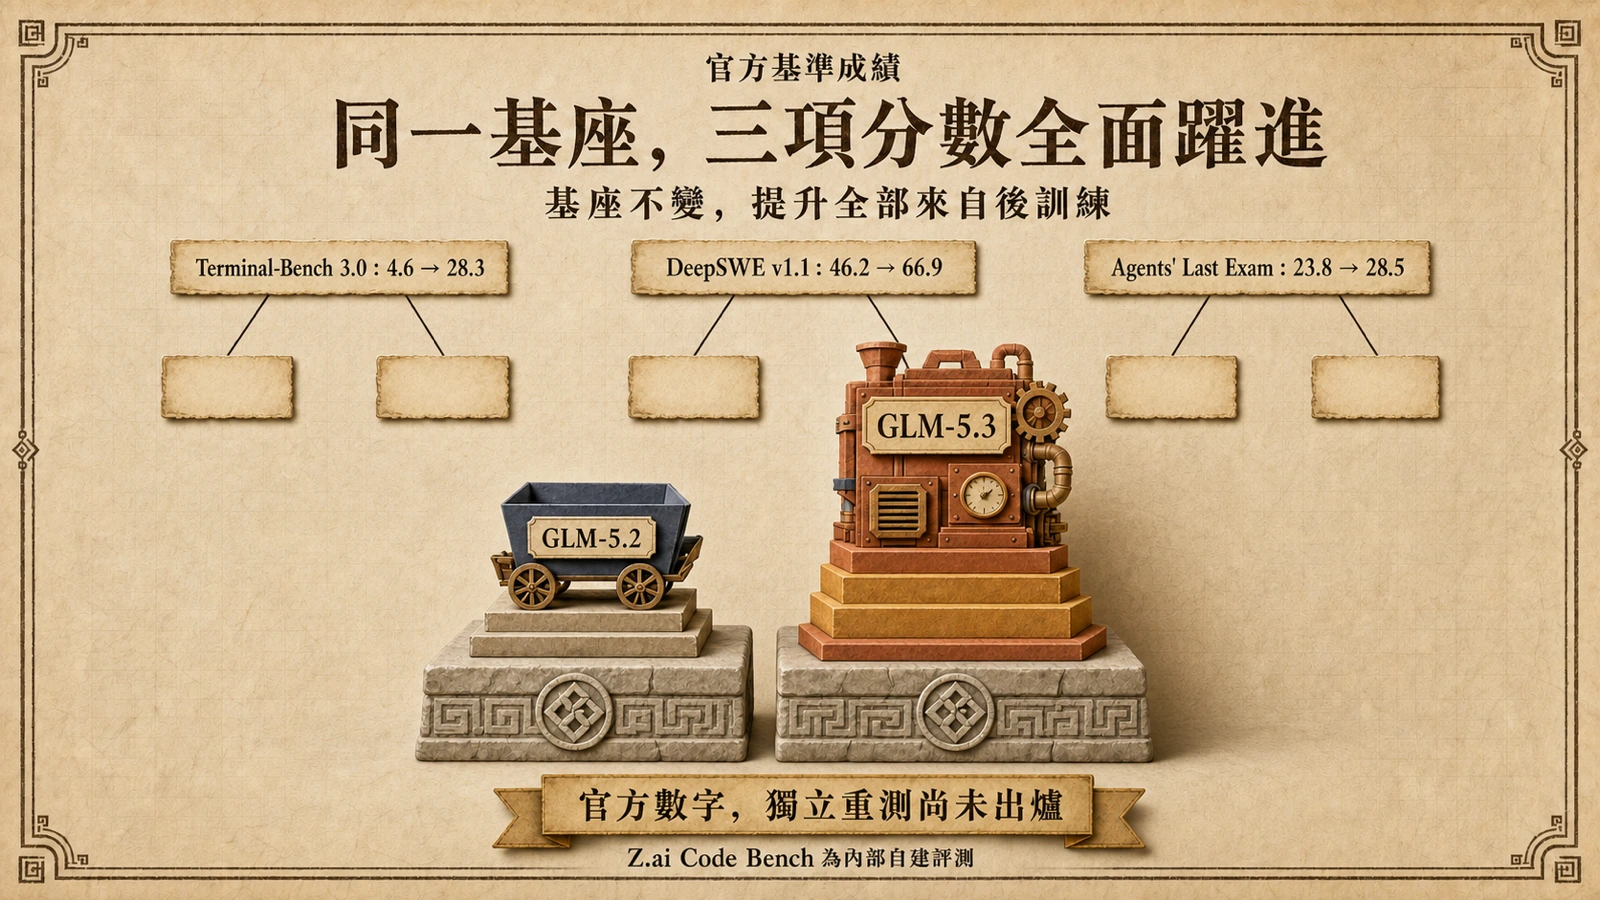
效率面同樣關鍵。在智譜自建的 Z.ai Code Bench——把模型放進複雜本地開發環境、在不同思考檔位執行端到端任務的內部評測——GLM-5.3 在 High 檔位達到 31.4% 準確率,超過 Claude Opus 4.8 最高檔位的 29.5%,而每項任務平均輸出約 5 萬 token,Opus 4.8 則需要約 12 萬 token。官方的解讀是 GLM-5.3 能用更短的執行路徑完成任務;對按 token 計費的重度使用者,這個差距會直接反映在每月帳單上。
網路防禦:追平 Mythos 5 的雙面刃
GLM-5.3 另一個被官方點名的新能力是網路安全。在白盒程式碼審查與漏洞發現等安全任務,GLM-5.3 的表現持平 Anthropic 的 Mythos 5。這個對比有分量,因為 Mythos 系列正是先前自主挖出密碼學弱點、讓資安圈繃緊神經的那一系模型,見〈Mythos 自主密碼分析〉。一個開放權重的模型在安全任務上追平閉源前沿,也解釋了智譜為何堅持先加固、再開放。
實戰案例已有端倪。另有中國媒體報導,清華 NASP 實驗室以 GLM-5.3 深入底層架構,在權限校驗邏輯撕開一道缺口,攻擊者一旦利用可任意寫入檔案、甚至接管整個開發環境,對象是廣泛使用的 AI 編輯器 Cursor。這類報導的細節尚待官方披露佐證,但方向與官方定位一致:同一個找漏洞的能力,防守方拿來審自己的程式,攻擊方拿來審別人的——開源權重讓兩種用法都變得容易,這正是「限制攻擊能力、保留防禦價值」這句加固目標的現實背景。
怎麼用:三種取用途徑
權重開放後,取用 GLM-5.3 的途徑有三。其一是下載權重自架:Hugging Face 上的 zai-org/GLM-5.3 已可下載,適合有 GPU 叢集、需要微調或離線部署的團隊;商用前應另行核對最終授權條款與安全審查門檻,硬體需求則以下載頁標示為準。其二是走訂閱:Z.ai 國際站的 GLM Coding Plan 已將 GLM-5.3 列入方案,可在 Claude Code、Codex、Cline 等 20 餘種編碼代理中使用。其三是官方代理環境 ZCode:官方文件將它定位為把 GLM 模型帶進真實編碼流程的代理開發環境(Agentic Development Environment),模型、工具與執行流程在同一套工作流裡共同調校;關於 ZCode 的工作流設計,見〈ZCode 與 GLM-5.2 的代理工作流〉。
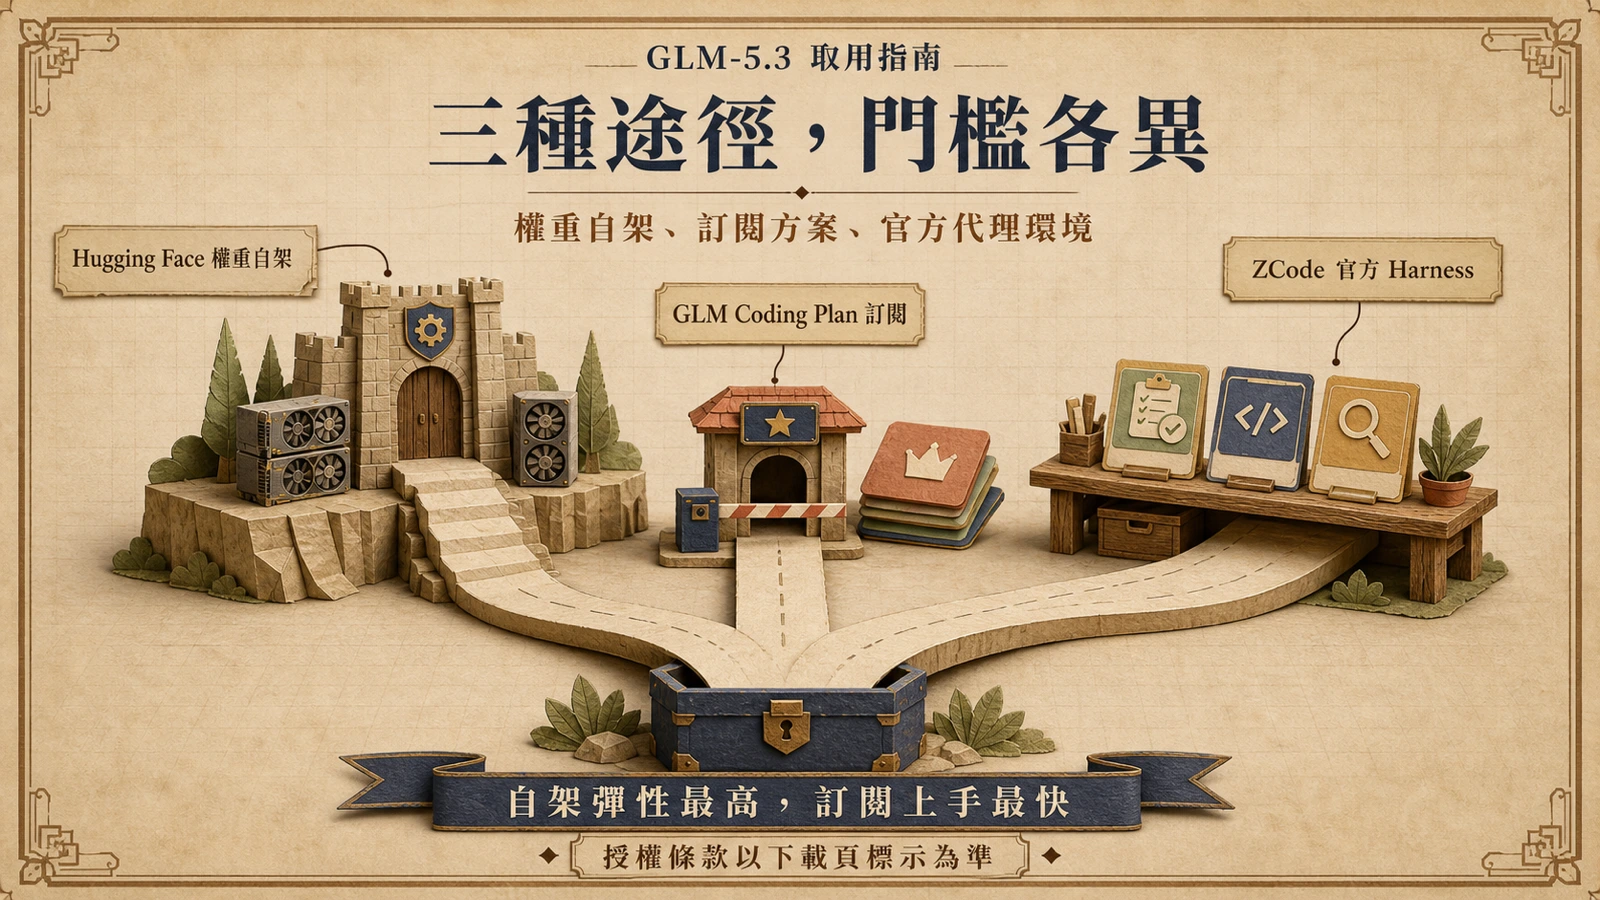
價格結構上,GLM Coding Plan 在智譜國際站以美元計價,中國站 BigModel.cn 則以人民幣計價,兩邊的方案條款與適用範圍並不相同。與 Claude Opus 4.8 相比,GLM-5.3 的賣點不是絕對分數追平,而是在相近的分數下用不到一半的 token 數完成任務——對每天讓編碼代理跑幾十項任務的團隊,成本差異會在月底被放大。
限制與後續觀察
這份成績單有三個但書。第一,主要數字來自智譜官方公告與內部自建的 Z.ai Code Bench,「體感提升 50%」屬廠商自述,尚待獨立評測驗證。第二,「持平 Mythos 5」的比較口徑——任務集、樣本數、評測協議——官方並未完整揭露,資安圈需要可重現的細節才能定論。第三,權重開放後的實際部署門檻,包括檔案規模、主流推理框架(vLLM、SGLang)的支援進度與微調配方,都要等社群實測才會明朗。
後續值得追蹤的指標有三:獨立榜單對 GLM-5.3 的第三方重測結果;主流編碼工具是否把它設為預設模型;以及「安全加固」實際上對模型行為加了哪些可觀察的限制。如果後訓練 Scaling 真能在同一個基座上持續榨出效能,那麼在下一代 GLM 出現之前,GLM-5.3 的開源權重本身就是這套方法論最有說服力的公開樣本。