11–16 倍背後:一個改寫 Metal 能力回報的墊片
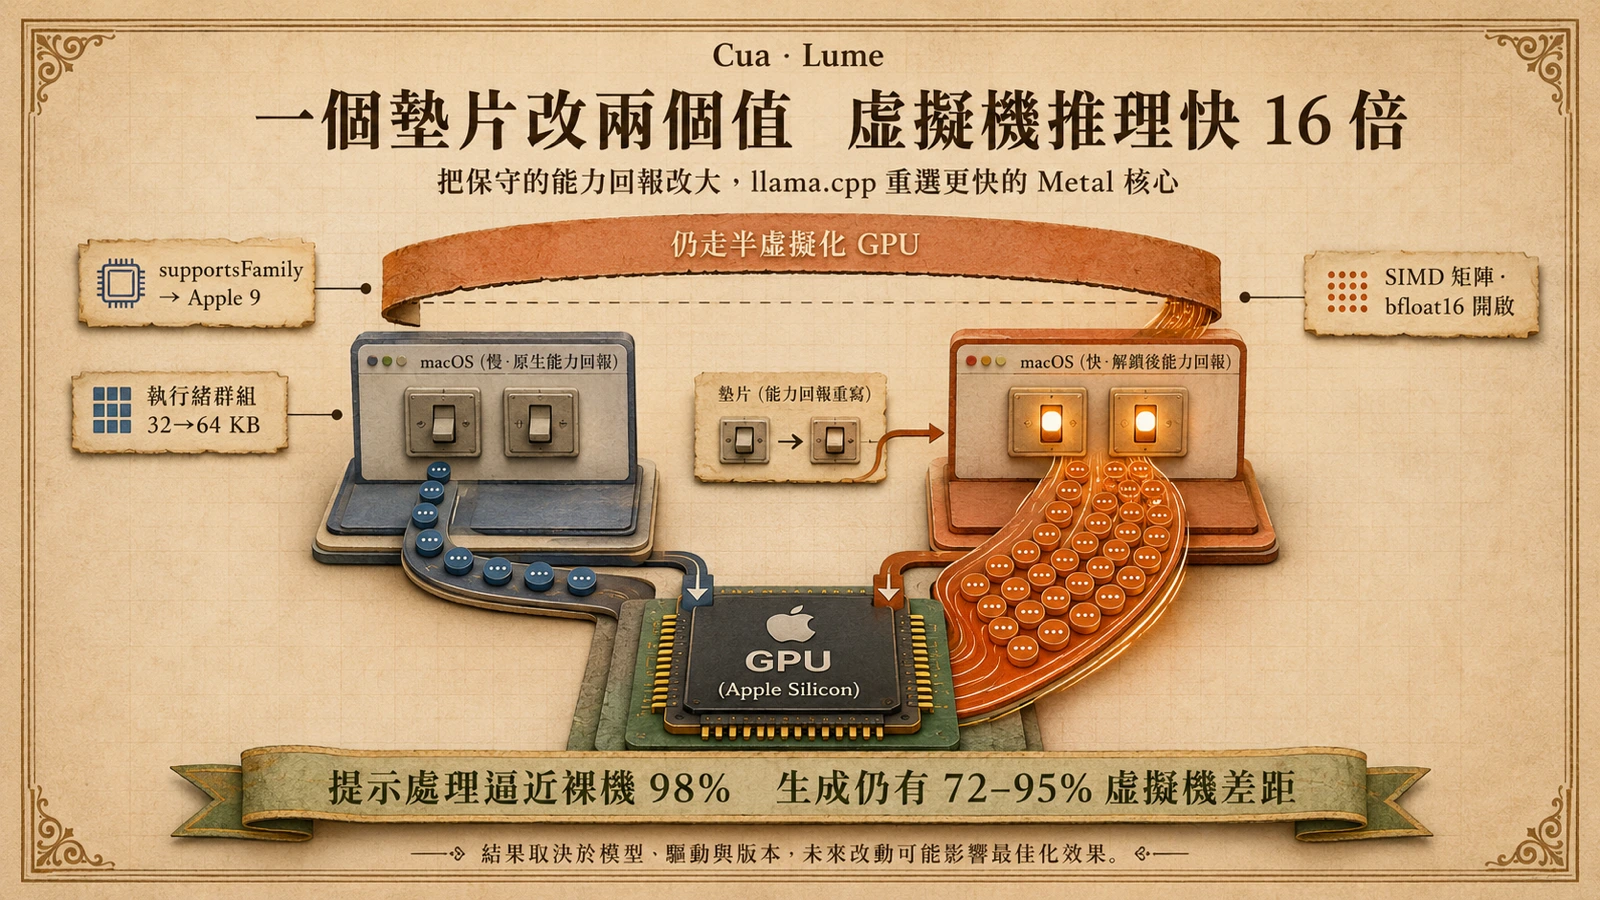
2026 年 8 月 11 日,Cua 團隊的 Francesco Bonacci 與 Johnny Franks 以研究發布的形式,釋出一個小型的進程級金屬能力墊片。它的作用不是為虛擬機加上新的 GPU,而是改變 macOS 客機裡一個進程對「這台 GPU 支援什麼」的查詢答案,讓 llama.cpp 重新選到較快的 Metal 核心。在一台 48 核 GPU 的 M1 Ultra 上,TinyLlama 1.1B 的提示處理比同一個標準虛擬機快 11.08 倍、token 生成快 16.36 倍,官方評測結果顯示提示處理達到裸機的 98.25%。
關鍵在於一個長期被當成硬傷的現象有了軟體層的解法:蘋果虛擬機裡的 GPU 慢,常常不是因為算力不夠,而是因為應用程式被「告知」這顆 GPU 比它實際能做的更舊。Cua 的工作顯示,只要把兩個能力回報值改大,那條更快、一直存在於晶片上的路徑就會被選中。團隊把原始碼、建置腳本、能力探測程式與完整的基準日誌一併開源(與 Lume、Cua 同樣的寬鬆授權),讓其他人可以重現並找出哪些 Apple Silicon 晶片、macOS 版本與 Metal 工作量能受益。
為什麼 macOS 虛擬機的 GPU 推理會慢
要理解差距從何而來,得先看蘋果虛擬化的運作方式。透過 Virtualization.framework 運行的 macOS 客機,拿到的是一個半虛擬化圖形裝置:客機透過專屬 GPU 驅動提交 Metal 工作量,主機端的蘋果軟體棧再在實體 GPU 上執行。主機保留對硬體的控制權,客機則使用一個能感知虛擬化的裝置。這與 x86 Linux 上以 QEMU、KVM 為基礎的棧不同——後者可透過 VFIO 與 IOMMU,把相容的實體 PCI 裝置直接分配給虛擬機,也就是一般所說的 GPU 直通。
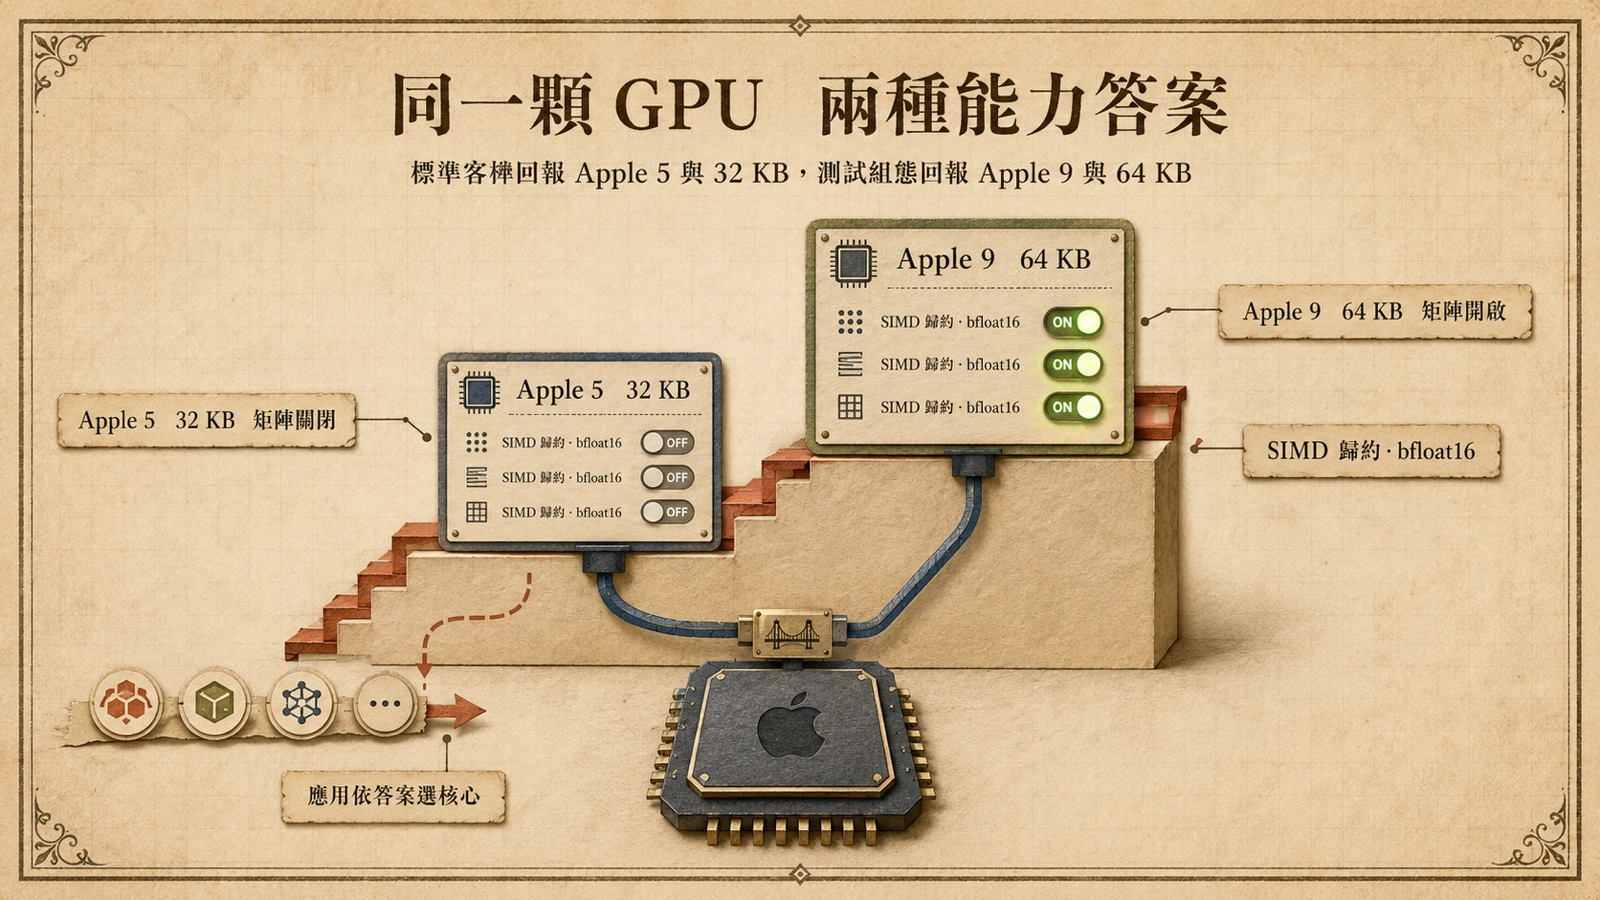
問題不在於這條半虛擬化路徑無法執行工作量,而在於它回報的能力過於保守。在 Cua 標準的 Tahoe 客機裡,這個裝置回報的是大約 Apple 5 代的家族等級、最大 32 KB 的執行緒群組記憶體,而且 SIMD-group 矩陣支援標示為不可用。而現代 Metal 軟體正是依賴這些回傳值來挑選核心——蘋果官方文件建議,在執行期呼叫 supportsFamily(_:) 來查詢 GPU 支援哪個家族。於是即使底層裝置其實跑得動更新的核心,llama.cpp 依舊選了較慢的執行路徑。換句話說,瓶頸是「能力邊界」本身:應用程式完全照平台告知的資訊行事。
進程級墊片:只改兩個回報值
Cua 的解法是一個小型金屬能力墊片(capability shim,一種插在應用與 API 之間的相容層),它運行在單一客機進程內部,會攔截選定的 Metal 能力查詢並修改回傳給該進程的答案。對於測試組態,墊片只做兩件事:把 supportsFamily: 的應答提升到 Apple 家族 9(枚舉值 1009),並把回報的最大執行緒群組記憶體從 32 KB 提升到 64 KB。這兩個改動就足以讓該版 llama.cpp 選到 SIMD-group 歸約、SIMD-group 矩陣與 bfloat16 等較新路徑。
| 能力項 | 標準客機 | 測試組態 |
|---|---|---|
| supportsFamily:1009 | 否 | 是 |
| SIMD-group 矩陣 | 關閉 | 開啟 |
| SIMD-group 歸約 | 關閉 | 開啟 |
| bfloat16 | 關閉 | 開啟 |
| 最大執行緒群組記憶體 | 32 KB | 64 KB |
值得強調的是這個改動的範圍極窄,而且刻意收在安全邊界內。工作量仍然走 Apple 既有的虛擬 GPU 路徑、在主機 Apple GPU 上執行;能力變更只限於被注入的那一個客機進程,主機、客機核心、其他客機進程都不受影響。實體 GPU 分配、裸 PCI 或 VFIO 直通、核心修改,全都不在此機制的範疇。墊片以環境變數控制:若控制變數缺漏、為零、超出 Apple 家族範圍或格式錯誤,程式會維持在預設能力路徑不變,等於內建一個失敗安全(fail-safe)的退路。團隊還特別說明,消融測試期間若把 MTLGPUFamilyMetal3 也改掉,會讓 MLX 請求一個半虛擬化裝置無法提供的駐留集(residency set),因此正式發布版刻意把變更限制在 Apple 家族枚舉值內、保留 Metal 3 的原值——這也解釋了為什麼 MLX-LM 的成績幾乎不動。
接近裸機的是提示處理,生成還有差距
基準在配備 48 核 GPU 的 M1 Ultra、macOS 26.6.1 主機上進行,客機為運行於 Lume 0.5.1 的公開 Tahoe Cua 映像檔(macOS 26.5.2、8 vCPU、16 GiB)。三次皆用官方 llama.cpp b10167 與相同的 TinyLlama 1.1B Chat Q4_K_M 模型,以 llama-bench -p 512 -n 128 -r 10 -t 8 -ngl -1 對每行取十次樣本的中位數。
| 工作量(TinyLlama 1.1B,tok/s) | 裸機主機 | 預設客機 | 解鎖客機 | 客機加速 | 解鎖/主機 |
|---|---|---|---|---|---|
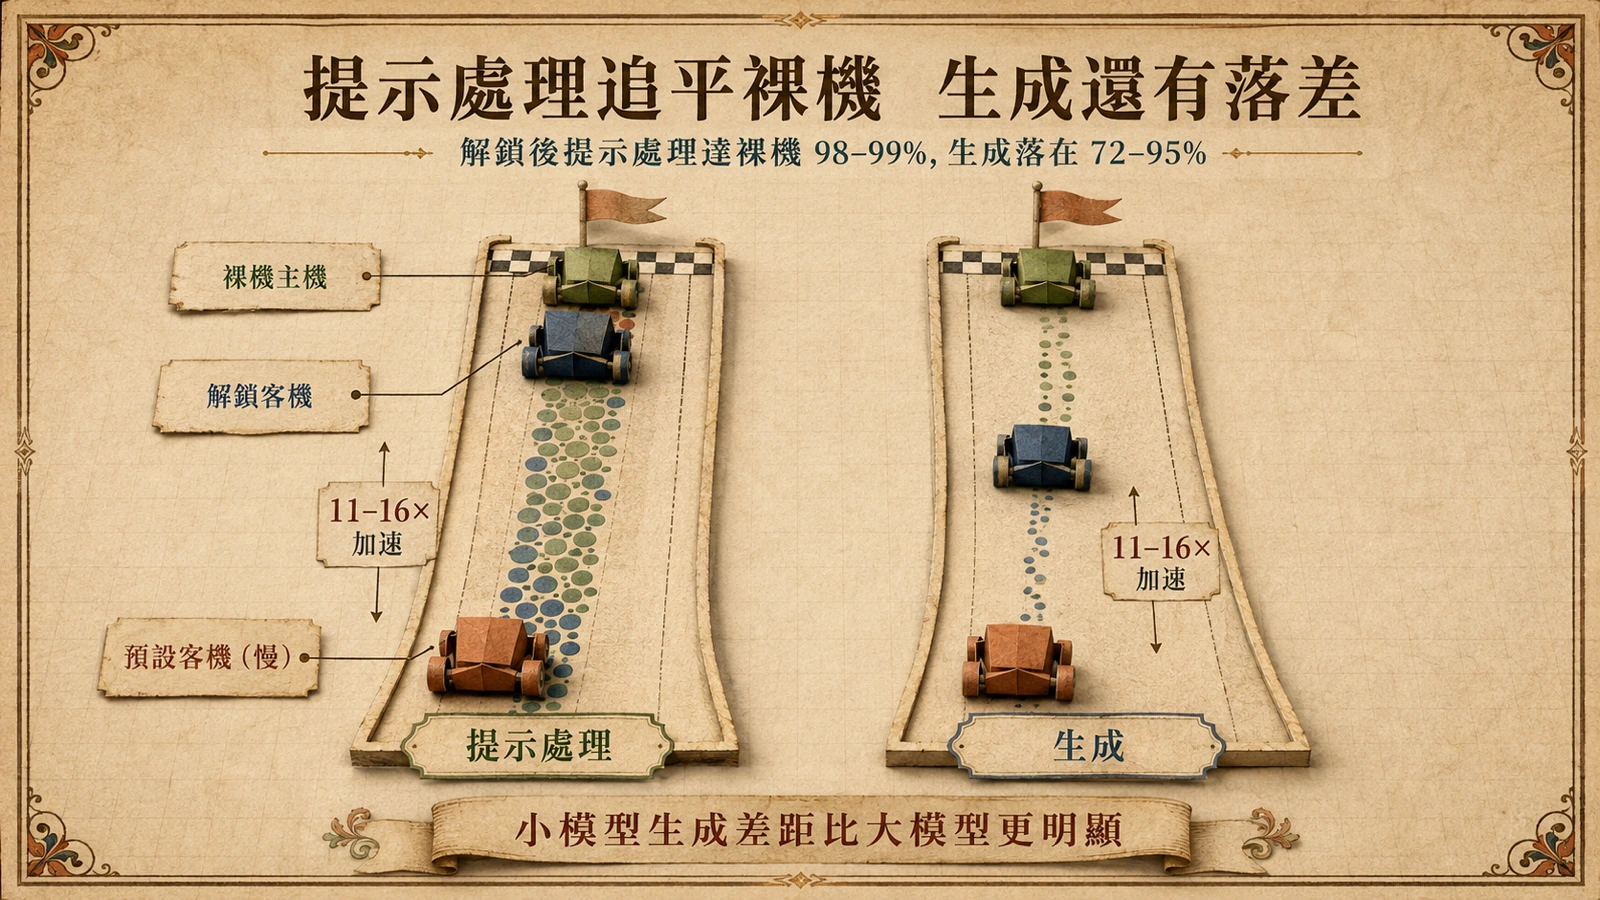
| 提示處理 512 tokens | 4,871.99 | 431.86 | 4,786.70 | 11.08× | 98.25% |
| 生成 128 tokens | 286.71 | 12.63 | 206.60 | 16.36× | 72.06% |
團隊再用 Google 官方的 Gemma 4 12B 指令微調 QAT Q4_0 模型重複實驗(同一個 llama.cpp 二進位檔、關閉推測解碼、不載入多模態投影器,以保持在同一條 Metal 推理路徑上比較):
| 工作量(Gemma 4 12B,tok/s) | 裸機主機 | 預設客機 | 解鎖客機 | 客機加速 | 解鎖/主機 |
|---|---|---|---|---|---|
| 提示處理 512 tokens | 517.88 | 71.66 | 515.76 | 7.20× | 99.59% |
| 生成 128 tokens | 52.38 | 3.41 | 49.67 | 14.54× | 94.82% |
兩個模型描繪出一個一致的輪廓:提示處理幾乎完全抹平虛擬機差距(TinyLlama 達裸機 98.25%、Gemma 4 12B 達 99.59%),但生成階段仍留下可量測的落差——TinyLlama 只有裸機的 72.06%,較大的 Gemma 4 12B 反而留下較小差距(94.82%)。團隊另以 Muse Glimmer 30B 在 64 GiB 客機上補測,提示處理與生成分別提升約 7.55 倍與 8.87 倍;而 MLX-LM 0.31.3 搭配 Llama-3.2-3B-Instruct-4bit 的對照組幾乎不動(比值約 1.0 倍),原因正如前述——MLX 在標準客機裡已經夠快,且把 Metal 3 也改掉會踩到駐留集的限制。這組「大幅加速」與「紋風不動」並存的數據,恰好劃出了這個方法的適用邊界:它的威力集中在那些會因保守能力回報而選錯核心的工作量上。
實驗性、按進程、且 Apple 未背書
這項成果之所以以「研究發布」而非產品功能的形式釋出,是因為它的穩健性仍受幾項前提制約。首先,墊片依賴客機 Metal 實作中私有、隨版本變化的細節——Apple 可能在任何一個 macOS 版本更動它,因此團隊對每一組主機與客機組合都獨立測試。其次,它只對被注入的單一進程(及其子進程)生效,經強化或受平台保護的二進位檔可能拒絕函式庫注入。再者,它只回報測試所涵蓋的 Apple 家族值,每多涵蓋一個 Metal API 都需要各自的虛擬化測試;物理 GPU 能力的探索也不在範圍內。
更重要的是要釐清它「不是」什麼。它不是 GPU 直通,不涉及裸 PCI 或 VFIO 的實體裝置分配,也不修改主機或客機核心——工作量始終在 Apple 既有的半虛擬化 GPU 路徑上執行,既有的 Virtualization.framework 渲染與虛擬化限制依然存在。啟用方式是兩段式:先在主機端為 Virtualization.framework 開啟 unrestricted feature level,再為單一進程注入墊片並以環境變數設定 Apple 家族上限(完整指令與回滾步驟見 Cua 的發布說明)。Apple 並未背書這項做法,Cua 團隊公開邀請蘋果工程師釐清半虛擬化圖形的不受限功能層級預期行為;同一個廣義限制也出現在其他 Virtualization.framework 前端,例如另一款 macOS 虛擬化 CLI「Tart」就有探討客機內 GPU 與 LLM 效能的公開 issue。
誰該關注:在虛擬機跑蘋果 GPU 推理的開發者
最直接的受益者,是任何在 macOS 虛擬機內跑 llama.cpp 或其他 Metal 工作量、卻撞上異常緩慢 GPU 推理的開發者。CI/CD runner、容器化開發環境、自動化代理管線——Cua 自家的電腦使用代理就跑在 Lume 虛擬機裡——都可能是這個能力回報差距的受害者。對這類場景,第一個該檢查的往往不是硬體規格,而是「應用程式被回了什麼能力答案」。
不過,把它當成通用的「免費加速」會誤讀它的性質。它不增加記憶體或核心數、不改變 Virtualization.framework 的其他限制,也無法承諾跨 macOS 版本的穩定——蘋果只要調整那層私有 API 介面,方法就可能失效。它真正的長期啟示比較像一則提醒:虛擬機裡那條最快路徑,可能從一開始就在晶片上,只是被一個過度保守的回答擋在門外。對產品團隊而言,務實的做法是把這份研究發布當成驗證起點——在目標主機與客機上重現、比對原始證據日誌(映像檔摘要、模型與二進位檔的 SHA-256、原始 JSON),再決定是否把按進程的墊片納入自己的推理或渲染工作流程。當虛擬機的提示處理已逼近裸機,剩下的生成階段差距與其他既有瓶頸,就會回到與裸機推理相同的戰場。