「高風險」上了新聞,官方文件裡的定義是什麼
2026 年 7 月底,《華爾街日報》的調查報導指出,自 2025 年夏季起,有數百名用戶向 ChatGPT 詢問毒物與生物武器的製造方法,部分對話取得了員工形容為「高中生程度」的逐步說明;報導並稱 OpenAI 停權了這些提出危險問題的帳號、未將事件通報執法機關,內部則曾在 2025 年夏季將 GPT-5 標記為高風險、於同年秋季下調評級。這段評級變動目前沒有對應的公開文件,事件本身的來龍去脈,先前的追蹤報導已完整整理。
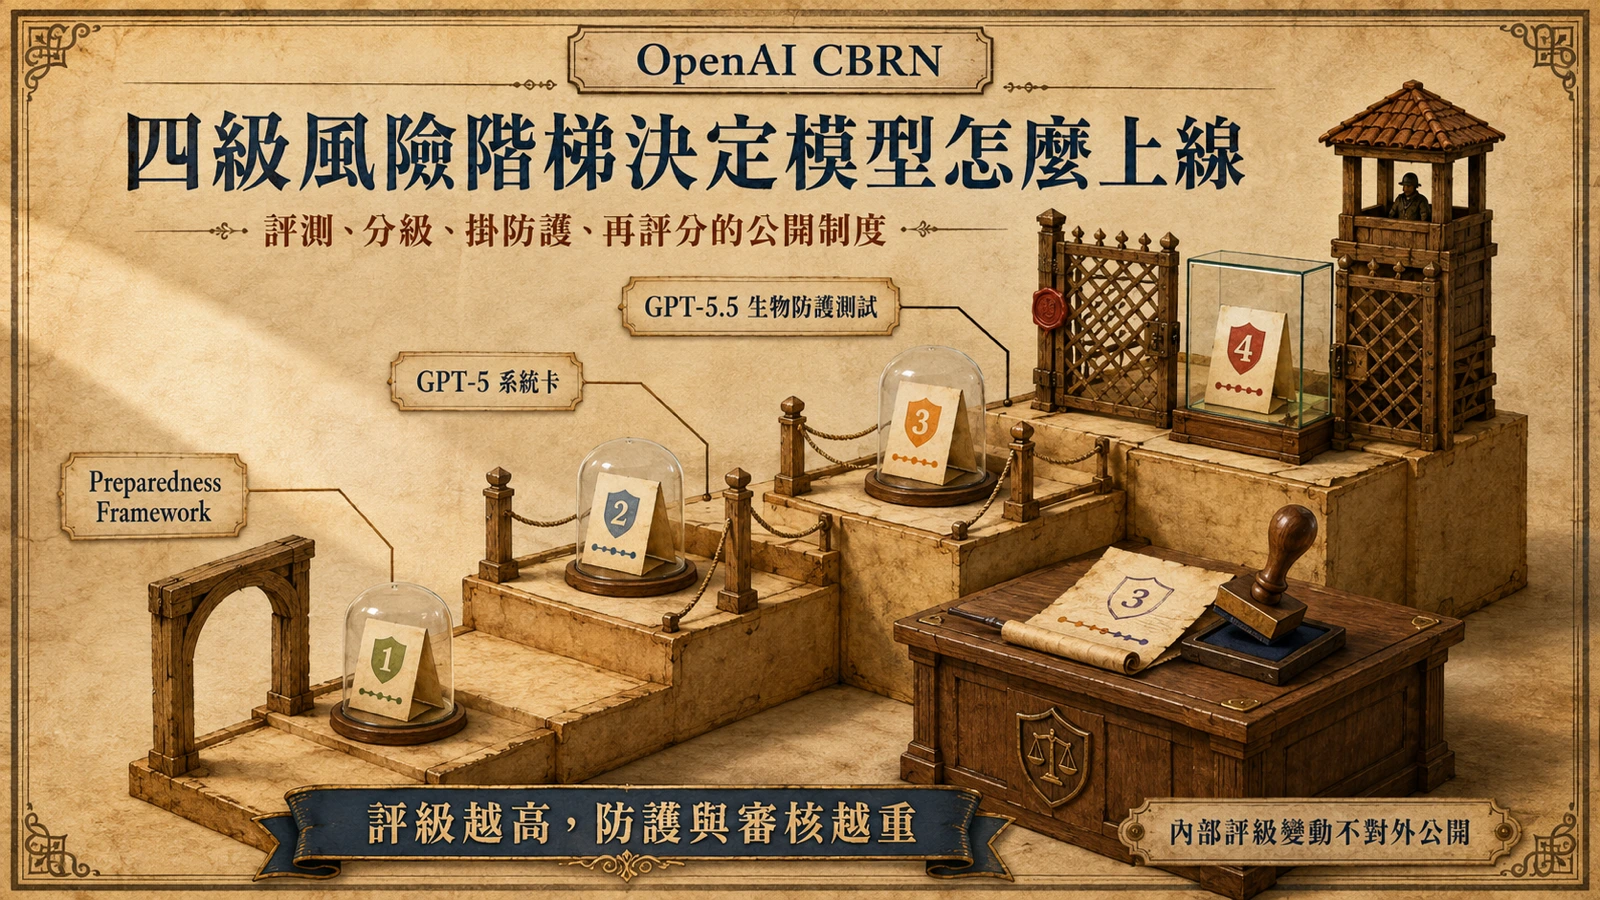
這則新聞最常被引用、卻最少被解釋的字眼是「高風險」。在 OpenAI 的官方文件裡,它不是形容詞,而是一套可以回查的正式分級:從 2023 年 12 月公布的 Preparedness Framework、各代模型隨發布附上的系統卡,到 2025 年起陸續擴充的 Deployment Safety Hub 文件站,OpenAI 把「模型有多危險、危險怎麼量、量完怎麼辦」寫成了公開制度。內部評級有沒有被調降,外部無從複驗;但官方版本的評級制度長什麼樣、每個等級對應什麼義務,全部攤在文件上。先看懂這套制度,才能判斷新聞裡的指控落在制度的哪一個環節。
CBRN:模型危險度的量測軸與 uplift 概念
在 OpenAI 的官方風險框架裡,CBRN 指的是與模型輔助創造化學(Chemical)、生物(Biological)、放射(Radiological)、核子(Nuclear)威脅相關的風險,與網路安全、說服力、模型自主性並列,構成前沿模型必須量測的四大風險類別。換句話說,當報導說一個模型被評為「高風險」,背後問的通常是:它會不會幫人做出 CBRN 這一類的東西。
評測的核心概念是 uplift(增益):問題不是「模型腦中有沒有危險知識」,而是「拿到模型的人,會不會因此變得比沒有模型時更危險」。毒物的合成路徑、病原的培養條件,多數本來就散落在公開文獻裡;模型真正改變的是取得的成本——檢索、拼湊與除錯的認知負擔被大幅壓低。這也正是《華爾街日報》報導中最刺眼的細節:員工形容部分回覆「連高中生都能照著做」。一個模型讓原本做不到的人做得到,即使每一條資訊都是公開的,增益仍然存在——這就是 CBRN 評測要量測的對象。
四級分級怎麼變成部署決策
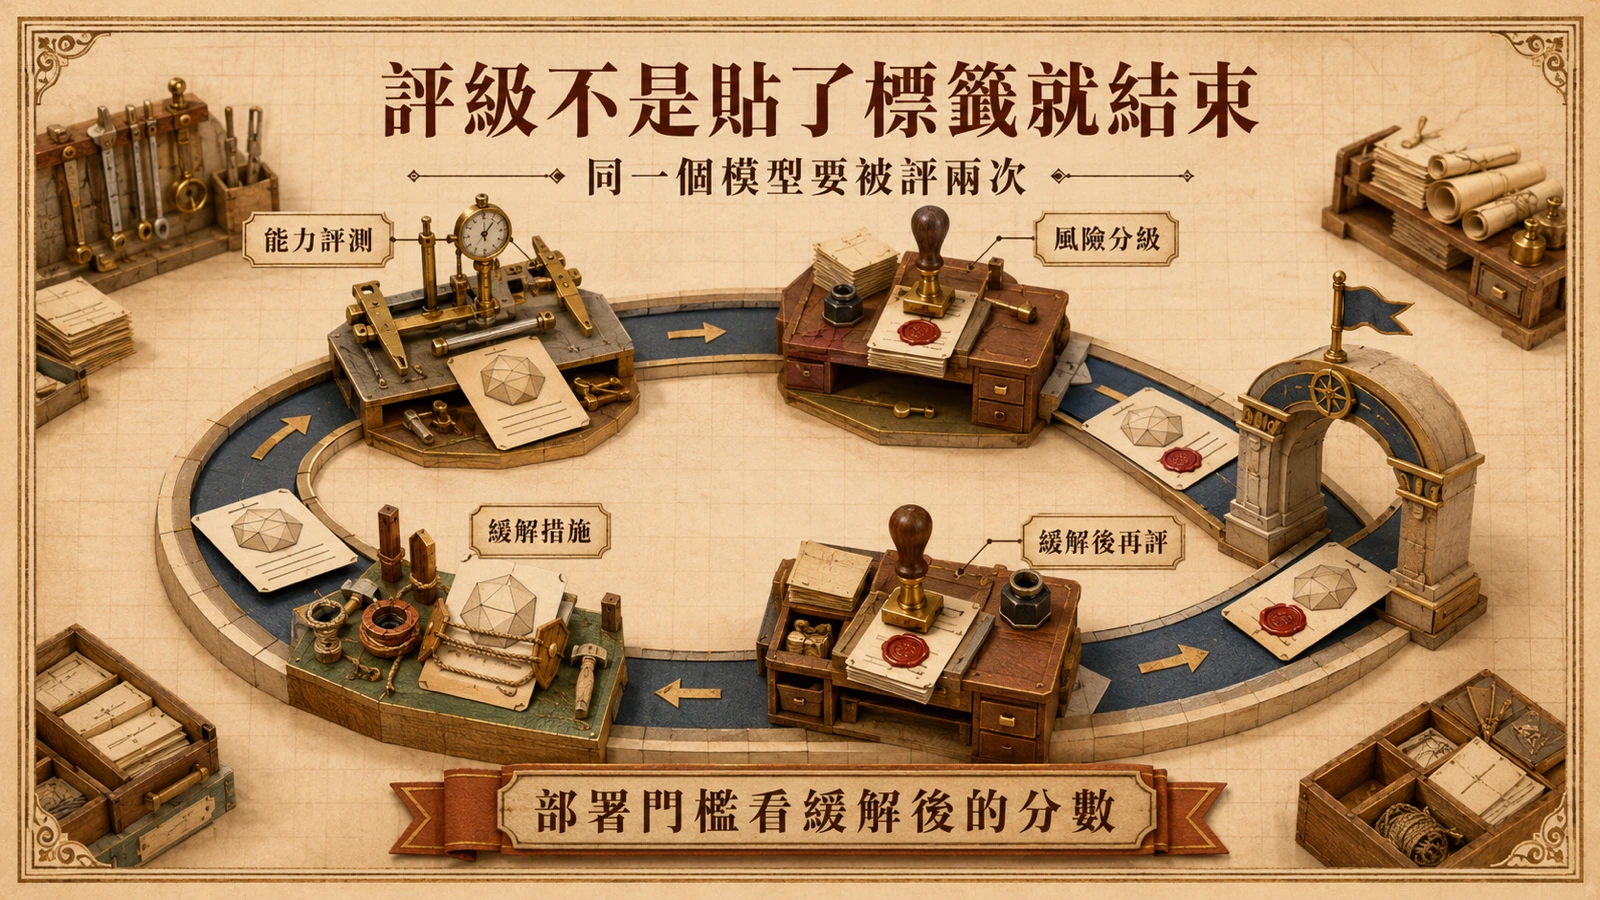
第一版框架把每個風險類別的評分由低到高分為四級:低(Low)、中(Medium)、高(High)、關鍵(Critical)。這組門檻不是抽象口號——OpenAI 在 o1 的系統卡中就說明,參與危險能力評測的外部專家上場前,是以「Preparedness Framework 的 CBRN 風險門檻(Low、Medium、High、Critical)」受訓的。分數不是標籤,而是部署決策的輸入:評測先行,內部測試加上外部專家紅隊,產生評級;評級若是過高,模型就必須掛上系統層防護——拒絕清單、輸出過濾、使用監控——然後在緩解之後重新評分,再看能不能上線。同一個模型因此會有兩個版本的分數:未緩解的能力分數,與掛上防護之後的分數,而部署判斷看的是後者。
2025 年 4 月改版的框架第二版,把方法再往前推了一步:官方公告明言,團隊正在為各類前沿風險發展威脅模型與先進能力評估。第一版的問法偏向「模型能力到哪裡」,第二版則要求把攻擊者怎麼用、防護怎麼擋、殘餘風險還剩多大,一起放進具體情境裡計算。這個轉變對讀者的意義很實際:兩份文件裡的「風險」不是同一種量尺,跨年份比較評級時,得先確認在看哪一版。
GPT-5 系統卡:生物評測為什麼排在化學前面
2025 年 8 月隨 GPT-5 發布的系統卡,把這套框架落成一頁可以回查的紀錄。系統卡明言,有鑑於生物威脅的潛在嚴重性高於化學,團隊優先進行生物能力評測——資源有限時,先量最痛的地方。
評測的基準點也寫得很清楚。OpenAI 在 Deployment Safety Hub 的威脅模型與生物威脅分類頁說明,評測的基本做法是把 GPT-5 拿來與前代模型比較:在同樣的任務上,新的模型有沒有讓危險任務變得更容易。這個設計的含義必須說破——它量的是相對風險,不是絕對安全。一個模型可以每一代都「沒有比前代危險」,同時整個產品線的絕對能力逐代攀升;當說服力、化學與生物知識整體上升時,逐代比較會給出一路「持平」的讀數。新聞報導問的是「這個模型能不能教人做毒物」,系統卡回答的是「它有沒有比上一代更會」——兩個問題都成立,但不能互相替代。
GPT-5.5:用專家紅隊實測生物防護能不能被繞過
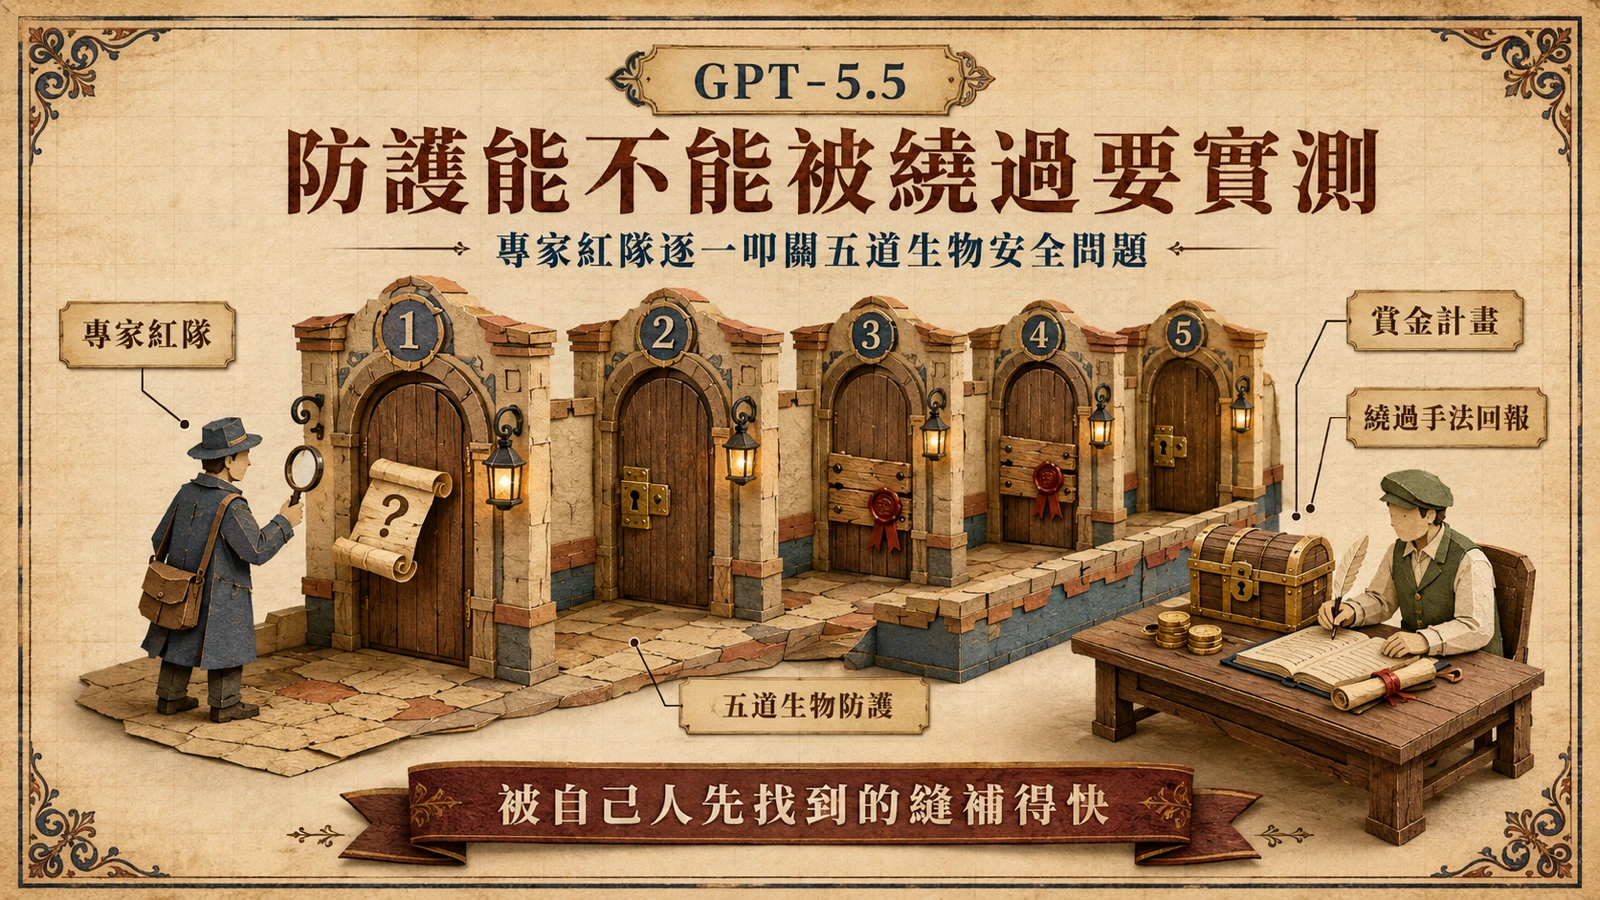
評級處理能力,防護處理輸出,而防護本身也需要被測試。GPT-5.5 的系統卡新增了生物防護測試頁,測試設計是讓專家紅隊嘗試繞過生物濫用防護——量測對象直接換成「防護有沒有被打穿」,而不是再問一次模型的能力分數。
配套措施把這件事推向外部:OpenAI 的生物賞金計畫公開徵求能一次繞過全部五道生物安全問題的通用越獄提示詞,測試範圍限於特定桌面環境中的 GPT-5.5。把「找繞過手法」變成有賞金的公開工作,等於承認防護必然有縫,重點是讓縫先被自己人找到。對照《華爾街日報》報導中「部分用戶取得逐步指南」的指控,這正是同一個問題的官方解法雛形:不是保證零繞過,而是用持續測試把繞過手法被利用的時間縮短。同一時期,OpenAI 也為生命科學場景另建受管控的 GPT-Rosalind 系列,把高風險研究用途導向需要審核的專屬模型管道,而非一般消費端。
對開發者與企業:採購時該問的三個問題
這套公開文件對採購端的價值,是把「你們模型安不安全」這種無法驗證的問題,換成三個可以要求看證據的問題。第一,要求看系統卡中的濫用防護測試段落:有沒有做、誰做的、結論是什麼——GPT-5.5 的做法(專家紅隊加賞金計畫)可以直接當作供應商的最低標竿。第二,釐清自己拿到的是哪一層:系統卡的評級與防護是針對官方產品量測的,經由 API 與自家工作流組裝之後,防護深度取決於你的系統提示、過濾器與權限設計,這一層的紅隊沒有人能替你做。第三,把治理寫進合約:供應商的風險評級流程、內部評級變動要不要告知客戶、濫用事件通報給誰——美國現行法沒有強制通報義務,這些目前全靠商業約定。
這套制度的限制與值得追蹤的指標
不過,這套公開制度回答不了新聞裡最關鍵的問題。第一,評級的歷史不公開:「夏季標記高風險、秋季下調」這段敘述只有單一媒體的調查支撐,沒有任何 OpenAI 文件可以對照複驗——文件公開的是制度,不是每一次評級的決策紀錄。第二,評測的細節有限:紅隊的規模、題庫的內容、通過與否的門檻,都沒有完整揭露,外部無法重跑同樣的評測。第三,整套框架是公司自律:四大類別、四級分級、部署門檻,全部由 OpenAI 自己定義、自己執行、自己解釋,法律上沒有強制力,改版也不需要外部核准。
值得追蹤的指標因此很具體:生物賞金計畫後續公布的成功繞過案例與修補速度;GPT-Rosalind 的受控存取模式會不會成為高風險用途的常規;以及美國國會有沒有把 AI 生物安全從自律推向法定通報。在強制揭露出現之前,系統卡與部署安全文件是外界唯一能逐版比對的公開軌跡——這也是為什麼讀懂它們,比記住任何一次新聞風暴更值得。