8 月 2 日生效:Claude 的文字輸出全面帶上隱形水印
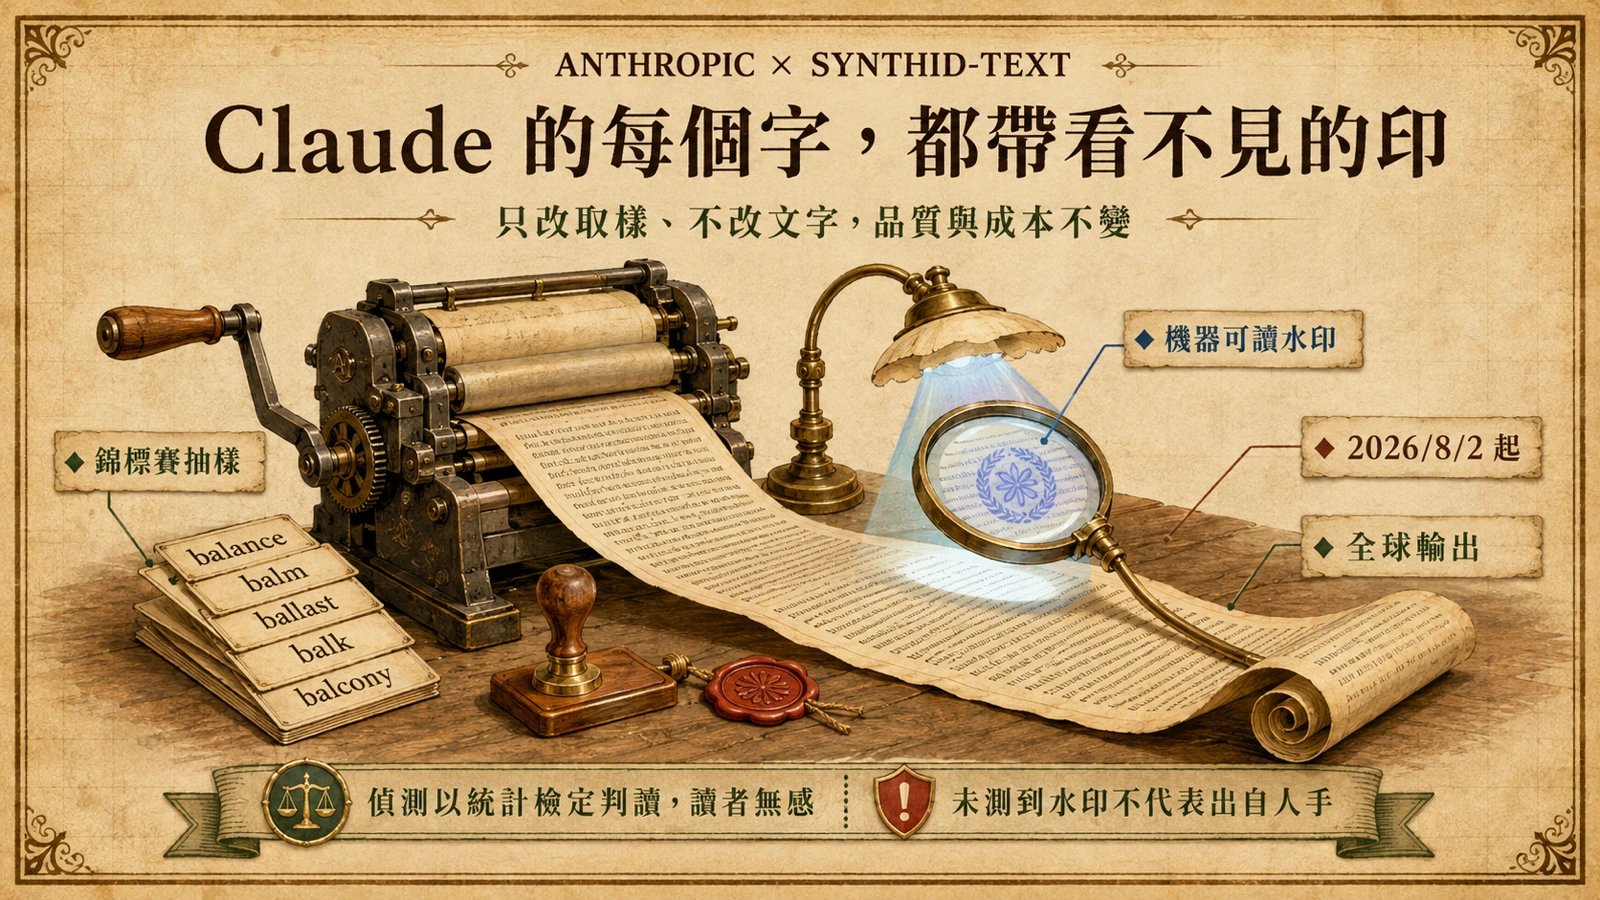
2026 年 8 月上旬,Claude 的輸出出現了一般使用者完全察覺不到的變化:Anthropic 在官方公告中確認,未來推出的 Claude 模型所生成的文字,一律嵌入肉眼不可見、但機器可讀的水印。依 Claude 說明中心的定義,Claude 以兩種互補的技術標記其生成與處理過的內容:其一是直接織進文字本身的水印,其二是附加在檔案上的簽署 metadata。而文字水印的技術基礎,是 Google DeepMind 開發、已經開源的 SynthID-Text。
這不是實驗室裡的原型。SynthID-Text 的原始研究 2024 年登上 Nature,論文將它定位為兼顧文本品質與偵測準確度的生產級水印方案,並且已在 Google Gemini 上大規模部署,處理過數以百萬計的真實使用者回應。Anthropic 等於是把這條已被線上流量驗證過的技術路線,原封不動搬進了 Claude 的生成管線。
時間點也不是巧合。歐盟《AI 法案》第 50 條的透明度義務自 2026 年 8 月 2 日開始適用,而 Claude 的水印正是從這一天起隨新模型生效;Anthropic 並同步簽署了歐盟執委會的《AI 生成內容透明度實務守則》。值得留意的是範圍——水印並非只在歐盟啟用,而是隨新模型在全球統一開啟。
水印藏在選字機率裡:錦標賽抽樣的原理
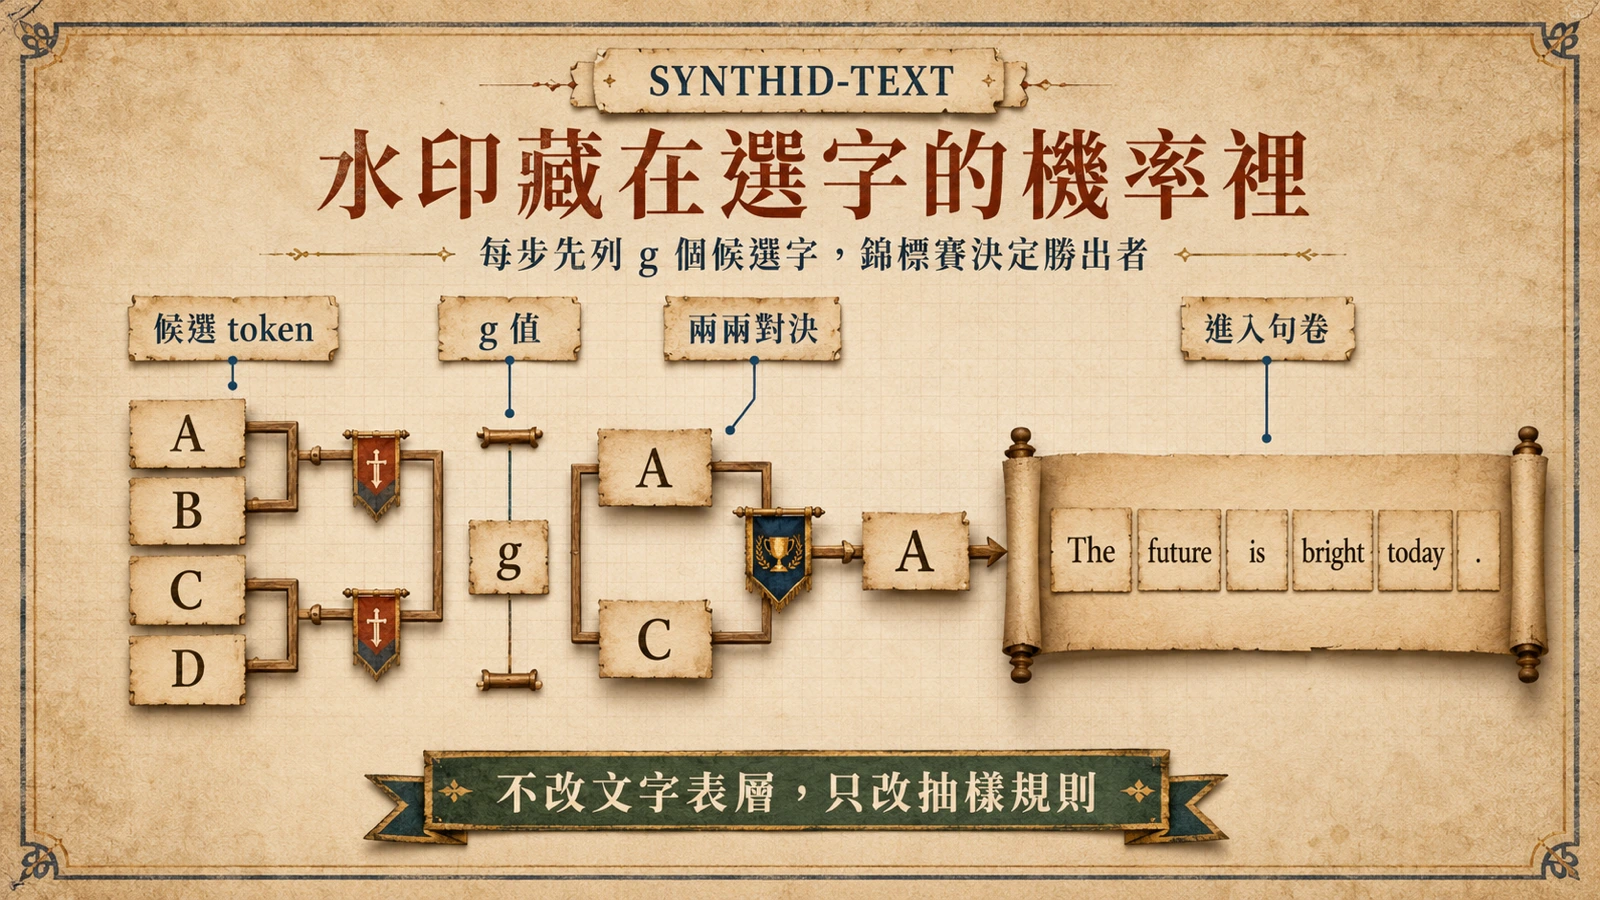
SynthID-Text 最反直覺的地方在於:它不改模型訓練、不在文字表層加料、也不輸出任何看得見的記號——它改寫的是「模型選下一個字」的抽樣程序。大型語言模型生成文字時,每一步都是從一個機率分布中抽樣出下一個 token。SynthID-Text 要求模型在每個生成步驟先列出 g 個候選 token 與各自的合理性分數(論文稱為 g 值),再由水印演算法以隨機化的「錦標賽」規則,讓候選者兩兩對決、層層淘汰,選出最終勝出的 token。
勝出者的選擇過程暗中偏向特定模式,於是整段文字的「勝出 g 值序列」會帶有可檢定的統計特徵。偵測端拿到一段文字後,對這串序列執行統計檢定,就能回報「這段文字由 SynthID-Text 系統生成」的可能性分數。Google 已在 GitHub 公開水印嵌入與偵測的完整參考實作,讓外部研究者可以重現論文結果,這也是這套方案可信度有別於閉源宣稱的原因。
也因為只動抽樣、不動文字表層,水印不需要多輸出任何 token,文字被複製貼上後訊號依然跟著內容走,讀者端則完全無感。這三個特性——不改表層、不加 token、不怕複製——正是它能被推向全系統預設的工程前提。
品質不變的證據:Nature 論文與 Gemini 的百萬級實測
「水印會不會讓文章變得奇怪」是最常見的疑慮,而這正是 Nature 論文花了最大篇幅處理的問題。SynthID-Text 屬於「非失真」(non-distortionary)設計:錦標賽規則被刻意設計成不改變輸出的整體機率分布,因此在論文的評測中,水印文本與無水印文本在品質評分上無法區分;在 Gemini 的線上實驗裡,數以百萬計的真實互動同樣沒有觀察到品質退化。Anthropic 的官方口徑與此一致:水印不影響 Claude 的輸出品質,也不增加額外成本。
從成本結構看原因很直觀。水印的運算發生在取樣階段——多出來的只是 g 個候選之間的一層對決,相對於模型本身動輒數十億參數的前向計算只是零頭。對 API 使用者來說,計費以 token 計,水印不產生任何額外 token,帳單與回應速度都不改變。換句話說,這是一次幾乎零邊際成本的透明度升級,這在合規工程裡相當少見。
為什麼是現在:歐盟 AI 法案第 50 條
把日期對起來看,這波水印的觸發點非常清楚。歐盟執委會的官方指引明載:《AI 法案》第 50 條自 2026 年 8 月 2 日起適用,對特定 AI 系統的提供者與部署者課予透明度義務。其中對生成式 AI 提供者的關鍵要求,是以機器可讀的形式標記合成內容,讓下游平台與使用者得以辨識「這是 AI 生成的」。
Anthropic 簽署的《AI 生成內容透明度實務守則》正是執委會為協助業者遵循這些義務而設計的框架。在工程選擇上,Anthropic 沒有為歐盟單開一條合規分支,而是把水印做進所有新模型的預設輸出、全球一致——對在多個司法轄區部署的企業來說,同一個模型只有一種行為,整合與稽核的負擔反而更低。這個「合規驅動、全球交付」的路徑,也可能成為其他供應商面對類似法規時的參考模板。
從 Gemini 到 Claude:水印走向產業預設
放在產業版圖裡看,水印正在從單一公司的實驗變成前沿模型的預設配備。Google 的 Gemini 率先以 SynthID 標記文字輸出;Anthropic 的 Claude 是第二家把文字水印推到全系統等級的前沿實驗室;OpenAI 也在其內容來源證明公告中說明,支援的語音輸出同樣採用 SynthID 水印。水印與 C2PA 類的簽署 metadata 是互補關係:metadata 附著於檔案,轉存或截圖時容易被剝除;水印則織進文字本身的統計結構,跟著內容走。Claude 的做法是兩者並用。
需求面也真實存在。從偽造學術文獻到內容農場,AI 生成內容混入資訊生態的案例早已氾濫,例如宣稱「100% 人類撰寫」卻被調查踢爆全程 AI 代寫的論文代工網站。當鑑別成本高到人類編輯無法逐一負荷,機器可讀的標記就成了唯一可規模化的第一道防線——前提是偵測端跟得上。
偵測的但書:測不到水印,不代表是人寫的
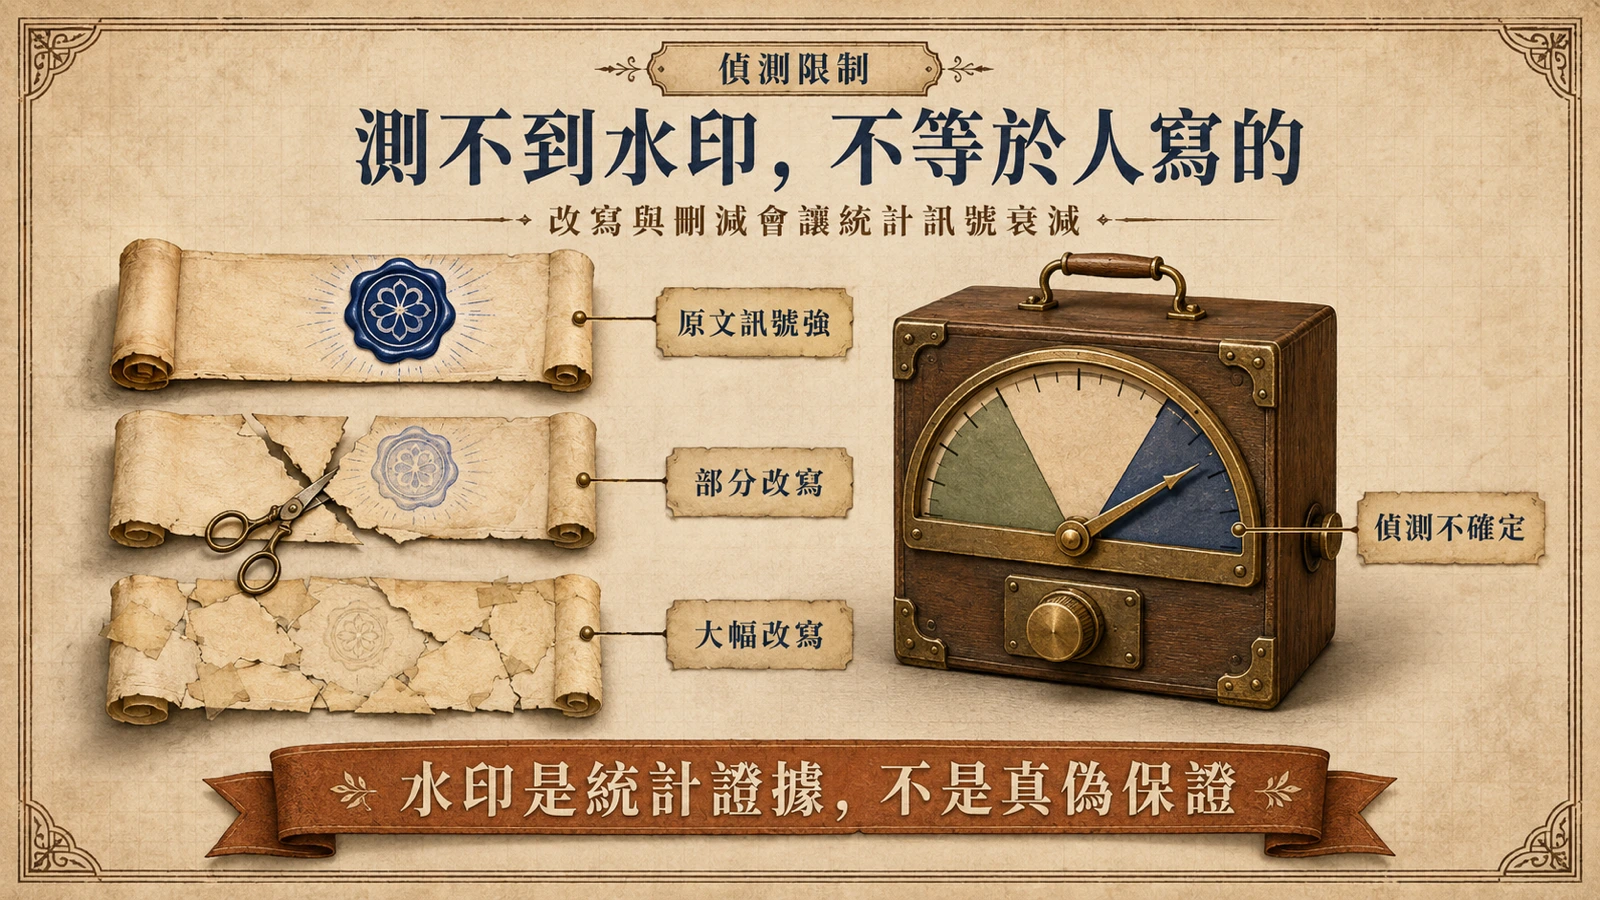
但水印不是真偽法庭。Claude 說明中心特別提醒:未偵測到標記,並不代表該內容不是 AI 生成或處理過的——水印訊號會隨改寫、翻譯、刪減而衰減,偵測回傳的也是可能性分數,而非二值保證。換句話說,「測到水印」是強而有力的證據,「測不到」什麼都不證明;把後者當成「這是人寫的」免死金牌,是對這套機制最危險的誤用。
另一個現實限制是偵測管道。水印設計上需要專門工具判讀,目前偵測能力主要掌握在模型提供方端;企業稽核、平台與獨立研究者能否取得、以什麼條件取得偵測管道,決定這套機制最終是公共的內容鑑識基礎設施,還是平台自家的私有稽核工具。此外,已公開的參考實作與後續理論分析都指向同一個結論:面對刻意的大幅改寫攻擊,任何統計式水印都有其耐受上限,水印應是分層鑑識的一環,而不是唯一關卡。
對開發者與內容團隊的實際影響
對直接使用 Claude API 或產品的開發者,這次變化幾乎零工時:水印在模型端自動生效,呼叫方式、計費與 token 計數都不變。真正要調整的是下游假設——如果你的產品會把 Claude 的輸出再改寫、重組後發布,就應假設水印訊號會隨之衰減,不要把它當成唯一的溯源依據;需要強溯源的場景,應搭配檔案層的簽署 metadata 與流程紀錄一起設計。
對負責內容治理的團隊,比較務實的態度是把「來源水印+簽署 metadata」視為新的可採購能力,寫進對模型供應商的要求,同時為無法依賴水印的情境(人力撰寫、第三方模型、已被改寫的內容)保留人工與程序性查核。後續值得追蹤三個指標:其他模型供應商是否跟進採用 SynthID 或相容方案、偵測工具是否對第三方開放,以及水印在真實改寫攻擊下的存活率數據。
回到整體圖像:這次上線把「這段文字是不是模型寫的」從純主觀判斷,變成可機器檢定的統計問題——在 AI 內容占比持續攀升的資訊環境裡,這是方向正確的一步;但只要記住官方自己寫下的但書「未偵測到標記不代表內容非 AI 生成」,就不會把統計證據誤當成真偽保證。