六款模型一次開齊:K2 Horizon 是什麼
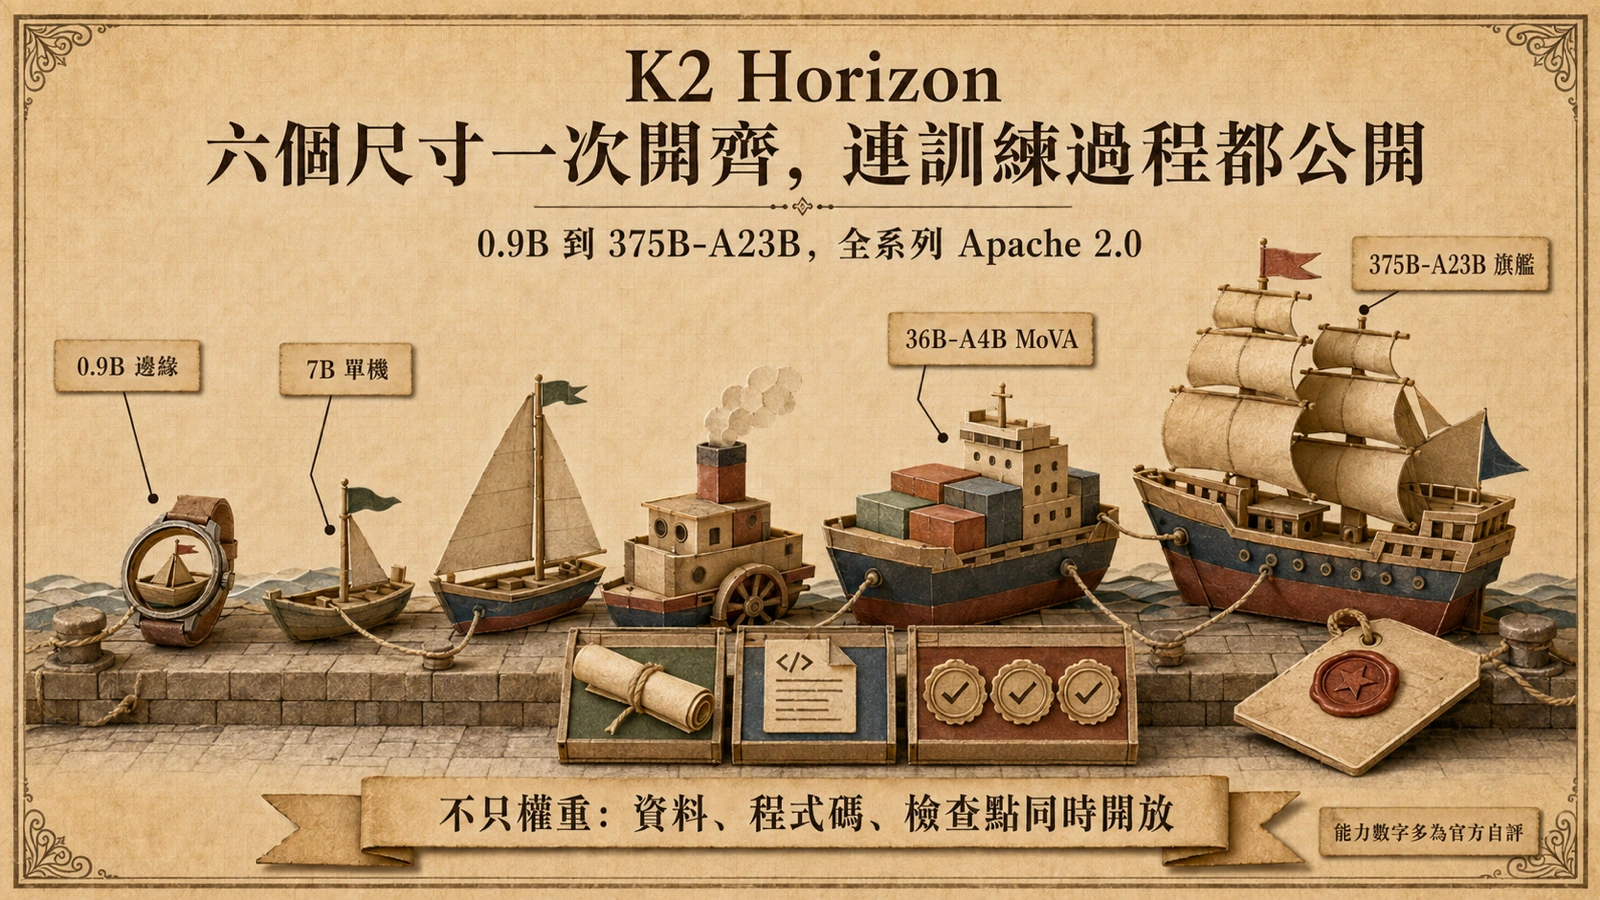
阿拉伯聯合大公國的 MBZUAI(穆罕默德・本・扎耶德人工智慧大學)旗下基礎模型研究院 IFM(Institute of Foundation Models)在 2026 年 9 月 3 日釋出 K2 Horizon 系列,一次開齊六款模型:0.9B、3.7B、7B、32B、36B-A4B 與 375B-A23B,全數以 Apache 2.0 授權開源。官方發布新聞稿以「業界最大的全開放模型艦隊」形容這次釋出,並在標題裡點出真正的差異所在:權重之外,連程式碼、訓練資料與方法論都一併交付。
六個尺寸都在 Hugging Face 的 IFM 組織下各自開設儲存庫,從命名就能讀出家族結構:0.9B、3.7B、7B 與 32B 是密集模型,36B-A4B 與 375B-A23B 則是混合專家(MoE)架構——名稱裡的「A4B」「A23B」標示每個 token 實際活躍的參數量。這種「總參數很大、活躍參數很小」的設計,是近兩年開源陣營追趕閉源旗艦的主要槓桿:容量用參數總量堆高,推理成本卻按活躍參數計算。
先釐清一個名稱陷阱:K2 Horizon 與 Moonshot AI 的 Kimi K2、Kimi K3 都掛著「K2」,但兩者是不同機構的不同系列。K2 Horizon 出自 MBZUAI 的 IFM,釋出內容與授權安排完全獨立,搜尋資料與引用時別混為一談。
旗艦 375B-A23B:每個 token 只出動 23B 參數
旗艦成員的375B-A23B 模型卡開宗明義寫著:「375B parameters and runs 23B per token, with a 512K context window」——3,750 億總參數,每生成一個 token 只活化 230 億,上下文視窗 512K。這三個數字放在一起,就是 MoE 的核心算計:模型把知識拆進眾多「專家」模組,推理時由路由器只挑少數幾位上工,於是記憶體要裝下 375B 的容量,單步計算量卻接近一個 23B 模型。
512K 上下文的另一層意義是長任務。代理式工作流程往往要一口氣讀完整批文件、追蹤數十輪工具呼叫的狀態,上下文視窗直接決定模型「記不記得住」。家族裡的密集大尺寸也跟上同一規格:32B 模型卡寫明「K2-Horizon-32B-Stage1 是這個家族的大型密集成員:32B 解碼器模型,具備 512K 上下文視窗」,與旗艦同級。
「Stage1」這個命名值得多看一眼:它暗示模型是分階段訓練、分階段釋出的產物,而不是一次訓完只交付終點。這個細節與整個系列「開放訓練生命週期」的定位互相印證,後面會再展開。
MoVA 新架構:36B-A4B 用 4B 活躍參數換效率
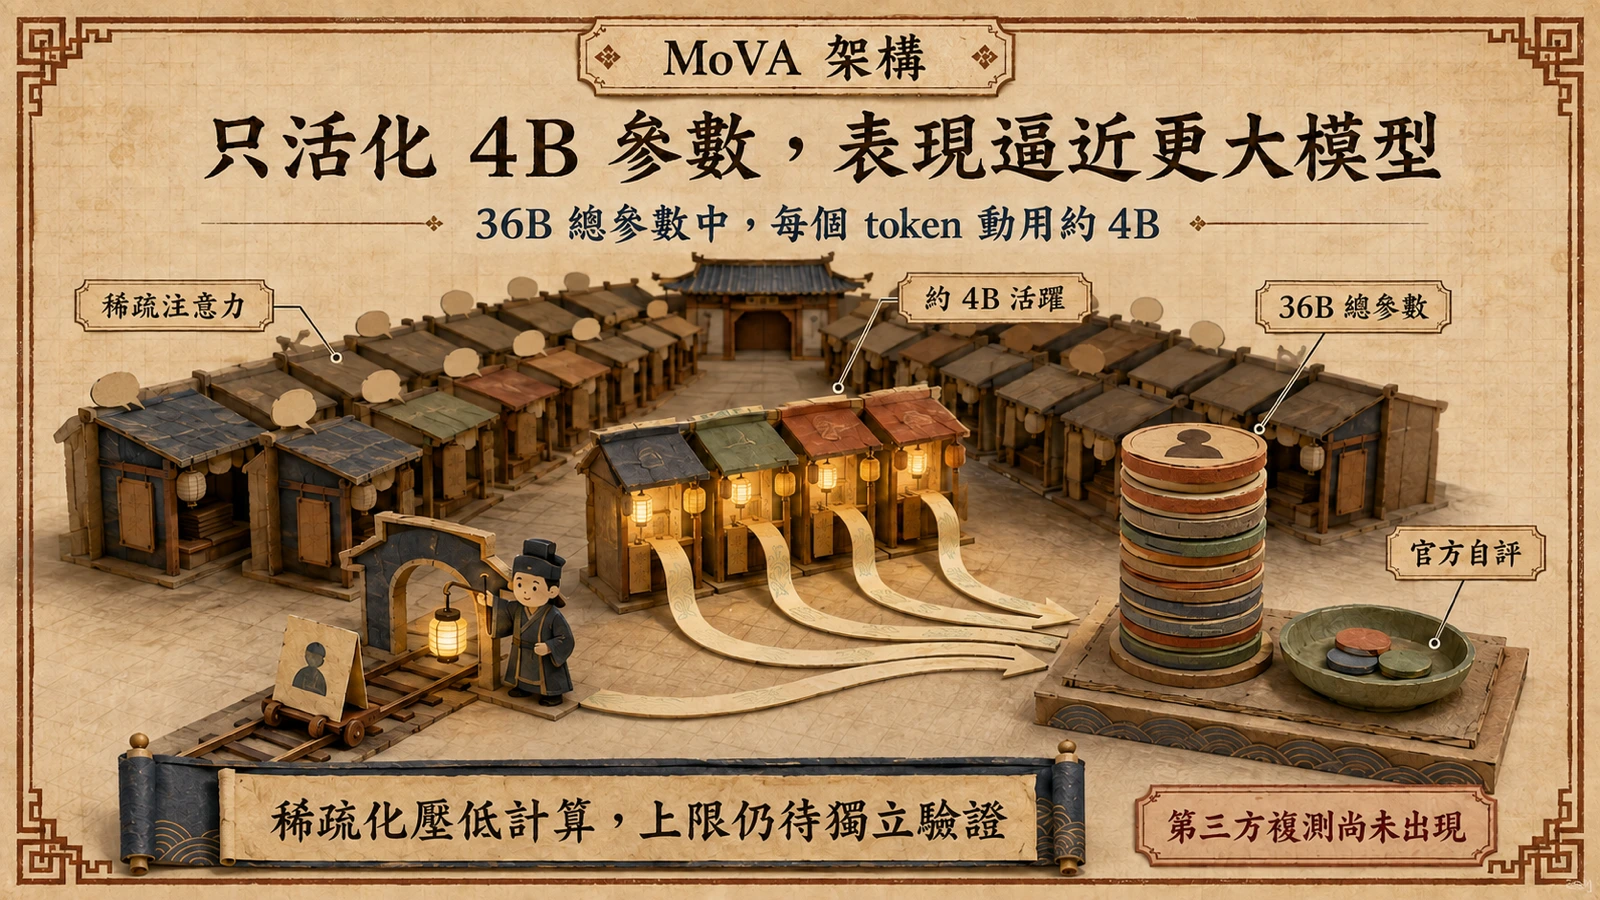
家族裡最有實驗性的是 36B-A4B。它的模型卡把自己定位為「K2-Horizon 家族的稀疏成員:採用 Mixture-of-Values 注意力(MoVA)的混合專家模型」。官方新聞稿進一步宣稱,這款搭載 MoVA 的 36B(活躍 4B)模型,「只活化 4B 參數就勝過許多更大的模型」。
要理解它在賭什麼,得先回到注意力機制。語言模型生成每個 token 時要回頭「看」前文所有 token,這種兩兩相看的成本隨序列長度平方成長,是長上下文最貴的一環。先前世代的稀疏化多半把刀口放在前饋層——把全連接層拆成專家、每次只動用少數;MoVA 則把稀疏化再往注意力層的 value 計算推進,讓「看前文」這件事本身變便宜。官方把它包裝成「每個活躍參數的效益」代表作,對記憶體預算有限、又想要長上下文的部署場景,方向明確。
不過這裡要踩剎車:MoVA 的架構細節與完整評測設定,目前主要出自 IFM 自家的模型卡與新聞稿,尚未看到後續論文或獨立複測。「勝過許多更大的模型」是發布方的比較句式,比較對象與評測集都由發布方選擇,採用前宜視為方向性訊號而非定論。
不只給權重:訓練資料、程式碼與檢查點全公開
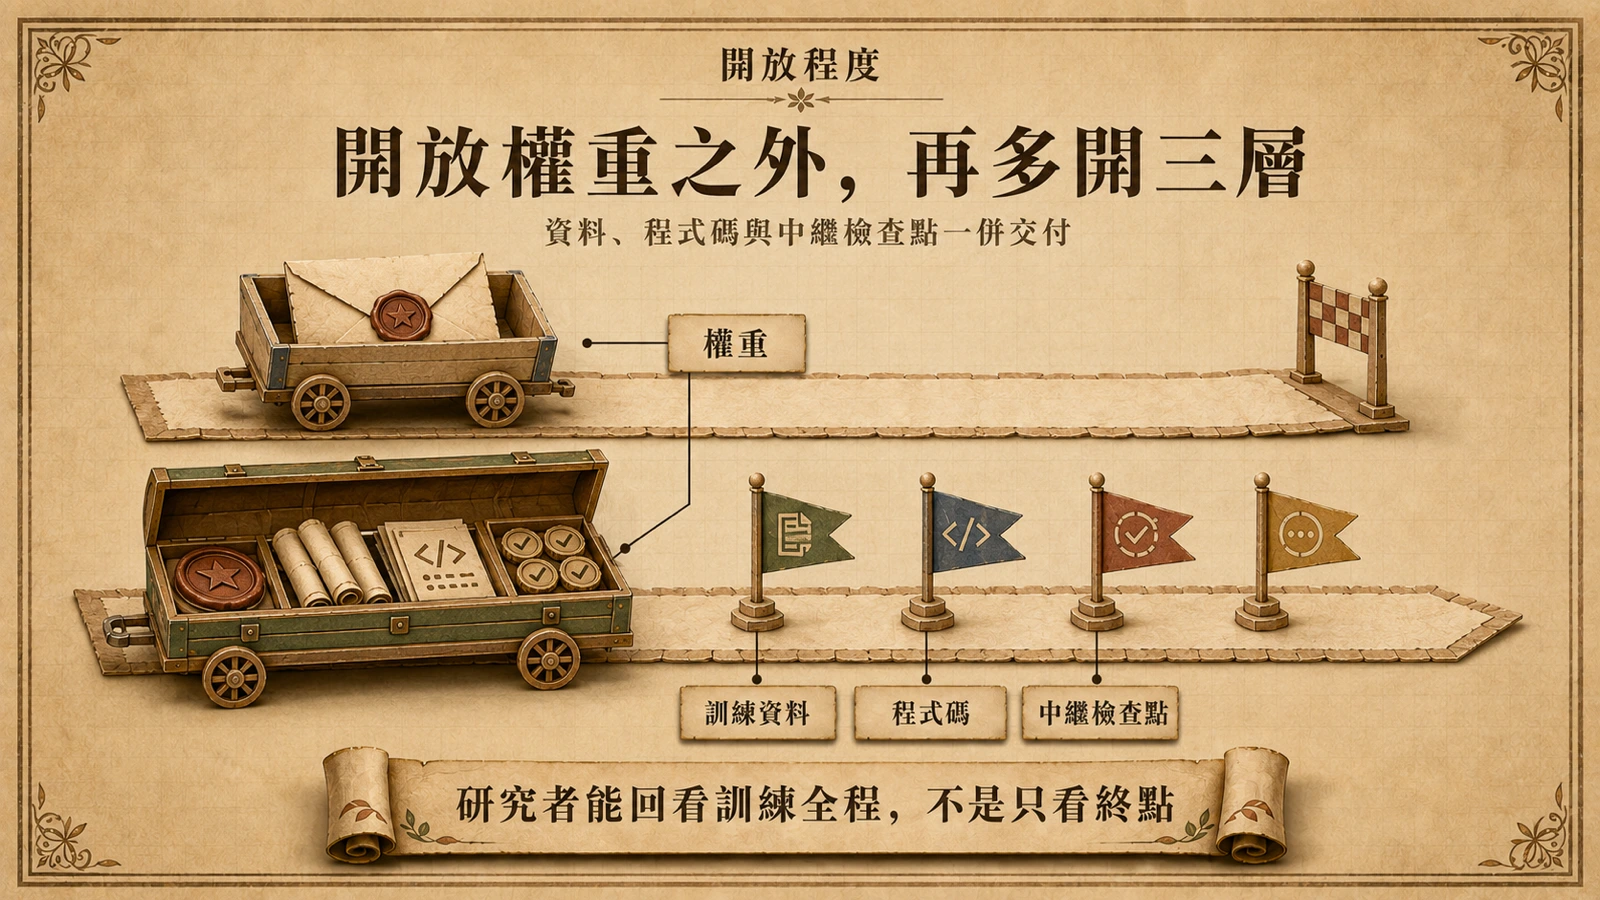
這次釋出真正罕見的地方,不在模型單筆分數的高低,而在「開放到哪一層」。市面上多數「開源模型」實際上只開放權重;K2 Horizon 的新聞稿直接在標題寫明,這支艦隊連程式碼、訓練資料與方法論都包含在內。旗艦模型卡也說明已釋出最終檢查點,中繼檢查點(intermediate checkpoints)列在釋出範圍。
連推論引擎生態都把它當成「可研究訓練過程」的家族來接待:vLLM 官方 recipes對 K2-Horizon 的介紹寫道,這是「為透明的基礎模型研究、分階段檢查點分析與實際部署而生的開放權重 IFM 模型家族」。對研究者的意義很具體:你可以沿著檢查點回看某種能力是訓練到哪個階段出現的、資料配比怎麼影響結果,而不是只能對著最終權重做事後解剖。
對企業與開發者,這多給了一層保險:訓練配方與資料在手,要做續訓、分支或安全審查,不必從黑盒子裡用猜的。當然,「公開」與「可用」之間仍有距離——訓練資料的實際完整性、格式是否真的能重跑,都要等社群實際拆解後才算數。
從邊緣到企業:六個尺寸的部署邏輯
六個尺寸對應新聞稿的另一句定位:「從邊緣到企業皆可部署」。0.9B 到 7B 的三個小尺寸,瞄準的是手機、眼鏡、手錶這類記憶體受限的裝置;32B 與 36B-A4B 適合單機與企業內部伺服器;375B-A23B 則是多卡叢集的旗艦檔位。尺寸階梯不是能力分級,而是部署位置的選擇題。
小尺寸也不是附贈品。3.7B 的模型卡頂部就把 K2-Horizon-3.7B 與多個參考模型放進同一張比較圖,並以表格交代每個比較對象——把「小模型到底跟誰比」攤開給讀者看,在模型發布裡算是相對少見的誠實做法。
部署路徑同樣已就位:vLLM recipes 為 32B、0.9B 等成員提供了部署指南;IFM 組織下也看得到 GGUF 量化版本的儲存庫,而 GGUF 正是 llama.cpp、Ollama 等本機推理生態的慣用格式,意味著消費級硬體跑小尺寸、工作站跑中尺寸的路徑是通的。開發者的務實起手式:先按硬體預算選尺寸,照 vLLM recipes 的指南落地,需要研究訓練過程時再回頭撿檢查點。
開源模型版圖:阿聯研究機構的進場位置
把 K2 Horizon 放回地圖上,它代表開源競賽的第三極。過去一年,開放權重的主要籌碼集中在兩個陣營:中國的 Qwen、Kimi、GLM、DeepSeek 系列,以及美國的開放權重動作,例如我們先前介紹過的 Muse Glimmer 30B 本機代理模型。MBZUAI 的 IFM 以「全開放」為差異化進場,把競爭軸線從「誰的權重更強」推到「誰開得更徹底」。
這個策略有其時機。我們先前的季節盤點指出,開源模型與閉源前沿的差距正在反向收斂,開源陣營的發布節奏持續加快。在這個脈絡下,一家研究機構願意連訓練資料與檢查點一起開,等於把「可重現性」本身變成競爭項目——對學界與需要審計軌跡的公部門採購,這個吸引力可能比帳面分數更大。
對台灣與華文圈的開發者,這類全開放釋出的實際意義很直接:不必等地區服務開通、不受單一雲端計價約束,直接從 Hugging Face 取得權重與配方,在本機或自家機房落地。
分數先別全信:自評、缺口與追蹤指標
回到檢核面。這次釋出的大部分能力宣稱——「最大全開放艦隊」「勝過許多更大模型」「從邊緣到企業」——都是發布方自己的定位語,依據以新聞稿與模型卡為主,獨立評測機構的覆蓋還需要時間累積。模型卡上的比較圖表雖然把參考模型列得清楚,但評測集與比較對象的選擇權,仍然在發布方手上。
幾個值得追蹤的後續指標:其一,中繼檢查點與訓練資料是否如承諾完整落地、格式是否真的可重跑;其二,MoVA 架構有沒有後續論文與第三方複測,把「4B 活躍參數」的效率宣稱變成可重現的數字;其三,獨立排行榜對六個尺寸的實測分數,特別是小尺寸在邊緣裝置上的真實延遲與記憶體佔用。
對照組也清楚:同場競技的開源家族多半以「開放權重加技術報告」為上限,K2 Horizon 把籌碼加到資料與檢查點。如果這條「全開放」路線被市場驗證,壓力就會回到其他實驗室:下次釋出,只給權重還夠不夠?這個問題比任何單一基準分數,更是這次發布值得記住的原因。