十張榜單,為什麼不能直接平均
大模型排行榜從來不缺。主流實驗室各自發布、第三方機構獨立評測、垂直場景任務榜層出不窮,幾乎人人都能跑一份自己的榜。問題不在於榜不夠多,而在於這些榜根本不能直接相加。
開發者「數字生命卡茲克」在發布文章裡點出三個會讓「取平均」破功的結構性問題。第一是規模不可比:同一個第五名,在只有十個模型的小榜裡只是中游,在兩百個模型的大榜裡已是頂尖,兩者含金量天差地遠。第二是領先幅度不可比:一張榜上第一名領先三成,另一張榜上第一名只多零點零一分,直接平均會把這兩種差距當成同一回事。第三是缺測:有的榜更新慢半拍,有的榜根本不跑某些模型,於是同一個模型可能在十張榜裡只出現六張——填零不公平,填平均會放大它參加過的那幾張榜,只算參加過的又會扭曲權重。
這正是聚合榜單最棘手的地方:想把多家結果匯成一個綜合判斷,卻沒有一個誠實的方法把分數直接加總。
把排名問題換成「對打」:Bradley-Terry 登場
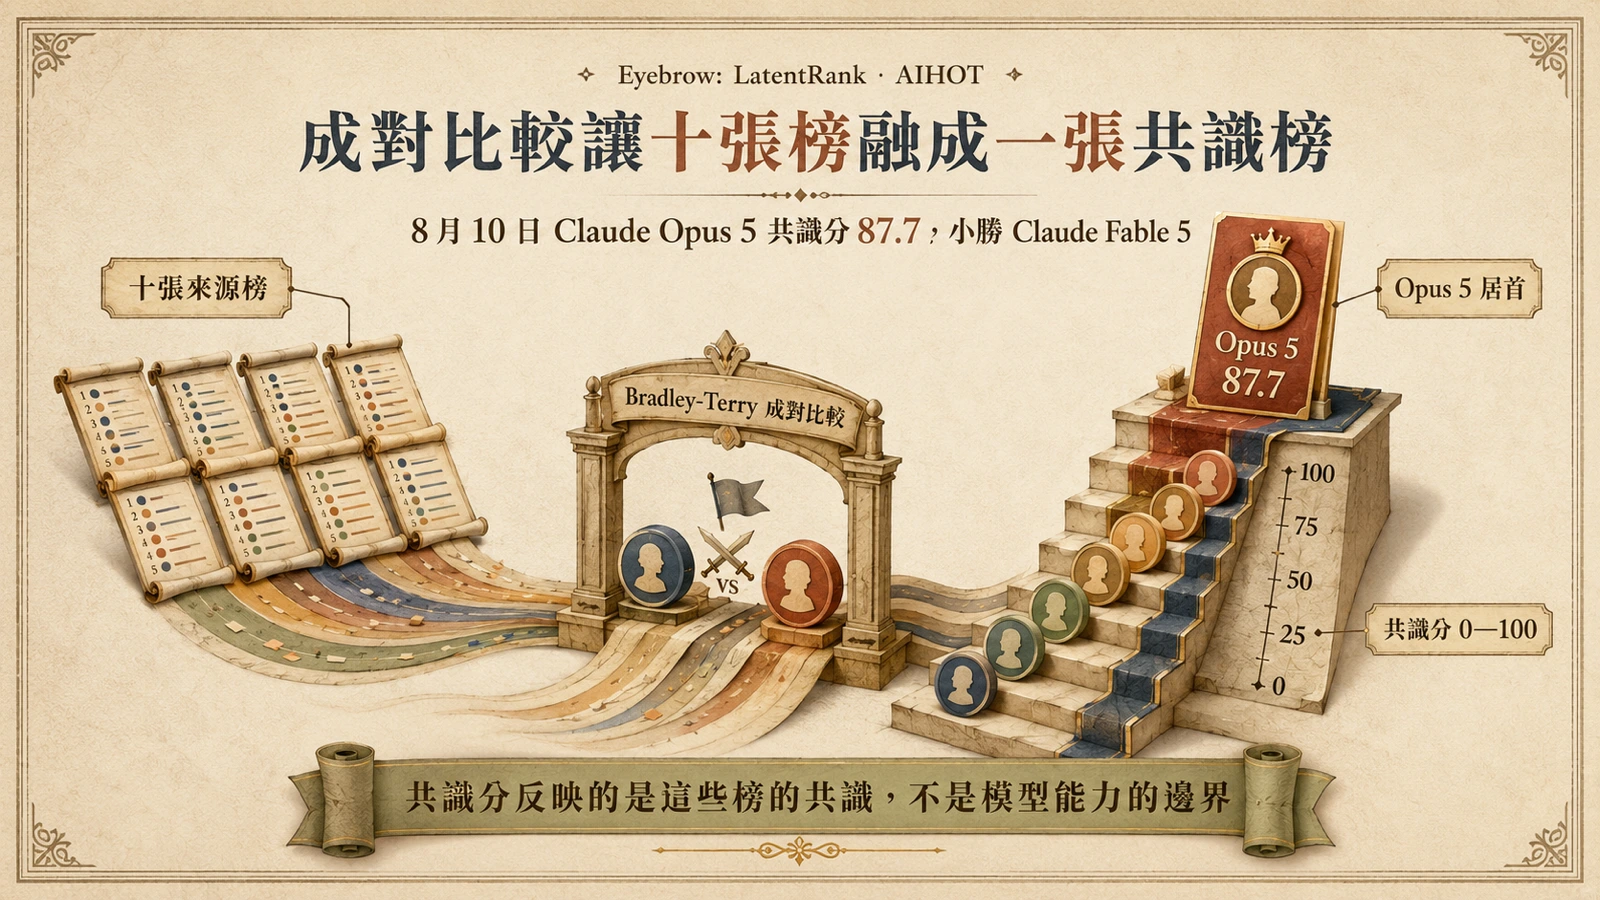
LatentRank 的解法是換一個問題。與其問「每張榜給這個模型幾分」,不如問「兩個模型在同一張榜上同場較勁,誰贏」。只要兩個模型同時出現在同一張榜單裡,名次高的記一勝、低的記一負、平手記和,再把所有榜裡真實發生過的勝負和匯進一張巨大的對戰網,回頭反推每個模型背後那個看不見的能力值。這套底層方法,作者稱之為 Bradley-Terry 並加入先驗。
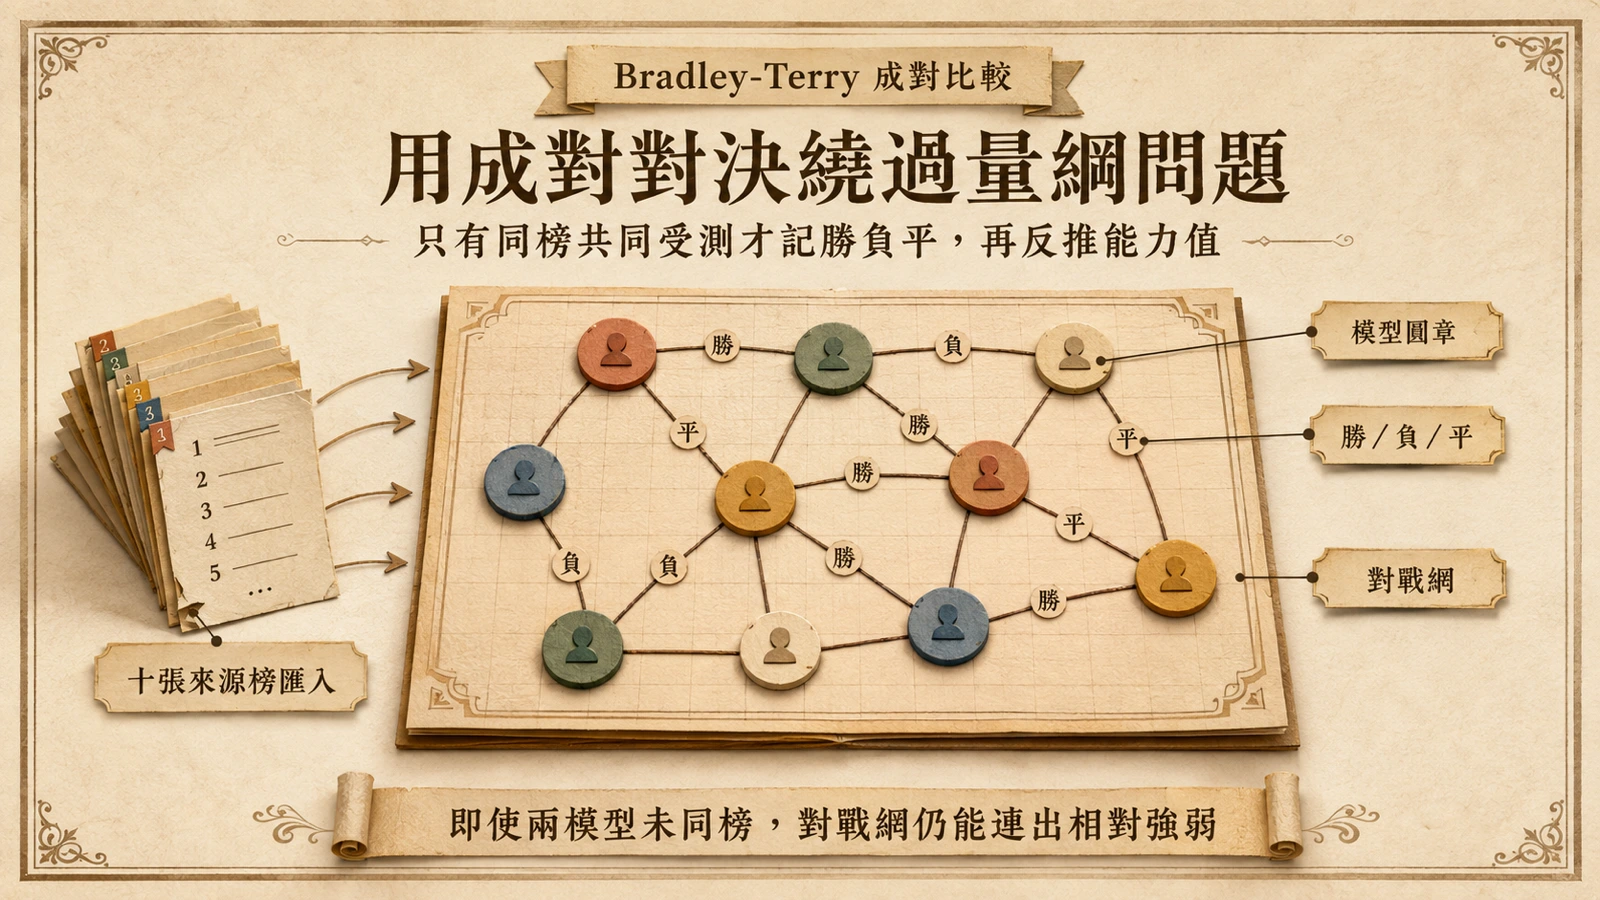
Bradley-Terry 不是新發明。它是一個用於成對比較的機率模型,標準定義是估計「i 勝過 j」的機率為 pᵢ/(pᵢ+pⱼ),其中 p 是每個項目背後的正實數能力值。它最為人知的化身是西洋棋與電競的 Elo 等級分:在特定刻度下,Bradley-Terry 與 Elo 數學等價。作者本人也是在與模型反覆討論後,從教育測驗(用答題結果反推潛在能力)與電競匹配(Elo、微軟的 TrueSkill)兩個領域找到這條路。
成對比較最大的好處,是繞開了量綱問題。不同榜的原始分一個是百分制、一個是勝率、一個是等級分,本來就不能加;但「誰在這張榜上名次更高」是任何榜都說得清楚的二值訊號。即使兩個模型從未在同一張榜出現,只要它們各自和同一批對手交過手,整張對戰網仍能把它們連起來,推斷出相對強弱。
先驗、證據預算與錨點模型
把成對比較搬到大模型榜上,會冒出電競裡不存在的麻煩:來源之間會重疊、小榜的偶然性更強、證據太少的模型可能剛好連贏幾場就被算出一個離譜的能力值。LatentRank 為此加了三層控制。
第一層是來源權重。根據 AIHOT 排行榜頁面的演算法說明,只在同一榜共同參評的模型之間記勝負平;每家獨立來源固定占一成權重,同一營運方的多張榜共享這一成,再用全部真實對戰估計綜合能力並映射到零到一百分,不同量綱的原始分不會直接相加。
第二層是先驗與證據預算。作者加入先驗來限制小樣本結果的評分,並設計「證據預算」機制,讓只參加少數榜的模型不至於因少數幾場勝負暴衝。與此並列的是「評測完整度」指標,按來源組權重、榜單組內份額與已評子項份額求和——少測不補零、不扣分,也不把空缺權重轉給別榜,百分比越低只代表證據越少、名次越不確定。
第三層是錨點。為了把能力值歸一到百分制,作者凍結一組錨點模型來定義共識分的刻度,讓不同時間點算出的分數有可比的基準。這套實作方式,作者讓模型取了個名字:LatentRank。
8 月 10 日的共識榜:Opus 5 小勝 Fable 5
實際成果放在 AIHOT 大模型排行榜,第一批聚合十張公開榜,8 月 10 日上午八點二十更新的前五名如下。
| 排名 | 模型 | 共識分 | 評測完整度 |
|---|---|---|---|
| 1 | Claude Opus 5 | 87.7 | 73.1% |
| 2 | Claude Fable 5 | 86.7 | 93.8% |
| 3 | GPT-5.6 Sol | 85.7 | 95.0% |
| 4 | Kimi K3 | 83.7 | 95.0% |
| 5 | GPT-5.5 | 79.5 | 95.0% |
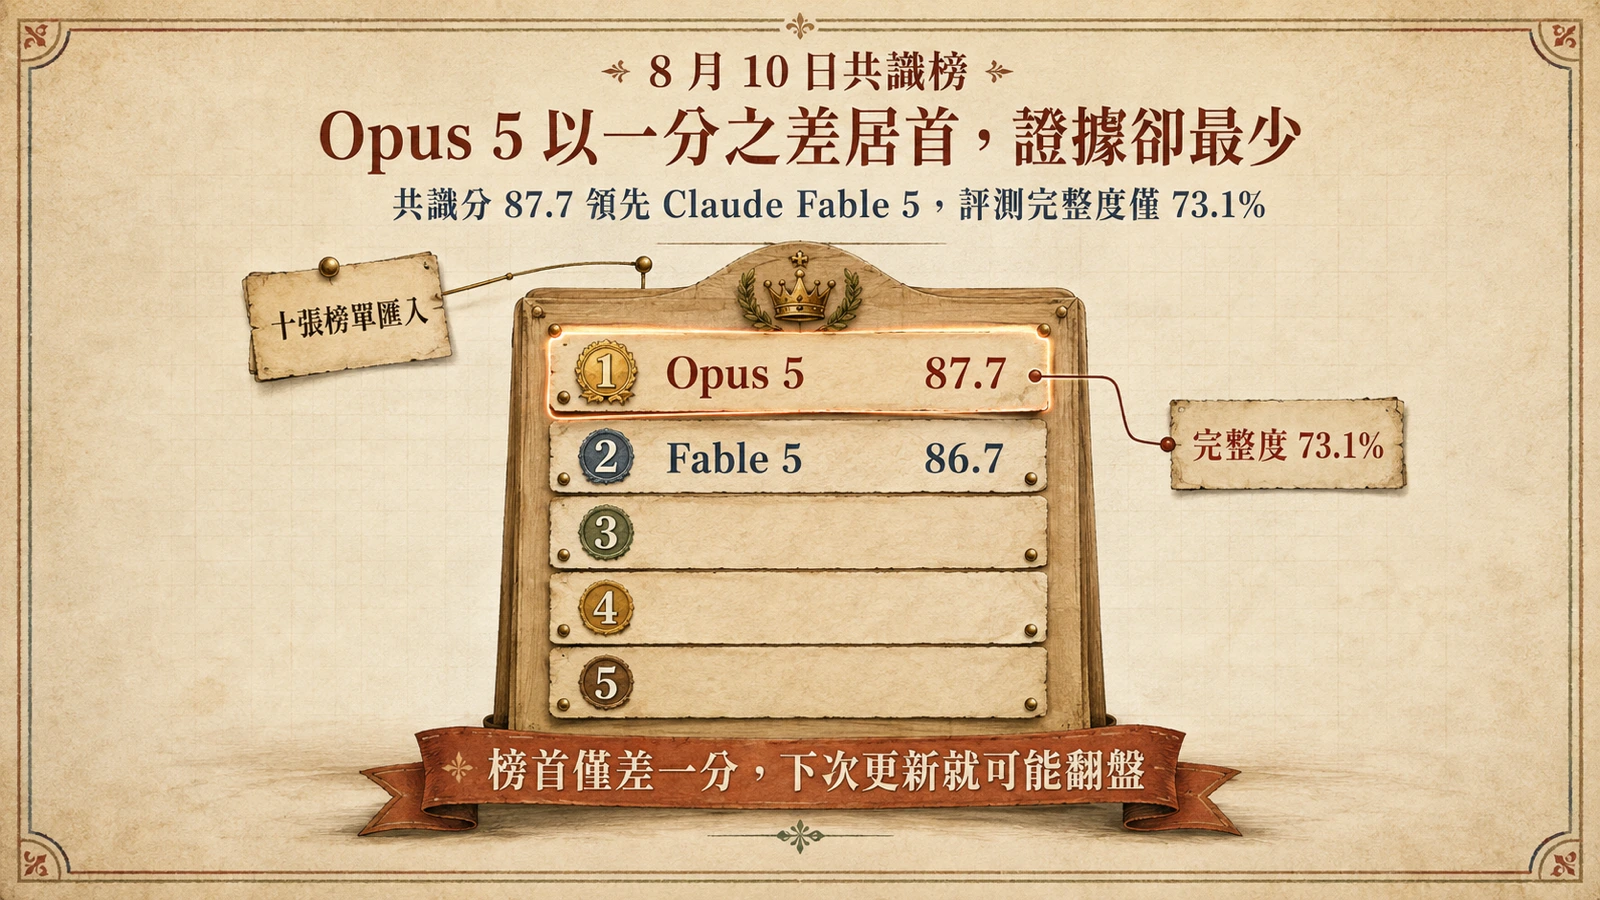
值得細看的是第一名與第二名的對比。Claude Opus 5 以 87.7 暫居榜首,只比 Claude Fable 5 的 86.7 高出一分,但兩者的評測完整度差距懸殊:Opus 5 只覆蓋七成三的評測子項,是前五名裡最低的;Fable 5 則覆蓋九成四。換句話說,Opus 5 的榜首建立在較少證據之上,名次的不確定性也最高——這正是 LatentRank 把完整度獨立披露的用意。作者對這個結果也感到意外,推測原因在於程式相關評測上 Opus 5 表現較強,加上 Fable 5 在某些任務一跑就降級,反而拉低了分數。若要把這組共識分拉回可重跑的單一評測證據,可對照 Kimi K3 在 AISI/CAISI 網路能力評測的實測結果,那是資安任務面向的獨立測試,與共識分互為補充而非替代。
該怎麼讀這張榜:它不是新標準
LatentRank 的方法論是紮實的——成對比較繞開量綱、先驗控制小樣本、錨點固定刻度,這套思路與主流盲測排行榜慣用的成對比較統計基礎同源。但它有自己的邊界,讀者不宜把它當成權威標準。
首先,它是單一開發者的第一版週末專案,聚合的十張榜是作者個人信任的選擇,換一批來源榜、結論就會變。其次,共識分反映的是「這些榜的共識」,而不是模型真實能力的邊界——作者在文章裡也強調這一點,並把所有原始榜單、各家名次與原始分數都攤在網頁上供查核,另附完整規則頁說明計算細節。最後,榜首與亞軍只差一分、且榜首覆蓋度偏低,這種微小差距在統計上未必穩定,下一次更新就可能翻盤。
對追蹤前沿模型的人,LatentRank 的價值不在給出唯一答案,而在提供一個方法透明、證據可回查的綜合視角,把「該看哪張榜」這個日益難答的問題,收斂成一個能拆開檢視的共識分。