30 秒單鏡生成與多輪續寫
ByteDance 旗下 Seed 團隊於 2026 年 7 月 31 日發表 Seedance 2.5,將其定位為新一代影片創作模型。這一代的賣點相當集中:單次生成最長 30 秒、且影像與聲音同步產出的影音內容。根據火山方舟的官方文件,相較前代,Seedance 2.5 的單次生成時長提升至 30 秒,讓一個鏡頭能一次說完,而不必把多段短片段硬拼起來。
把單鏡拉長只是起點。官方發布說明指出,使用者可透過多輪續寫逐段接續,把單次 30 秒的片段延伸成數分鐘的敘事;在這個延伸過程中,模型會維持主角、場景與敘事節奏的一致性,避免每接一段就「換了一個世界」。對需要長篇幅說故事的創作者而言,這代表可以在不手動剪接的情況下,把一個完整故事一次成型。
多模態參考:30 張圖、10 段影、10 段音
單次生成之外,Seedance 2.5 的另一條主線是「參考」。模型在官方說明中被描述為以基礎生成與參考生成為核心的新一代影片創作模型。實際能力上,使用者可在單次生成中輸入最多 30 張圖像、10 段影片與 10 段音訊作為參考素材,模型會整合這些素材的視覺構圖、場景、風格、角色與道具。
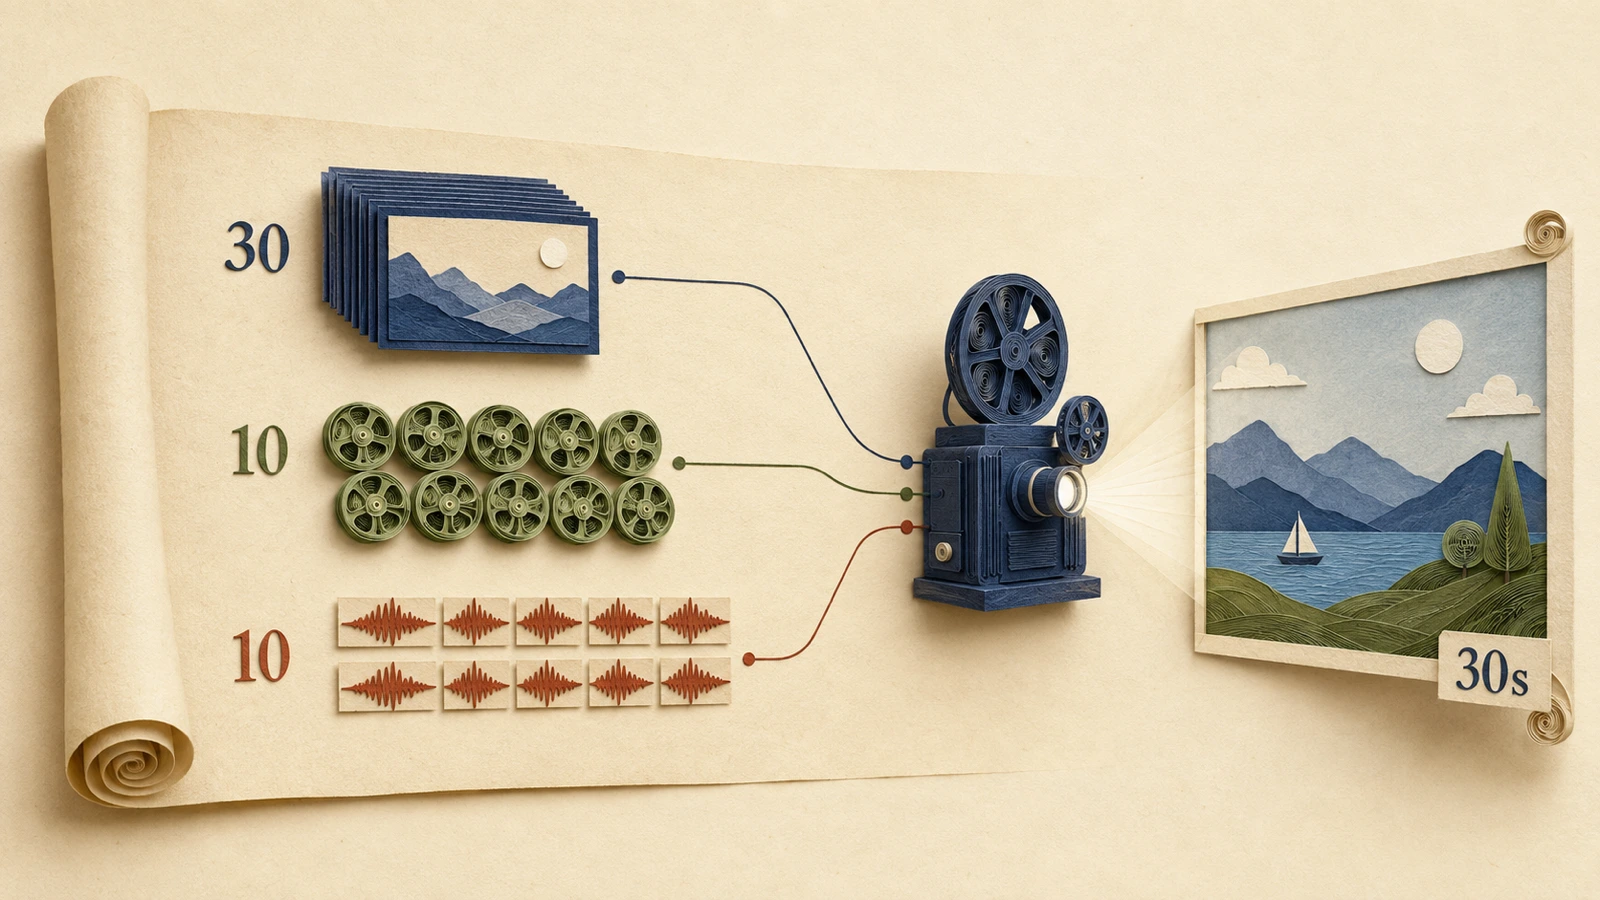
這意味角色與場景的外觀可以跨鏡頭維持一致——例如把同一個人物放進不同場景,或讓多個鏡頭共享一致的色調與風格,而不必反覆用文字描述同一張臉、同一件衣服。
時間戳鏡頭控制與去背、黏土模型編輯
Seedance 2.5 把「怎麼動鏡頭」也交給提示詞。官方列出時間戳級的鏡頭控制:使用者可在提示詞裡指定特定時間點的運鏡,例如推軌(push-in)、拉遠(pull-out)、弧形運鏡(arc)、甩鏡(whip-pan)與第一人稱視角(FPV),讓單段影片內的攝影機運動更接近分鏡表上的安排。
編輯能力同樣是這一代的重點。官方列出的編輯模式包括:以時間戳做精準內容編輯、綠幕去背(替換背景時保留主體,並對衣物、頭髮、步態與光線做物理感知的處理)、鏡頭視角編輯、參考式編輯,以及黏土模型(clay render)參考——後者用無紋理的 3D 模型來控制空間結構、人物姿勢、動作路徑與鏡頭角度,再疊加基於空間資料的物理光影,見〈Grok Imagine 魔術棒編輯〉。
延續 2.0 架構與已知限制
Seedance 2.5 並非從零另起爐灶,而是建構在 Seedance 2.0 的音視訊聯合生成架構之上;正因如此,2.5 能同步生成影音、並在多輪續寫之間維持音訊一致。在「影像、影片、音訊一起學」這個方向上,〈FLUX 3〉走了另一條統一多模態路線,兩者代表影音生成不同的優先序。
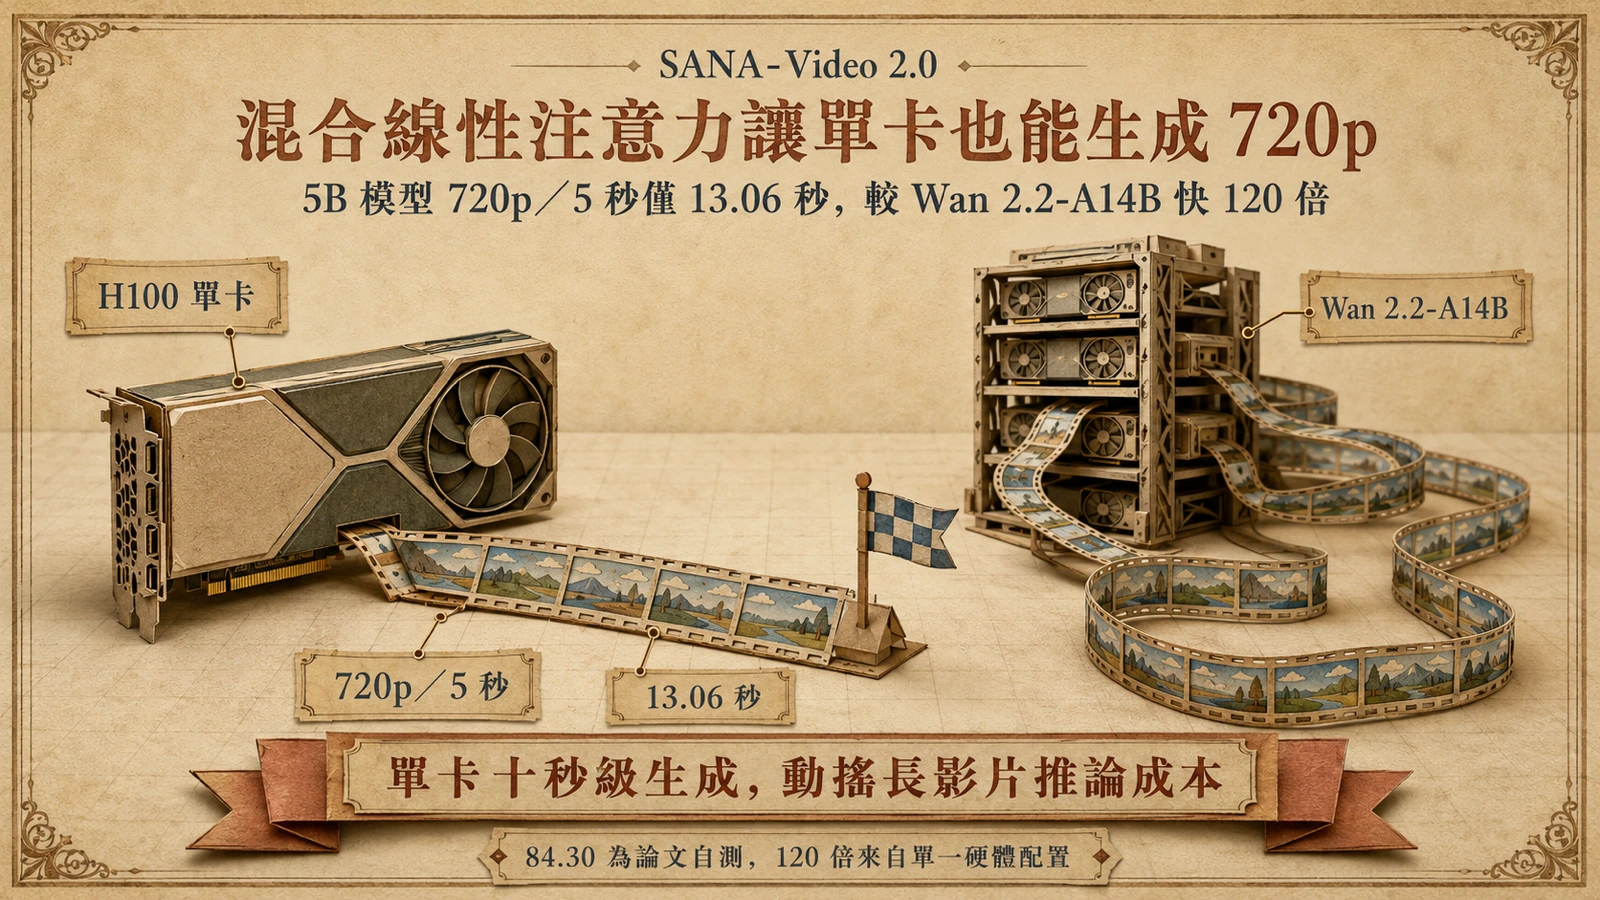
官方也坦承仍有短板。發布說明指出,模型在複雜動作的物理合理性、以及多個主體互動場景的穩定性上還有改善空間——這也是目前生成式影片共同的難題。Seedance 2.5 可在即夢 AI、豆包 Pro 上使用,API 則規劃透過 BytePlus ModelArk 提供(官方列為即將推出);在更廣的影片生成版圖裡,主打單卡推論效率的〈SANA-Video 2.0〉則代表了另一種以工程換成本的路線。