15 億美元和解獲最終批准
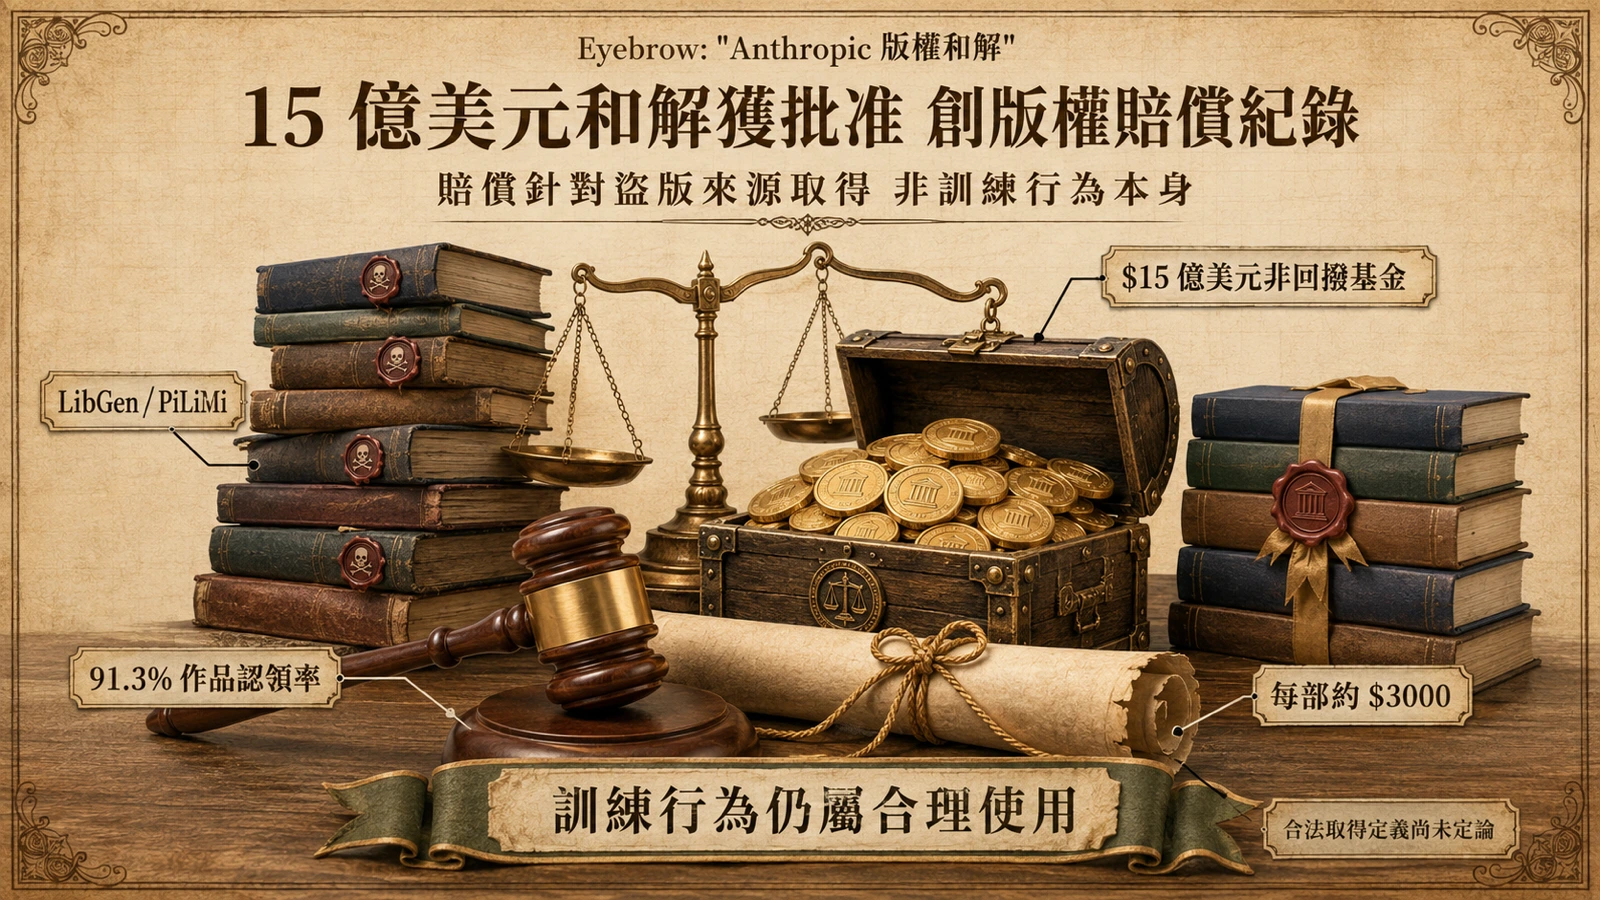
美國加州北區聯邦地方法院法官 Araceli Martinez-Olguin 於 2026 年 7 月 20 日簽署命令,正式批准 Anthropic 與圖書作者集體訴訟的和解協議。法院文件確認和解為「非回撥型」(non-reversionary)基金,規模 15 億美元,是集體訴訟史上最大的版權和解。訴訟起因於 Anthropic 在 2021 至 2022 年間從盜版資料庫 Library Genesis(LibGen)與 Pirate Library Mirror(PiLiMi)下載圖書,作為 Claude 模型的訓練資料。
作品認領率 91.3%、每部約 3000 美元
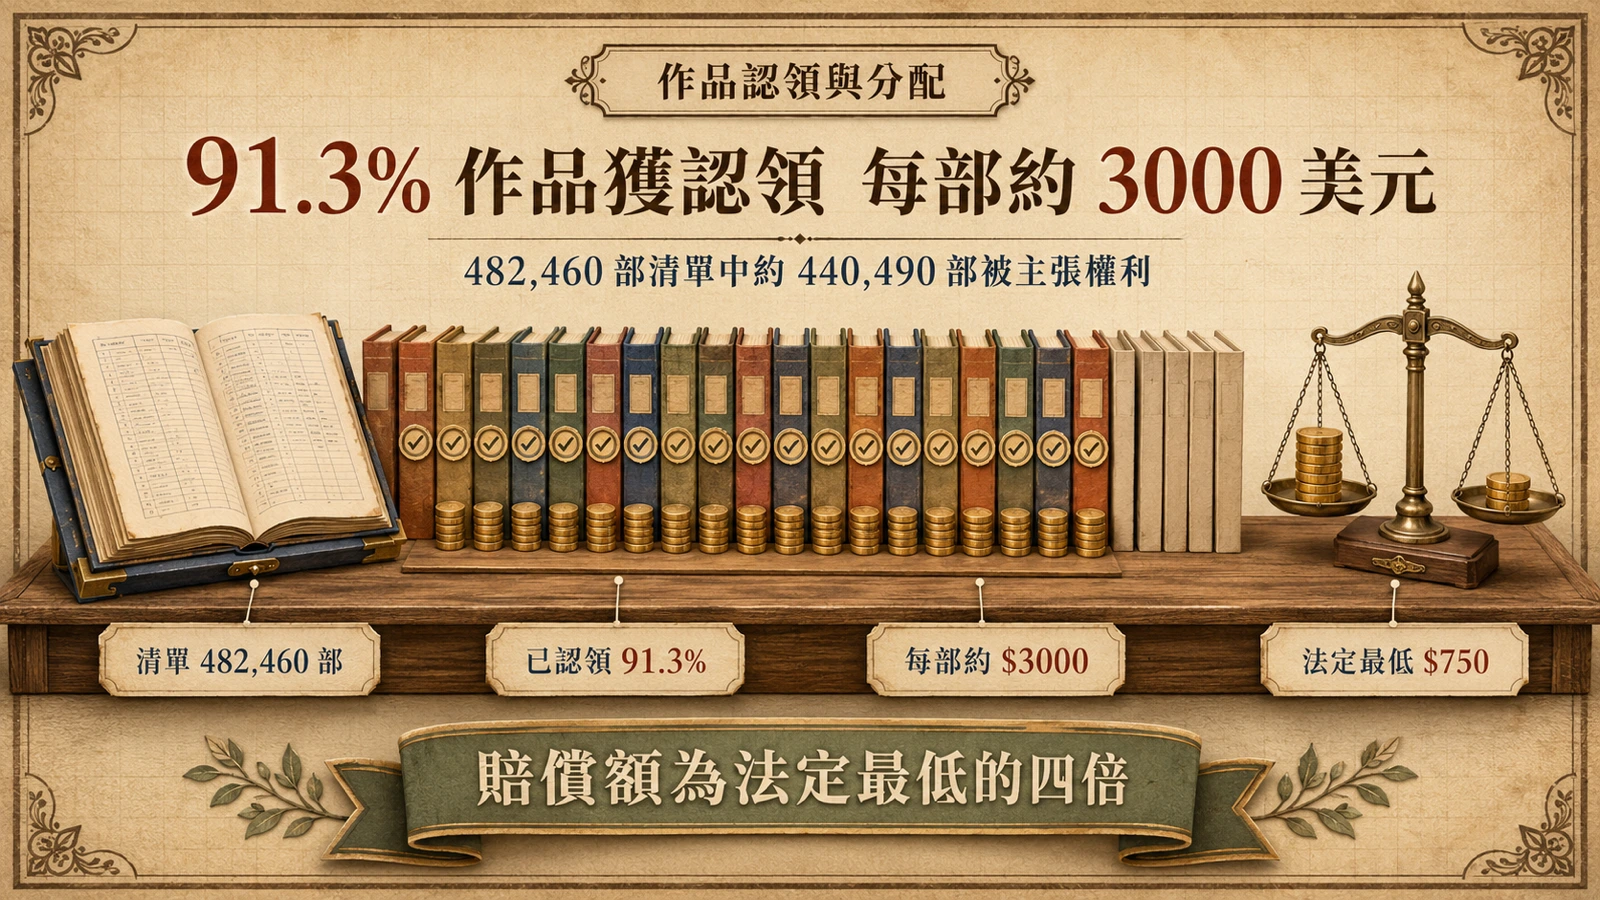
法院命令顯示,作品清單共計 482,460 部,截至 2026 年 4 月 16 日已有 91.3%、約 440,490 部被主張權利。每部作品預估可獲約 3000 美元,是法定最低賠償額 750 美元的四倍。Class Counsel 律師費用占基金 12.5%、約 1.875 億美元,訴訟支出另報銷約 297 萬美元。和解條款並要求 Anthropic 銷毀自 LibGen 與 PiLiMi 下載的所有原始檔案與副本。
賠的是盜版取得、非訓練行為
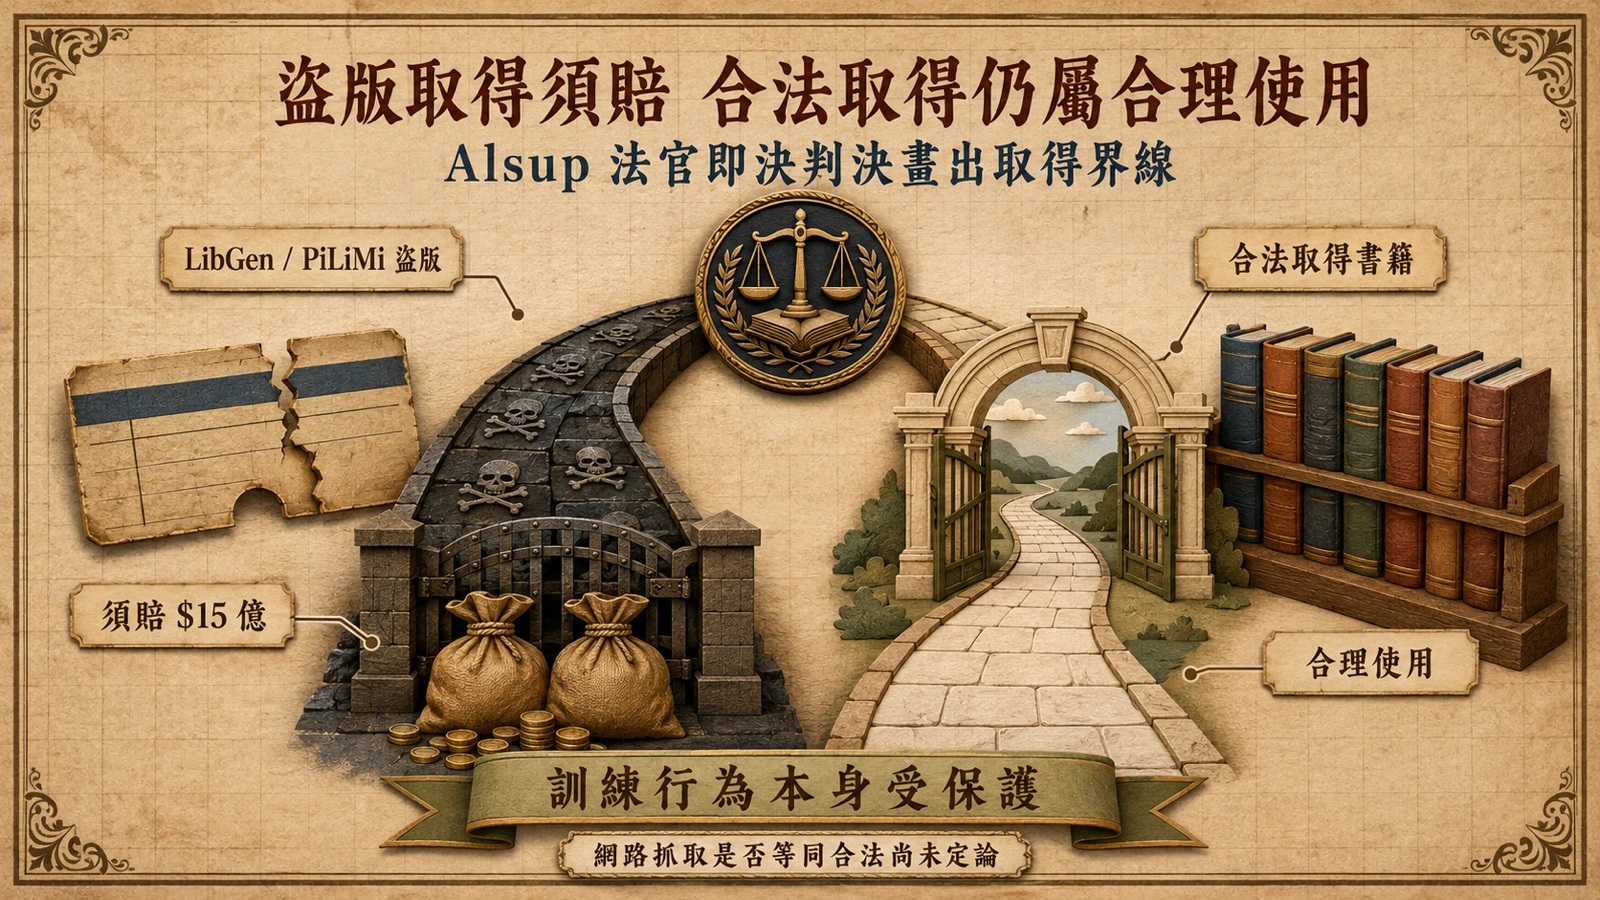
關鍵在於賠償標的是「盜版來源取得」,而非 AI 訓練行為本身。法官 William Alsup 先前在本案作出即決判決,認定在「合法取得」的書籍上訓練 AI 屬「變革性——極具變革性」的合理使用。作者方仍保留對於重製原作品的 AI 輸出內容,以及 Anthropic 未來行為的後續求償權。未經同意大量抓取網路內容是否等同「合法取得」,仍是法院尚未定論的開放問題,見〈The Numbers 停機重建〉。
合理使用判決留下的開放問題
Alsup 法官的即決判決為產業畫出一條關鍵界線,但界線之外仍是大片灰色地帶。判決明確保護的是「在合法取得的書籍上訓練 AI」這一行為本身,認定其具備「變革性——極具變革性」的合理使用性質;但「合法取得」的定義並未在和解中一併釐清。從圖書館購買、授權合約取得、到未經同意抓取網路公開內容,這些取得路徑的法律地位並不一致,法院至今未對最後一類給出明確見解。換言之,Anthropic 的 15 億美元買到的是對「盜版來源取得」這一明確過失的了結,而非對整體訓練資料策略的全面免責。作者方保留的兩項後續求償權——重製原作品的 AI 輸出內容、以及 Anthropic 未來行為——正是這條界線未來可能被重新測試的兩個入口。
與其他 AI 版權訴訟的對照
本案與同期進行的幾樁 AI 版權訴訟形成有意義的對照。《紐約時報》控告 OpenAI 與 Microsoft 的訴訟,爭點集中在新聞文章被用於訓練,以及輸出是否實質替代原報導;Meta 面對的作者集體訴訟,同樣觸及盜版來源(LibGen、Z-Library)取得與訓練行為的雙重爭議;Sony 與 Warner 對 Anthropic 提出的歌詞訴訟則把爭點推向音樂資料與模型輸出。Anthropic 案的特殊性在於,Alsup 法官以即決判決先行釐清「訓練行為本身屬合理使用」,把賠償範圍收斂到「取得方式」這個相對具體的過失上,使和解得以在明確的法律框架下成形。其他案件仍卡在「訓練是否侵權」這個更根本的問題上,尚未出現同等明確的司法見解。對業者而言,這代表訓練資料合規的風險地圖仍未畫完:取得方式是當下最明確的高風險點,但訓練行為與輸出行為的法律邊界,仍可能在下一份判決中被改寫。在美國之外,印度德里高等法院則在 ANI 控告 OpenAI 一案跨出更寬鬆的一步,初步認定以新聞訓練 ChatGPT 屬公平處理、不侵權,顯示同一訓練行為在不同法域可能得到截然相反的初步結論。
對 AI 業者的現實意義
此案傳遞兩個明確訊號:以盜版來源取得訓練資料的代價極高,而訓練行為在資料合法取得的前提下相對受到保護。對採購或建構訓練語料的 AI 團隊而言,資料來源合規的優先級應高於模型策略本身;凡涉及未授權抓取的網路內容,仍應假設存在實質法律風險,直到上游爭議有更明確的司法見解。同期另一樁指標案件是 Apple 控告 OpenAI 竊取硬體營業秘密,兩案分別環繞訓練資料版權與營業秘密,反映 AI 智財爭訟正沿多條戰線同時展開。