測試版上線:為每次請求打上結構化標籤
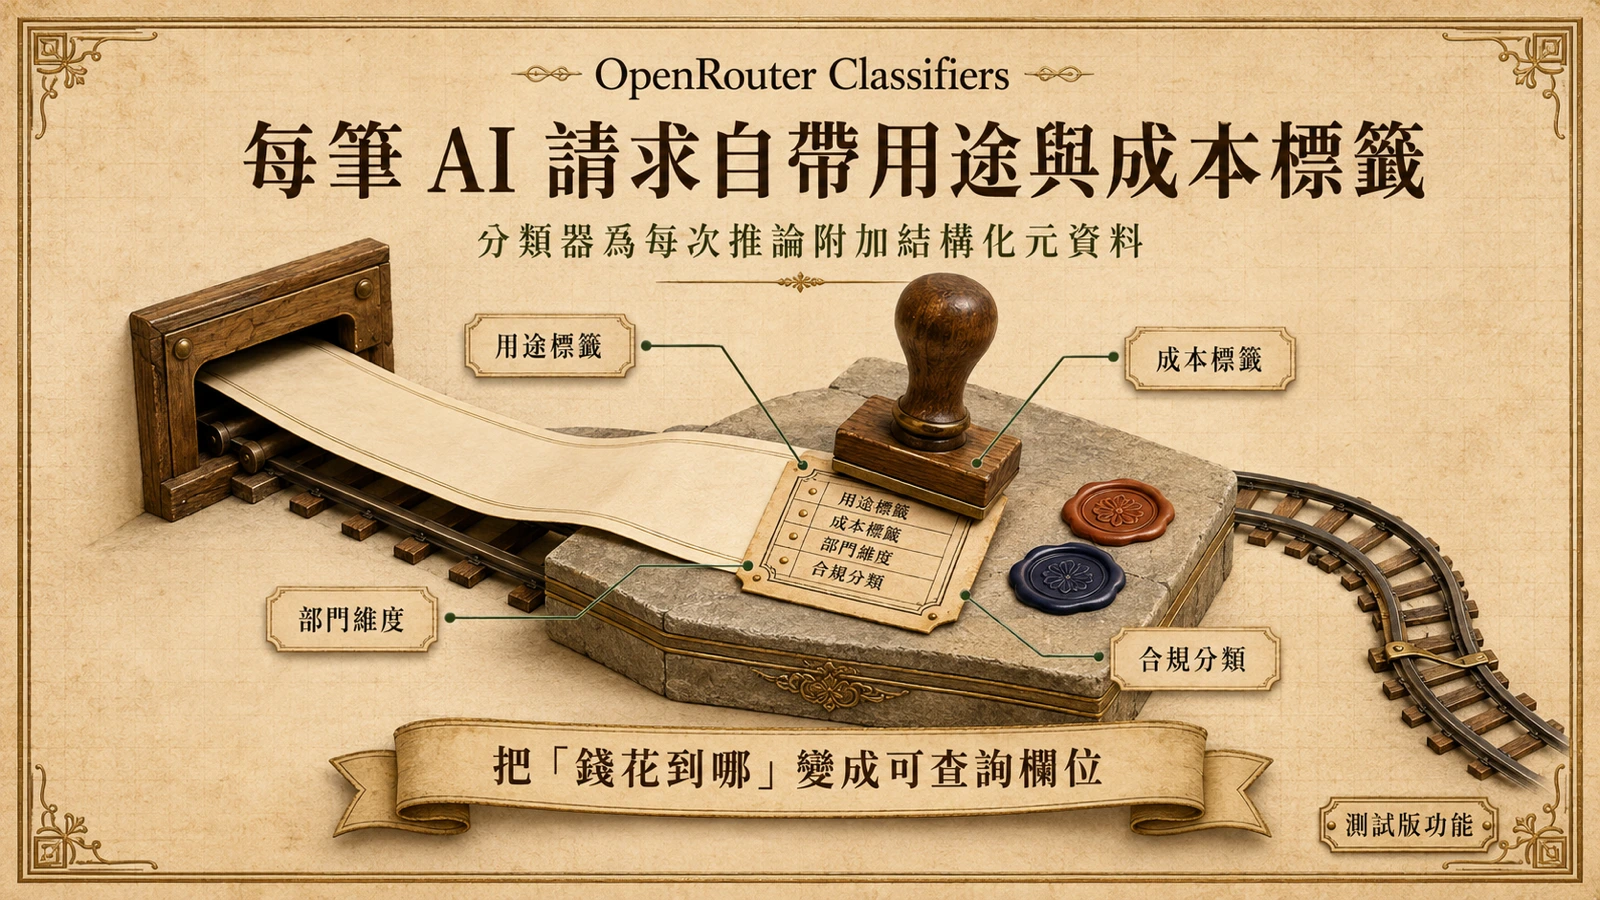
OpenRouter 推出 Classifiers 測試版,讓企業對每一次 AI 請求自動附加結構化元資料,把「這筆推論做了什麼、誰在用、錢花到哪」變成可查詢的欄位。使用者可定義任務類型、智慧代理複雜度、合規分類、成本中心等條件,由指定模型讀取每次生成結果(或抽樣子集)並套用分類體系,結果寫入紀錄。對需要審計 agent 開銷、向利害關係人報告 AI 治理狀況的團隊,這套機制補上了過去缺乏的觀測層。這是對生成結果做事後標記,與LoRA 微調 DistilBERT 的任務分類流程是不同路線。
設定四要素與六款預設模板
一個分類器是包含四個部分的小型設定:分類體系(最多八個維度,每個維度可自訂值)、分類提示詞、負責判讀的模型,以及採樣率。分類在每次請求完成後非同步執行,不會拖慢推論延遲。平台提供六款預設模板:Department 標記發起部門(工程、法務、行銷等);Audience 標記輸出對象(內部、客戶、監管機關、公眾);Task Type 標記任務種類;Engineering Work 細分功能開發、除蟲、重構、程式審查;Agent Complexity 標記難度等級;Capitalizable Software Expense 則判斷 AI 輔助工程是否屬於可資本化的開發。
模型選擇與採樣率控制成本
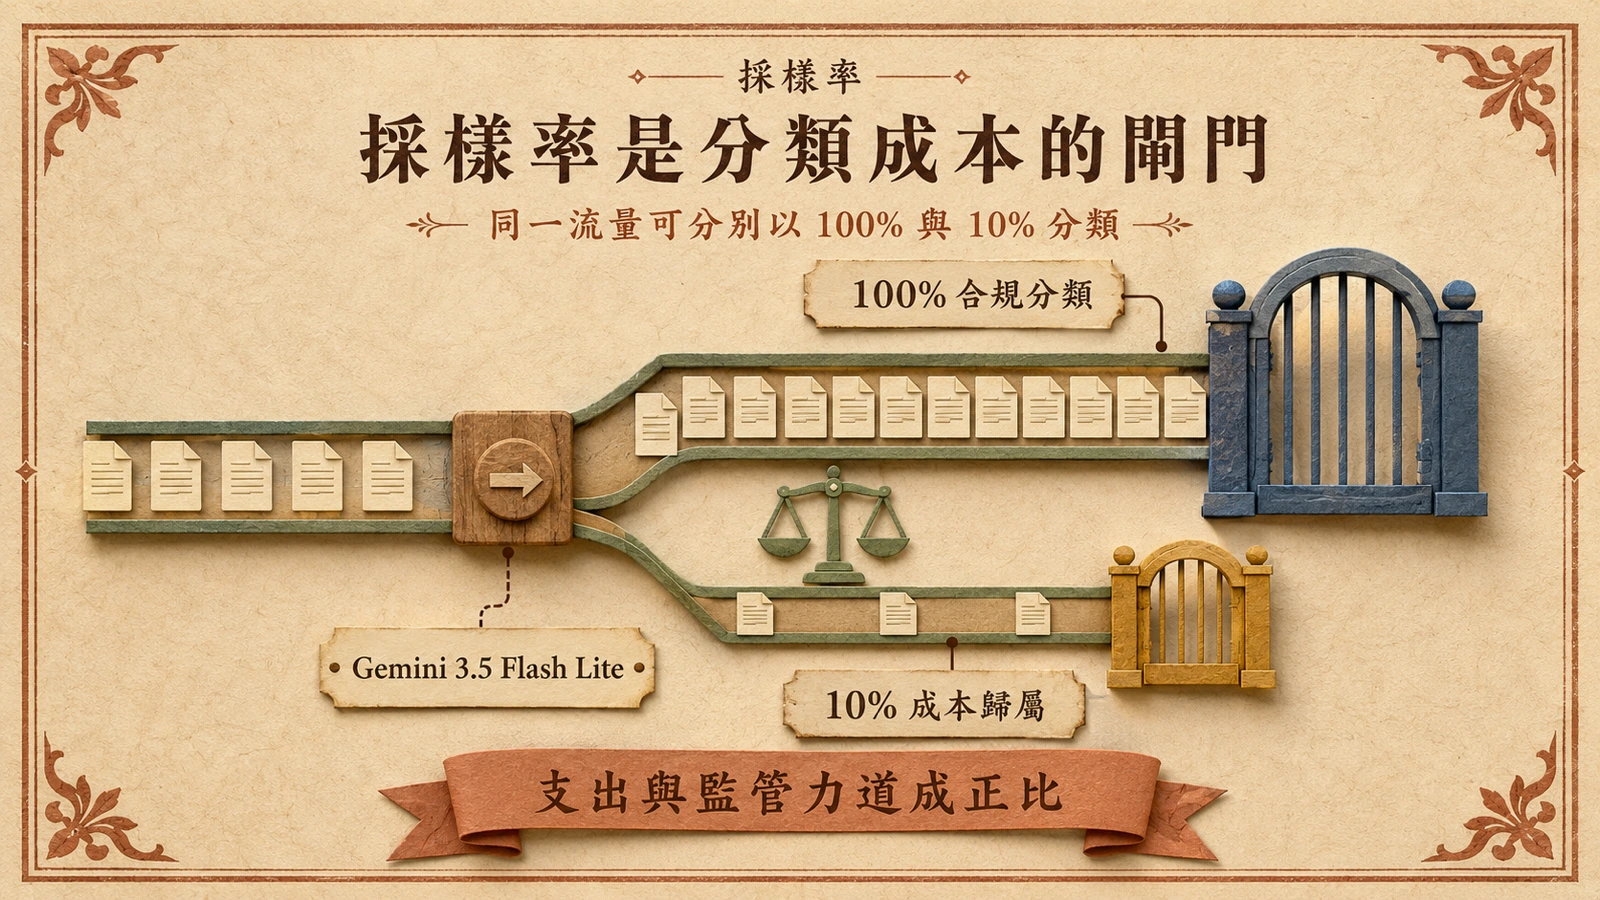
OpenRouter 推薦 Gemini 3.5 Flash Lite 作為分類模型,理由是價格低、結構化輸出準確度足以應付多數分類體系,並可隨時更換。在高吞吐下逐一分類的成本會累積,因此採樣率成為關鍵:可以用 100% 比例運行嚴格的合規分類器,同時對同一流量只抽 10% 做較寬泛的成本歸屬,讓支出與需要的監管力道成正比。
可資本化支出與審計價值
六款預設模板中最值得深談的是 Capitalizable Software Expense——它把 AI 輔助工程的工作分類,直接接到軟體開發支出的會計處理。在多數會計準則下,用於「建造可長期使用之軟體資產」的工程投入可以資本化、分期攤提,而屬於維運或日常除蟲的投入則列為當期費用。這個區分過去對人力工時難以精確切分,如今 AI 輔助開發的每一次推論都帶有成本與用途標籤,理論上可成為切分資本化與費用化支出的新證據來源。對財務與採購單位而言,這讓「AI 研發投入」不再只是一筆籠統的 API 帳單,而是可對應到資產負債表或損益表的細項。
但這條路徑有其現實限制。分類器判讀的是模型輸出與任務描述,無法驗證該次推論是否真的促成可交付的程式碼資產;要落地為可查帳的會計證據,仍須與專案管理、版本控制等系統對齊,並經會計師認可其採樣與抽樣方法。換言之,Classifiers 補上的是「這筆錢花在做什麼」的觀測層,至於「這筆投入能否認列為資產」,仍要回到企業既有的財務治理流程才能定案。
在 Activity Explorer 聚合分析
分類結果會被收斂成結構化格式並限制在自訂維度內,每筆被標記的生成結果可在 Logs 中按分類篩選,例如直接撈出 department: legal 或難度等級為 complex_multistep 的代理任務。Activity Explorer 回答聚合問題:按任務類型、部門或代理難度分組流量,觀察哪些任務或部門消耗最多預算、不同任務又用了哪個層級的模型。值得注意的是,即使停用輸入與輸出紀錄,Classifiers 仍可運作。
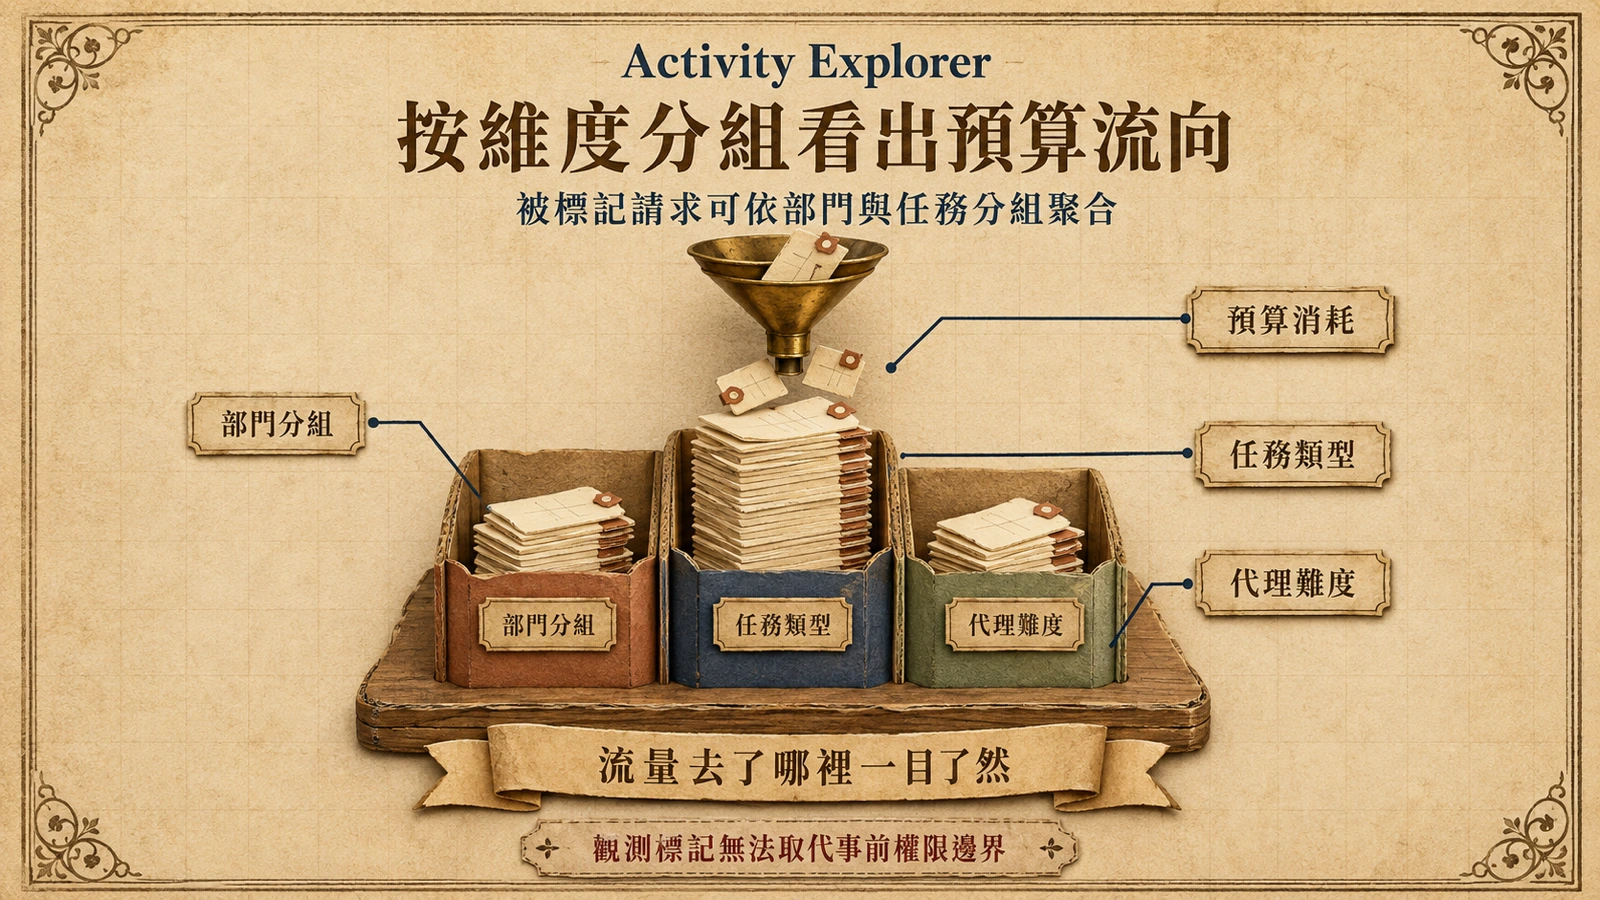
這類觀測標籤能回答「流量去了哪裡」,卻不能取代執行前的權限邊界;AgentForger 的 workspace agent CSRF 漏洞 顯示,一旦外部輸入能改寫審批政策,事後分類不足以阻止高權限動作;tl;dv 的 Firestore 租戶隔離缺口則展示了資料層沒有擋住時的直接後果。