放不下、記不住、忘了目標:長任務的三種失敗
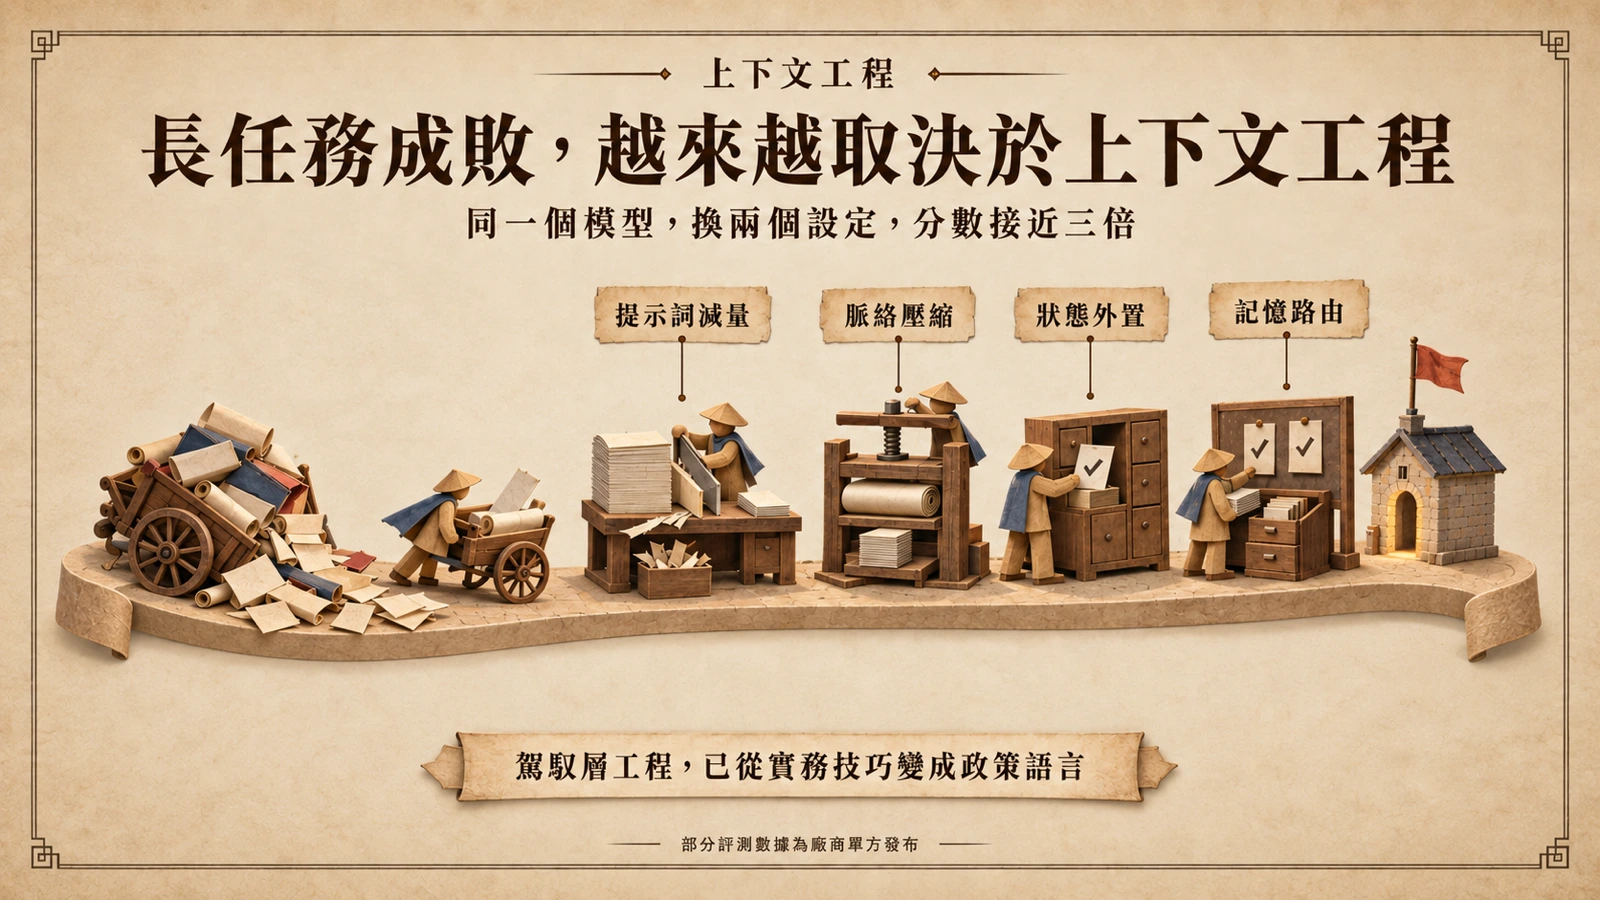
長任務(long-horizon task)是智能體最難的考場:同一個任務要連續執行數十上百個步驟,中途不能重來。模型智力之外,最先撐不住的往往是上下文視窗。失敗有三種典型樣貌。一是放不下——工具回傳、搜尋結果與操作軌跡不斷堆疊,視窗被塞滿後只能砍掉最舊的內容。二是記不住——上一回合摸到的規則,下一回合被系統預設丟棄,代理被迫從零重推。三是忘了目標——任務拉長後,最初指令被淹沒在雜訊裡,代理開始做與目標無關的事。
決定這三件事的不是模型本身,而是包在模型外圍、負責工具呼叫與上下文管理的那層框架,也就是駕馭層(harness)。最有說服力的證據來自 OpenAI 自己:在長程互動基準 ARC-AGI-3 上,GPT-5.6 Sol 在官方 harness 下於公開集僅得 13.3%;這個基準的技術報告寫明人類可解 100% 的環境,2026 年 3 月時前沿 AI 得分低於 1%。開啟跨回合保留推理與脈絡壓縮兩個設定後,同一個模型衝上 38.3%,將近三倍——兩個 API 層級的開關,比多數模型升級一個世代搬動的幅度還大。基準本身與分數爭議,站內已以〈ARC-AGI-3 半年飽和〉完整拆解,以下專注在它揭示的工程課題。
機制一:預算減法——上下文不是拿來塞滿的
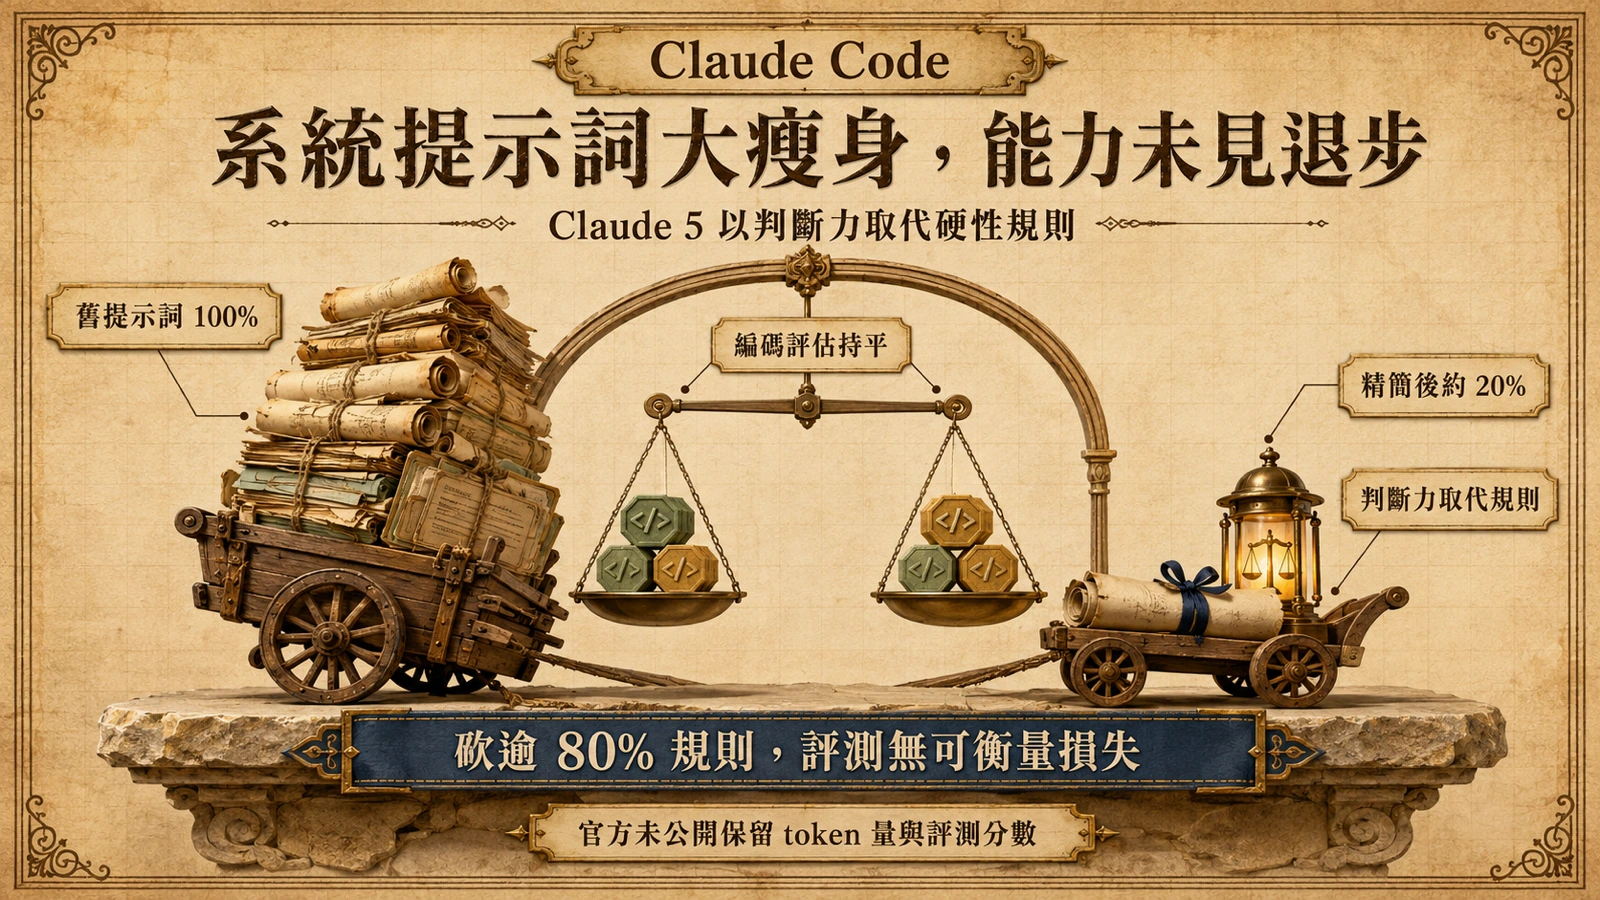
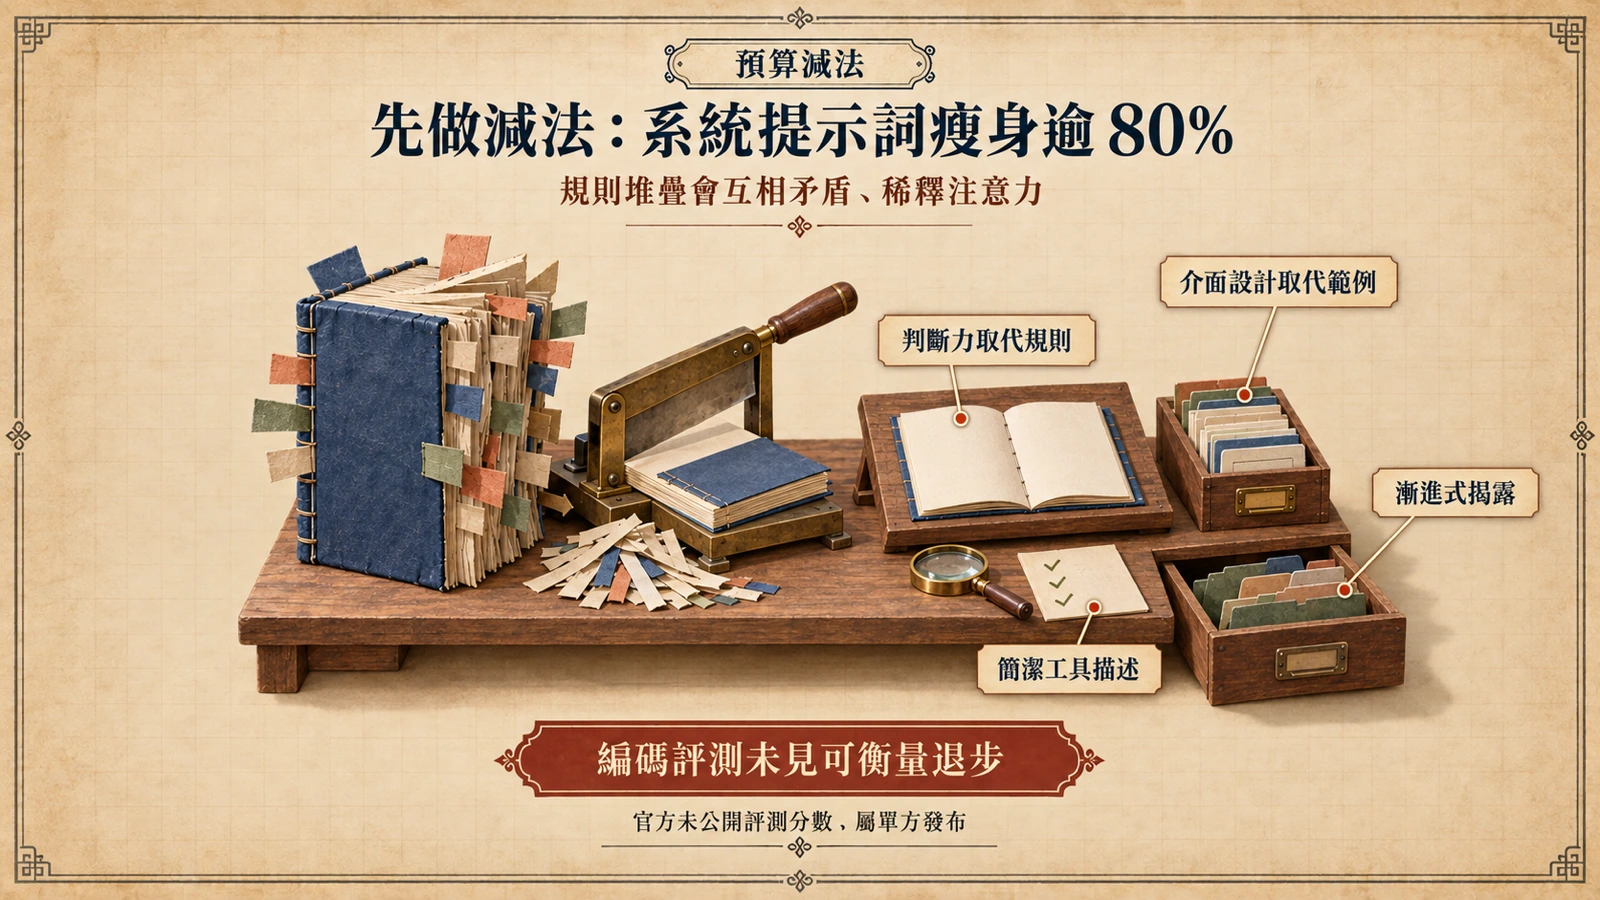
第一個機制最反直覺:不是往上下文加東西,而是先減。Anthropic 技術成員在官方部落格披露,團隊為 Claude Opus 5 與 Fable 5 兩個新一代模型移除 Claude Code 系統提示詞超過 80% 的內容,內部編碼評估未發現可衡量的效能損失。背後是硬性規則堆疊的結構性失效:規則會互相矛盾,在不同情境打架;會稀釋留給真正任務的注意力;也會讓模型在規則沒設想到的灰色地帶,寧可照字面遵循也不運用判斷力。
官方因此提出五條「過去 vs 現在」的對照:用判斷力取代規則、用介面設計取代範例、改採漸進式揭露(把驗證與程式碼審查移入獨立 Skill,需要時才載入)、用簡潔工具描述取代重複指令、以及用自動記憶取代手動維護專案設定檔。對開發者的意思是:上下文視窗是一種預算,系統提示詞每多一段,排擠的就是任務本身的空間;先把不再發揮作用的規則刪掉,通常比再加一條新規則划算。Anthropic 同步釋出 claude doctor 指令,讓外部社群能自動檢視自有設定檔的合理規模,站內對這篇〈上下文工程新規則〉另有逐條拆解。
機制二:壓縮與保留——讓記憶放得進、留得下
當軌跡無可避免地變長,第二個機制登場。脈絡壓縮(compaction)把不斷增長的互動軌跡摘要收納,用一段濃縮敘述取代逐字原文,避免超出視窗;與它成對的是保留推理(retained reasoning)——在回合之間不丟棄模型的推理內容,讓前一回合摸到的規則、踩過的坑得以帶到下一回合。一個解決「放不下」,一個解決「記不住」,在必須邊玩邊學的長程互動任務上效果最直接。
回到 ARC-AGI-3 的例子:不開這兩個設定時,官方 harness 預設在回合之間擦掉模型的推理內容,等於每換一回合就把代理的學習筆記清空,13.3% 的分數意味著它反覆以失憶狀態重考;保留推理讓筆記留得下來,脈絡壓縮讓筆記放得進視窗,兩者合力把成績推向 38.3%。代價也必須講清楚:摘要是有損壓縮,被摘要掉的細節——某次失敗嘗試的具體原因、某段工具回傳的原始內容——之後想召回就回不來。壓縮的觸發時機(視窗滿了才壓,還是定期壓)與摘要策略本身就是工程取捨,沒有免費的午餐。
機制三:狀態外置——任務進度寫在模型外面
第三個機制把狀態搬出上下文:與其讓任務進度寄生在對話紀錄裡,不如寫到模型外面的檔案、清單或資料庫,需要時再讀回。這一年各家框架開始把它做成正規架構。DeepSeek 開源的 Harness 框架明白把會話與儲存都列為插件——模型、工具、技能、沙箱到儲存全部可替換,任務狀態怎麼保存因此是可組合的設計決策,而不是框架寫死的黑箱。
Microsoft 走另一條路:用 14B 的編排模型 MagenticBrain 專責規劃、寫程式與任務分派,實際操作交給更小的電腦操作模型,規劃狀態因此有獨立的持有者;而且編排器在 harness 內端到端訓練,訓練與推論所用的工具介面完全一致,降低實驗室分數與上線行為之間的落差。政策側也出現同一組詞彙:北京市四部門 7 月印發的智能體政策,把上下文工程優化與任務持久化寫進紅頭文件,列為駕馭層工程的支持方向。三者的共同判斷是:任務狀態若只活在上下文裡,一次重置就歸零;外置之後,狀態可以檢查、可以恢復、可以交接。站內對〈DeepSeek Harness〉、〈MagenticLite〉與〈北京智能體新政〉均有完整報導。
機制四:記憶路由——難的不是存,是在對的時刻出現
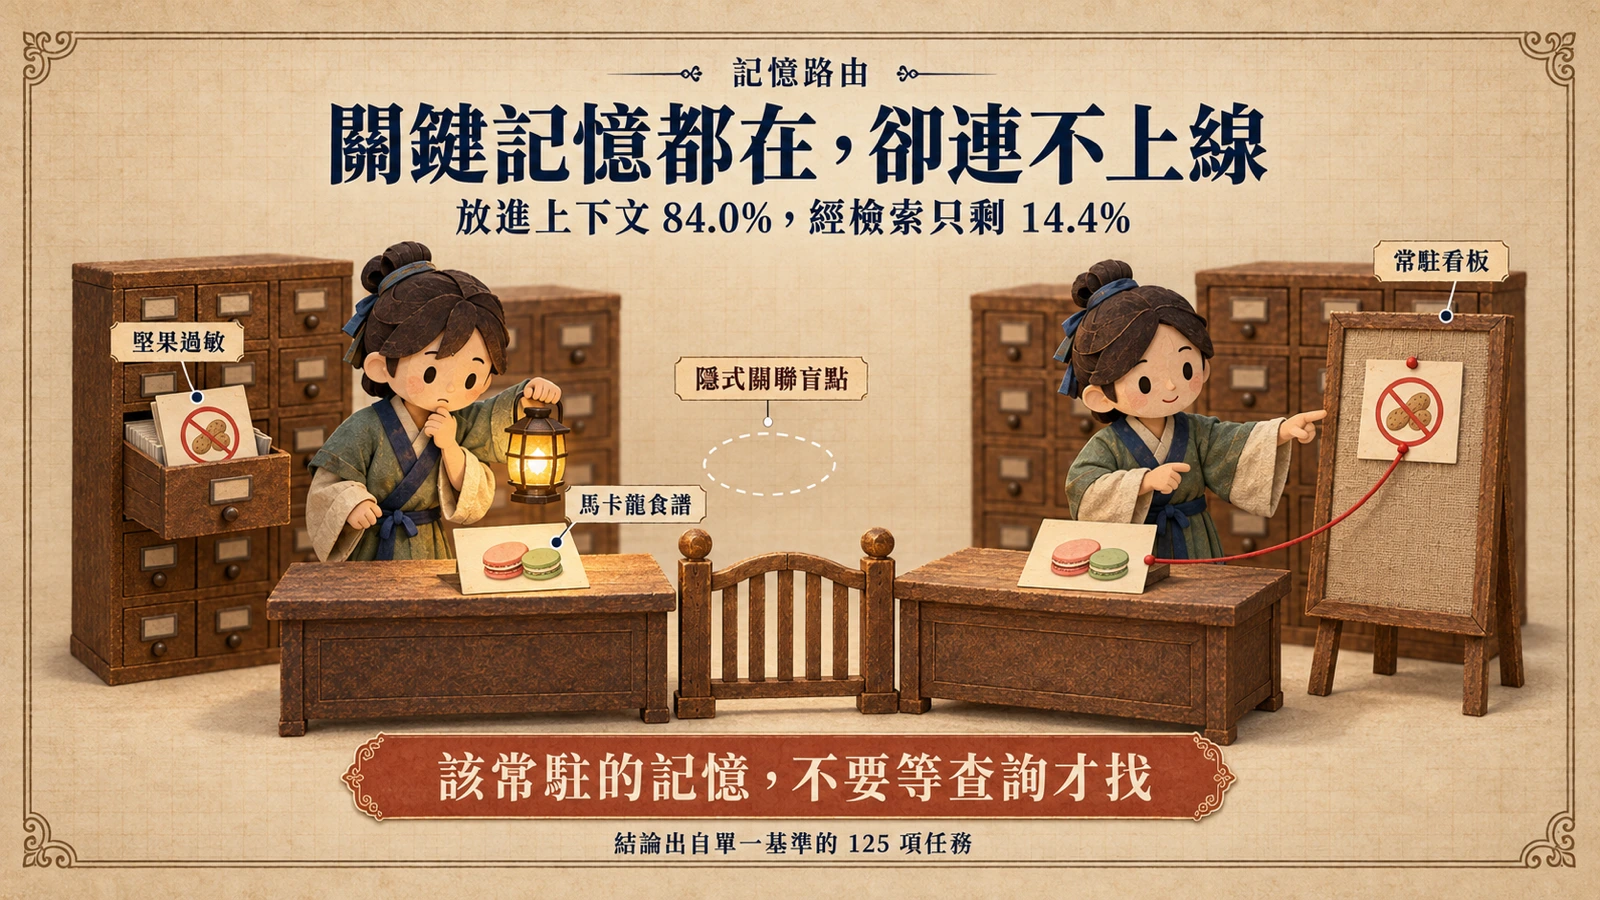
第四個機制處理跨會話的長期記憶,而目前最有殺傷力的證據是負面的。arXiv 論文 InMind 的配對控制實驗顯示:同一份決定性記憶,直接放進上下文時骨幹模型能答對 84.0% 的間接問題;改由六種向量、圖與智能體記憶系統在查詢到來時檢索,最高只剩 14.4%。同一批系統按需回憶相同事實的準確率是 100%——記憶有存進去、也取得出來,斷層發生在查詢到來、決定該呈現什麼的那一步。
原因被論文命名為隱式關聯盲點:使用者對堅果過敏這項事實,理應改變模型回應馬卡龍食譜請求的方式——馬卡龍以杏仁粉為主料——但「過敏」與「食譜」兩段文字之間不存在相似度能捕捉的線索,檢索器自然帶不進來。論文還實測了把嵌入維度提升八倍,召回率上升,84.0% 與 14.4% 之間的差距卻基本不動——這不是表徵容量問題,無法靠堆疊檢索工程根治。真正有效的動作是路由:在查詢到來之前,就決定哪些關聯必須常駐上下文、保持可見。這正好把資源優先序倒轉過來:與其無止境優化檢索器,不如把力氣花在決定「什麼該留在視線裡」。實驗細節可參考站內〈InMind 基準〉報導。
版圖對照:四家把寶押在不同層
把四類機制放回產業版圖,會看到各家押注的層次不同。OpenAI 押 API 層:把保留推理與脈絡壓縮做成兩個設定開關,開發者不必重造輪子,甚至把 Codex 同款駕馭層以 Agents API 開放串接。Anthropic 押提示詞與 Skill 層:用減法清出預算、用漸進式揭露按需載入、用自動記憶累積脈絡。Microsoft 押架構層:以專用編排模型分離規劃與操作,讓任務狀態有獨立的持有者。DeepSeek 押框架層:把會話與儲存插件化,讓狀態管理成為可替換的零件。
層次不同,共同判斷只有一個:模型的進步不會取消這層工程。同一個 GPT-5.6 Sol,駕馭層條件的差異就能讓分數差出近三倍;這也是柏克萊 RDI 把駕馭層標準化當成開源平台支柱的原因——當分數同時取決於模型與腳手架,後者就必須可以被檢視、被比較,訓練成果與評測數字才不會被混為一談。
對開發者:先問四個問題再疊機制
實際動手時,與其照單全收四類機制,先用四個問題體檢自己的智能體。第一,預算:系統提示詞與專案設定檔裡,有多少規則已經互相矛盾或不再發揮作用?判斷力更強的模型需要更少的防護欄,刪規則的報酬常常高於加規則。第二,收納:長會話有沒有壓縮與保留策略,還是放任軌跡撐爆視窗、每次重置都清空學習成果?第三,狀態:任務中斷或上下文重置後,代理能不能從外部狀態恢復「做到哪」,而不是從頭再來?第四,路由:哪些關鍵事實——使用者偏好、安全限制、專案慣例——必須常駐可見,而不是等查詢到來才檢索?InMind 的數據提醒,最後這題往往最貴也最被忽略。工作流程與團隊分工層的組織經驗,可另參考站內整理的〈Claude Code 新創五原則〉。
限制與後續追蹤
四類機制背後的證據各有但書。Anthropic 的 80% 精簡與「無可衡量損失」是單方描述,官方未公開評測分數與基準名稱,外部無法獨立複驗。InMind 是單一基準的 125 項任務,集中在生活領域的隱式關聯,距離生產環境的複雜工作流還有距離。OpenAI 的 13.3% 對 38.3% 出自官方部落格,測試設定的完整揭露程度曾引起討論。DeepSeek Harness 仍是 v0.1 開發者預覽,介面可能變動。跨基準、跨廠商的數字不能直接互比——它們的價值在於方向一致:駕馭層條件對長任務表現的影響,已經大到不能當成雜訊。後續值得追蹤三個指標:各家是否把保留推理與壓縮從選項變成預設行為;記憶路由是否長出標準化工具鏈;以及在北京之後,是否還有監管文本把上下文工程寫成合規要求。