系統提示詞瘦身 80% 的代價為何
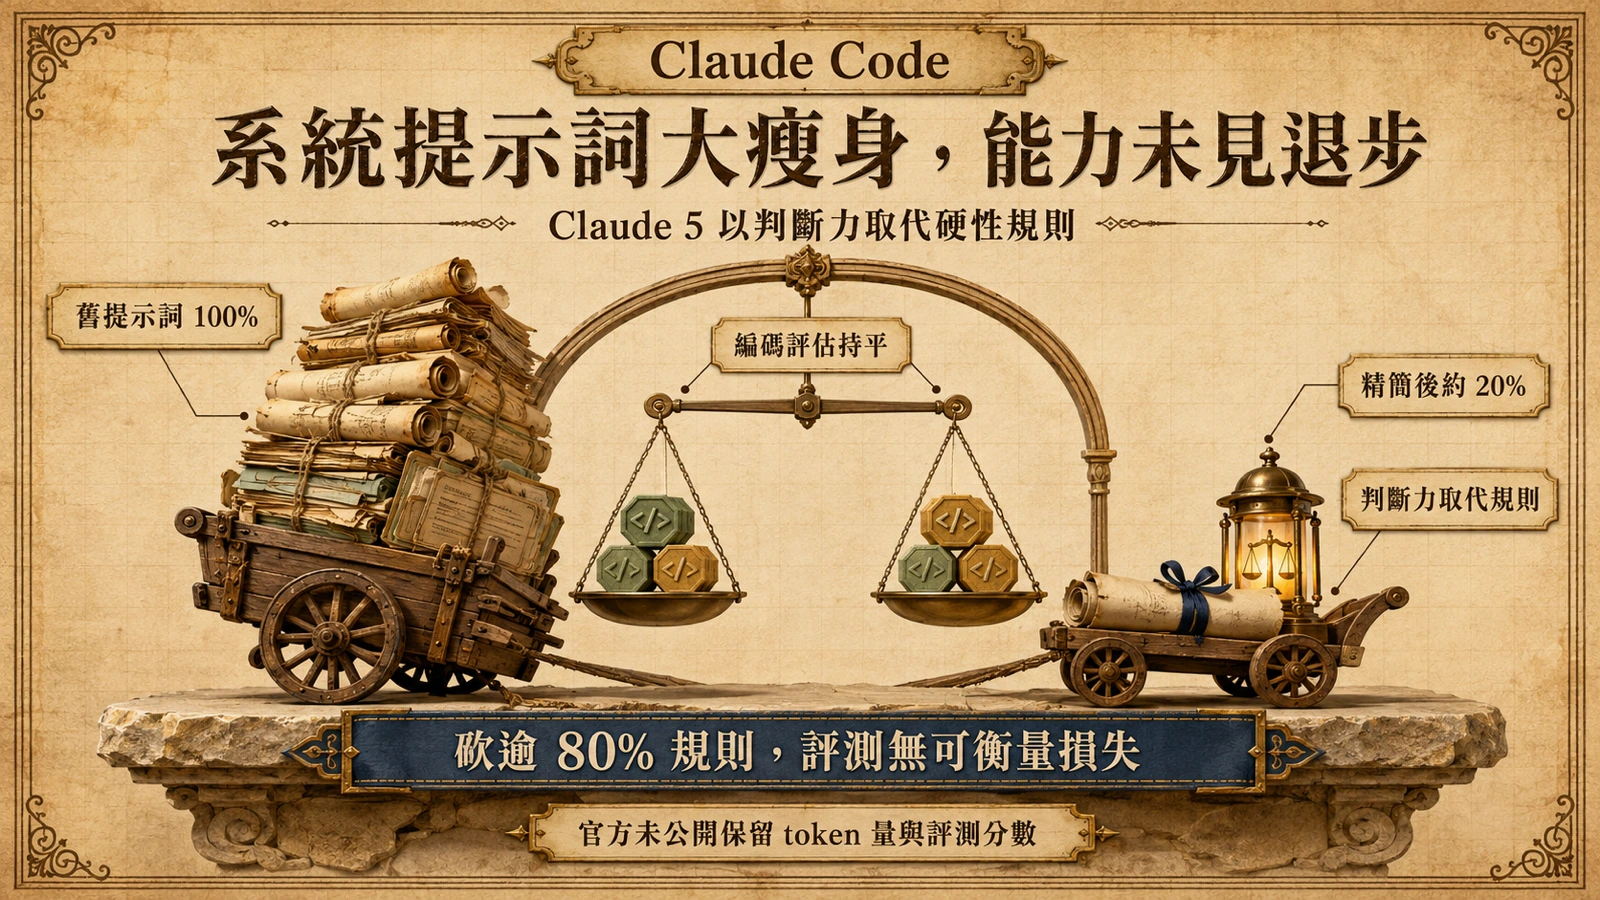
Anthropic 技術成員 Thariq Shihipar 在官方部落格指出,針對 Claude Opus 5 與 Claude Fable 5 等新一代模型,團隊移除了 Claude Code 系統提示詞中超過 80% 的內容,且在內部編碼評估中「未發現可衡量的效能損失」。這代表過去為防止舊模型犯下刪除檔案、濫加註解等最壞情況而堆疊的硬性規則,對判斷力更強的 Claude 5 已不再是必要防護欄。
Anthropic 同時發布 claude doctor(於 Claude Code 中以 /doctor 呼叫)指令,協助開發者自動檢視自有 Skill 與 CLAUDE.md 檔案的合理規模,把這套實踐直接交給外部社群。
五條上下文工程新規則
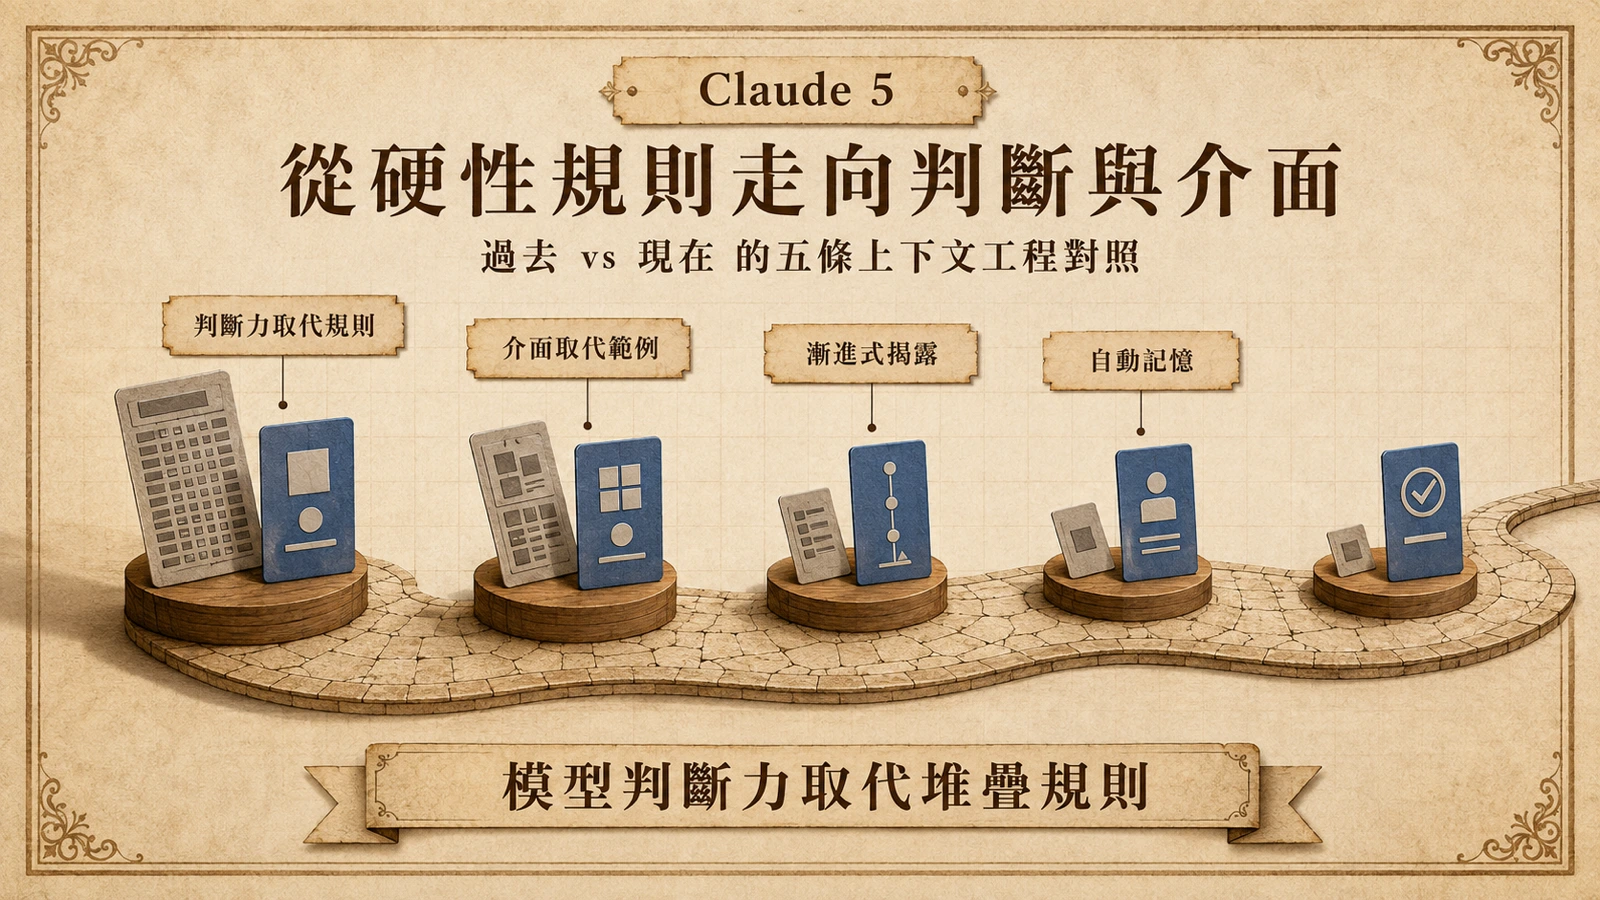
官方將舊有提示工程常識整理成五條「過去 vs 現在」的對照。第一,從「給 Claude 規則」轉為「讓 Claude 運用判斷力」,例如不再寫死「預設不寫註解」,改要求「匹配周圍程式碼的註解密度與命名慣例」。第二,從「提供範例」轉為「設計介面」,因為範例反而會限制模型探索空間,把工具參數設計得更具表達力(如列舉狀態)效果更好。
第三,從「全部塞在最前面」轉為「漸進式揭露」,將驗證、Code Review 等移入獨立 Skill,工具也採延遲載入(lazy-loaded),需要時再透過 ToolSearch 取出。第四,從「重複指令」轉為「簡潔工具描述」,把使用說明集中放進工具描述而非系統提示詞。第五,從「手動把記憶寫進 CLAUDE.md」轉為「自動記憶」,Claude 會自動保存與工作相關的脈絡。另外還有一條補充:從「簡單規格」轉為「豐富參考資料」,模型可直接消化 HTML 原型、測試套件或評分標準(rubrics)。
規則越堆越多反而失效的結構性原因
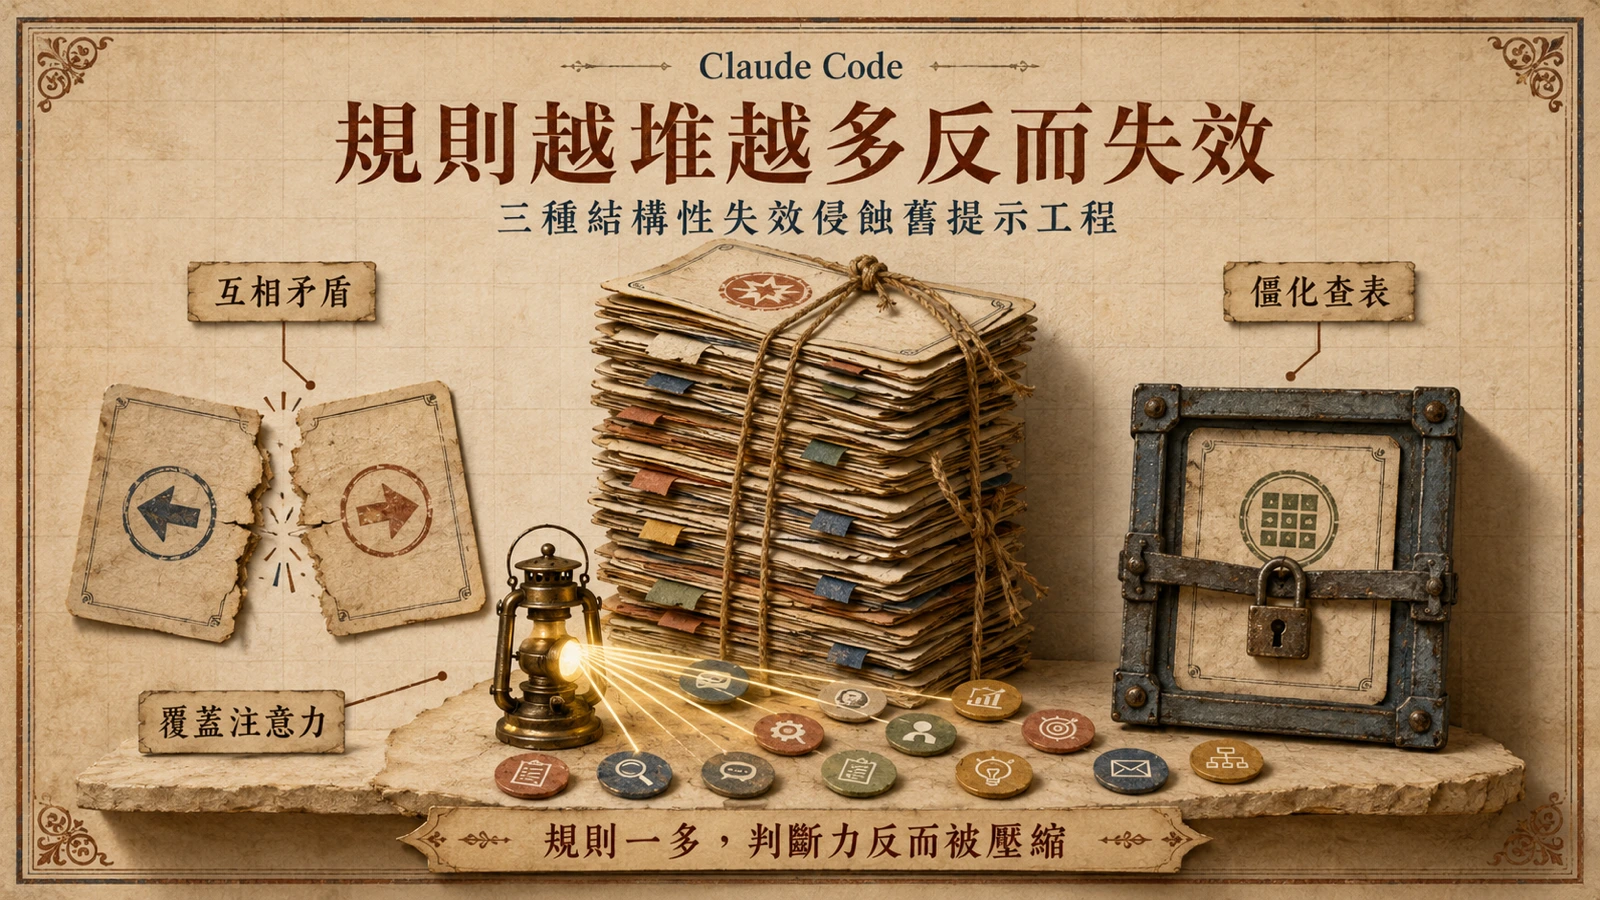
Anthropic 敢一次移除 80% 的系統提示詞,背後的因果機制值得分析。硬性規則在舊模型時代是必要的「防護欄」,因為早期模型判斷力不足,需要明確指令把最壞情況擋住。但規則一旦累積到一定數量,會出現三種結構性失效:第一是互相矛盾——「不要寫註解」與「要說明複雜邏輯」會在不同情境打架,模型被迫在兩條指令間猜測優先順序;第二是覆蓋注意力——系統提示詞每多一段,留給真正任務脈絡的有效注意力就被稀釋,規則反而壓縮了模型理解實際問題的空間;第三是僵化,規則為「常見情況」設計,一旦任務落入規則沒設想到的灰色地帶,模型會寧可遵循字面也不運用判斷力。
Claude 5 代之所以能卸下這層防護,是因為模型本身的判斷力已足以處理「何時該寫註解、何時不該」這類需要看上下文決定的問題。把決策從「規則查表」交還給「脈絡判斷」,等於用模型能力的提升,換回系統提示詞的精簡與一致性。這也解釋了為何官方同步推出 /doctor——當防護欄的責任從提示詞轉移到模型,開發者需要的是能診斷自身設定是否仍「過度防護」的工具,而不是更多範本。
對開發者的實際影響
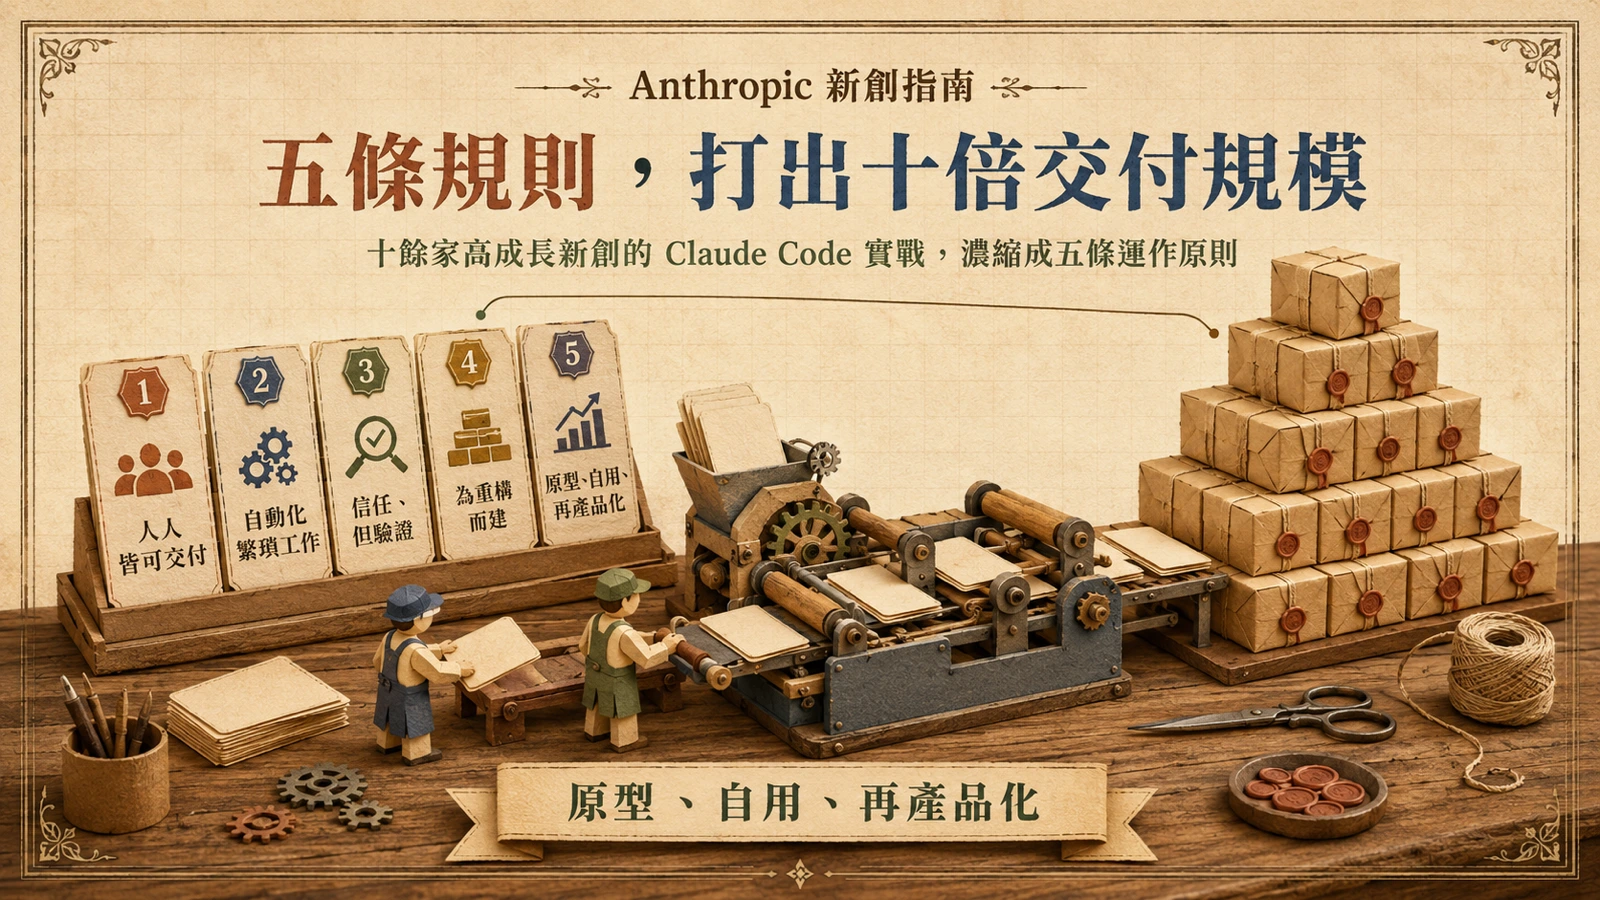
這份宣告的訊號很明確:系統提示詞與 CLAUDE.md 的價值,正從「條列式防護」轉向「脈絡與陷阱說明」。對自建 Agent 或大量使用 Claude Code 的團隊而言,與其繼續堆疊互相矛盾的指令,不如把心力放在工具介面、漸進式揭露的檔案樹,以及讓模型在需要時才載入的 Skill 結構;Anthropic 給新創團隊的五條 Claude Code 實戰規則可作為工作流程層的延伸。不過「按需揭露」的前提是模型能在需要時把對的脈絡找回來;對智能體的長期記憶而言,這正是〈InMind 基準〉揭示的難題——當關聯是隱式的,再強的檢索也會在關鍵時刻缺席,使「哪些事實必須常駐可見」本身就成為開放問題。而在長會話場景中,提示詞快取的保溫也是降低帳單的實務課題——claude-thermos 的快取保溫實測量化了這條優化路線。
不過文章並未公開 80% 之後實際保留的字數或 token 量,也未提供編碼評估的具體分數或基準名稱,因此「無顯著損失」目前僅為 Anthropic 單方描述,外部無法獨立複驗。可驗證的是方向性結論:Claude 5 代的設計前提,是模型能在更精簡的脈絡下自行做出正確決策。值得注意的是,官方精簡的是 Claude Code 的提示詞;據一份外流的網頁端系統提示詞檔案顯示,Claude Opus 5 在 claude.ai 的提示詞仍長達逾 13 萬字元,兩條產品線的取捨並不相同。