一個開源平台,打包電腦操作代理的三種碎片
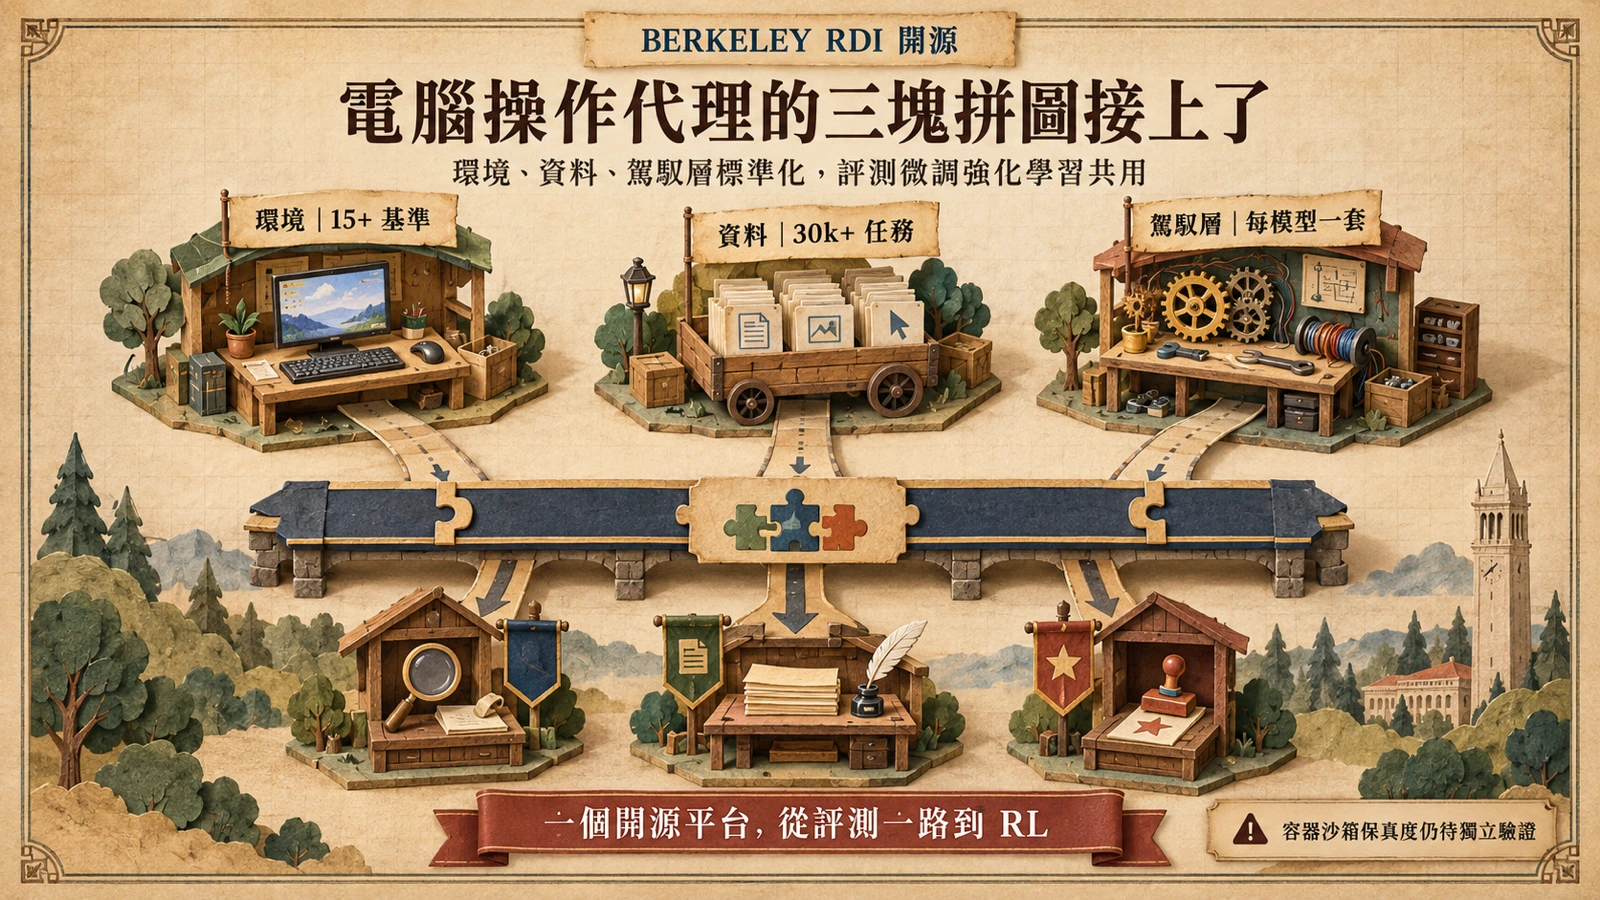
2026 年 9 月上旬,加州大學柏克萊分校 RDI(Robust, Decentralized Intelligence)團隊把一套名為 CUA-Lite 的開源平台放上 GitHub,服務對象是「電腦操作代理」(computer-use agent,CUA)——看得懂螢幕、能用滑鼠鍵盤代替人操作電腦完成任務的代理。計畫主持人宋曉冬(Dawn Song)在公告文章中寫明,這個計畫由 Berkeley RDI 主導,目標是讓它長成社群驅動的開放生態系,而不是另一個實驗室自用的內部工具。
承諾寫在專案官網首頁:一個開放平台,沙箱內含30k+ 可驗證任務,讓任何代理都能被評測、微調與強化學習訓練。官網列出的整合規模是超過 10 個代理、超過 15 個基準,覆蓋桌面、瀏覽器與行動端三種環境。對照各自為政的代理框架生態,這組數字背後的企圖很清楚:把研究社群重複在蓋的那層基礎設施,變成一份可以共同維護的公共財。
碎片化為什麼是痛:每個計畫都在重造輪子
要讓代理安全地操作電腦,團隊得自己張羅四件事:可以打碎重來的環境(沙箱)、可以拿來訓練的資料(操作軌跡)、把模型接上環境的腳手架(harness,站內譯作「駕馭層」),以及能夠公平比較的評測。官方說法直指三個斷點:框架碎片化,每個計畫都在重造同樣的基礎設施;沙箱沉重且難以重現——以代表性桌面基準 OSWorld 為例,跑一個任務要開一台 QEMU/KVM 虛擬機,主機必須有 /dev/kvm 且支援嵌套虛擬化,而多數雲端 VM 不提供這個條件;資料與評測缺乏標準,不同計畫的軌跡格式互不相通,分數也就難以互比。
這三個斷點疊起來的實際後果是:研究生把時間花在架虛擬機與轉檔,而不是模型本身;論文之間的數字難以比較,進展變得難以累積。CUA-Lite 選擇一次處理三個。
三個標準化介面:環境、資料、駕馭層
平台的解法是三個標準化抽象。GitHub 儲存庫的自述一句話講完企圖:把代理、沙箱、資料、評測、SFT 與 RL 標準化的開放平台,橫跨桌面、瀏覽器與行動端。
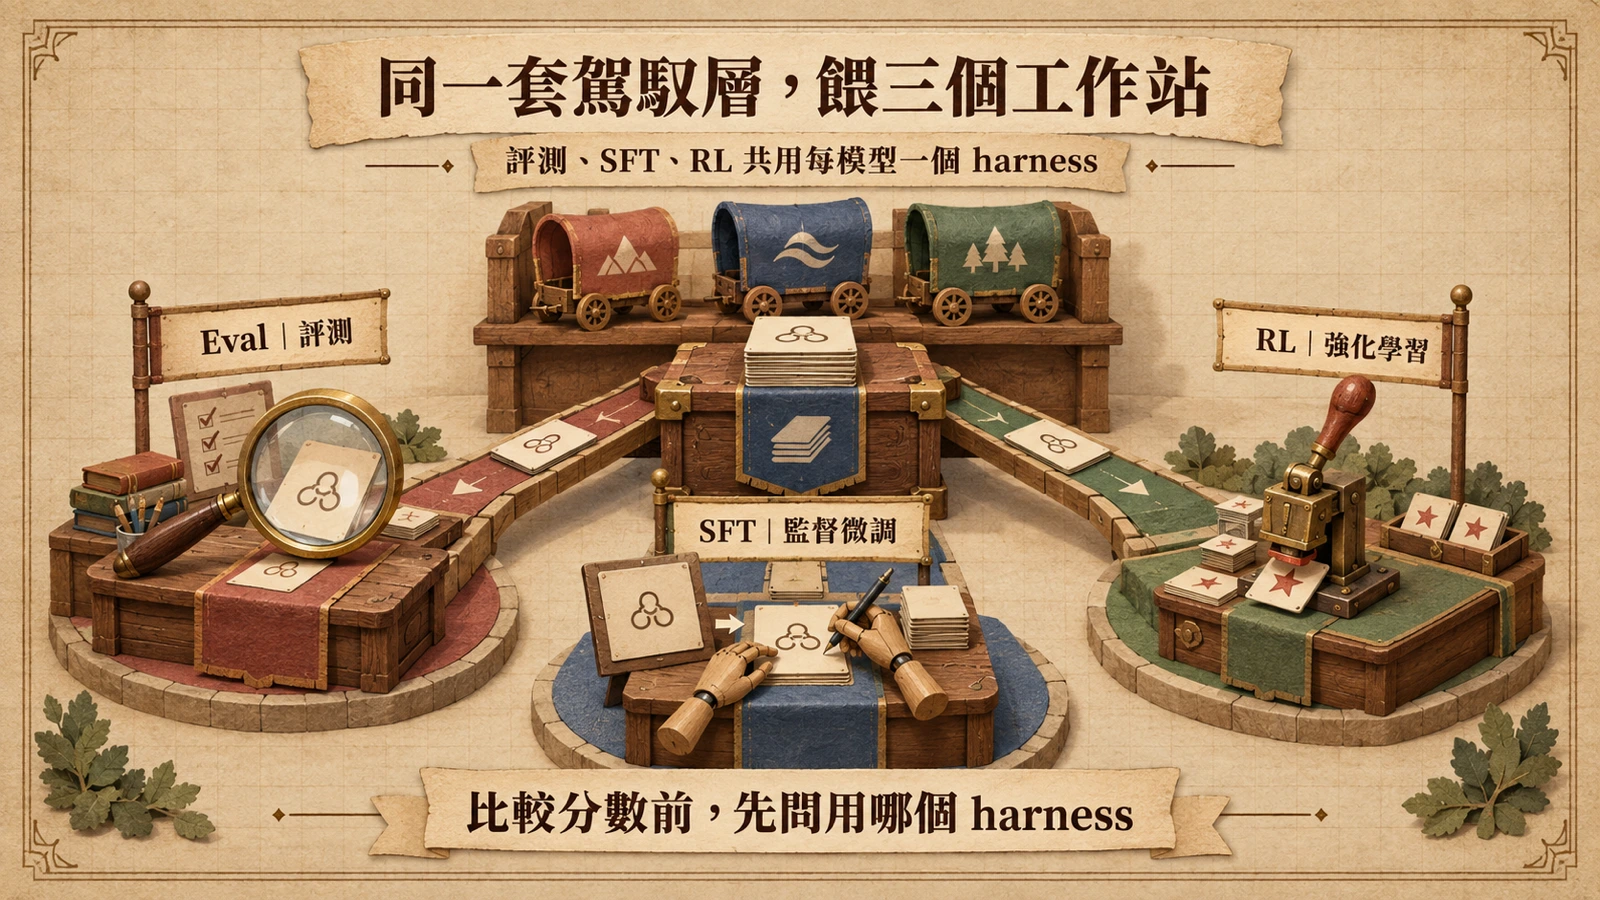
第一是環境介面。15 個以上的基準被接上同一套環境 API,代理不必為每個基準重寫一遍程式碼;桌面、瀏覽器與行動端共用同一種呼叫方式。第二是資料格式。一套名為 LiteSample 的統一軌跡架構通吃所有環境、代理與任務類型,再由各代理專屬的轉接器轉成每個模型自己的腳手架格式——模型之間的差異被隔離在轉接層,資料層保持乾淨。第三是駕馭層。每個模型配一個 harness,在評測、SFT 與 RL 之間共用:訓練時的操作介面與評測時完全相同,訓練成果與分數因此對得上,GPT、Claude、Gemini 等一線模型族都有對應的轉接器可用。
免 VM 沙箱:OSWorld 從 4.1 GB 換成 0.9 GB
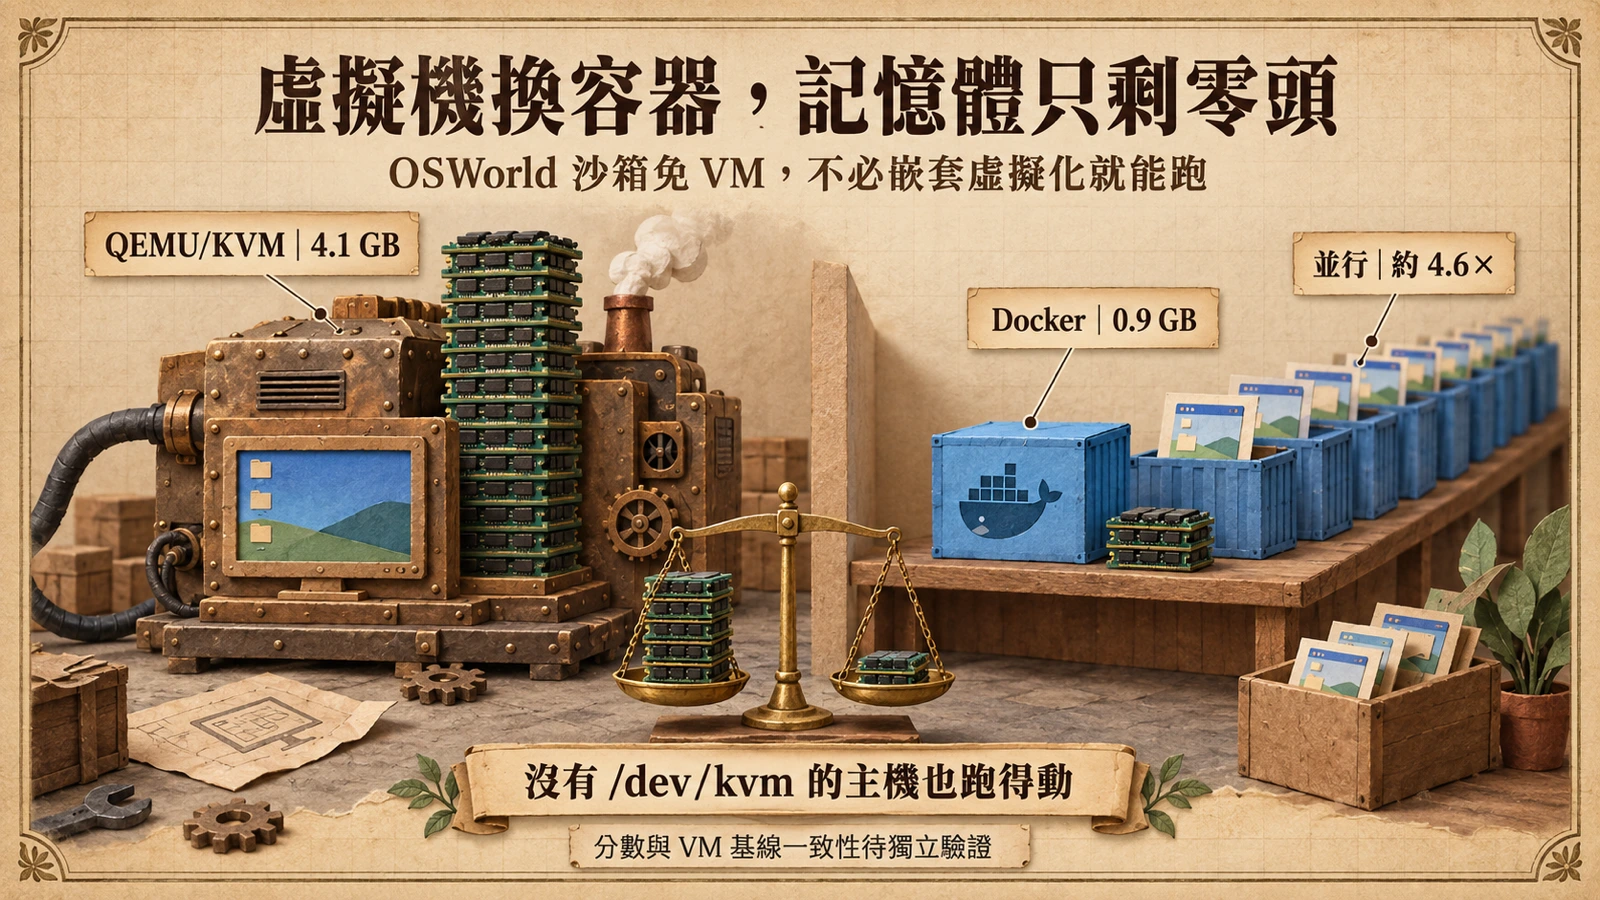
四個元件裡最扎實的工程在沙箱。官方部落格以「VM-free OS(World) at Scale」為題拆解這一步:OSWorld 提供裝了 LibreOffice、Chrome、VS Code 等真實軟體的忠實桌面環境,但以沉重的虛擬機形式交付。CUA-Lite 的做法是把任務與評分器裝進普通 Docker 容器:單一桌面的記憶體占用從 4.1 GB 降到 0.9 GB,主機不再需要 /dev/kvm 與嵌套虛擬化,任何裝得起 Docker 的機器都能跑。
0.9 GB 意味著什麼?同樣的記憶體可以塞下約 4.6 個容器——官方宣稱的並行度提升,基本上就是這個記憶體比例,4.1 除以 0.9 約等於 4.6。對要跑 30k+ 任務、每個任務都需要一個乾淨沙箱的訓練流程來說,並行度直接決定一天的任務吞吐量;官方並宣稱分數與虛擬機基線一致,這一點的獨立複核仍然有限,後面會再回到它。
駕馭層為何是主戰場:分數、訓練、政策都指向它
站內先前的報導提供了一個現成對照:OpenAI 自己的數據顯示,同一個 GPT-5.6 Sol 在官方 harness 下得 13.3%,開啟跨回合保留推理與脈絡壓縮後升到 38.3%——harness 條件足以讓分數差出近三倍。這正是「每個模型一個 harness、評測訓練共用」值得當成平台預設的原因:當訓練與評測共用同一套駕馭層,「模型變強」與「腳手架變強」才不會被混為一談,跨論文、跨團隊的數字也才有起碼的可比性。
政策側出現了同一個詞。北京市四部門 7 月印發的智能體政策,把「駕馭層工程(Harness Engineering)」寫進正式紅頭文件,圍繞上下文工程、任務持久化與多智能體協作夯實共性底座,站內政策報導已做逐條拆解。當駕馭層同時出現在評測爭議與政策文本裡,把它標準化、開源化,就不再只是工程便利問題,而是生態治理問題——誰定義標準介面,誰就影響下一代代理研究的預設值。
對開發者與研究者的所以呢
實際用法可以分三層。想跑分的人:任何 Docker 主機都能把 15 個以上的基準跑起來,不必先喬到支援嵌套虛擬化的機器。想訓練的人:30k+ 可驗證任務直接當 SFT 與 RL 的素材,統一格式省掉資料轉檔的工程;訓練與評測共用馭具,調參結果不再依賴另一套腳手架。要發表或採購的人:把「附上統一格式軌跡與 harness 條件」寫進論文或驗收條款,結果才可重現、可比較。對企業採購電腦操作代理的場景,最低成本的下一步是要求供應商在這類開放基準上、揭露馭具條件地重跑一輪,而不是只看簡報裡的單一數字。
台灣讀者的取得條件相當單純:專案以開源形式釋出,沒有付費牆與地域限制;Docker 沙箱在一般雲端主機上就能跑,小團隊也能先跑基準再決定要不要投入訓練。
限制與後續追蹤
三件事值得誠實看待。其一,容器不等於完整作業系統:Docker 沙箱省掉虛擬機,代價是與真實桌面的保真度差異,官方宣稱分數與 VM 基線一致,但獨立複核有限,正式採用前值得自己跑一輪對照。其二,平台剛開源,模型族覆蓋、基準整合速度與長期維護都取決於社群動能,單一實驗室主導的公共基礎設施能否吸引外部貢獻,仍是開放問題。其三,安全面:沙箱裡跑的是會操作真實軟體的代理,容器隔離的邊界與資安後果,值得在放大規模之前先想清楚。
後續追蹤三個指標:第三方重現的分數一致性、基準與資料集的整合速度,以及論文與商業產品是否開始採用 LiteSample 格式。三個都往對的方向走,CUA-Lite 才有機會從「另一個開源計畫」變成電腦操作代理研究的度量衡。