檢查點內嵌探針,置信度結構化輸出
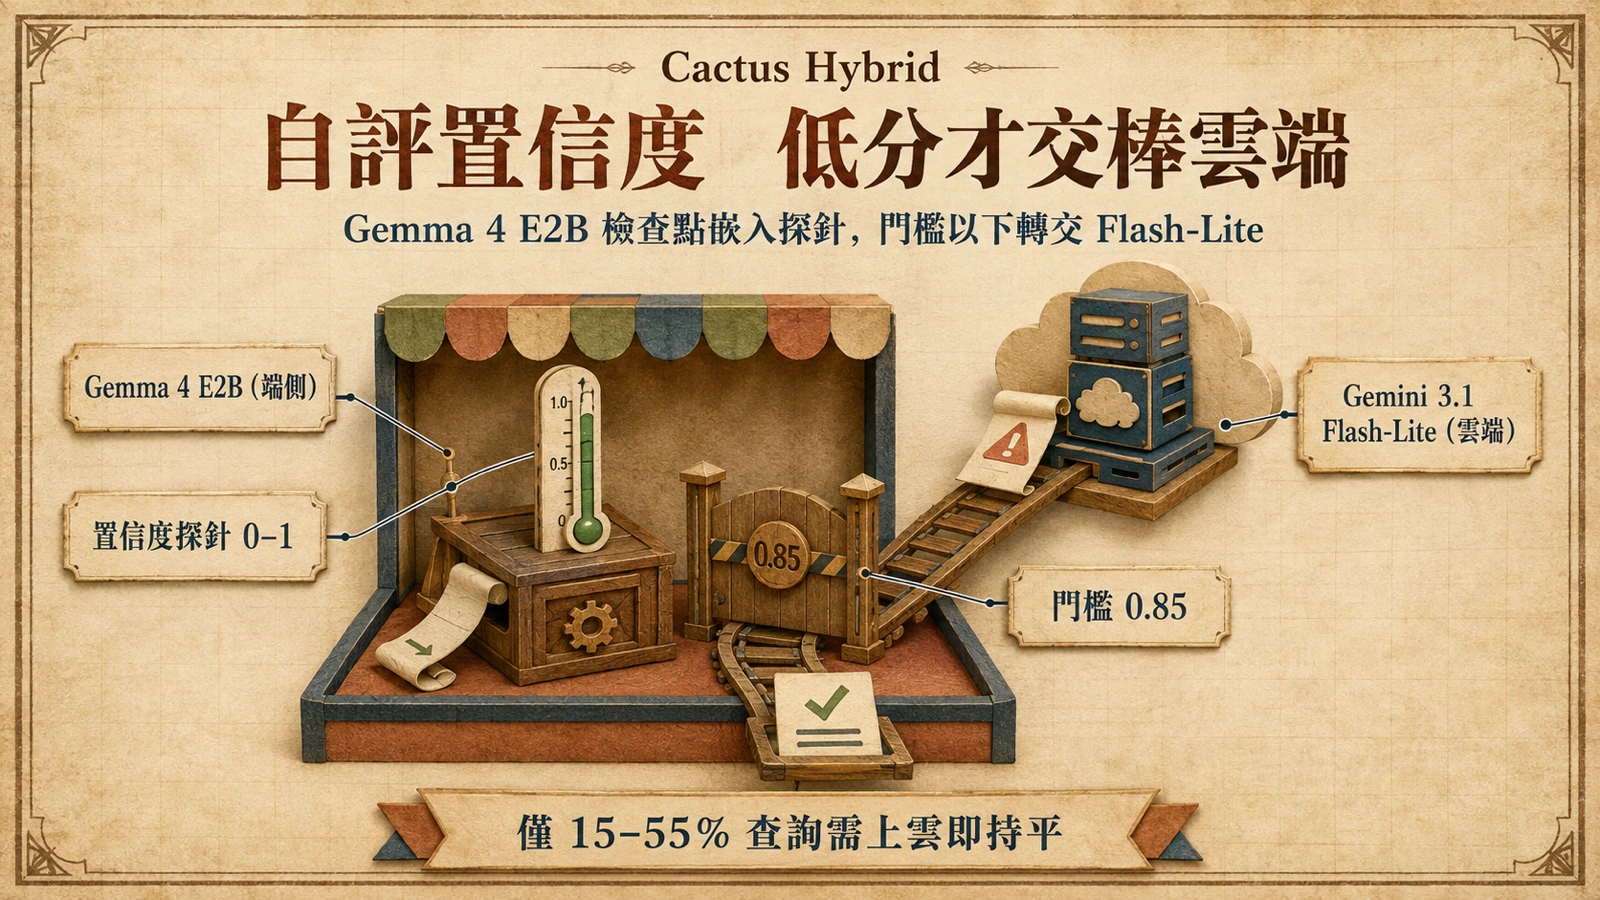
Cactus 以 Gemma 4 E2B 為基底推出 Hybrid,後訓練階段在模型檢查點內植入一支置信度探針(probe),為每個生成的答案回傳一個 0 到 1 之間的結構化分數,而非從答案文字解析。運作邏輯很直接:置信度高時直接在裝置端回覆,低於門檻(範例為 0.85)就把請求轉給更大的雲端模型。Gemma 4 E2B 是 Gemma 系列中最小的成員,鎖定離線與隱私優先的端側場景。同樣把「簡單查詢走快、難題才升級」做成動態切換的,還有 Ant 的〈Ling-3.0-flash〉混合推理 MoE——兩者印證同一趨勢:不是每個請求都值得啟動完整推理或最大的模型。
15–55% 路由即持平 Flash-Lite
Cactus 公布的切換比例顯示,端側模型自己處理大多數查詢,僅把困難題交棒。以 FP16 為例,ChartQA 只需路由 15–20% 即可追平 Gemini 3.1 Flash-Lite,MMBench 與 MMAU 約 30–35%,最困難的 MMLU-Pro 則需 45–55%;4-bit 與 3-bit 量化會把所需切換比例往上推,MMLU-Pro 在 4-bit 接近 90%。換言之,量化的省記憶體代價會直接反映在雲端呼叫頻率上,部署前需把這條取捨算進成本。
跨模態訊號而非死記答案
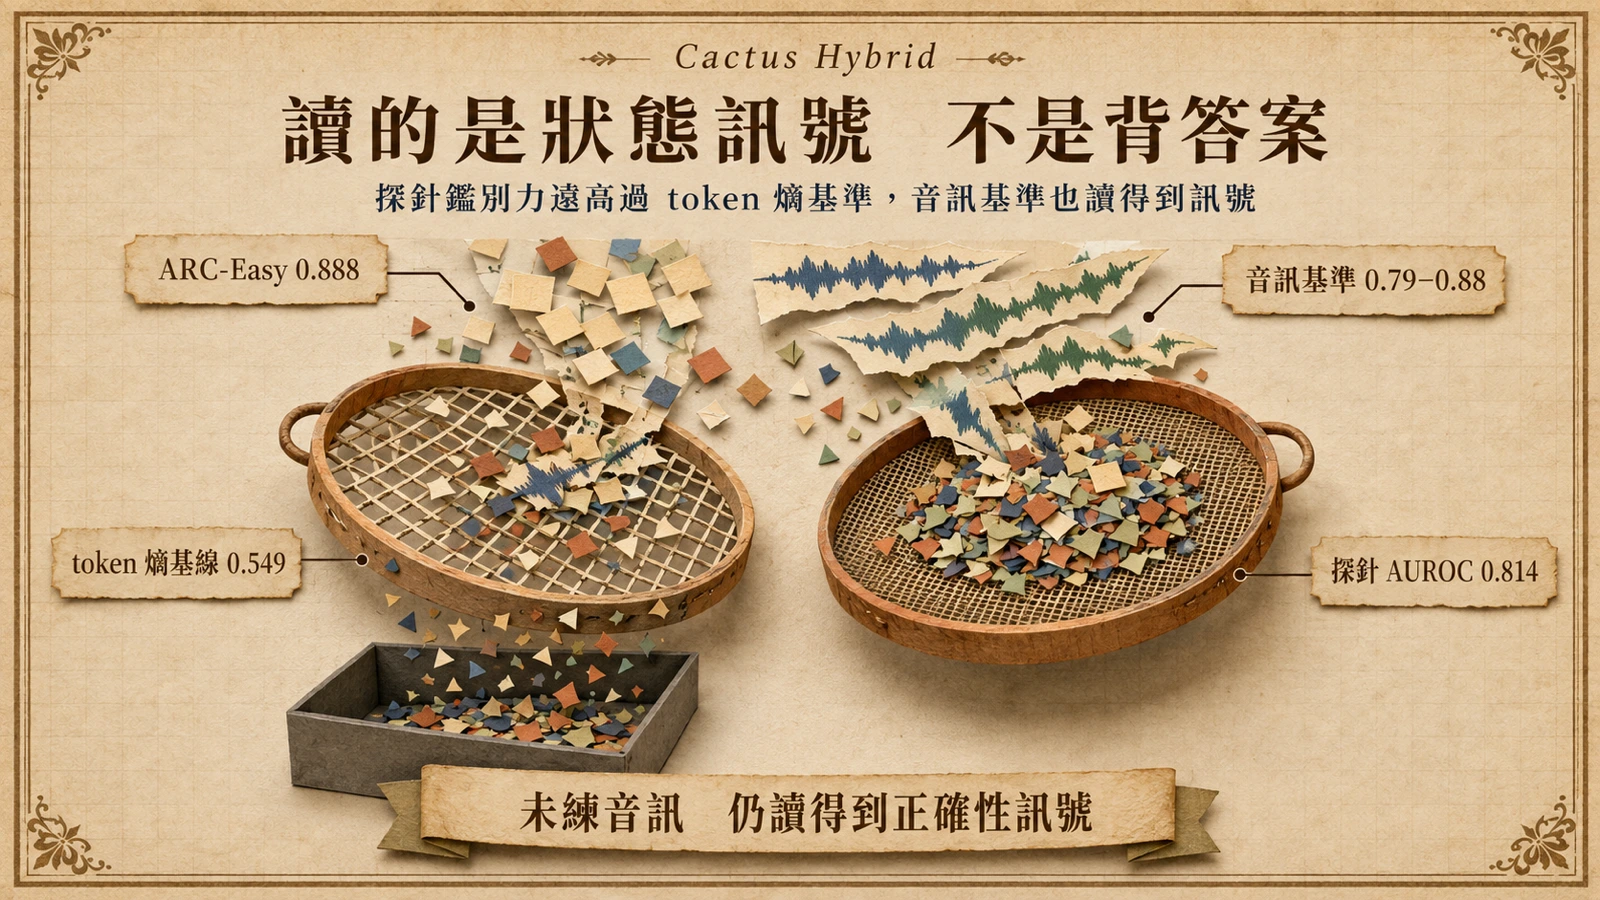
較值得注意的是探針的鑑別力。Cactus 自評 AUROC 在 12 個留出集平均達 0.814,明顯高於以 token 熵為基線的 0.549;其中 ARC-Easy 0.888、MMBench 0.840、GigaSpeech 0.876。最具說服力的一組數字:探針完全未以音訊資料訓練,卻在四個音訊基準(兩個轉錄、一個音訊選題、一個跨域轉錄)拿下 0.79–0.88 AUROC,暗示它讀的是隱藏狀態中與模態無關的正確性訊號,而非背誦訓練分布。
為什麼不全交給雲端
既然雲端 Flash-Lite 準確度更高,何不把所有請求都送上去?Cactus 的整個設計就是在回答這個問題。第一是延遲:每次雲端往返都會把回應時間拉長到數百毫秒甚至秒級,對即時互動的體驗是硬傷;端側模型在置信度高時直接在地回覆,省掉的就是這段往返。第二是成本:雲端按 token 計費,若多數查詢其實是簡單題,全量上雲等於把便宜流量當昂貴流量買。第三是隱私:敏感資料留在裝置端不出端,對醫療、金融、企業內部場景往往不是偏好而是合規要求。
置信度路由的價值,在於讓這三者在多數場景同時成立——多數基準只需把 15–55% 的難題升級到雲端,就能追平全雲端的準確度。但前面那組量化數字已經劃出邊界:4-bit 量化會把 MMLU-Pro 所需切換比例推到將近 90%,等於用「省記憶體」換來「幾乎每題都得叫雲端」。也就是說,這不是一個裝上去就保證省錢的開關,而是一條必須連同解析度、量化位元與硬體一起基準化的成本曲線;門檻值的調整也會直接挪動準確度與雲端用量之間的槓桿。
落地限制與整合
模型以 MIT 授權開源,Gemma 本身仍受 Gemma 條款約束,權重放在 Hugging Face 的 Cactus Hybrid 集合。整合路徑涵蓋 Cactus 自家 SDK、MLX、Transformers 與 llama.cpp,但 llama.cpp 需先編譯補丁才能讓回應帶出 confidence 欄位;Transformers 載入必須用顯式 .to(device),device_map="auto" 會讓留在 meta 裝置的權重導致置信度讀取崩潰。對想自建端側路由管的團隊,這是一份可複現的起點,但量化與硬體組合仍需自行基準化。部署後若還要追蹤請求用途、部門與成本歸屬,可接著看〈OpenRouter Classifiers 的非同步請求分類〉;前者決定「該不該升級模型」,後者回答「流量為何發生、費用算給誰」。
門檻校準的隱藏風險:排序能力不等於路由可靠
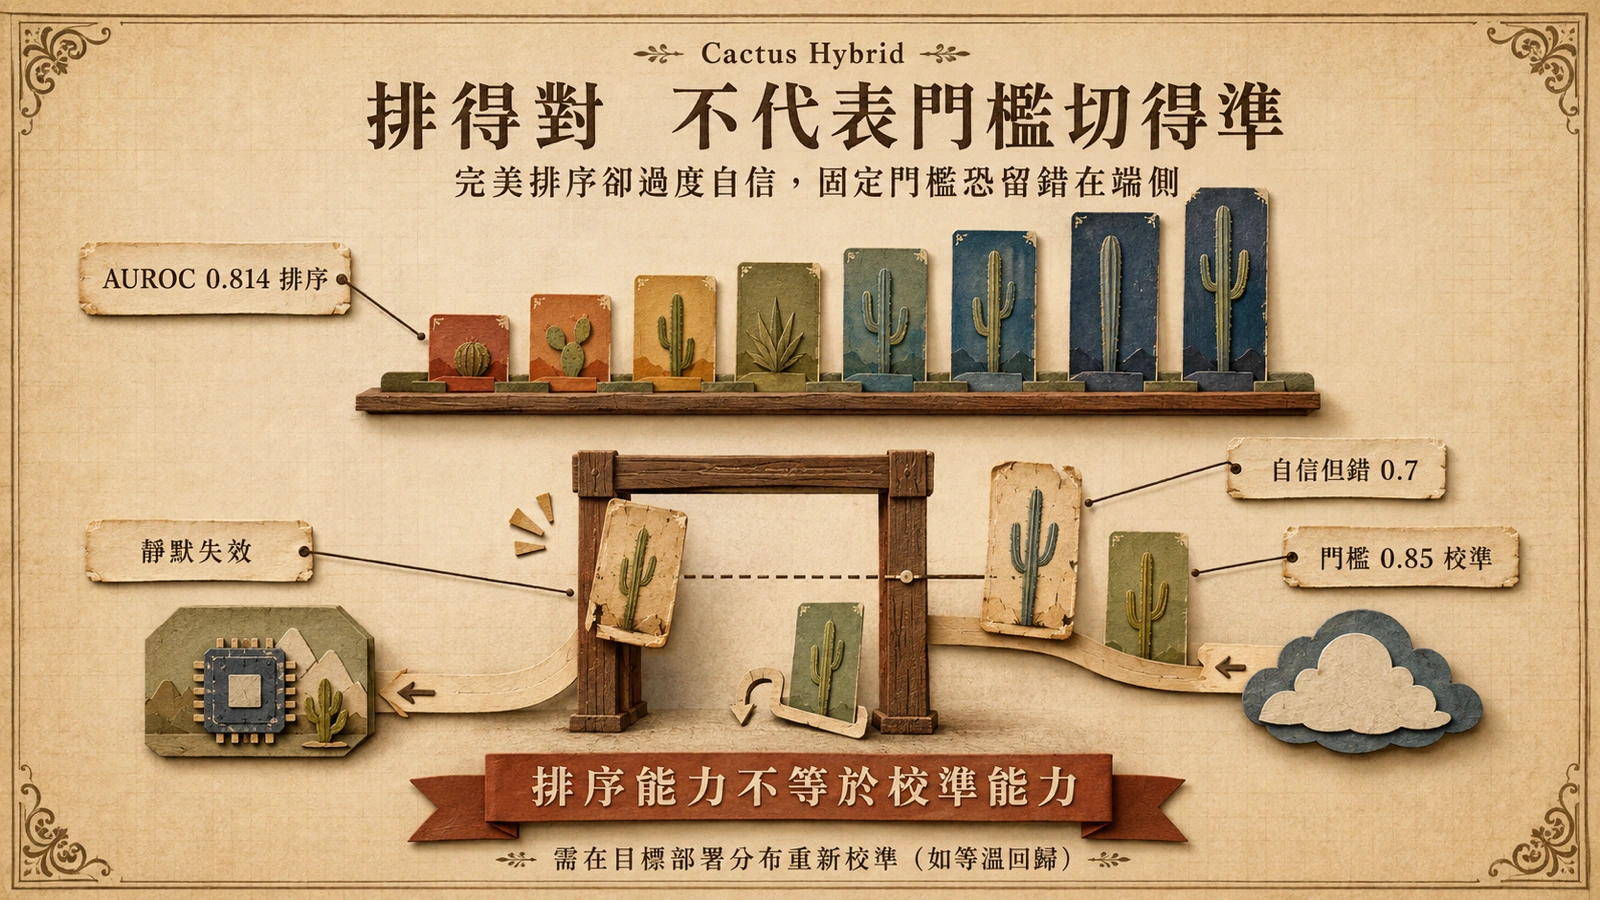
AUROC 0.814 證明探針能正確排序「哪個答案更可能正確」,但路由用的是絕對門檻(範例 0.85),而排序能力與校準能力是兩件事。一個探針可以完美排序、卻系統性地過度自信——對該答對的題給 0.9、對該答錯的題也給 0.7——此時固定門檻會把本該升級雲端的錯誤答案留在端側,造成靜默失效:基準測的是全分布準確度,測不出這類「自信但錯」的部署誤差。更棘手的是,量化與不同硬體會讓隱藏狀態分布偏移,進而推動探針分數的整體位移,等於同一個 0.85 門檻在不同部署環境下對應到不同的真實錯誤率。穩健的做法是在目標部署分布上重新校準探針輸出(如等溫回歸或 Platt scaling),並把門檻選擇連同可接受的靜默錯誤率一起設定,而非直接套用範例值。