124B 總參、5.1B 激活的稀疏架構
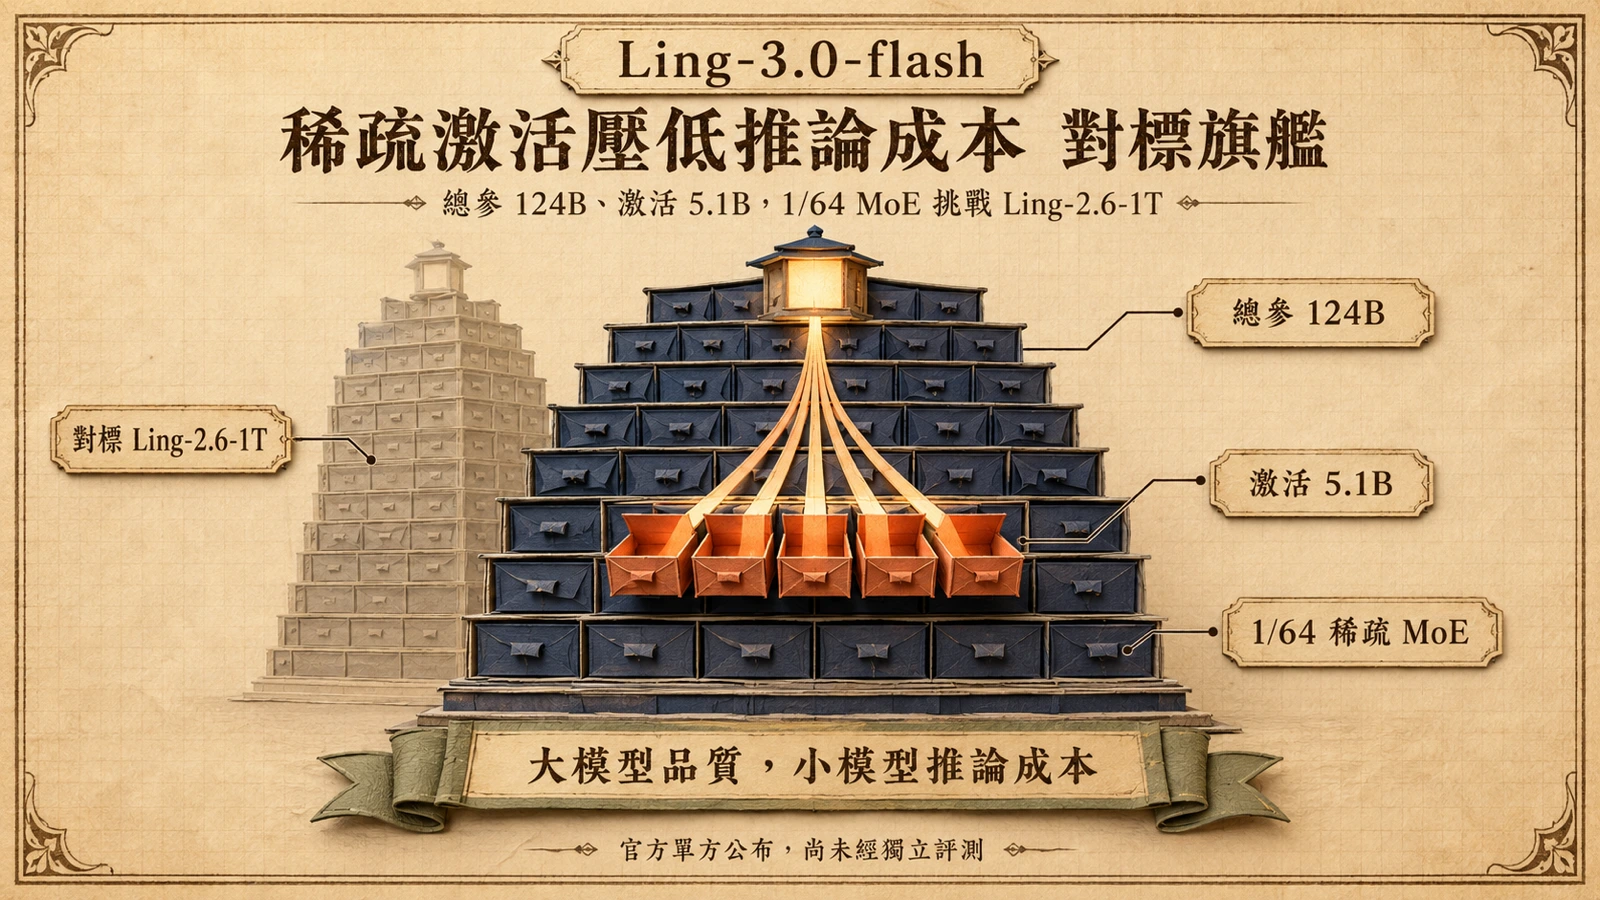
Ant Group 旗下 InclusionAI 團隊於 7 月 24 日透過「螞蟻百靈」官方公眾號發布 Ling-3.0-flash,定位為新一代原生混合推理模型。模型總參數量 124B,每次推理僅激活 5.1B,採 1/64 稀疏 MoE 與原生混合線性注意力架構,設計訴求是在大參數量下壓低單次推理的算力成本。HuggingFace 上對應的 inclusionAI/Ling-3.0-flash 模型卡目前回傳 HTTP 401,模型確實存在但為有限存取,權重與完整模型卡尚未對外公開。
混合推理的設計訴求:讓模型自己決定要不要深思
Ling-3.0-flash 定位為「原生混合推理」模型,與傳統模型固定輸出思維鏈不同,關鍵在於讓模型在單一架構內自行決定何時啟動深度推理、何時走快速回應路徑。這條路線的設計誘因明確:多數查詢其實不需要長鏈推理,強制每一題都「想很久」會把推論成本推高、把首字延遲拉長,而混合架構理論上能讓簡單題省下算力、把資源集中給難題。
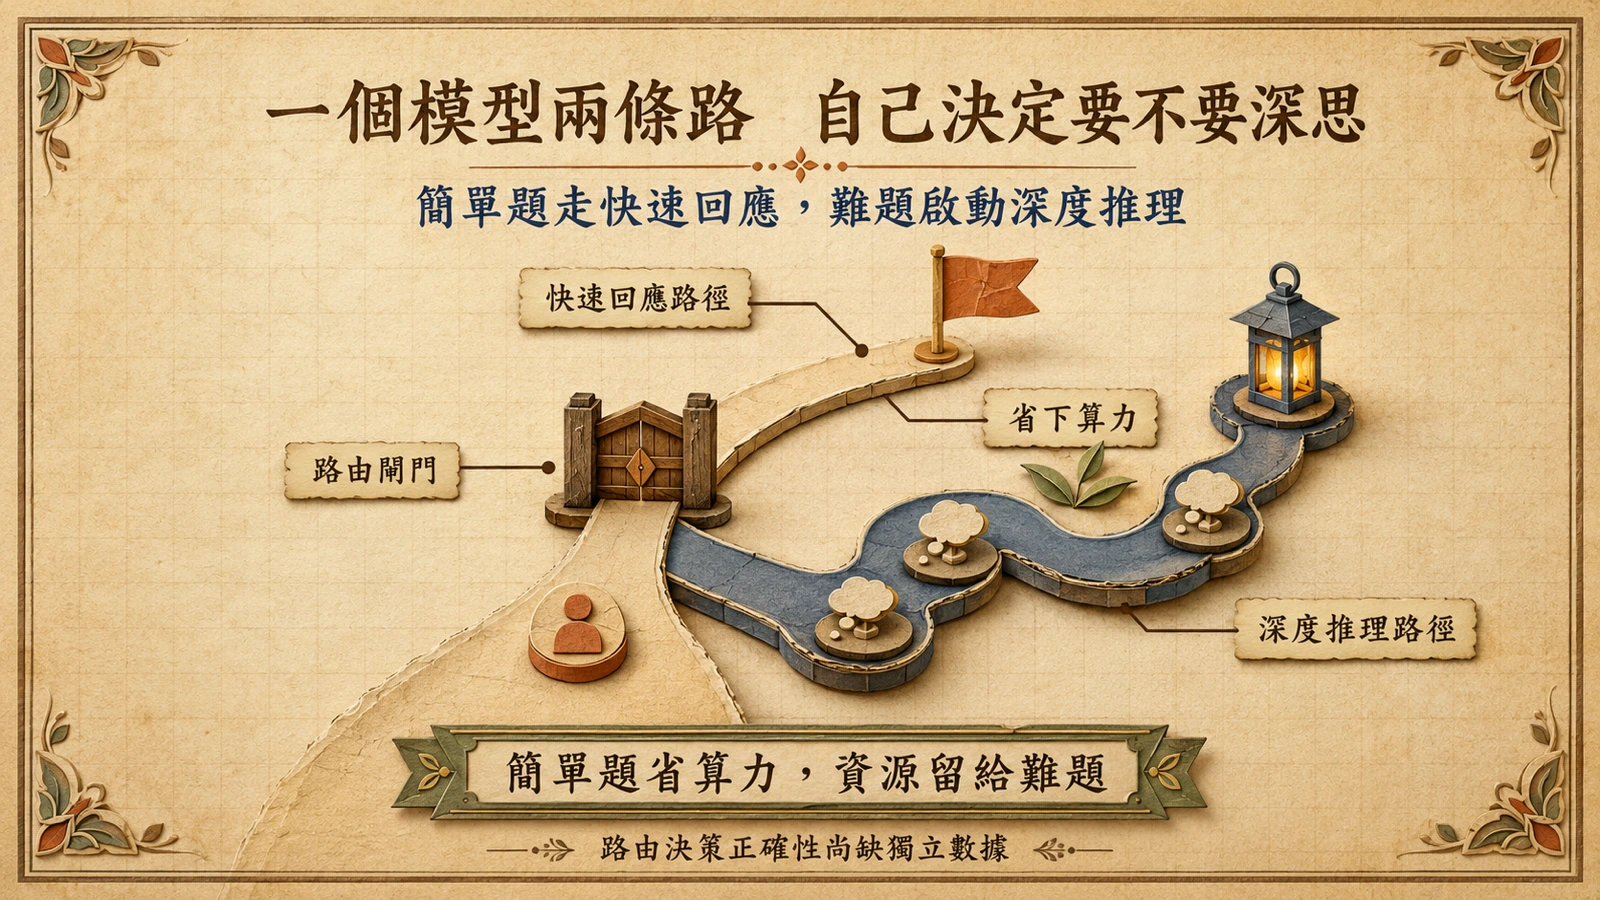
這也是 TTFT 降低 60% 至 80% 宣稱的技術背景——若模型能正確判斷何時跳過冗長推理,長輸入情境下的首字延遲自然下降。但混合推理的驗證難度也更高:模型是否在該深思時偷工、在該快速時卻過度推論,需要更細的場景化評測,而目前官方公布的指標仍以聚合分數為主,缺乏針對「路由決策正確性」的獨立數據。
稀疏架構的代價:顯存與路由穩定性
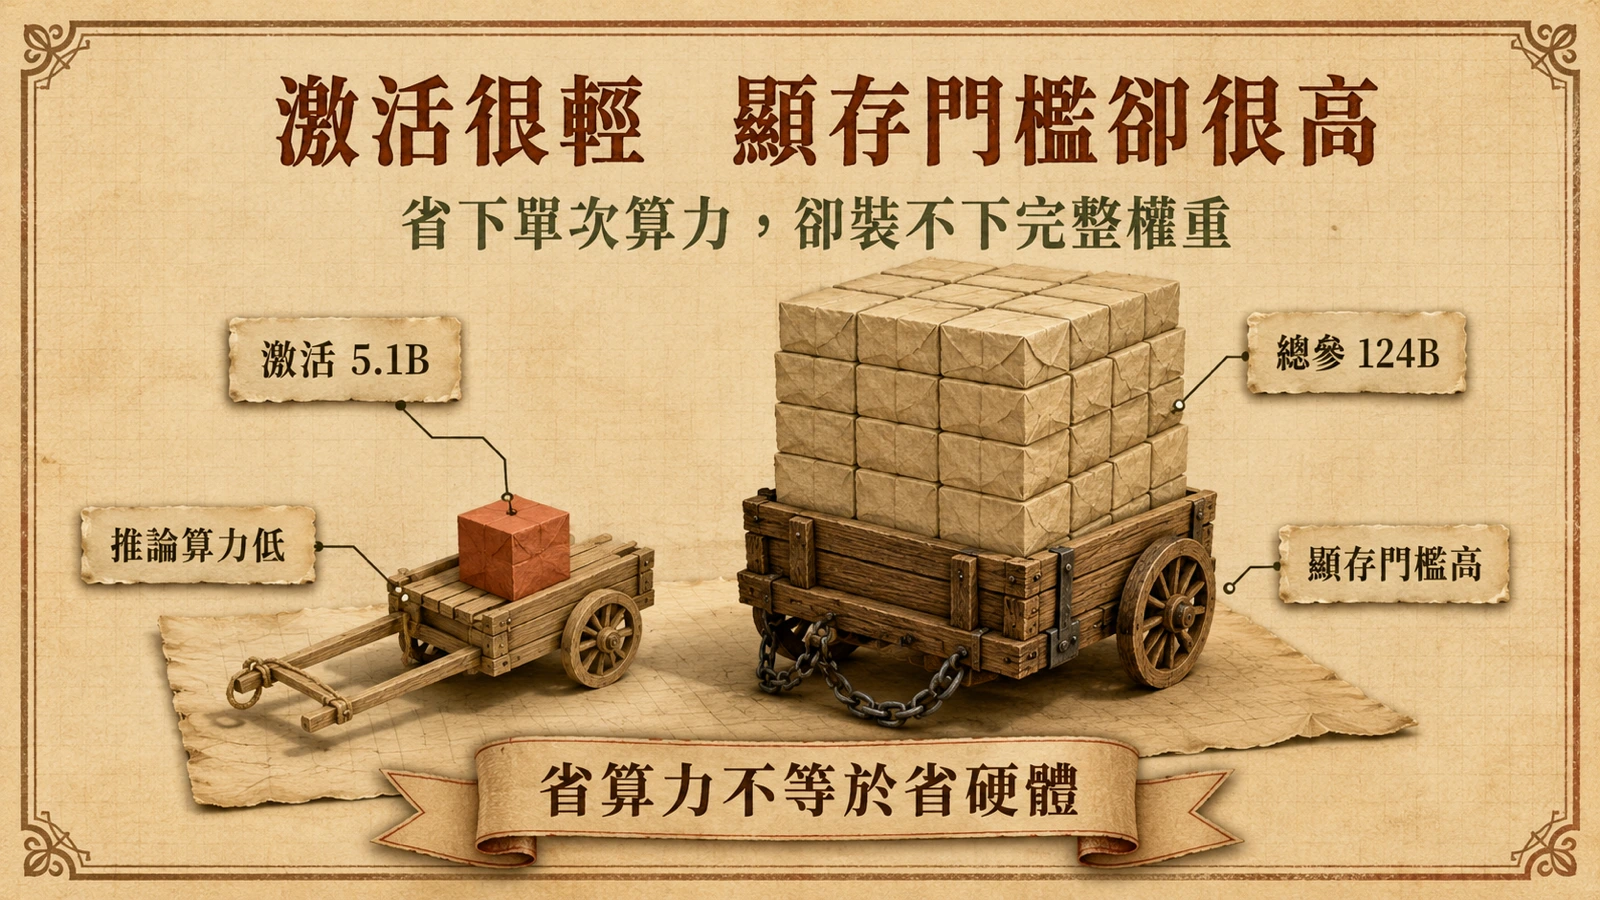
1/64 稀疏 MoE 把激活量壓到 5.1B,推論成本逼近中小型稠密模型,但代價並非為零。稀疏 MoE 的總參 124B 全部必須駐留在記憶體(或以卸載分層載入),意味著實際部署的顯存門檻遠高於 5.1B 這個激活數字所暗示的水準;對沒有大顯存硬體的團隊,省下的是單次推論的算力,而非可承載的硬體規格。混合線性注意力進一步把長序列的注意力成本從平方級降到近線性,是 TTFT 與長文本處理得以改善的另一根支柱。
第二個代價是路由穩定性。MoE 的品質高度依賴專家路由是否把 token 送對分流,稀疏度越高(1/64 意味每個 token 只激活一小群專家),單一路由誤判對輸出的影響越被放大。官方宣稱對標 1T 旗艦,但這類架構在邊界案例、罕見領域上的表現往往比稠密模型更不穩定,仍需等權重公開後的社群實測,才能確認「低成本是否以長尾品質為代價」。
對標上一代 1T 旗艦的宣稱
官方宣稱 Ling-3.0-flash 在傳統推理、指令遵循與長文本等指標上「對標甚至超越」上一代旗艦 Ling-2.6-1T(總參量約 1T)。此比較為廠商單方公布,未附獨立第三方評測,相關基準分數尚無法在公開模型卡或論文中查證。inclusionAI 的 HuggingFace 組織頁可見 Ling 2.6 1T 等前代模型的推論空間,佐證旗艦傳承脈絡。
長輸入延遲與 Agent 訓練數據
官方並列出兩項工程數據:在長輸入情境下,首字延遲(TTFT)降低 60% 至 80% 以上;訓練階段擴展至 10,000+ 個可交互環境,用以強化 Agent 場景的能力。這兩項數字同樣來自官方公告,外部尚無法獨立重現,實際改善幅度仍待模型公開後的社群實測。
開源與 API 推論通道
延續 Ling 系列的開源策略,Ling-3.0-flash 預告將開源權重並提供免費 API;inclusionAI 同時維護 HuggingFace、ModelScope,以及 ZenMux 與 OpenRouter 等推論通道。對想以低成本跑強 Agent 的團隊而言,5.1B 激活量意味推論成本接近中小型稠密模型,但「對標 1T 旗艦」的實測表現與 TTFT 改善幅度,仍須等權重完全公開後才能驗證。從產業視角看,中國 AI 業者普遍把自有模型與算力視為長期立足之本(見崑崙萬維方漢的 WAIC 觀點),Ling-3.0-flash 以稀疏架構壓低推論成本,正是這條路線的具體推進。