視訊是真正的難點
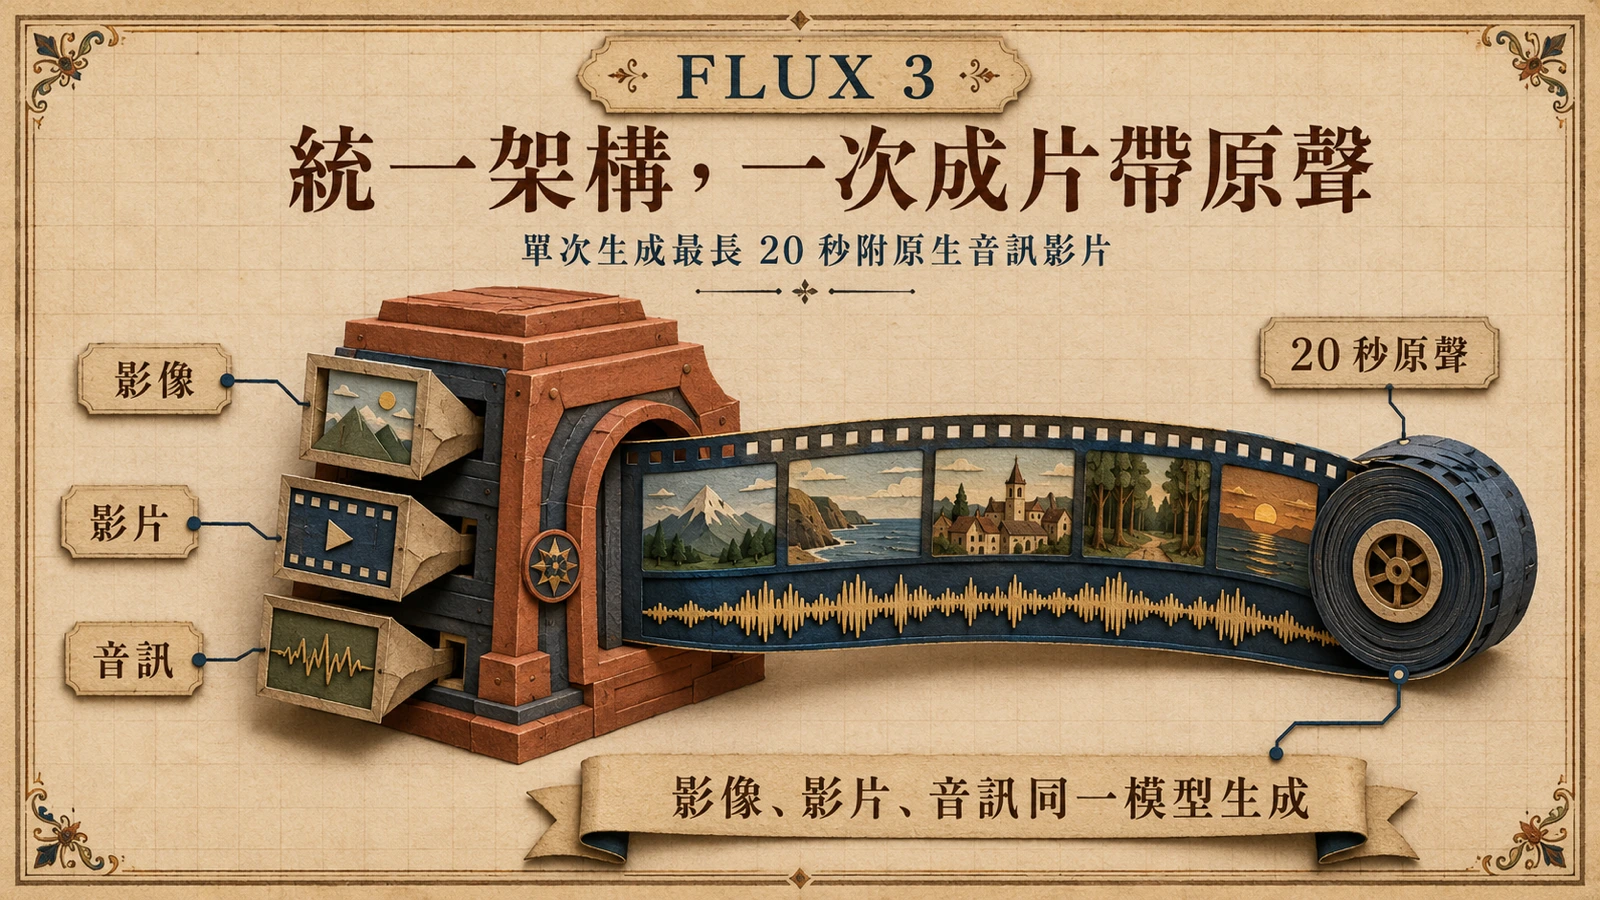
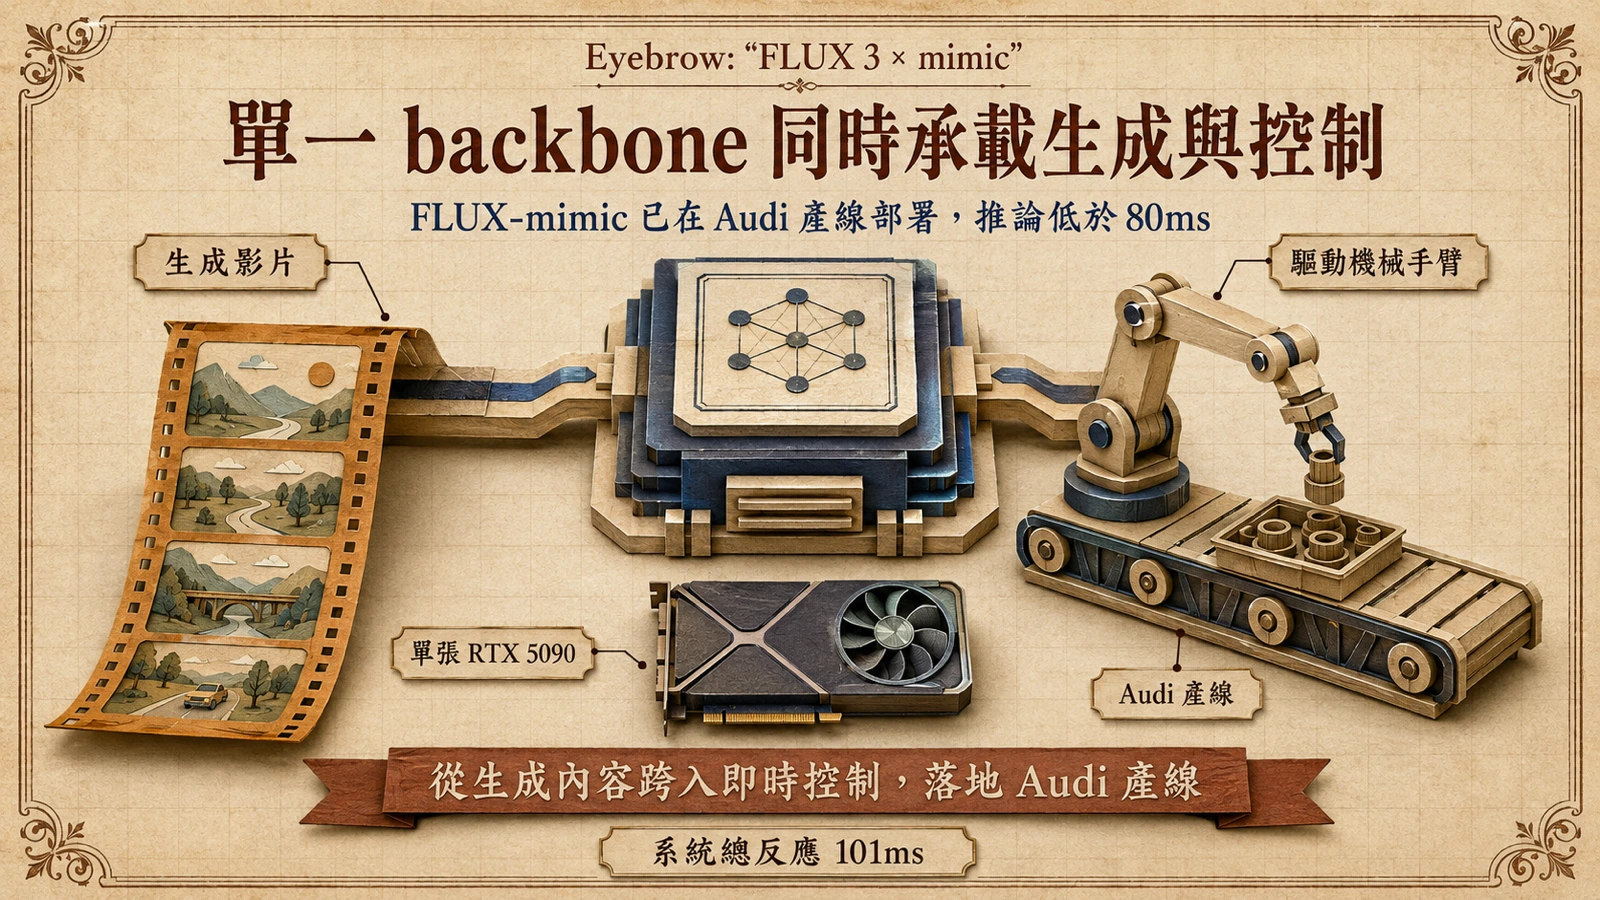
Black Forest Labs 將 FLUX 系列從圖像生成推進到 FLUX 3:一個從最初就聯合訓練圖像、視訊與音訊的單一基礎模型。官方公告指出,視訊預測是整個訓練中最昂貴的一環,占總算力成本 95% 以上;相對之下,音訊在 720p 含音訊視訊中只占不到 0.5% 的 token。要逼真生成視訊,模型被迫學會接觸、運動、重量與因果關係,這正是 FLUX 3 被定位為「世界如何運作」模型、而非單純內容生成模型的原因。FLUX 3 作為多模態基礎模型的完整發表規格與初步影音評測,詳見〈FLUX 3 推出,單次生成 20 秒附聲影片〉。
單一 backbone 同時生成與控制
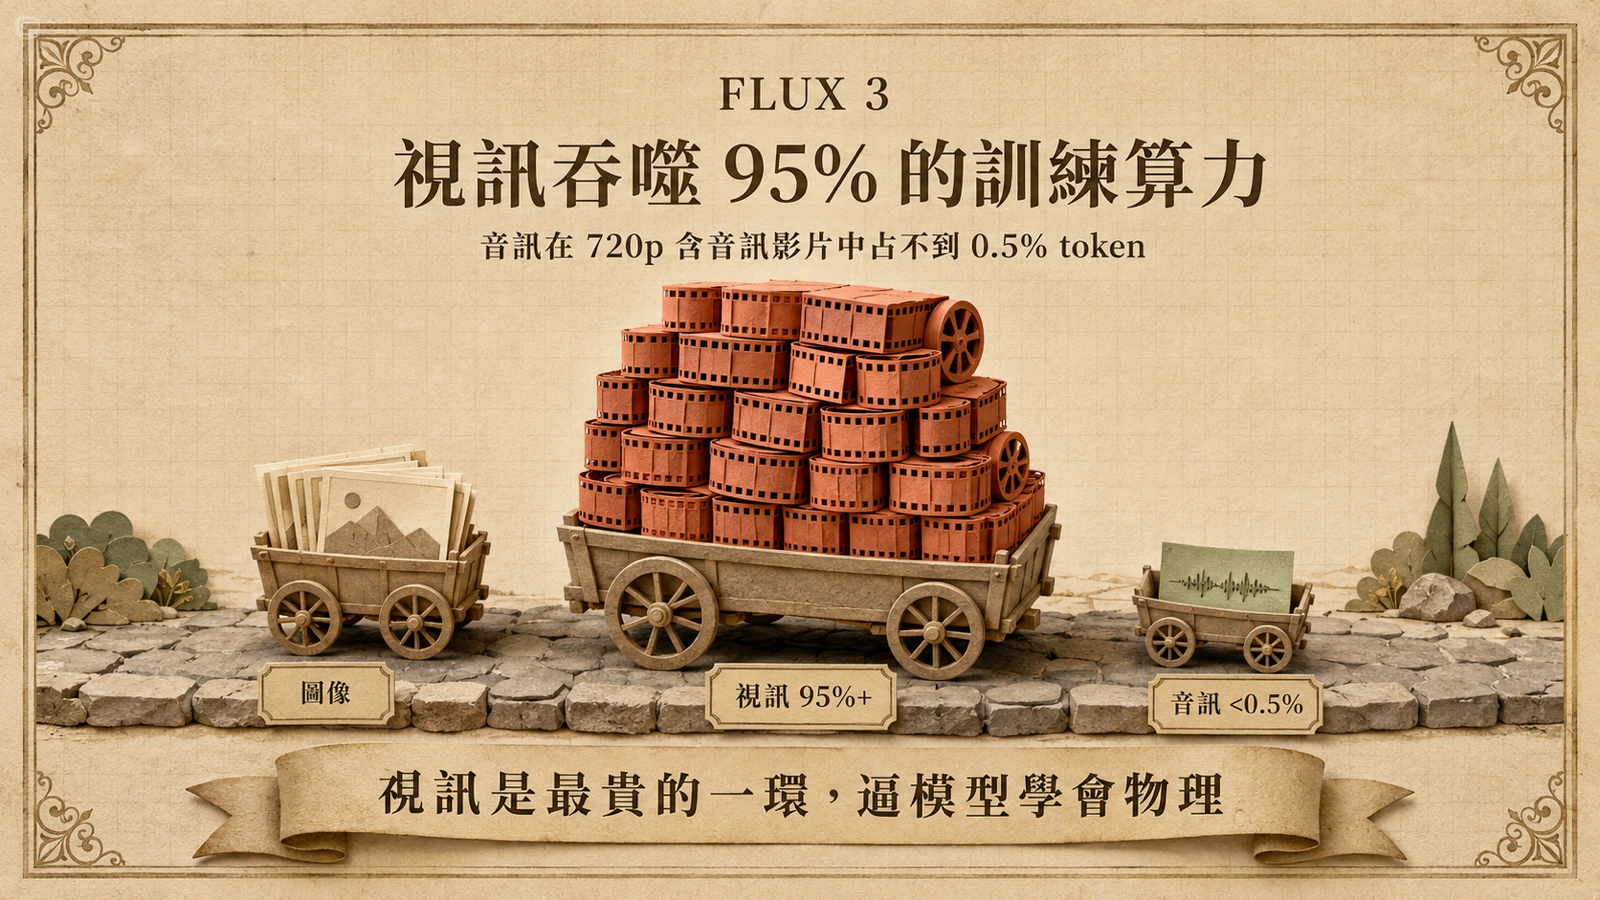
FLUX 3 同時成為 FLUX-mimic 的基礎。這款與 mimic robotics 合作的視訊動作模型,把動作視為與音訊、視訊影格同形態的低維表徵。官方在大規模訓練中實測,加入動作預測後,text-to-video 與 image-to-video 的人類評分一度下滑最多 10%,但經過 3500 步訓練即恢復原有水準。Black Forest Labs 據此主張:動作預測不需另立基礎模型,同一個 backbone 即可同時承載生成與控制。
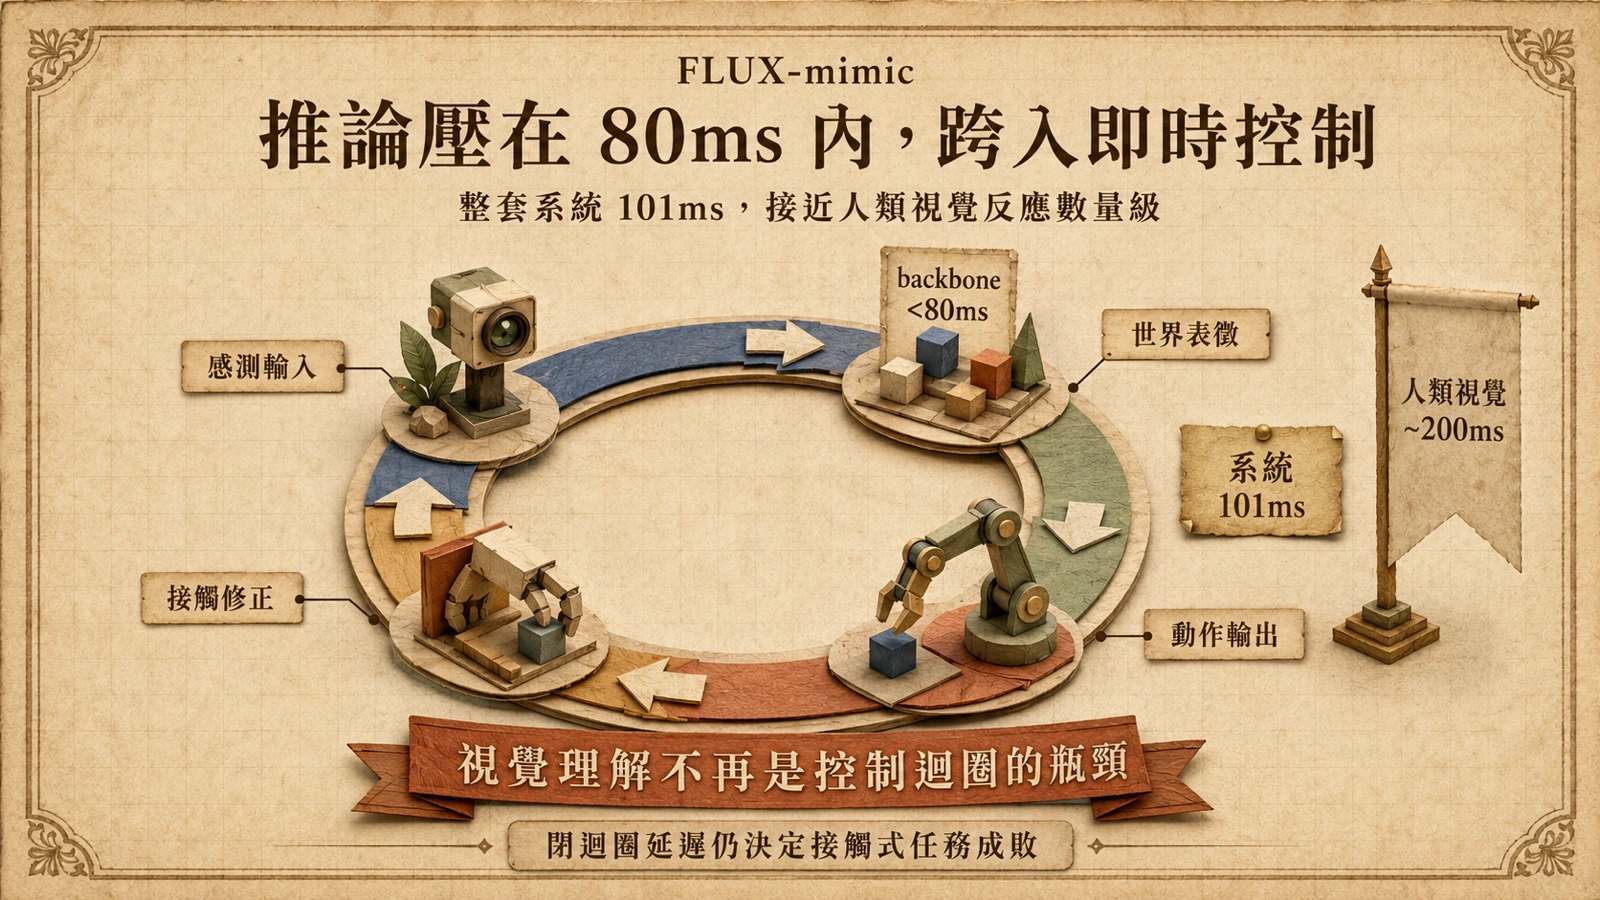
FLUX-mimic 在 mimic 最佳化的部署堆疊下,backbone 從輸入到世界表徵可在單張 NVIDIA RTX 5090 上以低於 80ms 完成,整套機器人系統反應時間為 101ms,接近人類視覺反應速度的數量級。
80 毫秒控制迴路的工程含義
101ms 的系統反應時間(其中 backbone 推論低於 80ms)值得單獨拆解。機器人接觸式操作的成敗,往往取決於感知到動作修正的閉迴圈延遲:延遲過長,機械手會在收到「施力過大」的訊號前就把零件壓壞。人類視覺反應約在 200ms 數量級,而需要精細接觸控制的工業任務通常要求控制迴圈顯著快於此。FLUX-mimic 在單張 RTX 5090 上把「從感測輸入到世界表徵」壓在 80ms 內,意味著視覺理解不再是控制迴圈的瓶頸——這是生成式世界模型從「產出內容」跨入「即時控制」的關鍵門檻。在此之前,機器人視覺理解與動作控制通常是兩套獨立系統,世界模型則讓兩者在同一個前向傳遞中完成。
從實驗室走到 Audi 產線
mimic 已將 FLUX-mimic 部署於 Audi 產線的實際任務,涵蓋零件分揀入盤、電子控制單元插入緊配合件、零組件組裝,以及密封條、線材等軟性可變材料處理——這些過去向來是傳統自動化難以經濟化的工作。Audi Production Lab 的 Christoph Schneider 表示,這些機器人解決了傳統機器手臂根本無法勝任的軟體操作,對協助員工、提升效率與擴大彈性自動化具重大潛在影響。
這些任務有一個共同特徵:工件的位置、形狀或剛性在每次操作中都會變動。傳統機器手臂依賴預先程式化的固定路徑與夾具定位,假設每個零件都出現在精確已知的位置;一旦零件姿態隨機、材料可變形(例如軟性密封條會因擠壓而改變形狀),這條假設就失效,必須為每個變體重新設計夾具與流程,成本往往高到不具經濟性。FLUX-mimic 的價值主張正在於此:模型先用世界表徵學會「接觸、運動、重量」的物理直覺,再把這套直覺解碼成當下的動作,因此能在不重新工程化的前提下適應工件變異。這也是 Schneider 所說「根本無法勝任」的具體含義——不是算力問題,而是固定路徑範式無法處理可變物理。
對決策者的訊號很明確:生成式世界模型與實體機器人正在同一個 backbone 上收斂。當模型先把世界學好,新任務只需要把既有知識解碼成動作,樣本效率與可轉移性由此而生,而非靠任務專屬工程。