統一架構聯合學習影像、影片、音訊
Black Forest Labs 於 7 月 23 日宣布,以 Early Access 方式推出 FLUX 3 多模態基礎模型。不同於將各類輸出交給獨立模型,FLUX 3 在同一架構內同步學習影像、影片與音訊,理由是任一單一模態都只是同一物理現實的投影,唯有聯合訓練才能讓「聲音對應撞擊、運動服從質量、未來銜接過去」等相互約束同時成立。模型建構於其先前提出的 Self-Flow 框架,並在此代大幅擴展運算與資料規模。在生成式模型走向統一架構的趨勢下,FLUX 3 與各自分工的同期模型形成路線對比——如主打美學個人化的〈Midjourney V8.2〉,或同樣鎖定影片生成的〈SANA-Video 2.0〉。
為什麼必須聯合訓練
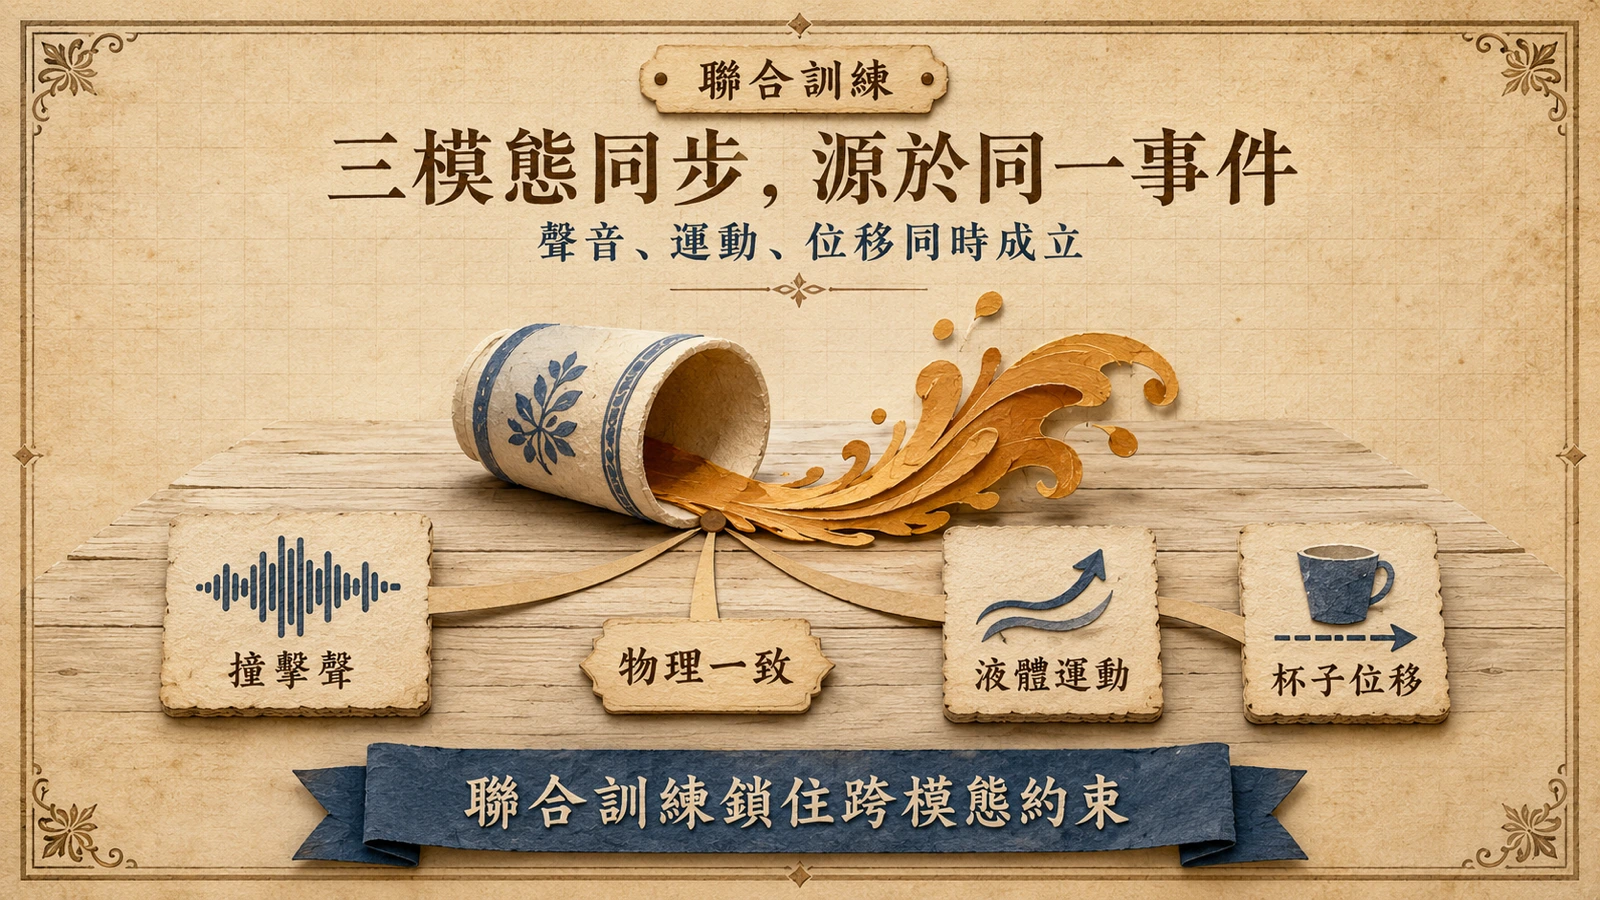
「聯合學習」聽起來像工程便利,背後其實是一組物理一致性的論證。在真實世界裡,一杯水被敲翻時,聲音、液體運動與杯子位移是同一個事件的三個投影;若把影像、影片、音訊交給三個獨立模型各自生成,再事後拼接,每個模型只看到自己那個投影,彼此之間沒有共享的因果約束,結果就是「嘴巴在動但聲音晚半拍」「重物落地卻沒有對應撞擊聲」這類一眼就看穿的出戲感。聯合訓練的價值,在於讓單一架構在學習過程中同時背負這些跨模態約束,使「聲音對應撞擊、運動服從質量、未來銜接過去」不是後處理能補上的特效,而是模型內建的一致性。
這也解釋了為何 Black Forest Labs 把 FLUX 3 稱為「基礎模型」而非影片模型——它的野心是用一個統一表徵同時服務多種輸出。代價是訓練複雜度與資料工程成本遠高於單模態路線,這也是為什麼官方選擇 Early Access 而非直接全面開放;先在受限範圍驗證聯合訓練的物理一致性收益,再決定後續影像與編輯能力的釋出節奏。
單次生成 20 秒附原聲影片
在影片能力上,FLUX 3 可在單次生成中輸出最長 20 秒、附帶原生音訊的影片,支援文生影片、圖生影片、影片生影片、輸入影片與音訊續寫、關鍵幀轉影片、多語言對話,以及將多個片段串接為多鏡頭序列。官方補充,模型在人物表情捕捉、聲音與物理事件關聯、多語言生成等方面表現較突出,並具備風格與長寬比的多樣性。影像生成與編輯能力則預計在後續數週進入 Early Access。同類「影片加原生音訊」路線可對照 MiniMax-H3 的 ComfyUI 無頭工作流;若關注單次 30 秒與多輪續寫,則可參考 Seedance 2.5。
初步評測與開放路線圖
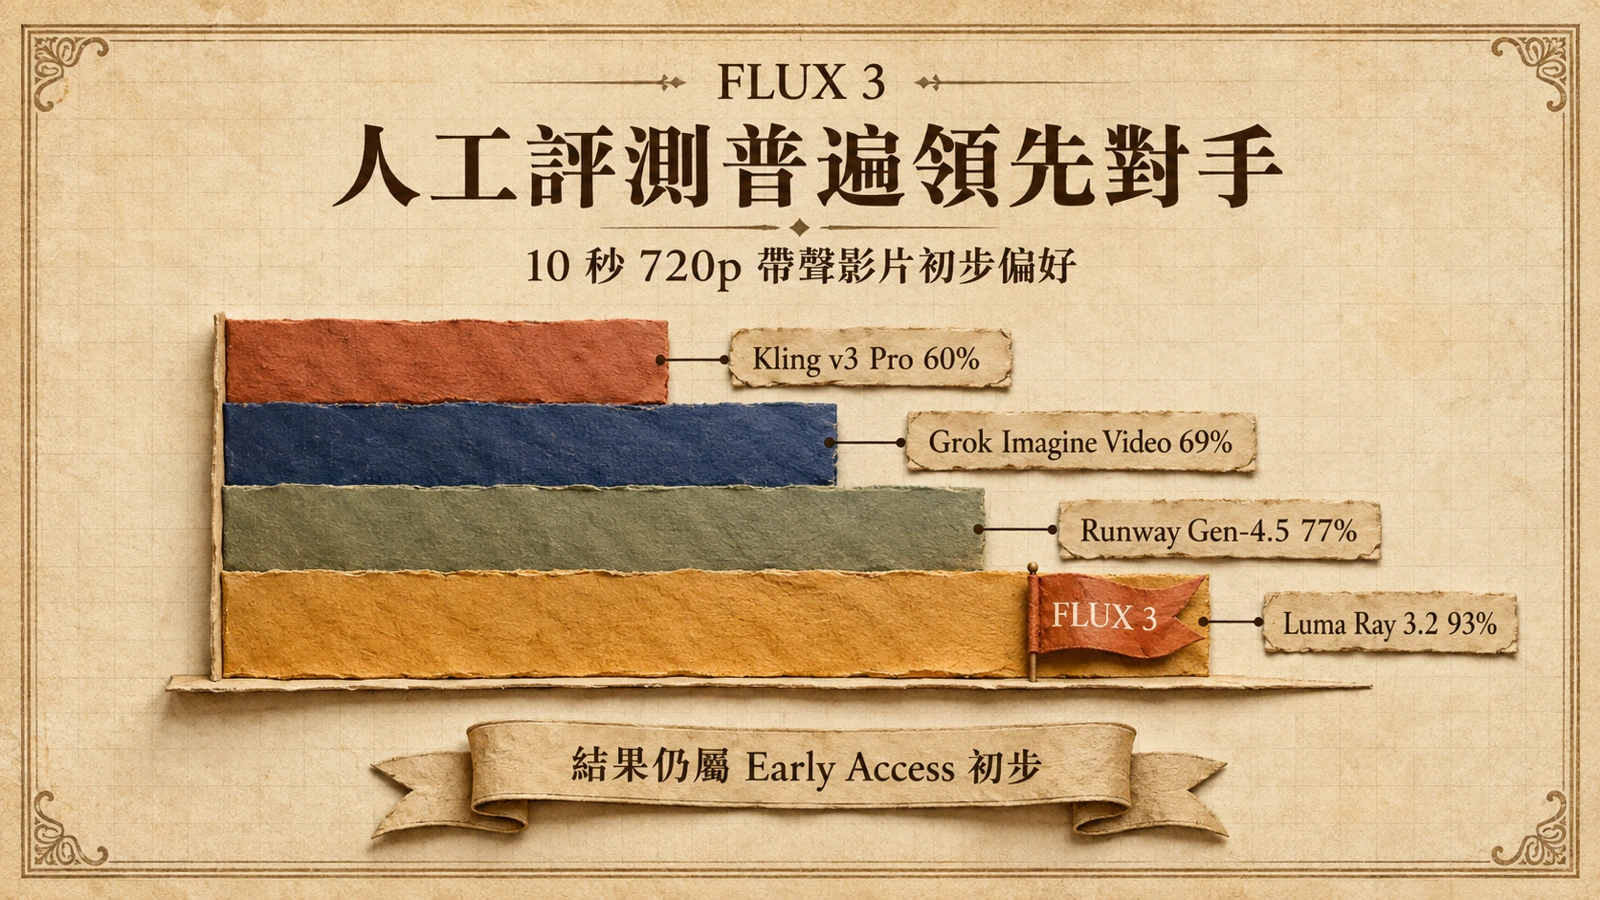
官方公布以 10 秒、720p 帶聲音的文生影片進行初步人工評測。在這項早期測試中,FLUX 3 被偏好的比例為:對 Grok Imagine Video 達 69%、Kling v3 Pro 60%、Seedance 2.0 與 Gemini Omni Flash 各 52%、Runway Gen-4.5 達 77%、Luma Ray 3.2 達 93%。Black Forest Labs 強調結果仍屬初步,Early Access 期間會持續改善。
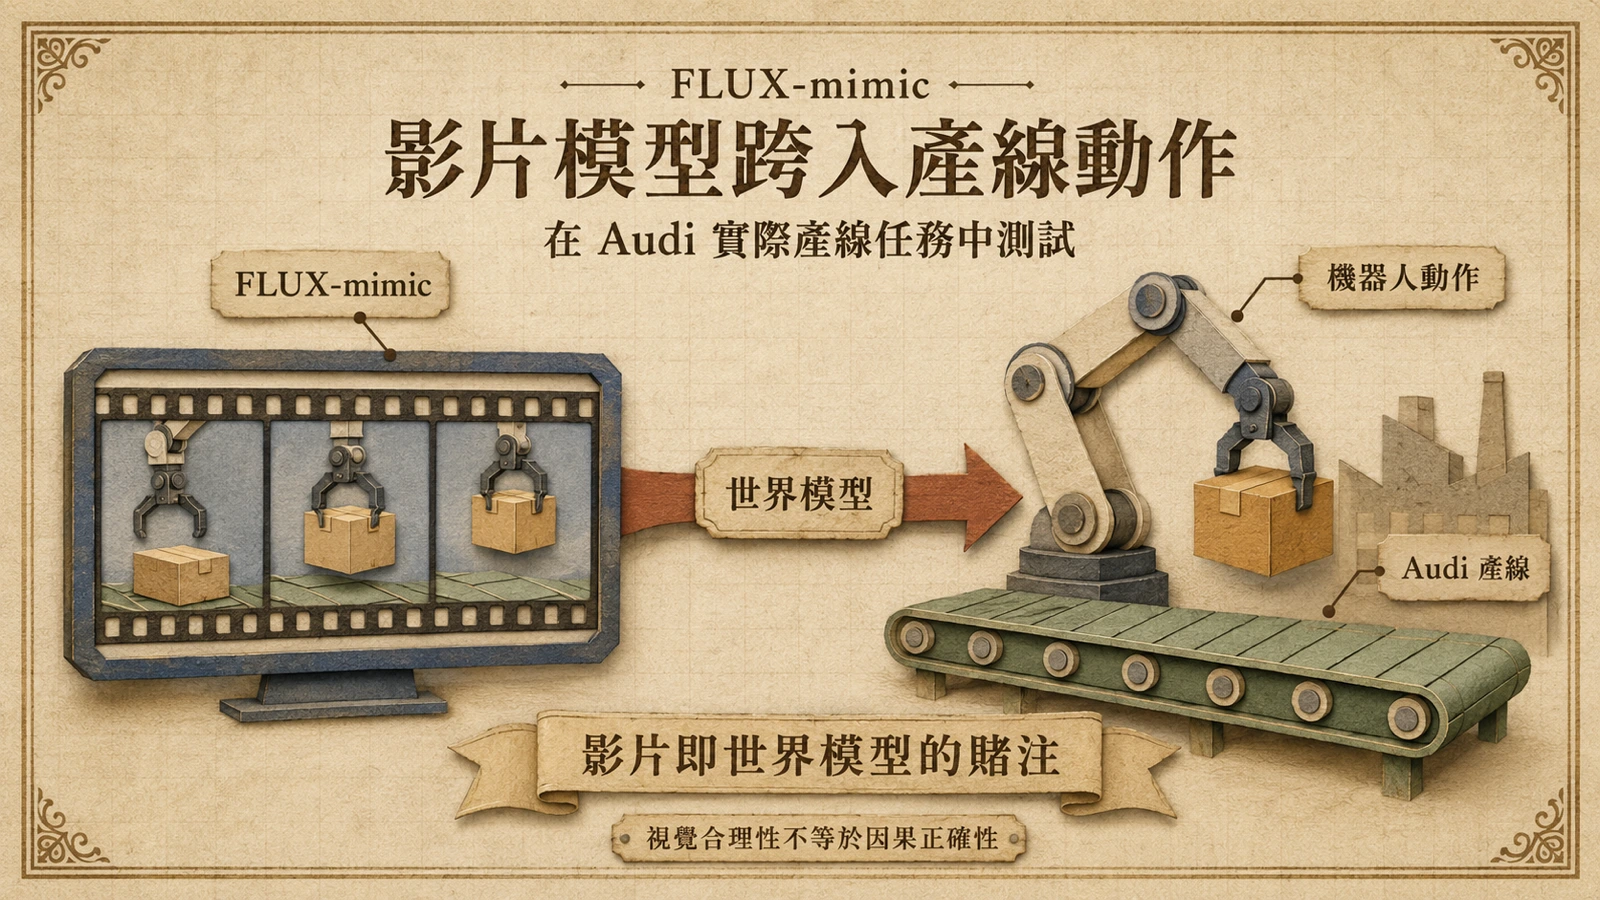
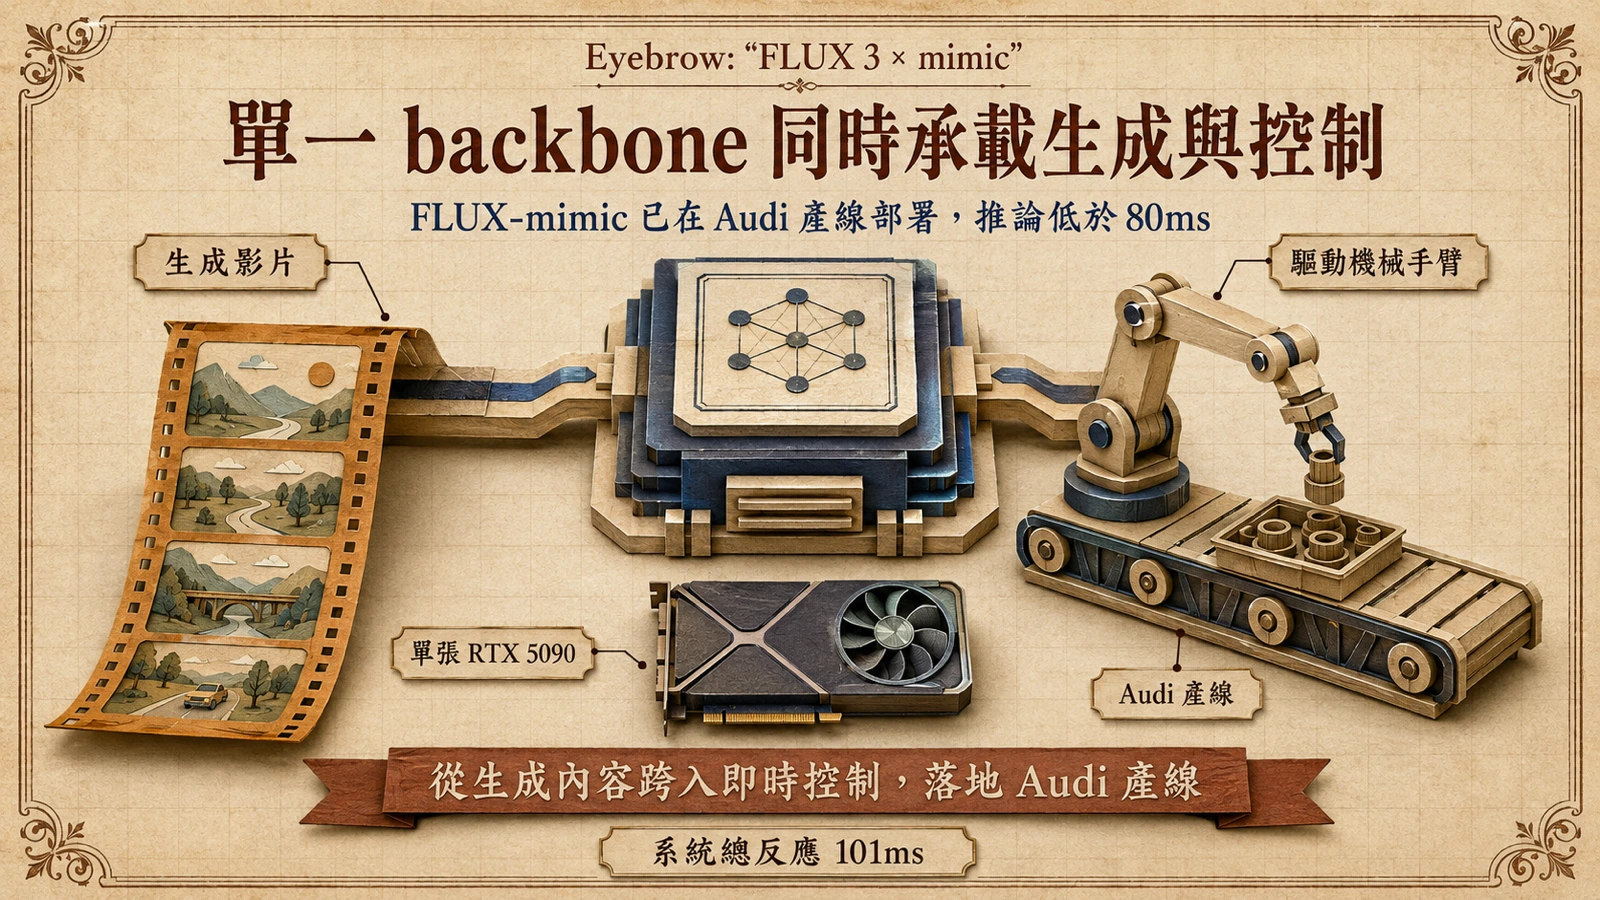
商用部署方面,FLUX 3 已與 Mimic Robotics 合作推出 FLUX-mimic 影片-動作模型,並在 Audi 的實際產線任務中測試,作為機器人動作預測的探索方向。FLUX-mimic 在 Audi 產線的實際部署任務與推論規格,詳見〈FLUX-mimic 攜手 mimic 在 Audi 產線部署〉。若需求集中在語音而非影音聯合生成,Qwen-Audio-3.0-TTS 的盲測排名與定價提供了另一條可比較的品質軸。後續將分階段釋出 FLUX 3 Video、FLUX 3 Image、研究與商用夥伴用的 FLUX-mimic 與 FLUX 3 Action,以及開源權重的 FLUX 3 Dev。對決策者而言,觀察重點在於統一架構能否壓低多模態內容產製成本,以及開源骨幹釋出後對在地應用鏈的擴散效應。
從影片到機器人動作:統一架構的世界模型賭注
FLUX-mimic 在 Audi 產線的測試不只是一樁商用合作,而是 Black Forest Labs 路線選擇的關鍵訊號。若 FLUX 3 真的在聯合訓練中內化了「運動服從質量、聲音對應撞擊」的跨模態物理約束,那麼同一組隱藏表徵理應能遷移到機器人動作預測——這正是「影片即世界模型」的論點,也解釋了為何一家影像公司願意把模型推進工廠產線。硬體與資本端可對照宇樹科技人形機器人 IPO 的出貨、研發與估值資料;它呈現的是具身智能公司已量產後的商業檢驗。風險在於:影片生成衡量的是視覺合理性,機器人控制要求的卻是因果正確性與樣本效率,兩者的安全與成本結構完全不同。一段看起來流暢的搬運影片,並不保證模型理解重力、摩擦與接觸力的真實邊界;一旦物理直覺只是「像素級近似」而非因果模型,產線部署的誤差容忍度會立刻把這個差距放大成報廢與停線成本。換言之,FLUX 3 的統一架構是否真正具備世界模型的遷移力,Audi 產線的良率數字會比任何影片評測更早給出答案。