hill-climbing 把前沿能力搬進自家產品
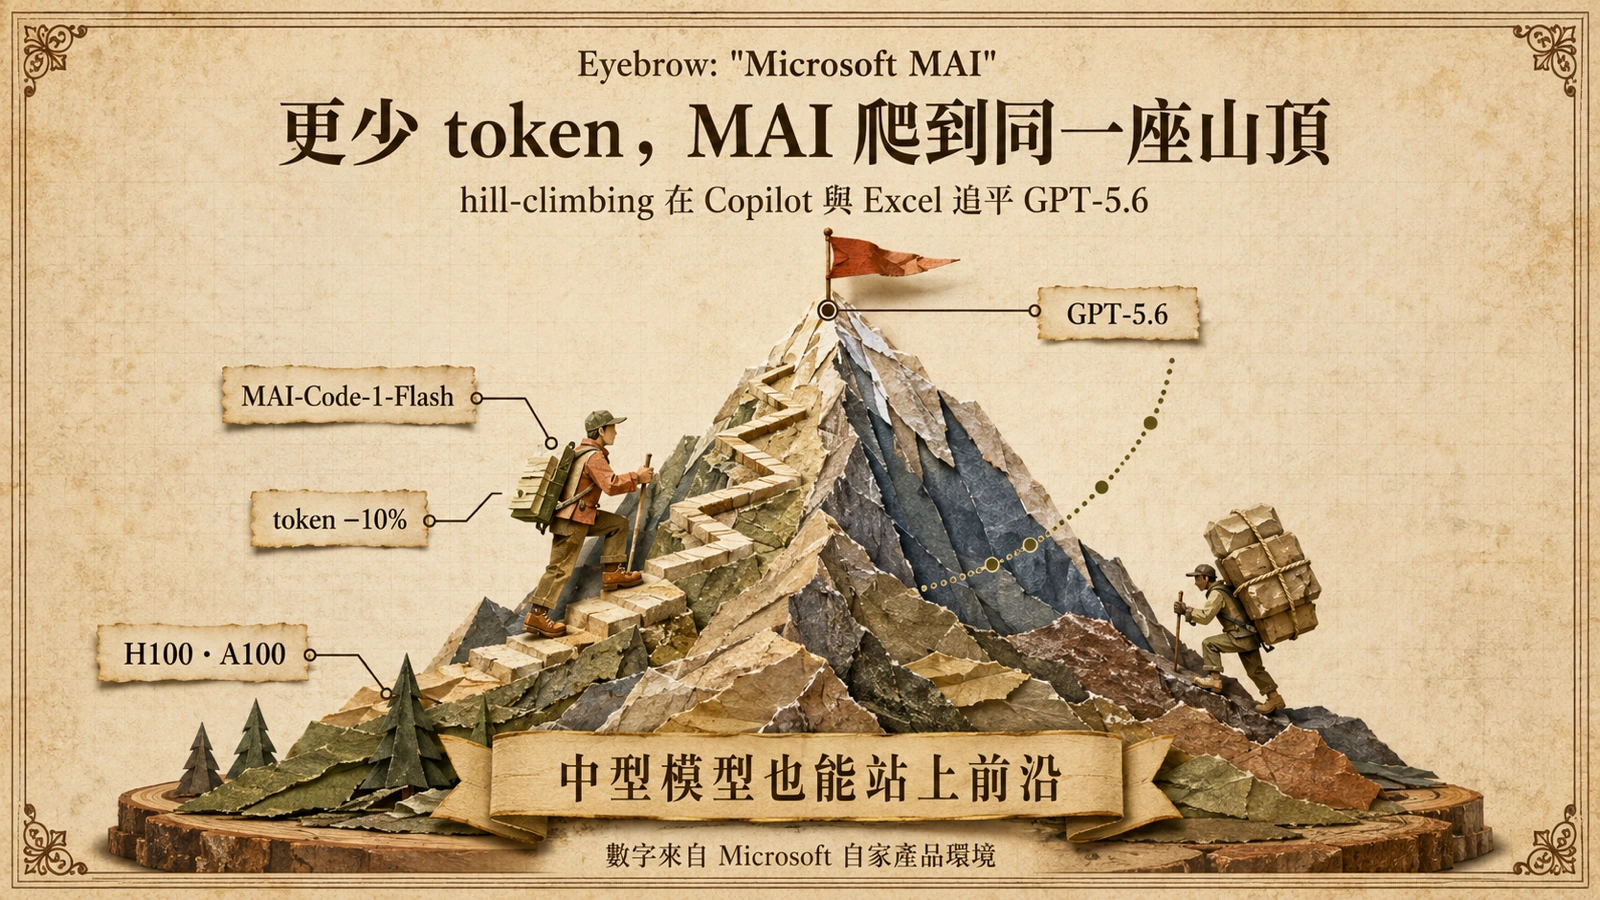
Microsoft Superintelligence 團隊公開 hill-climbing 機制的首批產品案例:MAI 模型在 GitHub Copilot 與 Excel 內部完成產品化訓練,目標不是衝單一基準,而是在真實任務上把「品質-成本」曲線持續往上爬。CEO Satya Nadella 在 X 上的說法更直白:來自 OpenAI 與 Anthropic 的前沿模型、MAI 模型、編排框架、記憶與工具,共同組成一套可替換的爬山系統,重點是即便抽換掉某個模型,評估指標仍能繼續爬山。
關鍵設計是把編排框架、記憶、上下文、技能外化於模型之外,並在產品內的 reinforcement learning environment(RLE)中訓練模型,讓它針對使用者真正在乎的任務獲得獎勵。
hill-climbing 的機制拆解:外化編排、產品內 RL
hill-climbing 的名稱取自最佳化理論裡的爬山演算法——不追求一次跳到全域最佳解,而是沿著品質-成本曲線持續往上爬。Microsoft 的工程化版本拆成三層:第一層是把編排框架、記憶、上下文、技能這些過去被「焊」在模型提示詞裡的能力,外化為模型之外的獨立元件;第二層是在產品內建一個 reinforcement learning environment(RLE),把使用者真實在乎的指標(code accept rate、回訪比例、任務完成度)轉成獎勵訊號;第三層是讓模型在這個環境裡反覆訓練,逐步把中型模型推到該任務的前沿。
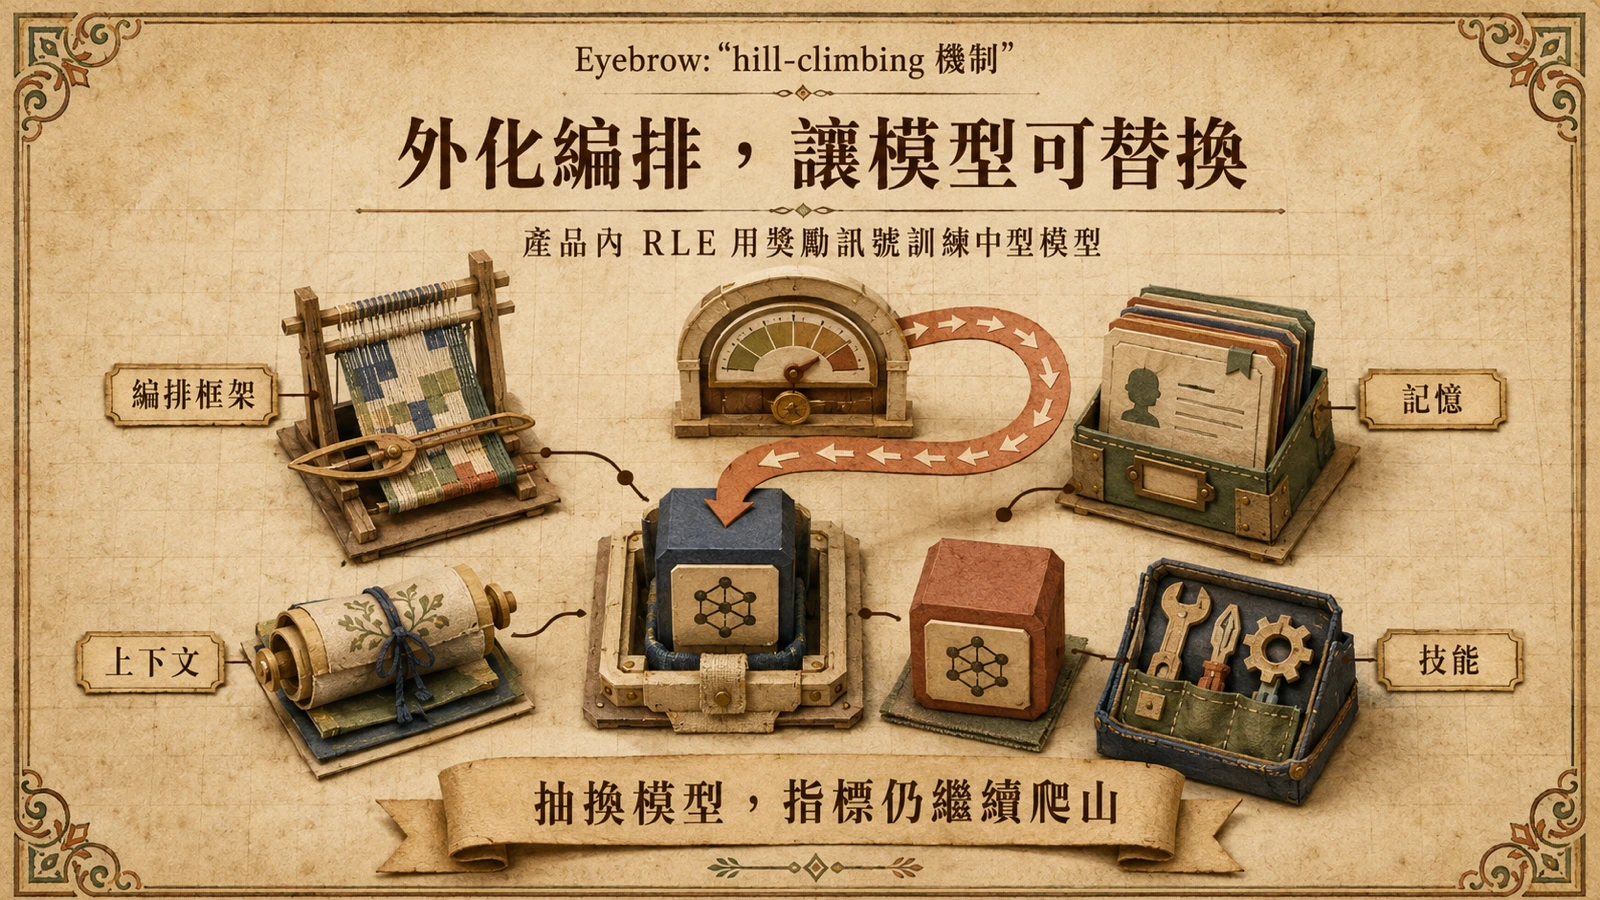
這套設計的最大後果是「模型可替換性」。當記憶、工具、上下文都不綁死在單一模型內部,OpenAI 的 GPT 系列、Anthropic 的 Claude、或自研 MAI 模型就能在產品堆疊裡互換,而評估指標仍能繼續爬山——這正是 Nadella 所稱「即便抽換掉某個模型,指標仍能繼續爬山」的技術基礎。它也解釋了為何 Excel 能從 Copilot 的程式碼模型遷移而知識工作能力不墜:被搬移的不是模型本身,而是那套外化的編排與 RLE 訓練框架。
GitHub Copilot 與 Excel 的實測數字
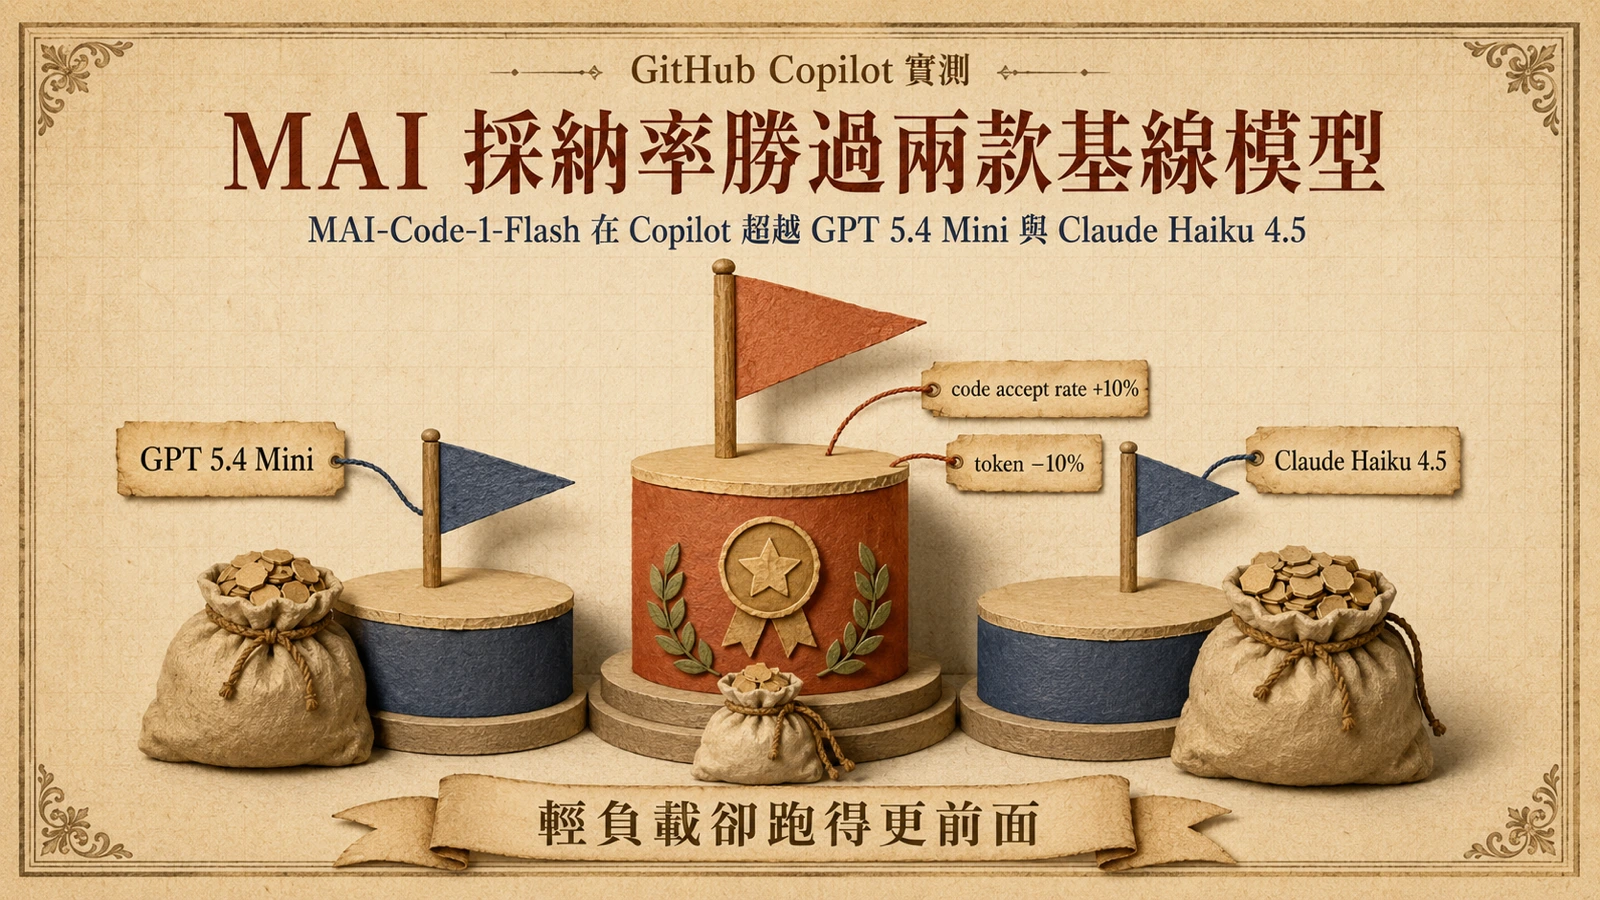
MAI-Code-1-Flash 自 6 月 Build 大會後部署進 GitHub Copilot,已被「數百萬開發者」日常使用,Microsoft 給出的對比基線是 GPT 5.4 Mini 與 Claude Haiku 4.5:
- 在 VS Code 的 code accept rate 高出約 10%。
- 開發者多日回訪的比例較 GPT 5.4 Mini 高 6%、較 Claude Haiku 4.5 高 11%。
- 中位數 token 用量降低約 10%,且使用者主動發起的 turn 更多。
Excel 則驗證了「從程式碼遷移到知識工作」的可移植性:以 MAI-Code-1-Flash 為起點,在 Excel RL 環境中再訓練,得到的模型在常見任務上與 GPT-5.6 相當。由於模型更小、更有效率,能在 Nvidia H100 與 A100 級 GPU 上同時服務,不必綁定最新一代加速器,這對 Microsoft 的部署成本是直接降低。
對企業的模板意義
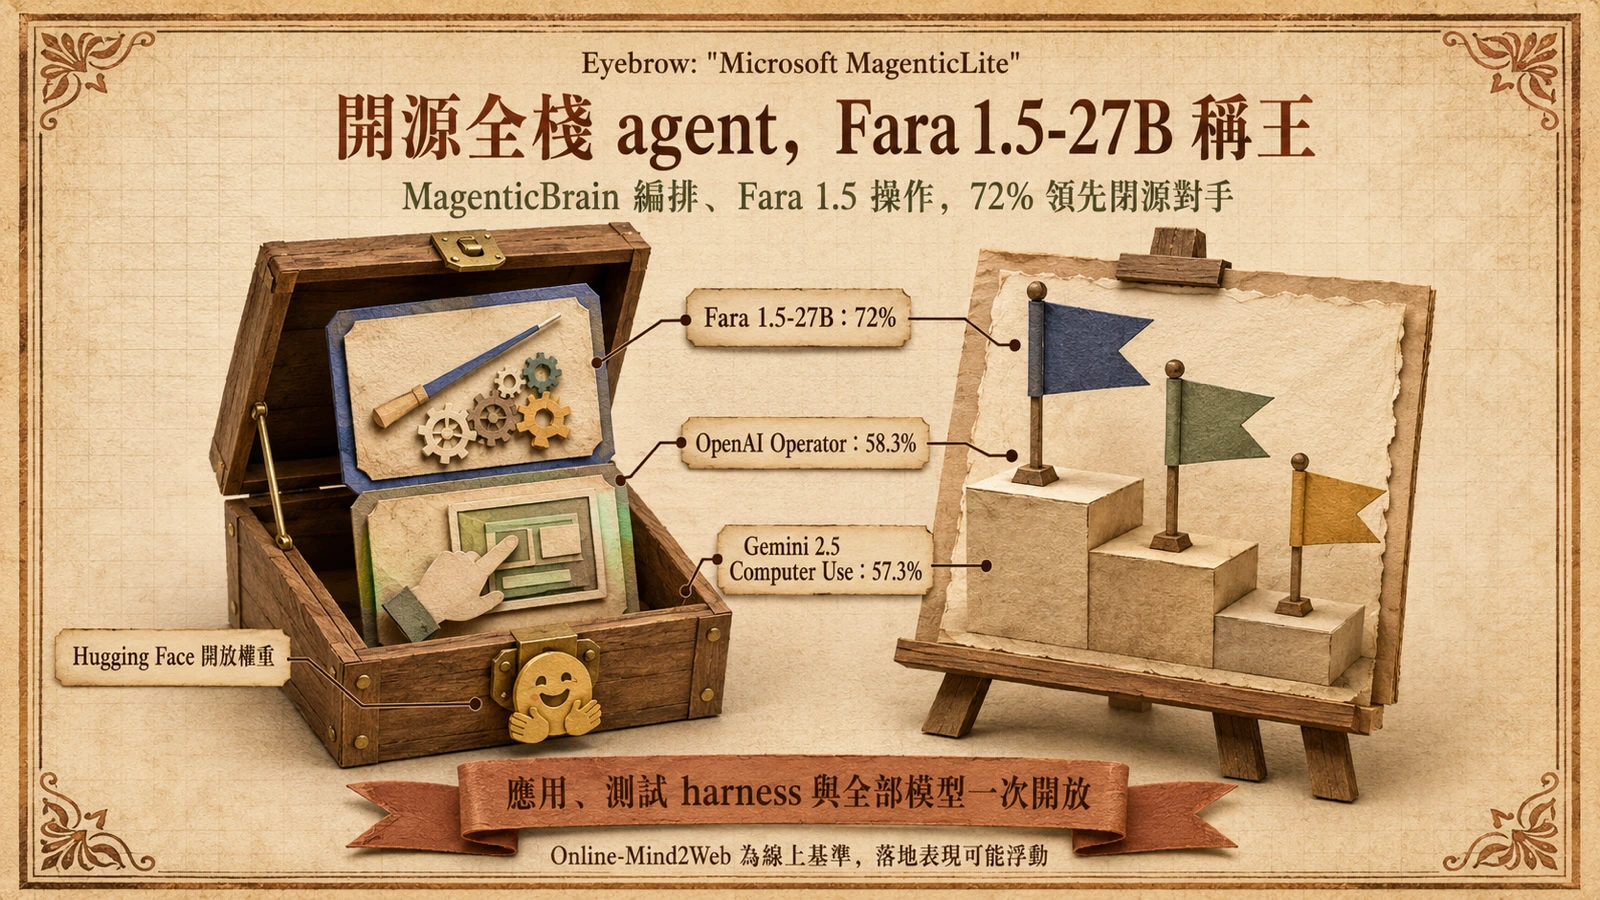
Microsoft 強調這套流程並非自用專利:相同的第一方產品堆疊——模型、harness、agent、產品特定評估——正是企業可在 Foundry 與 Frontier Tuning 上自行複製的模板,用自有評估體系、自有 RLE、工作流與上下文訓練出符合自身任務的專用模型。在 agent 層,Microsoft 也已把〈MagenticLite〉整套 agent 堆疊(含 MagenticBrain 編排與 Fara 電腦操作模型)開源到 Hugging Face,讓同一套產品堆疊可供外部研究與改作。
下一步將把 hill-climbing 延伸到 Copilot Chat、Outlook、PowerPoint 等更多產品。
數字來自 Microsoft 自家產品環境
上述所有對比數字——code accept rate、回訪比例、token 用量——均來自 Microsoft 自家產品環境(GitHub Copilot 內部遙測),而非獨立第三方評測。這些數字具有真實世界的生態效度(反映數百萬開發者的日常使用),但缺乏獨立可重現性:外部研究者無法存取 Copilot 的內部指標定義、使用者分群邏輯與統計方法,也無法排除「MAI 模型因與產品深度整合而獲得 GPT 5.4 Mini 不享有的上下文優勢」這類混淆變數。
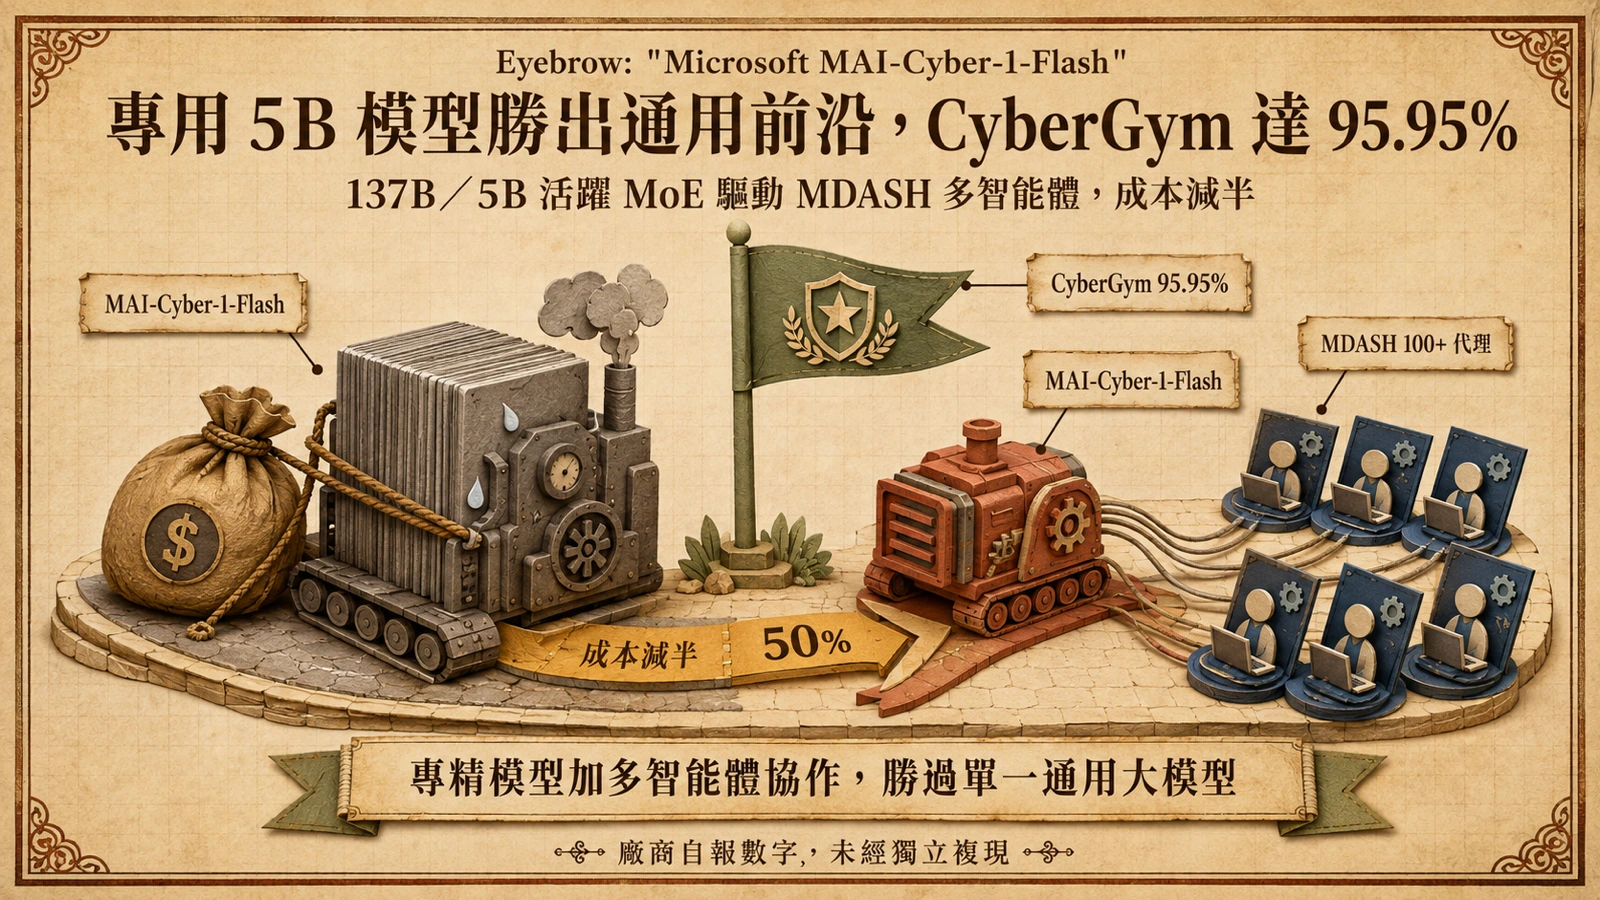
換言之,這些數字證明的是「在 Microsoft 的產品堆疊中,MAI 模型可以達到與或超越通用模型的使用者體驗指標」,而非「MAI 模型在模型層面優於 GPT 5.4 Mini」。前者對 Microsoft 的部署策略已有足夠意義——它證明了 hill-climbing 的工程化路線可行——但採購方在引用這些數字時應理解其適用範圍的邊界。若要把這些數字換成可重跑的外部比較框架,可對照 Tencent WorkBuddy Bench 的 Code、Web、Office、Security 四領域評測——它不直接評測 MAI,卻提供了獨立、可審計的任務結構,讓其他模型的產品化成果有可比的基準。對決策者的訊號是:前沿能力的競爭正從「誰有最大的模型」轉向「誰能用產品內資料把中型模型爬到任務前沿」,而 Microsoft 正試圖把這條路徑包裝成可販售的平台服務。由於這些數字來自 Microsoft 自家產品環境,採購方仍應搭配外部任務評測。同一條 hill-climbing 路線也延伸到了資安領域:MAI-Cyber-1-Flash 正是 MAI-Code-1-Flash 的網安微調版本,以 5B 活躍參數驅動 MDASH 在 CyberGym 達 95.95%。