MiniMax-H3:一次生成影片與原生音訊的開源全模態模型
MiniMax-H3 是 MiniMax 於 7 月 31 日發布的開源全模態生成模型。根據官方模型卡,它能在統一的上下文裡理解文字、影像、影片與音訊,並產出附帶原生立體聲音訊的影片,解析度最高 2K、幀率 24fps、時長約 15 秒。和同樣主打「影片與原生音訊一次生成」的 FLUX 3 相比,MiniMax-H3 把這項能力以開放權重釋出,讓任何人都能在自己的 GPU 上跑,閉源陣營則有〈Seedance 2.5〉。
它最關鍵的設計是 H3-Omni-Transformer:模型在同一個排程裡聯合預測影片與音訊的潛空間,再分別解碼成影片與立體聲,而不是先生成畫面、再疊上配樂與對白。MiniMax 在發布文章中把它定位為承接 Hailuo 01、Hailuo 02 之後的第三代系統——Hailuo 01 從零打造基礎,Hailuo 02 著重架構效率、資料品質與規模。文字理解則交給 H3-Encoder,它直接取用 Qwen3-VL-32B 的完整預訓練權重,並把第 50 層的隱藏狀態餵給 H3-Omni-Transformer。
ComfyUI 的原生支援:四個專屬節點與三種生成模式
開放權重要能用,還得有順手的推理框架。ComfyUI 從 0.30.0 版起原生支援 MiniMax-H3,官方工作流教學隨附三個範本:文字生影片(T2V)、影像生影片(I2V,可加首幀與尾幀),以及參考生影片(R2V,可用參考影像、影片、音訊鎖定人物、風格、運鏡或聲音)。模型本身還提供更細的生成模式:首尾幀條件生成(fl2va)走 MiniMaxH3ImageToVideo 節點,全參考條件生成(ref2va)走 MiniMaxH3ReferenceToVideo 節點,兩者使用不同的擴散權重。
這些專屬節點都集中在 ComfyUI 原始碼的 comfy_extras/nodes_minimax_h3.py:除了上述兩個條件節點,還有調整影片與音訊雙流排程偏移的 MiniMaxH3SigmaShift,以及建立影音聯合潛空間的 EmptyMiniMaxH3LatentAV。換句話說,MiniMax-H3 的原生支援不是社群外掛,而是隨 ComfyUI 主線一起維護的程式碼。實際生成時,影音聯合潛空間會交給 ComfyUI 既有的 VAEDecode 解出影格、VAEDecodeAudio 解出音訊,再由 CreateVideo 封進同一個 MP4。
無頭驅動:把 ComfyUI 當成 Python 可呼叫的推理後端
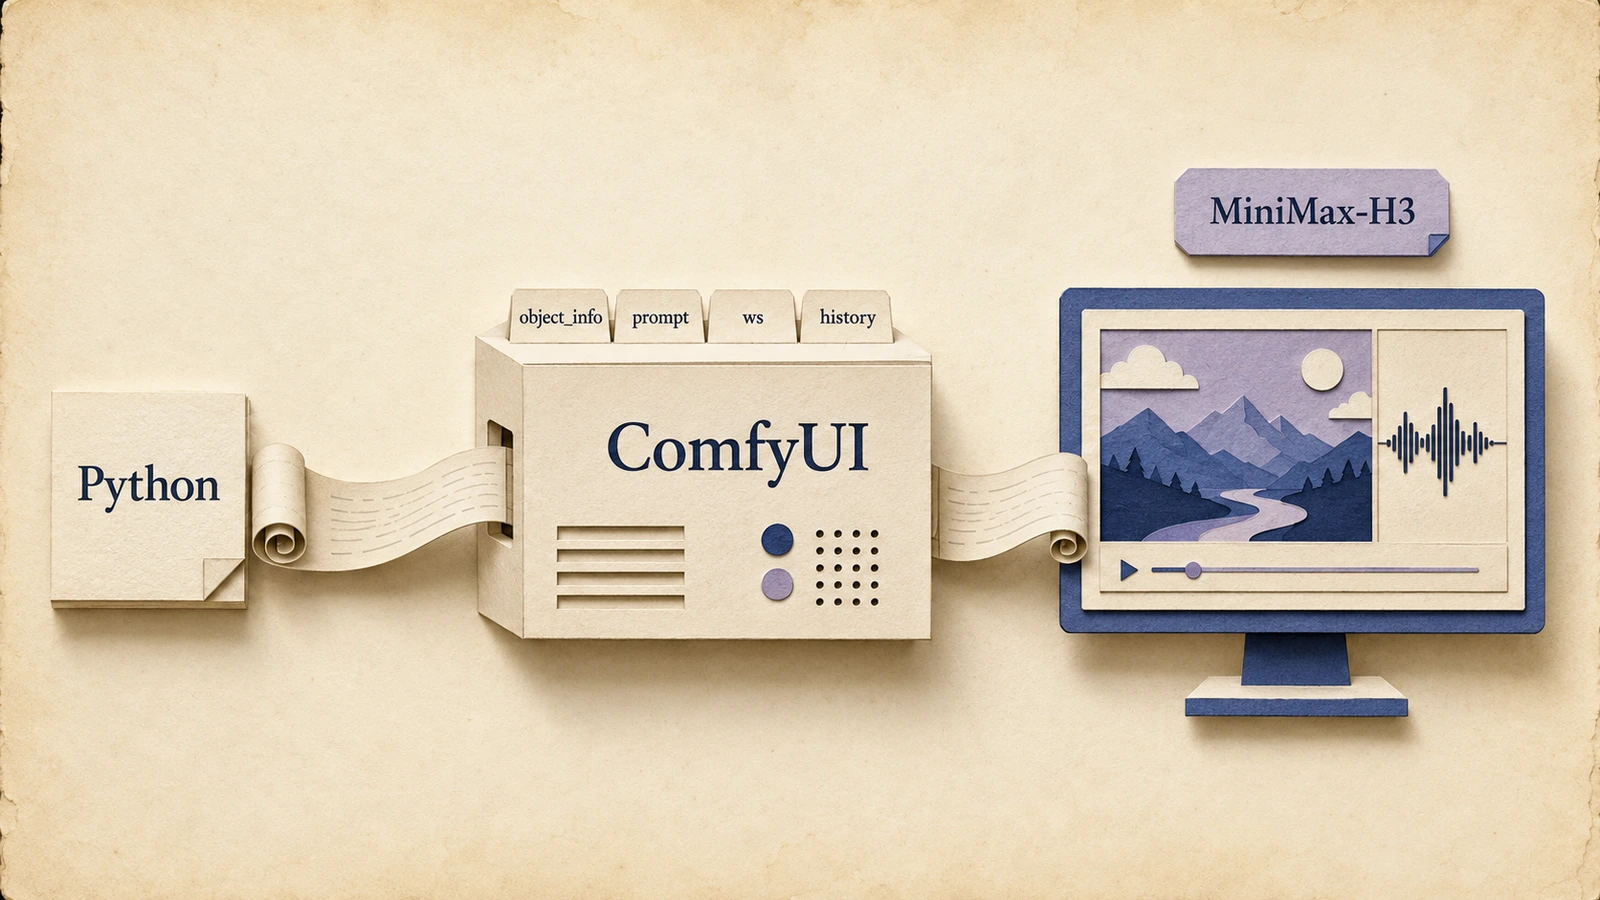
ComfyUI 雖然以圖形化節點介面聞名,但它的核心其實是一座 HTTP 伺服器——介面上的每一條連線,最終都會編譯成一份執行圖,POST 到同一個 /prompt 端點。這代表你完全不必開瀏覽器,也能用 Python 把整套生成流程腳本化。
典型的無頭流程是這樣跑的:先用子程序啟動 ComfyUI(main.py --listen 127.0.0.1 --port 8188 --disable-auto-launch),輪詢 /system_stats 確認伺服器就緒;接著在 Python 裡把上述 MiniMax-H3 節點逐個組成執行圖,並對照執行中伺服器回傳的 /object_info 驗證每個節點的輸入名稱,避免文件與實際版本對不上的問題;然後把整份圖 POST 到 /prompt,再用 WebSocket 連到 /ws 追蹤每一步進度,最後從 /history 收回產出的 MP4。圖片條件素材則透過 /upload/image 以 multipart 上傳。
這條路徑的好處是整個生成鏈都能寫進一支腳本:硬體預檢、權重下載、畫布與幀數計算、節點拼裝、進度監控、輸出收集一氣呵成,方便放進 Colab 或自動化管線反覆實驗,也能依 GPU 條件動態決定要用哪一組權重。
兩個必須對齊的規格:畫布上限與幀數網格
腳本化生成最常踩的坑,是解析度與時長對不上模型的要求。MiniMax-H3 的原生畫布以短邊 768px 為基準,並須為 32 的倍數;時長則要對齊模型的時間壓縮——在 24fps 下,幀數會吸附到「每 17 幀一塊、加 5 幀」的 17k+5 網格。也就是說,你要的秒數會被自動調到最接近的合法幀數,腳本裡最好先把目標秒數換算成合法幀數,再餵給節點,避免送出執行圖後才被伺服器退件。ComfyUI 的 Resolution Selector 節點封裝了畫布邏輯,但在無頭模式裡,你也可以在 Python 端複製同樣的計算,先決定寬高與幀數再組圖。
依顯存挑權重:從 BF16 到 FP8 的量化梯
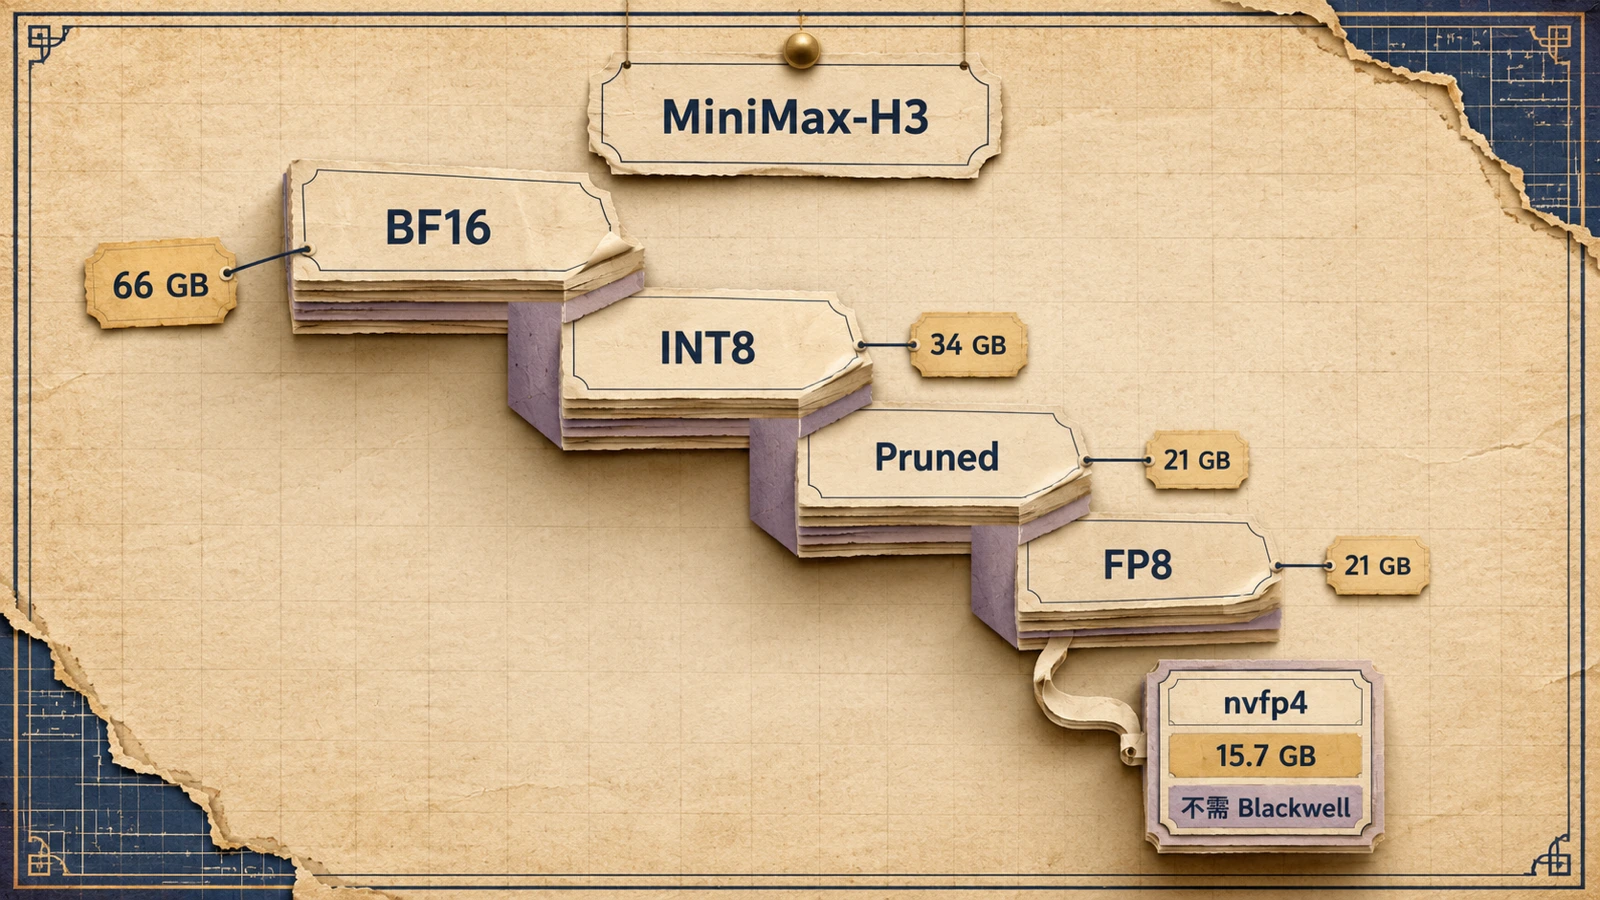
MiniMax-H3 的權重由 ComfyUI 團隊重新封裝在 Comfy-Org/MiniMax-H3 庫,同一份模型提供多種量化格式,讓不同顯存的機器都能跑。擴散主模型有 BF16(如 minimax_h3_fl2va_bf16 約 66.3GB)、int8_convrot(約 34GB,官方建議優先採用,需搭配 PyTorch cu130)、剪枝版 pruned_int8_convrot(約 21GB),以及最精簡的 pruned_fp8_scaled(約 21GB,僅在無法使用 int8_convrot 時作為備援)。
文字編碼器 Qwen3-VL-32B 同樣分三檔:BF16 約 51.5GB、int8_convrot 約 27.1GB,以及 nvfp4_awq 約 15.7GB。值得留意的是,官方 README 特別註明nvfp4 文字編碼器不需要 Blackwell 架構 GPU就能用——nvfp4 原生格式通常需要 Blackwell,但這份轉換後的權重讓非 Blackwell 架構的消費級與資料中心顯卡也能跑得動編碼器這一環。把擴散模型與文字編碼器的量化等級分開挑選,就能在畫質、速度與顯存之間找到適合自己硬體的平衡點。