V4 系列第一個視覺模型走上 API
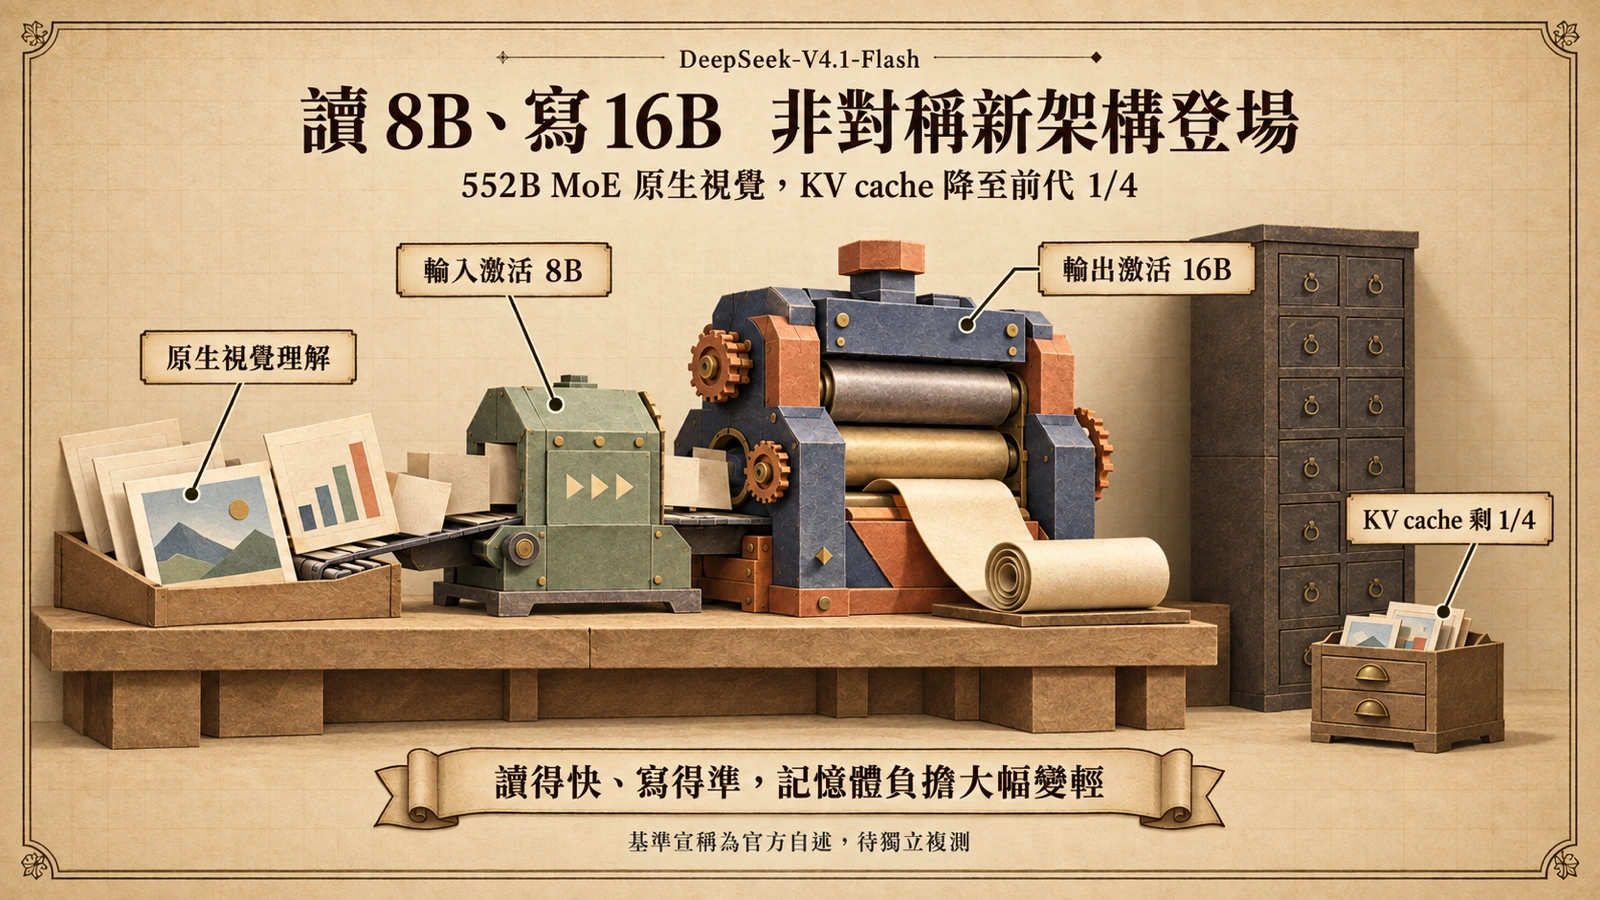
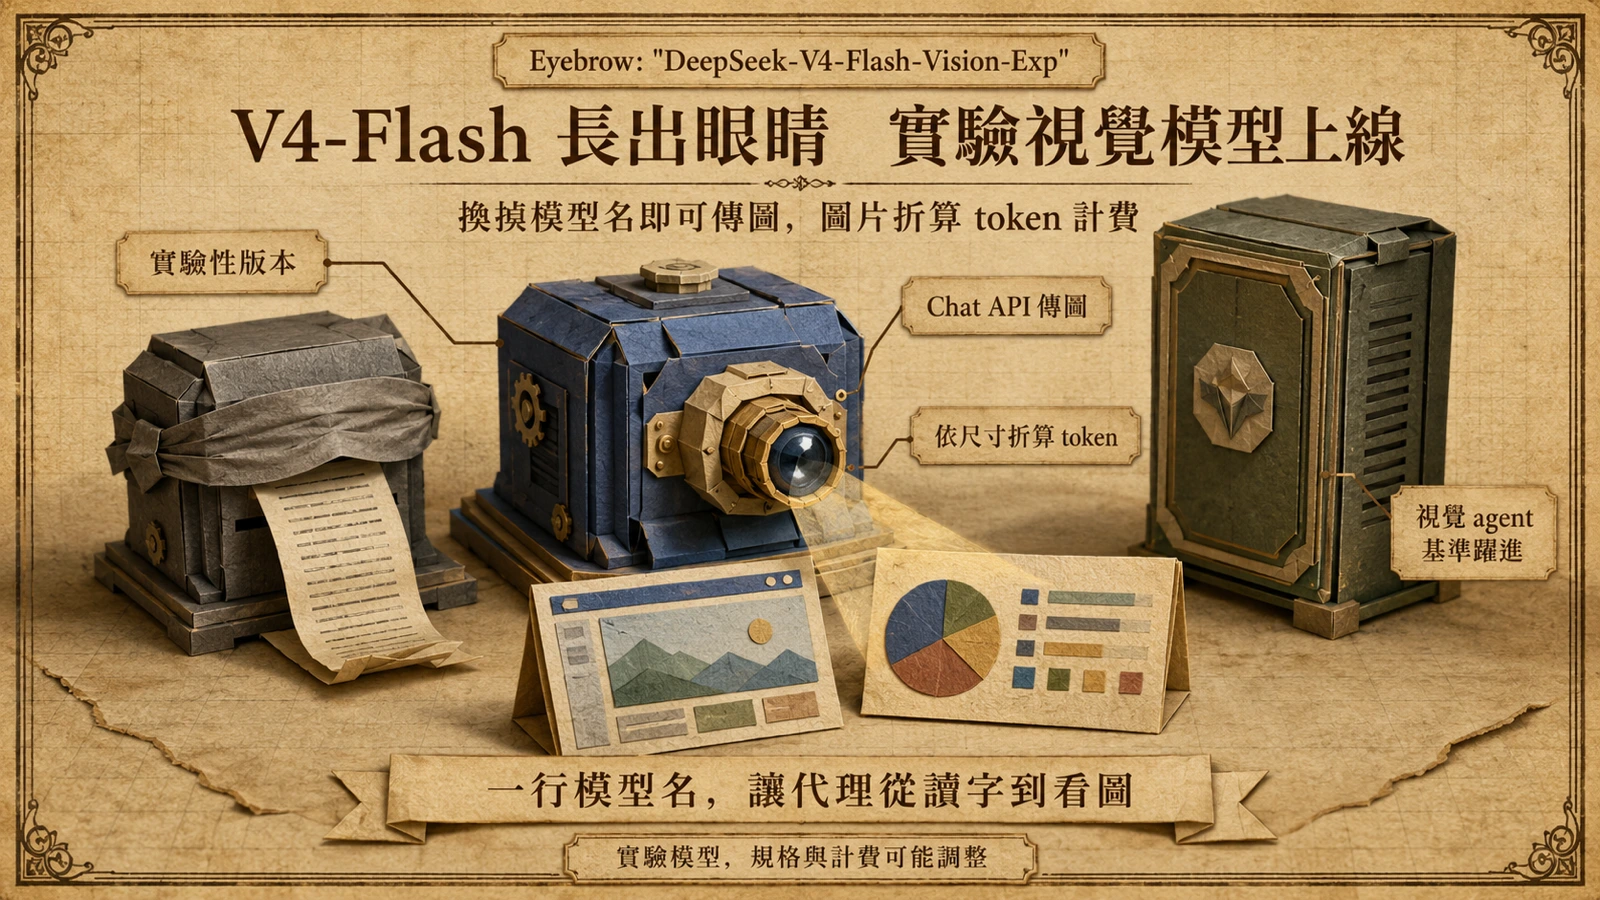
DeepSeek 台灣時間 8 月 21 日在官方 API 平台送上新品:多模態視覺理解模型 DeepSeek-V4-Flash-Vision-Exp。官方 change log 的公告以「今天起在 DeepSeek API 平台可用」的措辭宣布上架,並明確定位為實驗性(experimental)模型。這也是 V4 世代第一個走上官方 API 的視覺理解模型——在這之前,API 上的 V4 家族只有 deepseek-v4-flash 與 deepseek-v4-pro 兩條純文字路線。
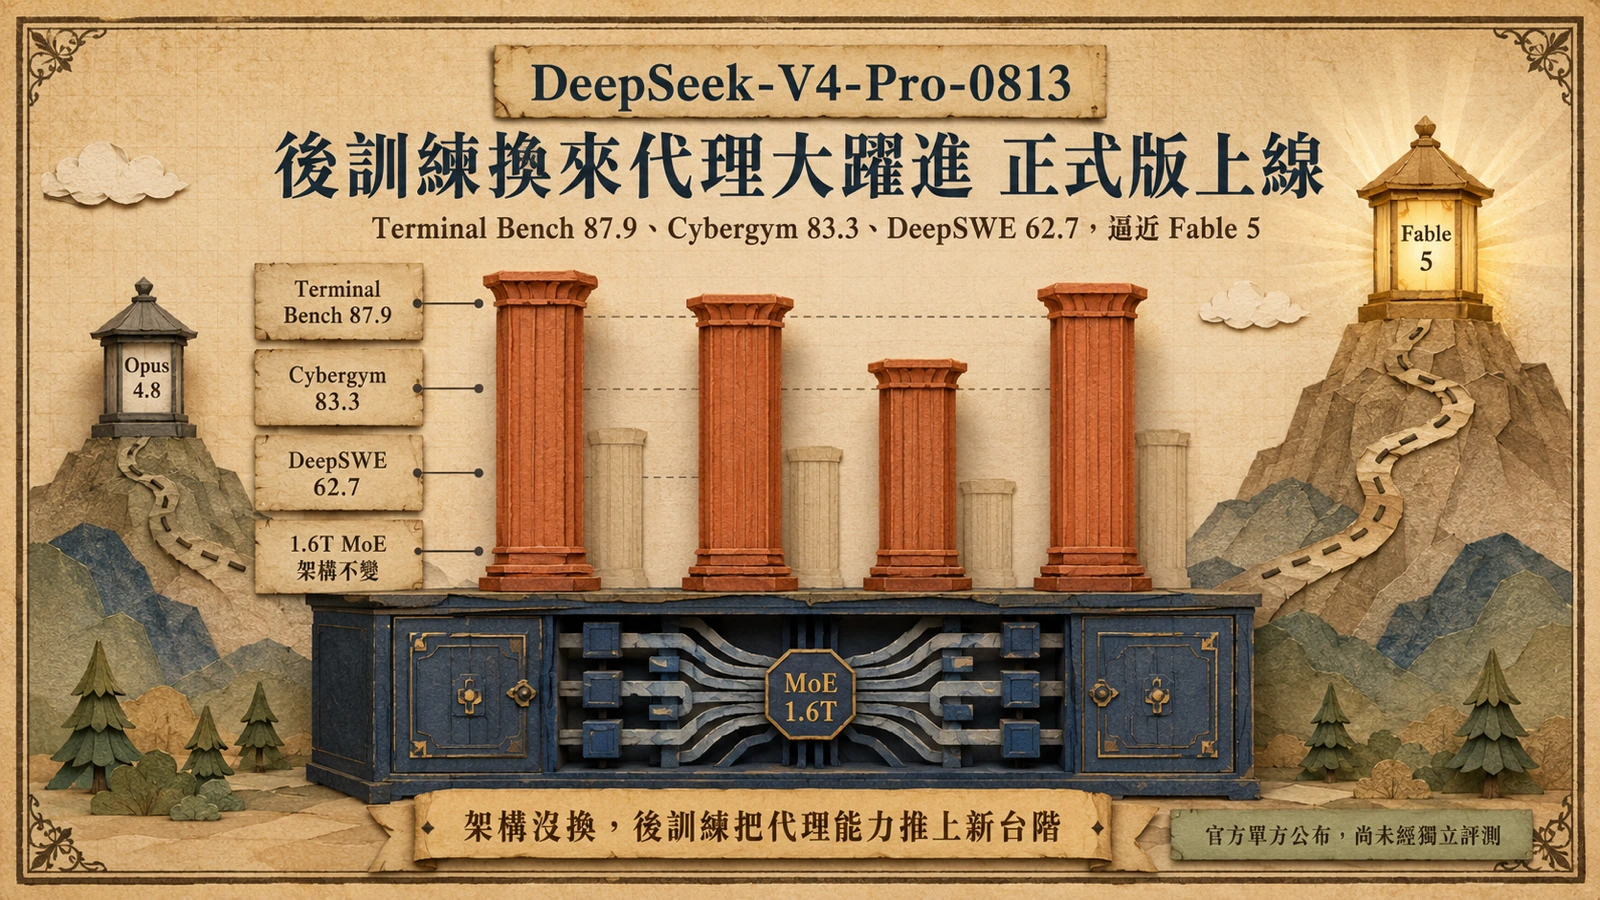
從節奏看,這一步不算意外。DeepSeek 八月中旬才把旗艦 deepseek-v4-pro 更新為 0813 正式版,隔天就登上矽基流動的第三方託管,半個月內再補上視覺模型,等於把 V4 世代從「兩條文字線」推進到「文字加視覺」的編制。對照官方文件目前的生產線標示——deepseek-v4-flash 指向 DeepSeek-V4-Flash-0731、deepseek-v4-pro 指向 DeepSeek-V4-Pro-0813——Vision-Exp 是掛在 Flash 這條輕量主力旁邊的實驗分支。
怎麼呼叫:換掉模型名就能傳圖
使用方式沒有新花樣。官方入門文件說明,這個新發布的 deepseek-v4-flash-vision-exp 是實驗性模型、在原有能力之外額外接受圖片輸入,把模型名設為 deepseek-v4-flash-vision-exp 就能呼叫。換句話說,開發者不需要換 SDK、不需要改接法,既有的 Chat API 呼叫程式碼只要改一行模型名稱,就能把「只讀文字」的代理升級成「看得見畫面」的代理。
這個設計延續 DeepSeek 一貫的介面策略:模型版本推進、呼叫方式維持不變。對已經把 deepseek-v4-flash 放進工作流程的團隊來說,導入視覺能力的摩擦力被壓到最低——想先驗證「加了眼睛之後代理到底變多強」的團隊,可以用同一份程式碼、同樣的請求結構,對照新舊兩個模型名跑出可比較的結果。
圖片計費:依尺寸折算成輸入 token
成本面的設計值得停下來看。官方定價文件明載,傳給這個模型的圖片會依尺寸折算為 token,與文字 token 合併按輸入 token 計費。這代表三件事:第一,沒有「每張圖多少錢」的獨立價目,圖片成本完全由它折算出的 token 數決定,解析度越高、畫面越大,消耗的輸入 token 就越多;第二,圖與文字走同一個計費口徑,做成本試算時只需要掌握 token 用量這一個變數;第三,既有的用量監控直接沿用——後台看到的輸入 token 曲線,就是圖文混合後的真實帳單。
對多圖工作流(例如批次讀表、文件辨識、UI 截圖分析)來說,這種計費設計的好處是可預估性:先小量跑一批樣本,量出每張圖平均折算的 token 數,再乘上工作量,就能在正式上線前把成本模型建起來。而文字輸出照 DeepSeek API 慣例按輸出 token 計費,看圖答題若要求逐字轉錄畫面內容,輸出長度也會直接反映在帳單上。
官方評測怎麼說
能力主張集中在一句話:官方在同一份公告中表示,在需要視覺理解的 agent 基準上,V4-Flash-Vision-Exp 較 DeepSeek-V4-Flash 有顯著躍進(a significant leap)。
「需要視覺理解的 agent 基準」值得拆開看。這類任務的共同點是:代理光會讀文字不夠,必須真的看懂畫面——讀儀表板截圖上的數字、在介面截圖裡找到正確按鈕、理解圖表中的趨勢再決定下一步操作。V4-Flash 原本是純文字模型,遇到這類任務只能靠外部工具先把圖轉成文字描述,轉換過程漏掉的細節就是失分來源;Vision-Exp 把視覺理解收進模型本身,等於把這條漏損環節補起來。
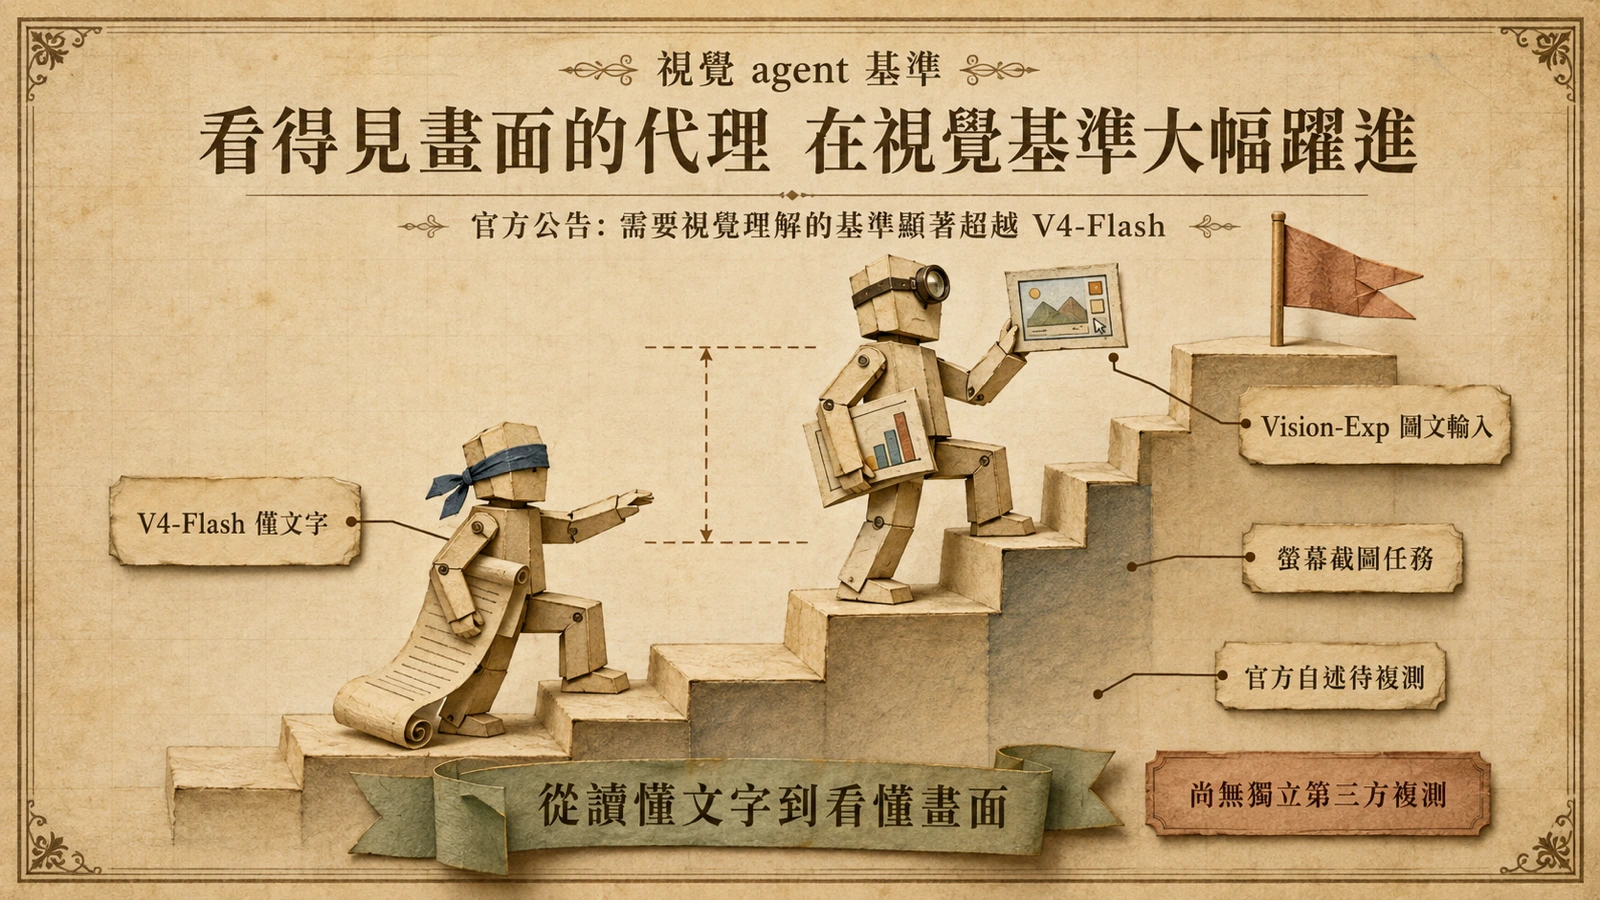
不過要留意主張的層級。「顯著躍進」是 DeepSeek 官方的自述,截稿前尚未見到逐項基準分數的對照,獨立評測機構的複測也還沒有跟上。官方自評是必要的第一手資訊,但在把它當成採購或遷移依據之前,等第三方數字出爐總是穩妥的做法。
V4 產品線分工:Flash 走量、Pro 走旗艦、Vision 補上眼睛
把 Vision-Exp 放回 V4 產品線,DeepSeek 的佈局更清楚。目前 API 上的生產模型維持兩條:deepseek-v4-flash 已更新至 DeepSeek-V4-Flash-0731,deepseek-v4-pro 已更新至 DeepSeek-V4-Pro-0813。兩者的分工在 0731 上市時就定調——官方模型卡明白寫著 V4-Flash-0731 以遠小於 V4-Pro 預覽版的激活參數量,在多項基準上勝出,輕量模型不再是次級品,而是代理任務的性價比首選。
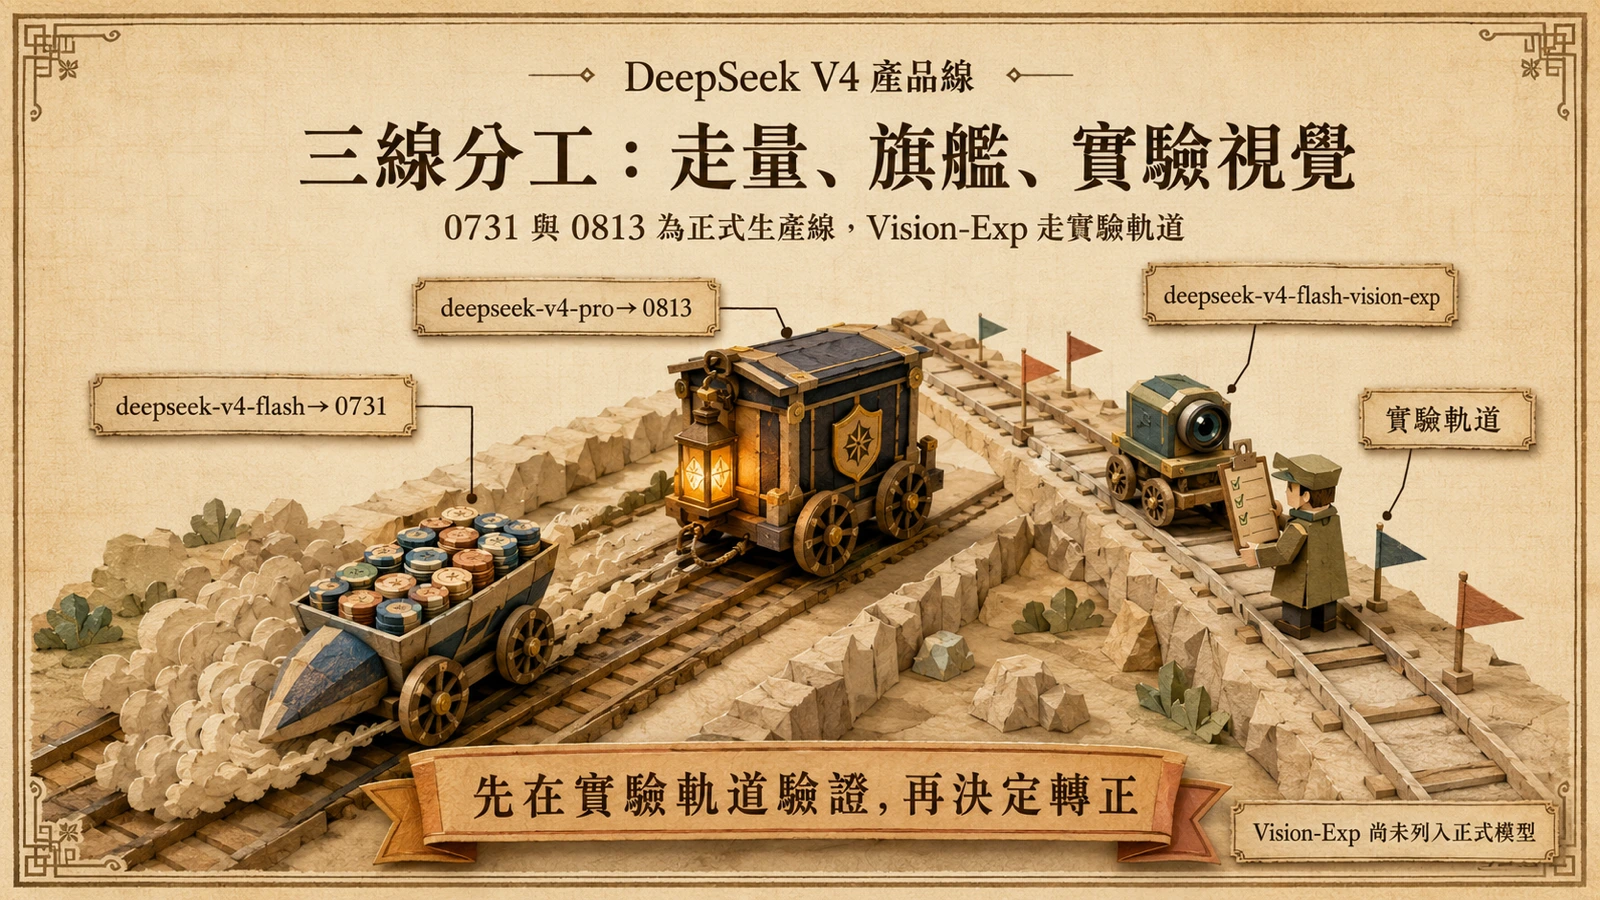
Vision-Exp 補上的正是這條輕量主力最缺的一塊。Flash 走量、顧成本;Pro 走旗艦、衝上限;Vision-Exp 走實驗軌道、驗證「會看圖的 Flash」有沒有市場。這種「先在實驗軌道試營運、再決定轉正」的節奏,與 DeepSeek 過去把預覽版逐步收斂成 0731、0813 正式版的做法一脈相承。若 Vision-Exp 後續轉正,合理的推測是它會掛上穩定模型名並列入正式生產線——但官方尚未給出時間表,這屬於值得追蹤而非可以依賴的資訊。
實驗版的三個注意事項
對開發者而言,「實驗性」三個字應該這樣讀:
第一,別急著把生產流量切過去。 官方文件目前的正式生產線仍是 0731 與 0813,Vision-Exp 是掛明實驗標籤的嘗試。實驗模型的行為、介面與計費都可能隨反饋調整,把它放在原型驗證、內部工具、低風險場景先跑一輪,是比較穩健的姿勢。
第二,純文字負載沒有理由搬家。 這個模型的差異化在「額外接受圖片輸入」,定位掛在 Flash 這條線上。既有純文字工作流留在 deepseek-v4-flash(0731)即可——除非任務真的需要看圖,否則遷移只會增加變數,不會增加能力。
第三,把圖片管理納入成本設計。 既然圖片依尺寸折算 token,代理人設計裡「丟多少張圖、丟多大解析度」就變成直接的成本槓桿:能裁切就裁切、能縮圖就縮圖、能重用前次辨識結果就別重傳。多模態代理的成本最佳化,第一課往往不在模型端,而在圖片管理。
限制與後續觀察
這次發布留了幾個待答的問題。評測面:官方只給出「顯著躍進」的定性描述,逐項分數與評測設定仍待補齊,獨立複測也還沒有出現。開源面:DeepSeek 過去有釋出權重的慣例,V4-Flash-0731 的模型卡就在 Hugging Face 上,但 Vision-Exp 是否比照辦理、何時辦理,仍待官方後續說明。定價面:官方定價頁先前已預告將顯著調漲 API 整體定價,實驗模型是否適用新價、圖片折算率會不會調整,值得持續盯著官方 change log 與定價頁的後續更新。
後續可以追蹤三個訊號:一是 Vision-Exp 從實驗版轉正的時間點與最終模型名;二是獨立評測機構對其視覺代理能力的複測結果;三是競品回應——輕量多模態代理這個位置,各家都不會拱手讓出。DeepSeek 用一個實驗版本試水溫,真正的訊號是:V4 世代的競爭,已經從純文字代理延伸到看得見畫面的代理。