混合注意力:用 25% softmax 換回全秩表達力
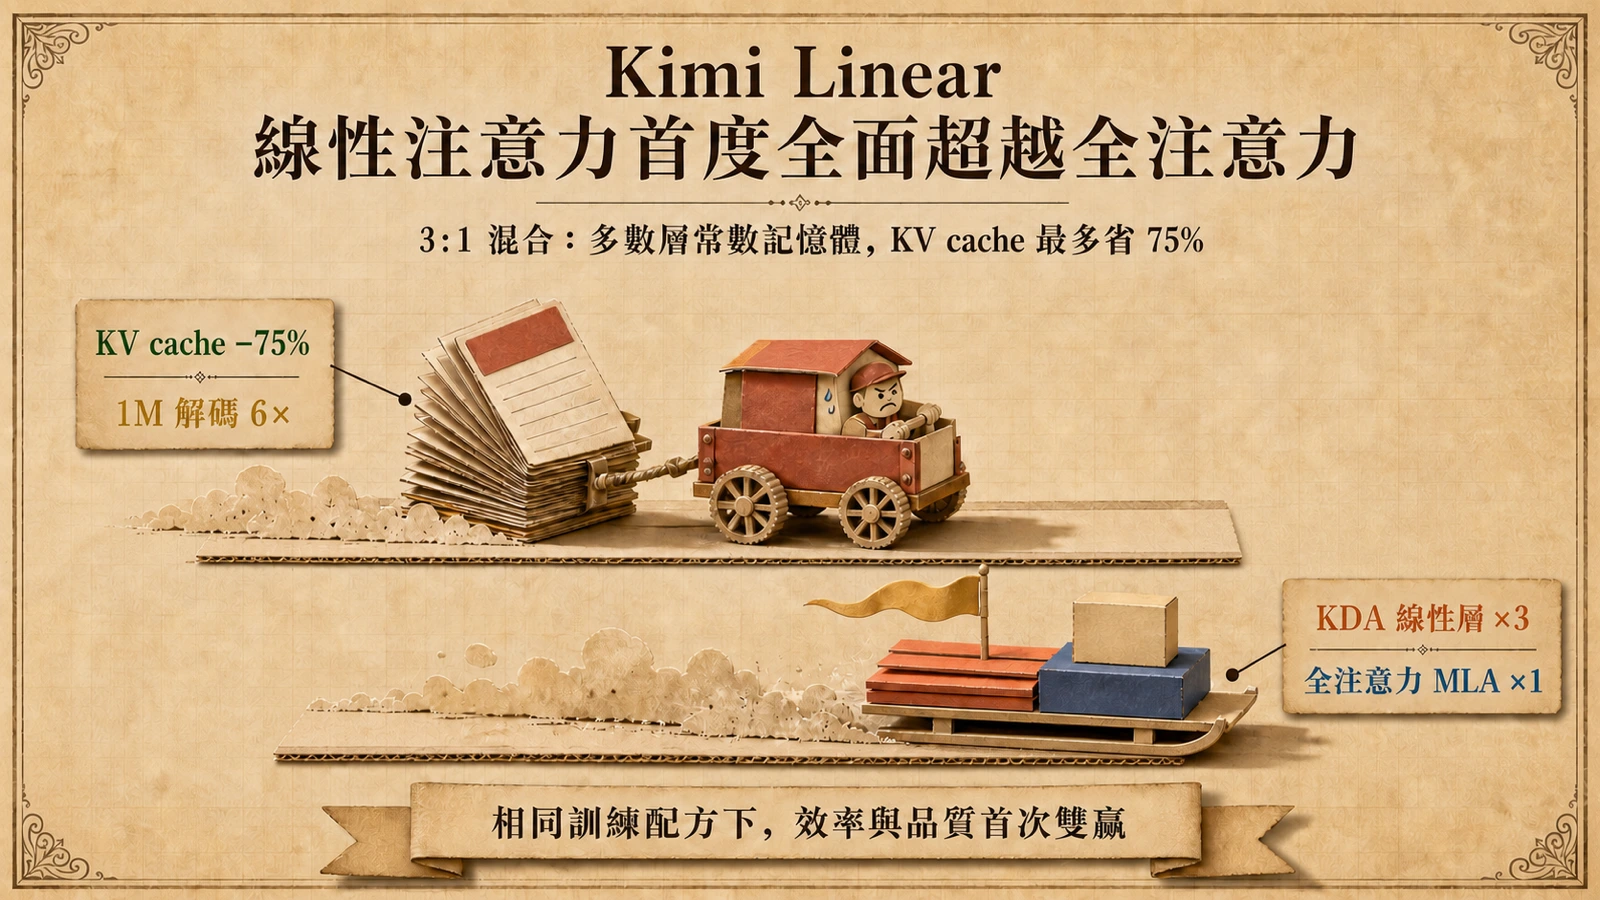
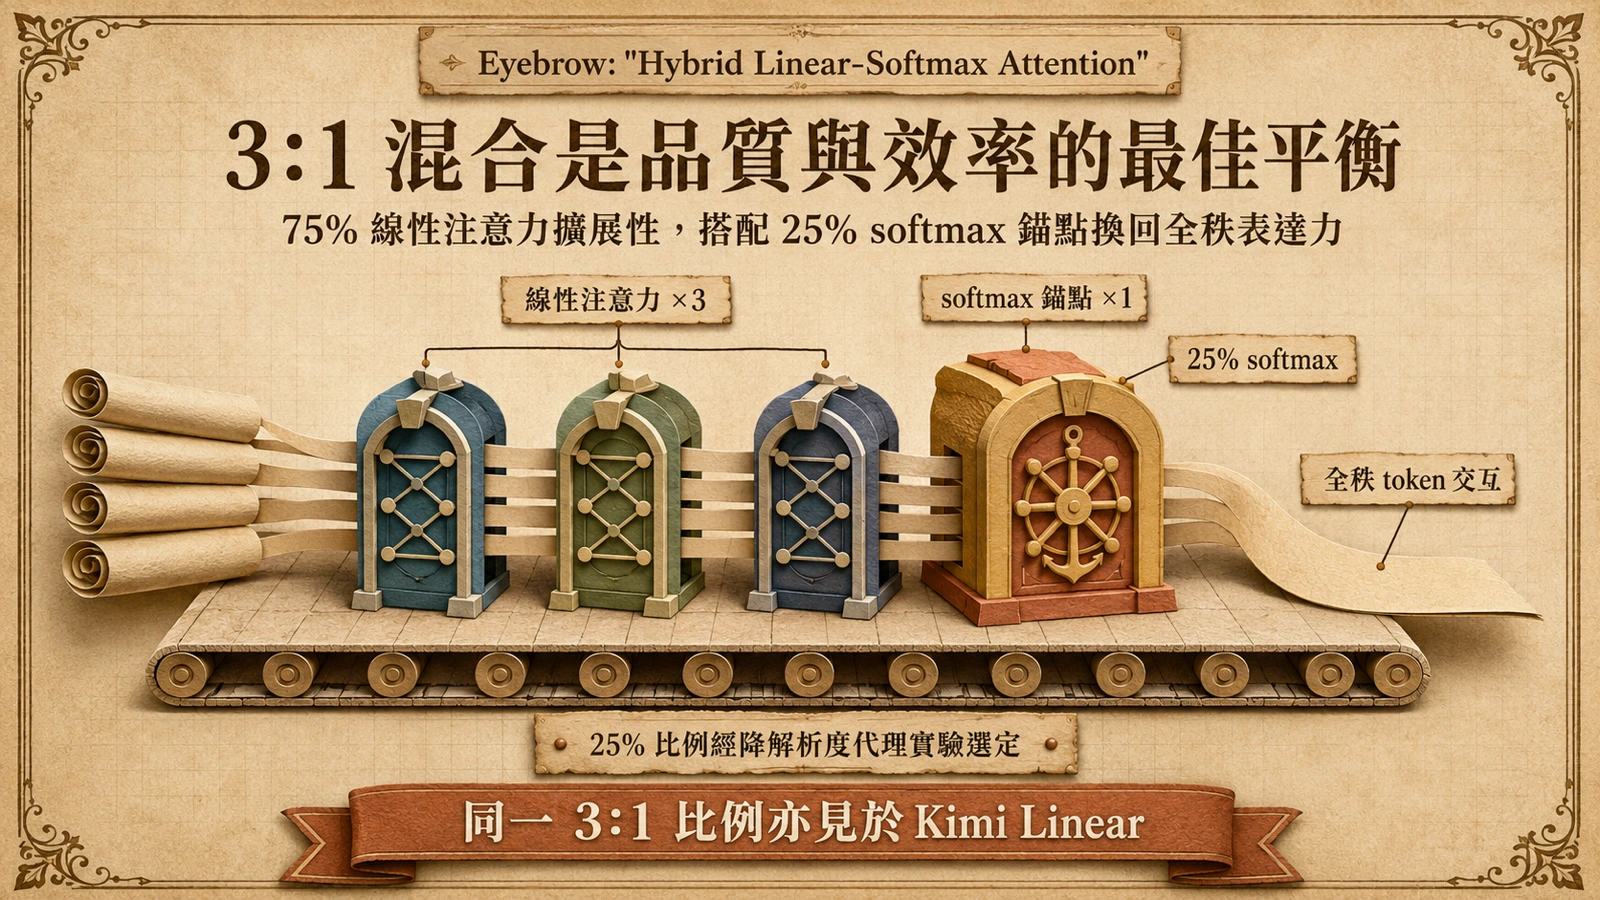
SANA-Video 2.0 是 NVIDIA、MIT 與香港大學團隊(Junsong Chen、Enze Xie、Song Han、Daquan Zhou、Ping Luo 等)發表的混合影片擴散 Transformer,提供 5B 與 14B 兩種規模,目標是在單張 GPU 上生成最高 720p 影片。核心問題在於:純線性注意力擴展性佳但會失去全秩 token 交互,純 softmax 又帶來二次複雜度。論文提出的 Hybrid Linear-Softmax Attention 以 3:1 比例混合閘控線性注意力與週期性閘控 softmax 錨點,並透過降解析度代理實驗把 25% softmax 定為品質與效率的最佳平衡。值得一提的是,同樣的 3:1 線性對全注意力比例在語言模型領域也出現——〈Kimi Linear〉以自研 KDA 搭配 MLA 採 3:1 分層混合,宣稱是首個在公平比較下、於短/長/RL 三場景全面超越全注意力的混合線性注意力架構;兩個獨立團隊不約而同選中同一比例,是個值得注意的巧合。
深層有效秩提升約 12%
為了把 softmax 錨點刷新後的表徵沿深度傳遞,團隊設計 Block Attention Residuals(AttnRes),將已完成的塊摘要路由到後續線性層,實現錨點特徵再利用,使深層有效秩提升約 12%。值得注意的是模型採從頭訓練,直接學習完整混合架構,而非對預訓練模型做事後線性化,這也是其在長序列仍能保持擴展性的關鍵。
從頭訓練而非事後線性化
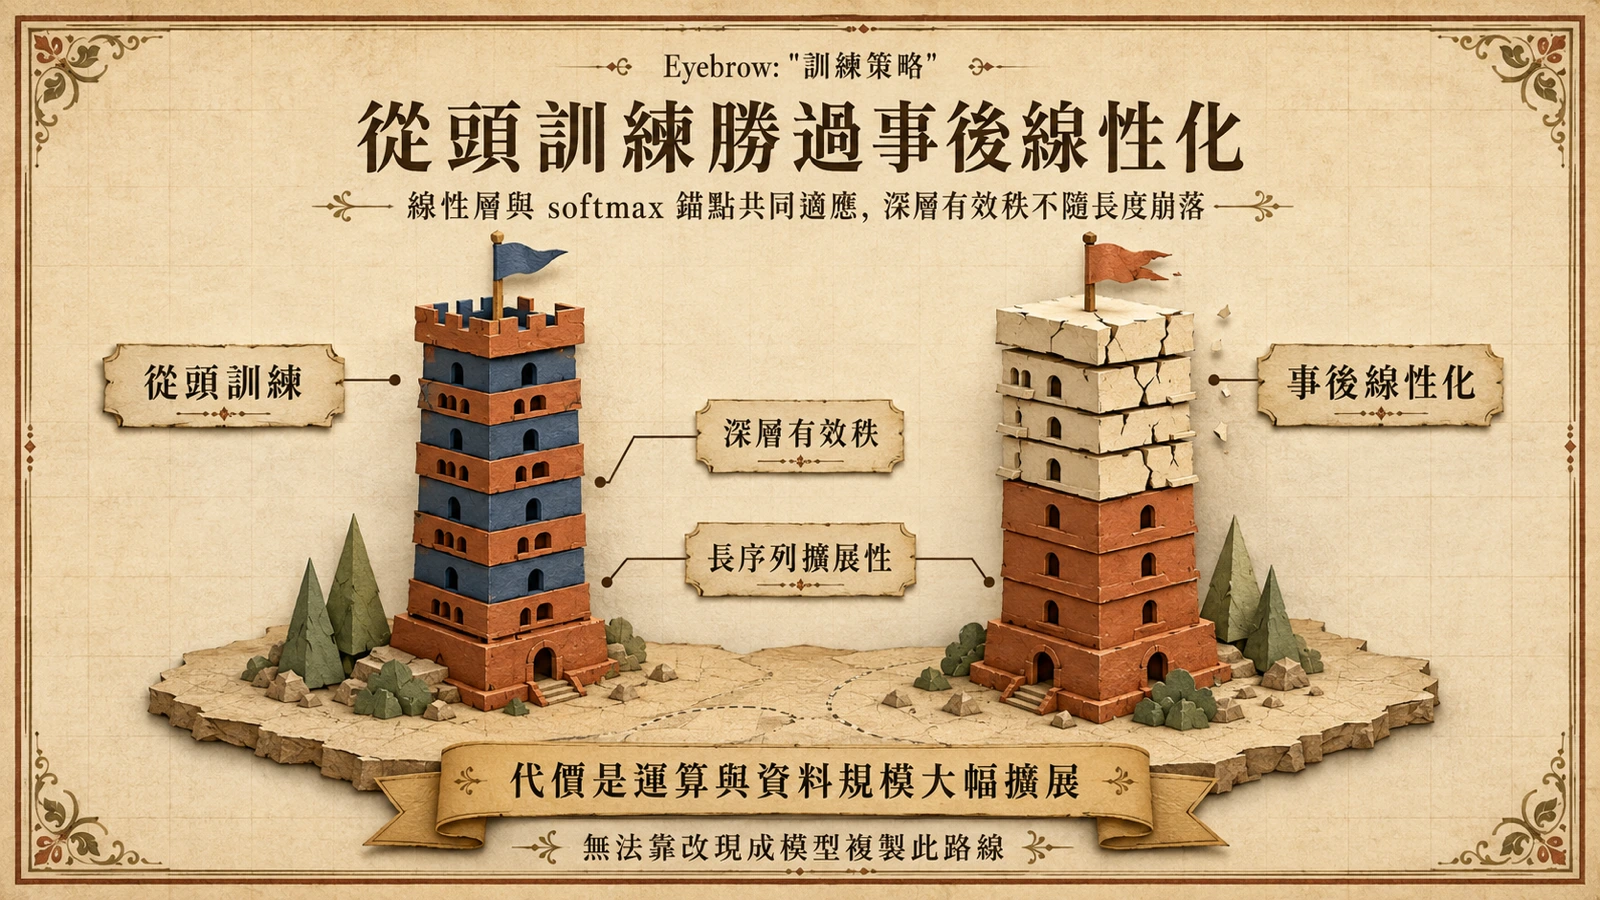
這裡的工程選擇值得拆開看。把既有 softmax 模型「事後線性化」(post-hoc linearization)是常見的省事路線:拿一個已訓練好的強模型,把部分注意力層置換成線性近似,指望蒸餾把效能拉回來。問題是這類置換往往在長序列暴露表達力缺口——線性層從未真正學過如何在沒有全秩 token 交互的情況下建模長程依賴,蒸餾只能補住淺層,深層有效秩依舊塌陷。
SANA-Video 2.0 反過來選擇從頭訓練整個混合架構,讓線性層與 softmax 錨點在訓練期就共同適應,配合 AttnRes 把錨點特徵沿深度再利用。代價是訓練成本更高、資料與運算規模都得跟上,論文也確實強調此代「大幅擴展運算與資料規模」;回報則是深層有效秩不隨序列長度崩落,讓模型在 720p/60 秒這類長影片條件下仍能維持擴展性。對評估遷移成本的團隊而言,這代表一條無法靠「拿現成模型改」複製的路線。
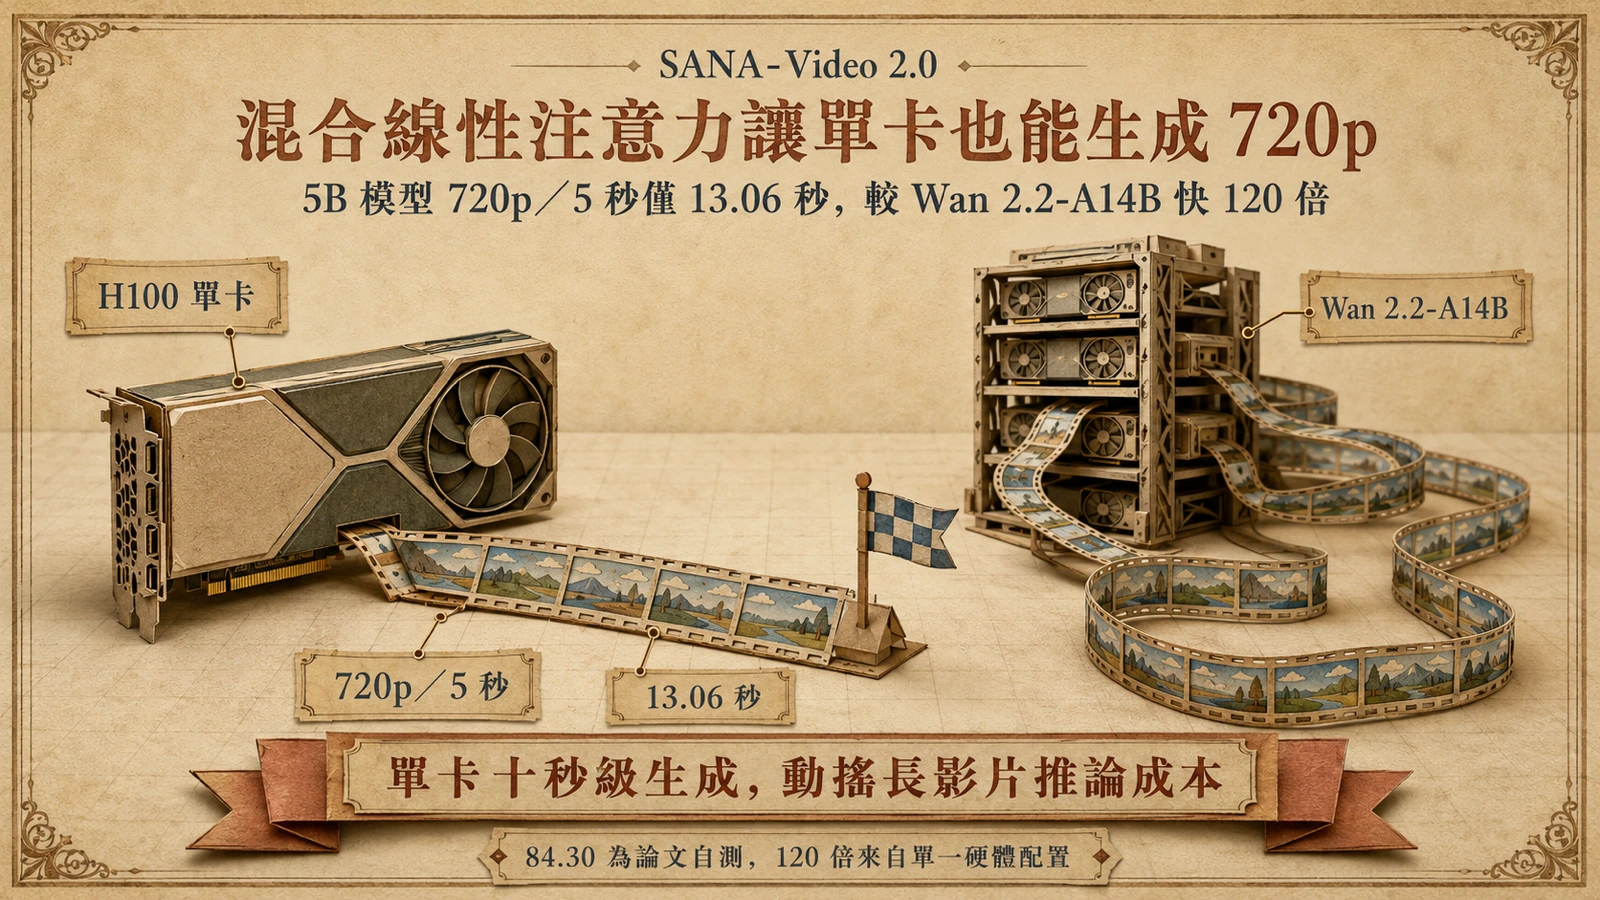
單張 H100、720p/5 秒影片 13.06 秒
實測數字才是重點。40 步取樣下,SANA-Video 2.0 在單張 H100 上以 480p 解析度、13.2 秒取得 VBench 84.30,與規模遠更大的 softmax DiT 表現相當但延遲大幅降低。720p/60 秒條件下,編譯後的 DiT 前向傳播比同等全 softmax 基線快 3.2 倍,且差距隨影片長度增加而擴大。再疊加全棧 Sol-Engine 優化(核心融合、快取、稀疏注意力)額外提速 3.58 倍,5B 模型在 720p/5 秒只需 13.06 秒,比 Wan 2.2-A14B 在同一張 H100 上快 120 倍。
拆解這 120 倍是兩層加速相乘的結果:3.2 倍來自架構本身(混合注意力讓長序列的注意力計算量下降),3.58 倍來自 Sol-Engine 的系統工程(核心融合減少 GPU 核心啟動次數、快取避免重複計算、稀疏注意力跳過不重要的 token 交互)。換言之,即便不採用混合注意力,光靠系統優化也能拿到將近 3.6 倍的提速;但若沒有系統工程,純架構創新在 720p/60 秒這類長序列上也難以逼近即時。這也是論文把兩者並列呈現的原因——它們解決的是不同層次的瓶頸,缺一不可。
對開發者的意義
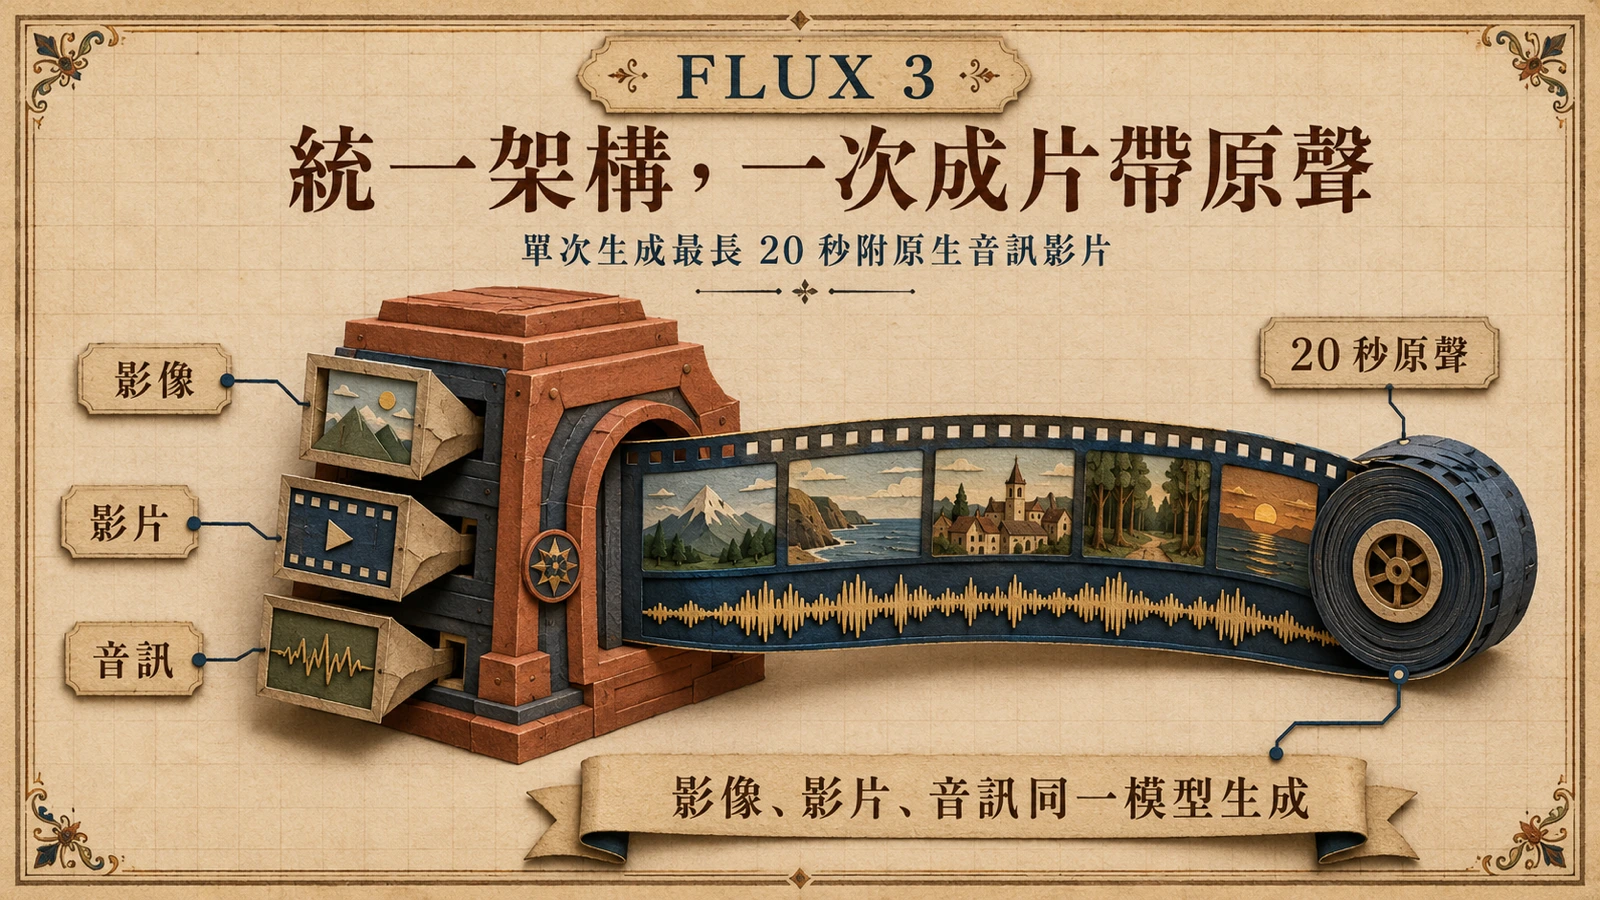
對做影片生成的開發者而言,這組數字直接動搖成本結構:過去需要多卡或長時間推理的高解析度長影片,現在單卡可在十秒級完成,自架推論的單位成本有望顯著下降。需留意 84.30 為論文自測結果,實際美學與動態穩定度仍待第三方橫評;120 倍的對比來自單一硬體配置,部署前應以自身工作負載重新量測,再決定是否從 Wan、HunyuanVideo 等既有路線遷移。同一時期的〈FLUX 3〉選擇影像、影片、音訊聯合學習,兩者分別代表推論效率與統一多模態的不同優先序。在圖像生成端,〈Midjourney V8.2〉則把競爭焦點轉向主觀美學與個性化,呈現生成模型另一種差異化優先序。