OSWorld-Verified 是什麼:把模型丟進真實作業系統
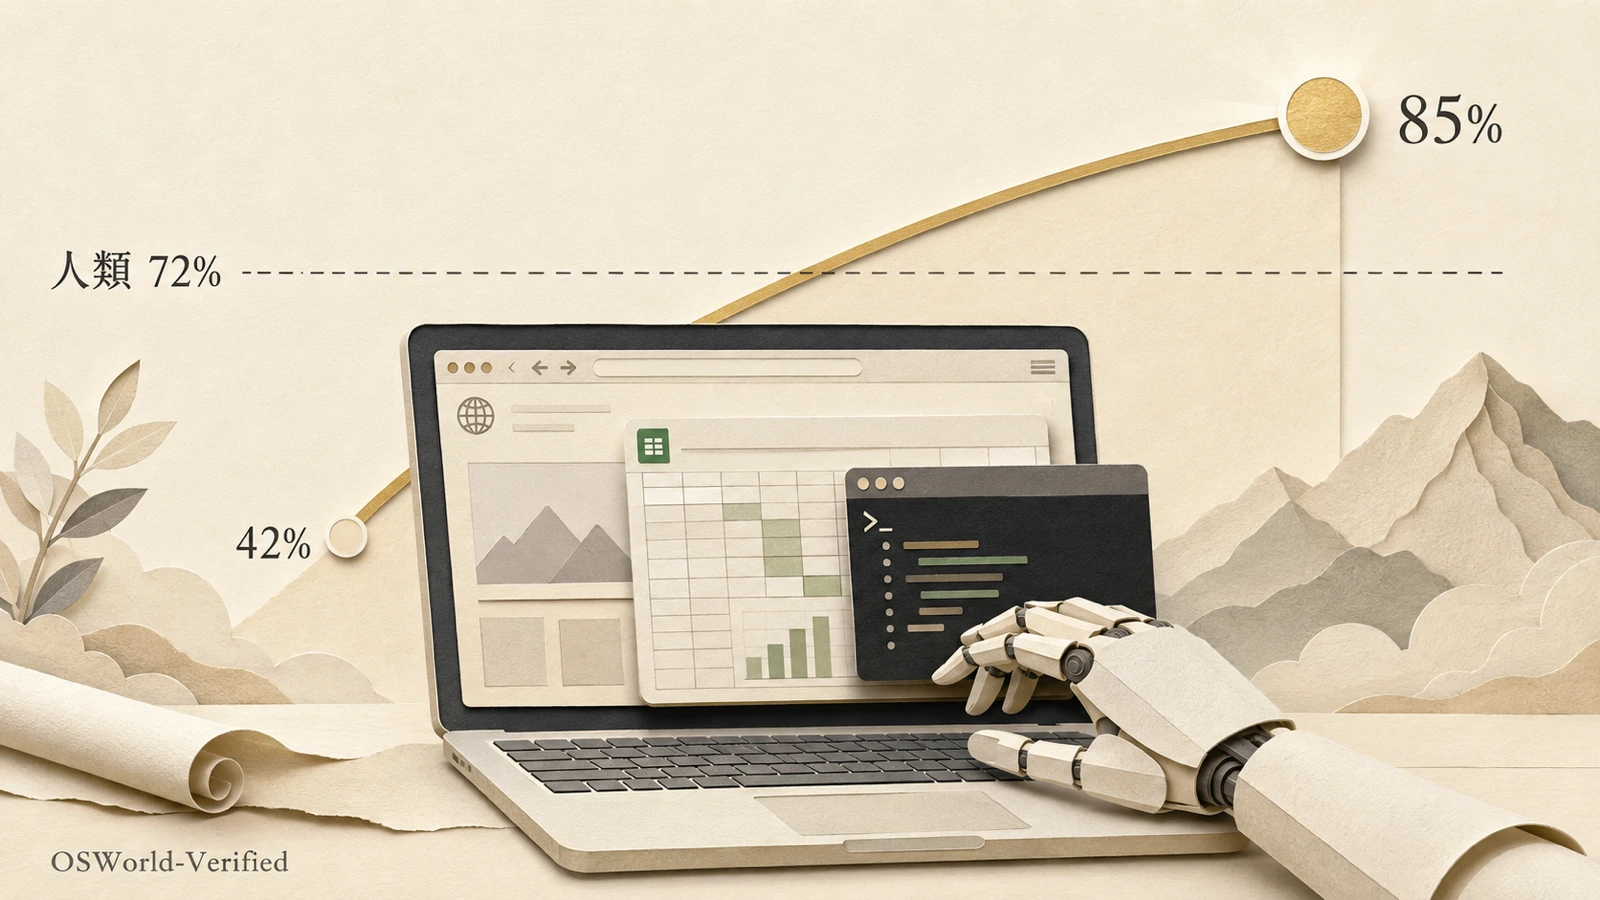
要理解「85%」這個數字,得先看它量的是什麼。OSWorld 是一個把模型丟進真實作業環境的基準:研究團隊打造了一個涵蓋 369 道任務的測試集,任務涉及真實網頁與桌面應用、作業系統檔案讀寫,以及跨多個應用的工作流程,在 Ubuntu、Windows、macOS 等系統上以執行結果(而非模型自陳)來評分——也就是真的讓模型開瀏覽器、操作 LibreOffice、改系統設定,再檢查它有沒有做到。原始論文在 NeurIPS 2024 發表時,人類能完成超過 72.36% 的任務,當時最強的模型只有 12.24%,主要卡在「看懂介面、點對位置」這類 GUI grounding。
2025 年 7 月,官方在 OSWorld 的 GitHub 專案釋出 OSWorld-Verified,修掉社群回報的多項任務定義問題、強化驗證器並加入 AWS 支援,讓訊號更可靠。a16z 追蹤的,正是這個修正後版本的排行榜軌跡。
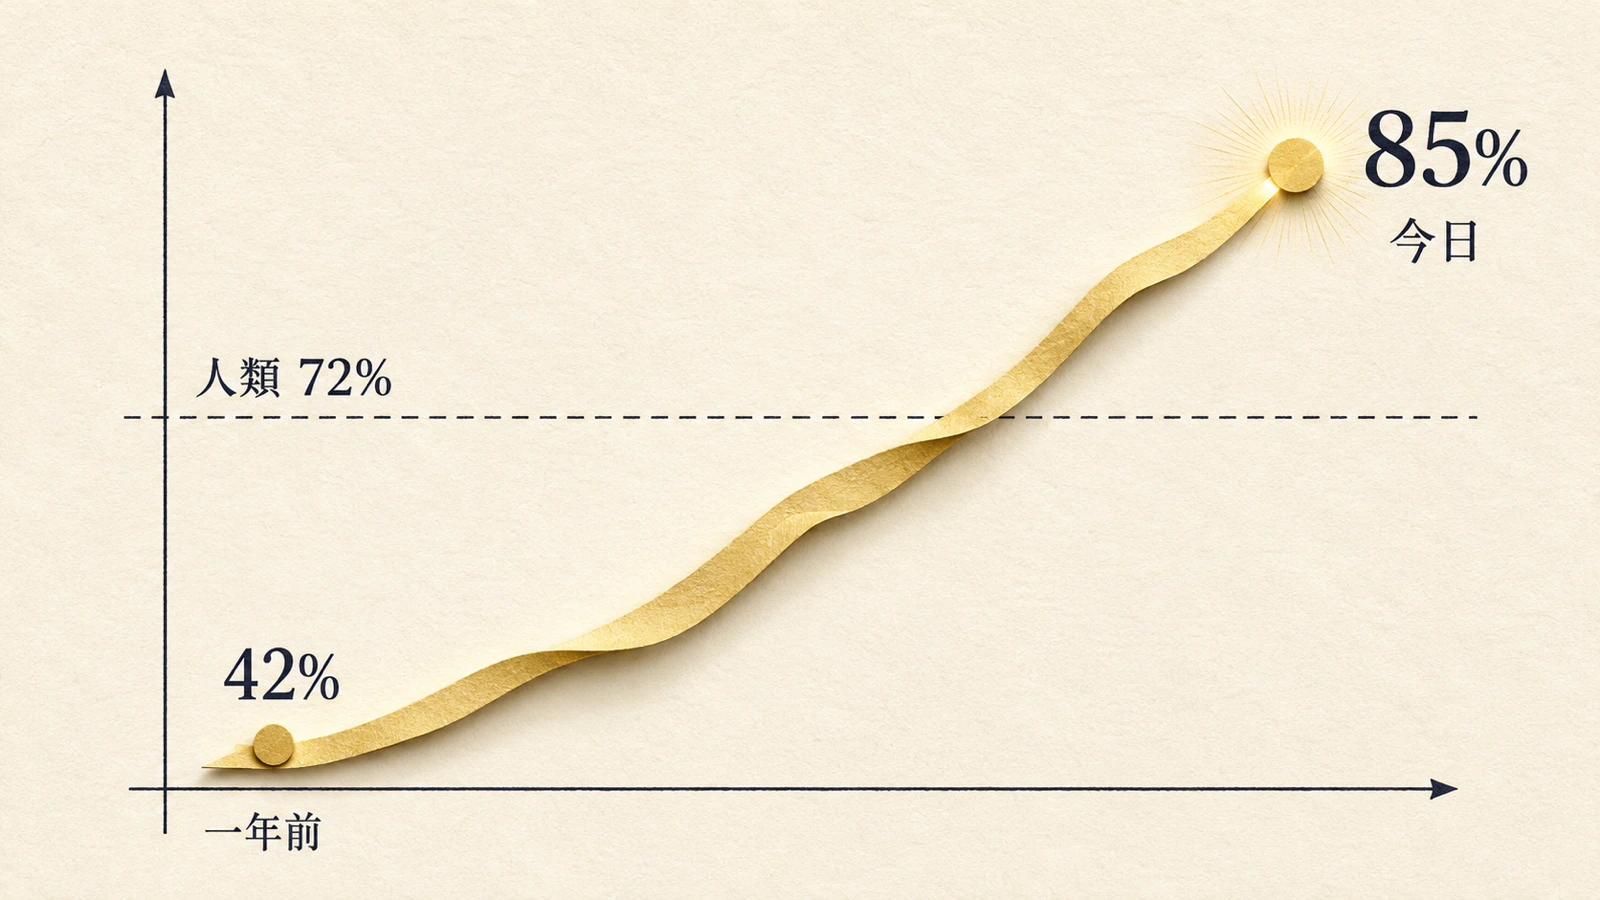
一年從 42% 衝到 85%,跨過約 72% 的人類水準
a16z 的報告用一條曲線把進展講得很直白:一年前最強的電腦操作模型在 OSWorld-Verified 拿 42%,如今最好的模型拿 85%,已經高於人類在同一批任務上的約 72%。換句話說,以這個基準衡量,AI 的最佳表現不只是追上、而是超過了人類測試者的平均水準。
這個跨越是近一年的事。a16z 點出一個轉折:模型直到 2026 年 2 月的 Opus 4.6 之前,都還不夠格在生產環境單獨上線;其後短短半年,榜首成績又從那個水位推進到 85%。要留意的是,「超過人類」是就最佳單次表現的分數而言,並不等於穩定度或效率,見〈MineExplorer 的 41%〉。
Claude Fable 5 以 85% 暫居榜首
報告的排行榜上,Anthropic 的 Claude Fable 5 以 85% 名列當前榜首,在 a16z 的圖中以金色標示。值得對照的是,a16z 特別把 Gemini 3.5 Flash 排除在比較之外,理由是它沒有原生電腦操作能力——這也提醒讀者,不同模型在這條賽道上的「起跑點」並不一致,跨模型比較時要留意哪些能力被納入、哪些被排除,見〈LatentRank 共識榜〉。
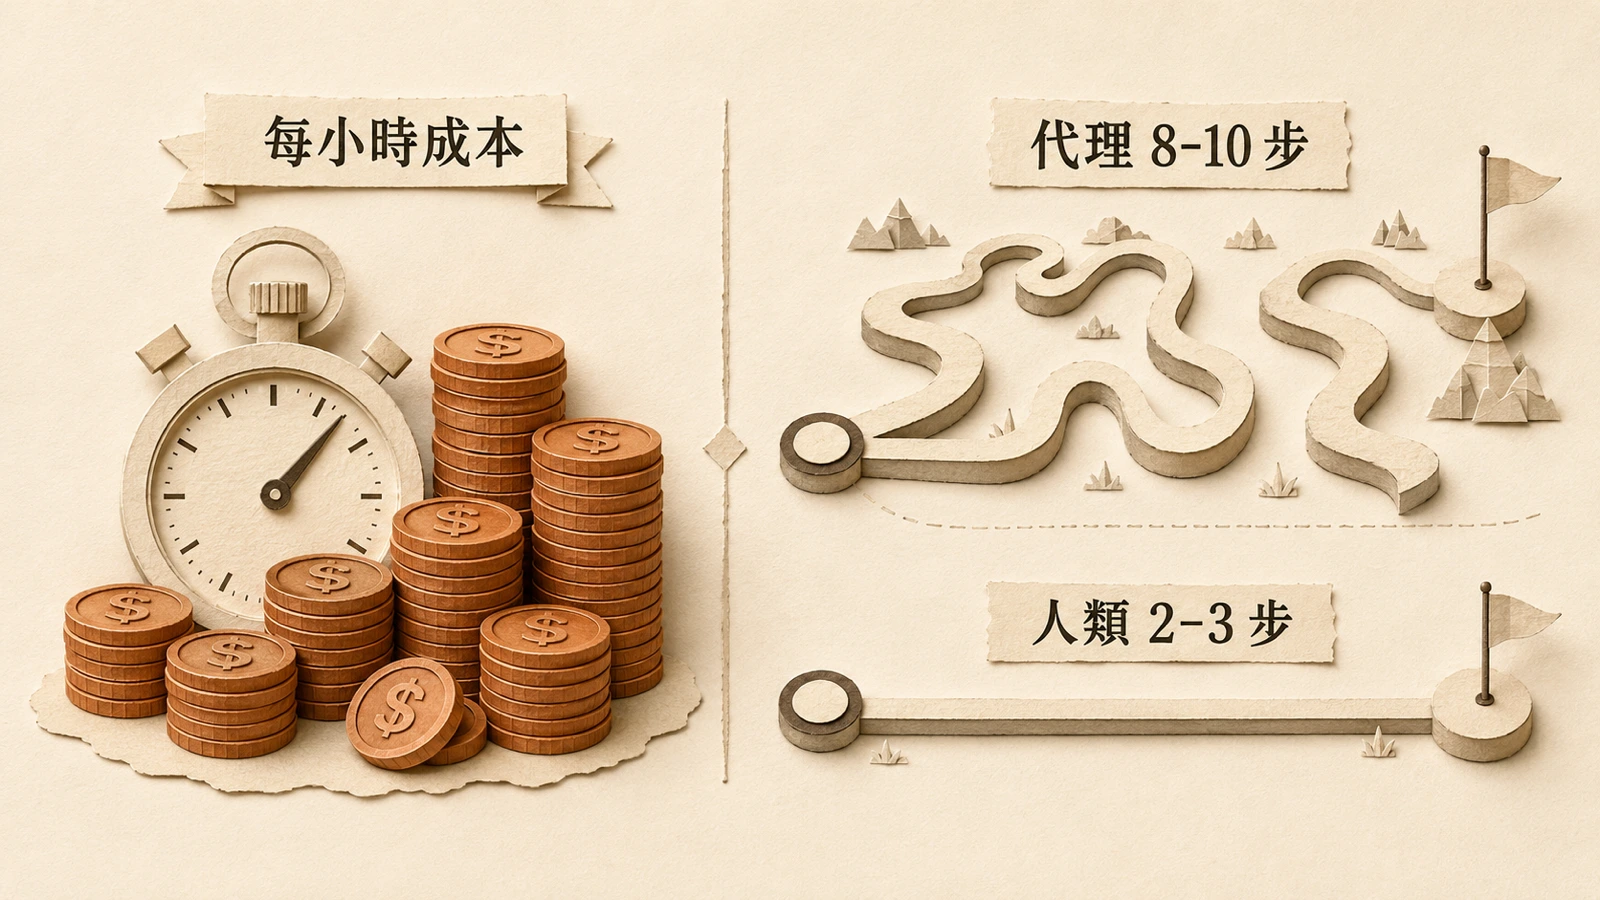
不過榜首的意義得放在成本脈絡下看。a16z 估計,今天跑一個電腦操作代理,每小時推論成本約 6 到 8 美元,實務上落在 3 到 15 美元之間;相對之下,離岸業務流程外包約 10 美元、美國後台行政約 30 到 45 美元,美國勞工統計局的客服代表中位數時薪為 20.59 美元。也就是說,最強模型的帳面時薪已經壓到與離岸外包相近,但這還沒計入它在效率上的劣勢。
成本與步數:能力過門檻,落地卡在這兩關
分數過了人類水準,不等於代理就划算或可靠。a16z 引述一個直觀的落差:一個人兩三分鐘做完的任務,代理可能要花八到十分鐘——因為每一次規劃與反思都要呼叫大模型,這些呼叫主導了延遲,也讓代理的步數遠多於人類。換算下來,雖然帳面時薪壓低了,但「完成同一件事的總成本」可能反而更高,這正是電腦操作代理至今仍多作為輔助、而非全面取代的原因。
不過落地確實在發生。a16z 接觸的企業案例顯示,某消費品資料平台每月跑約 1,500 萬到 2,000 萬次自動化入口互動,並把維護爬蟲的工程團隊砍掉一半;一家系統整合商有 27 條上線流程、每天處理約 1,500 到 2,100 張 IT 工單。有趣的是,一位每月跑數百萬次任務的營運者坦言,他根本不知道底層是哪個模型——因為供應商像雲端業者換硬體一樣為他切換模型,用便宜的非前沿模型就「夠用且做得好」。a16z 的觀察是:他們在用戶端沒看到更複雜的應用,顯示市場仍停留在容易的應用上。
跨過的是分數,不是生產力
把這些擺在一起,訊號很清楚:在 OSWorld-Verified 這個最受注視的電腦操作基準上,最強模型一年內從 42% 衝到 85%,分數上已經跨過人類水準,Claude Fable 5 暫居榜首。但分數跨過門檻,與「能穩定、划算地取代人類操作」之間,還隔著步數效率、單次與平均表現的穩定度落差,以及真實工作流程的長尾難題。對追蹤模型能力的人,這是一條明確上升的曲線;對想把代理推上生產線的人,成本與可靠度才是下一戰。