GB/s 等級的分詞吞吐量
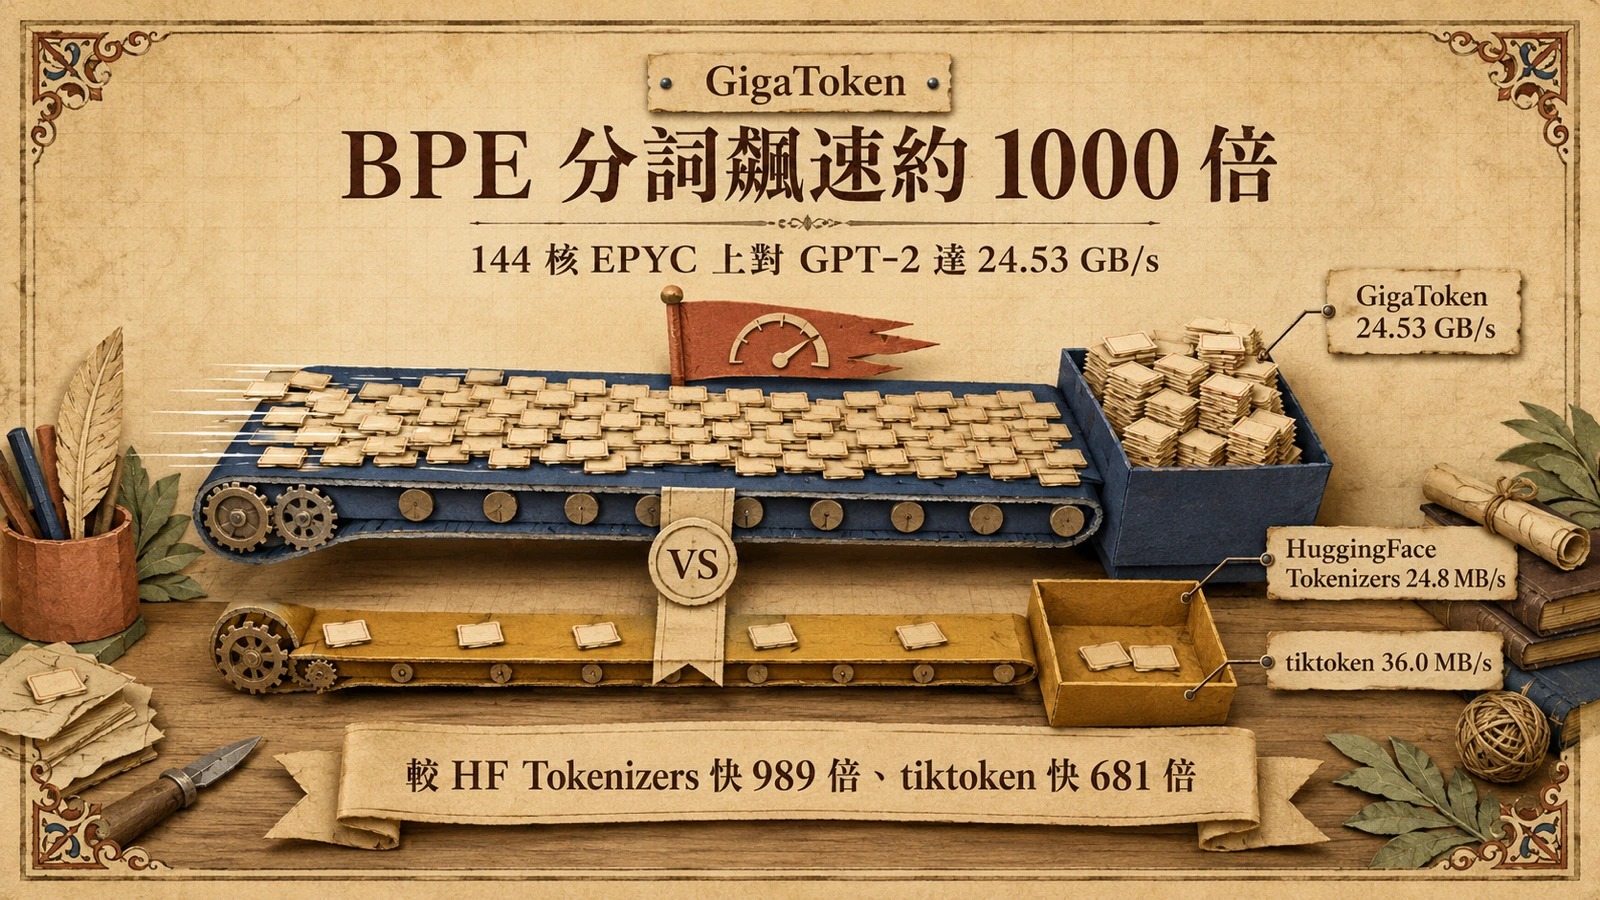
開發者 Marcel Rød 在 GitHub 釋出 GigaToken,標榜是目前最快的語言模型 tokenizer,以 Rust 撰寫、透過 pip 即可安裝。官方基準在 AMD EPYC 9565 雙路 144 核平台上,對 11.9 GB 的 OpenWebText 訓練檔做 GPT-2 分詞,吞吐量達 24.53 GB/s,約 5,565 Mtok/s;同一資料上 HuggingFace Tokenizers 為 24.8 MB/s,tiktoken 為 36.0 MB/s,換算分別快 989 倍與 681 倍。換言之,整個約 130 兆 token 的 Common Crawl,理論上可在 6.5 小時內完成分詞。
GigaToken 官方基準涵蓋主流 BPE 詞表,包括 Llama 3/3.3/4、Qwen 2/3/3.5、DeepSeek V3/R1/V4、GLM 4/5、Phi-4、GPT-OSS、Kimi K2 等,在 EPYC 上多落在 18 至 24 GB/s 區間。作者強調,比較基準中 HF 與 tiktoken 本身已是多執行緒 Rust 實作,差距來自 SIMD 化的預分詞(pre-tokenization)、分支消除與多層預分詞快取,而非對手沒有平行化。
為什麼能快上千倍:SIMD、分支消除與多層快取
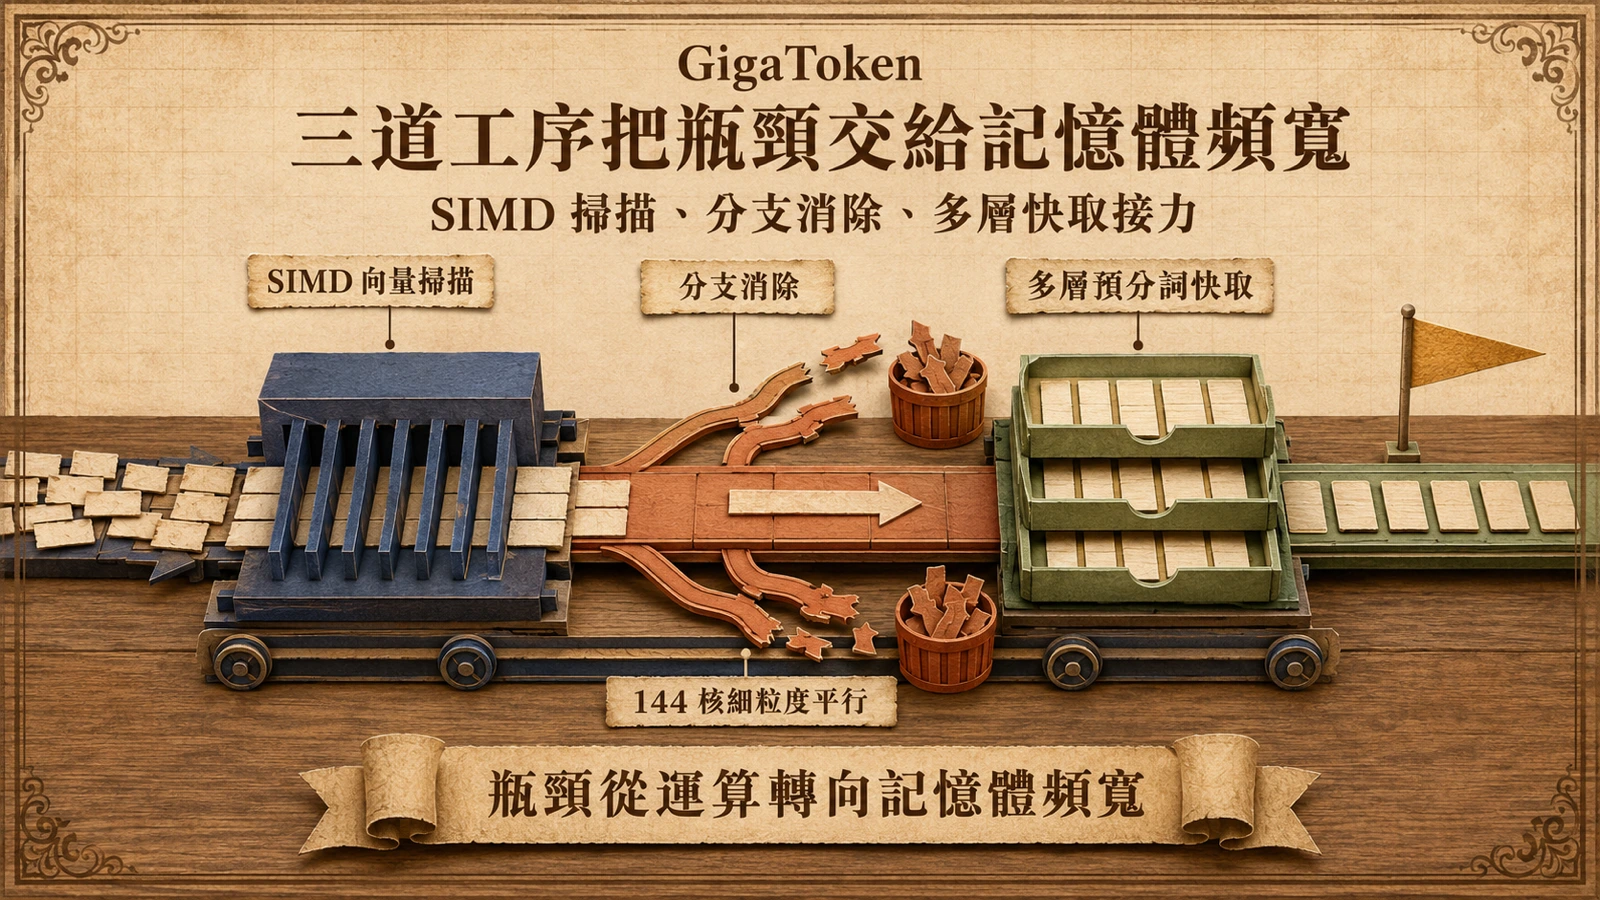
要理解 989 倍的差距從何而來,得回到 BPE 分詞本身的瓶頸。BPE 的標準流程是先用一組正則把文字切成「預分詞」(pre-token),再對每段重複查表、合併詞表中最頻繁的位元組對。這個流程的熱點不在合併邏輯,而在預分詞階段的逐字元掃描與大量分支判斷——輸入是任意 Unicode,正則引擎必須頻繁地分岔處理空白、標點與多位元組序列,分支預測失誤會把管線打斷。GigaToken 把預分詞改寫成 SIMD 化的向量化掃描,一次處理多個位元組,並消除熱路徑上的分支,讓 CPU 能以接近記憶體頻寬的速率吞吐文字。
第二個關鍵是多層預分詞快取。同一份訓練語料中,重複的預分詞片段(常見詞、固定片語、程式碼 token)出現頻率極高;GigaToken 在多個層級快取這些片段的切分結果,避免對相同輸入重跑正則。搭配 144 核的細粒度平行,瓶頸從運算轉移到記憶體頻寬,這也是為什麼官方數字逼近 24 GB/s——幾乎是在「用記憶體讀取的速度在分詞」。值得留意的是,這個極限值高度依賴大量檔案與高核數 CPU:原生 API 讓 Rust 直接讀檔、跳過 Python 資料結構往返,才是把頻寬吃滿的前提。
相容模式與原生 API 的取捨
GigaToken 提供兩條接入路徑。相容模式可把既有 HuggingFace 或 tiktoken 物件包進 gt.Tokenizer(...).as_hf() 或 .as_tiktoken(),幾乎不改程式即可運作,並投入大量功夫確保輸出與 HF 一致;但作者明白指出,相容模式會有「不可忽視的效能損耗」,無法拿到原生 API 的 1000 倍量級提升。原生 Gigatoken API 則讓 Rust 直接讀檔、跳過 Python 資料結構往返,搭配 encode_files 與 TextFileSource 達到最高吞吐。
現階段的限制也清楚:WordPiece 尚未支援、檔案輸出尚未實作、Windows 僅建議走 WSL。最慢的一群是 SentencePiece 系(Gemma、Mistral、CodeLlama、TinyLlama),在 EPYC 上僅約 3.4 至 4.8 GB/s,相對 HF 提升收斂到 7 至 22 倍;作者將 SentencePiece 列為低優先,主因是 Google 與 BERT 體系以外多已轉向 BPE。
1000 倍之後的等價性風險:分詞器不是無狀態函數
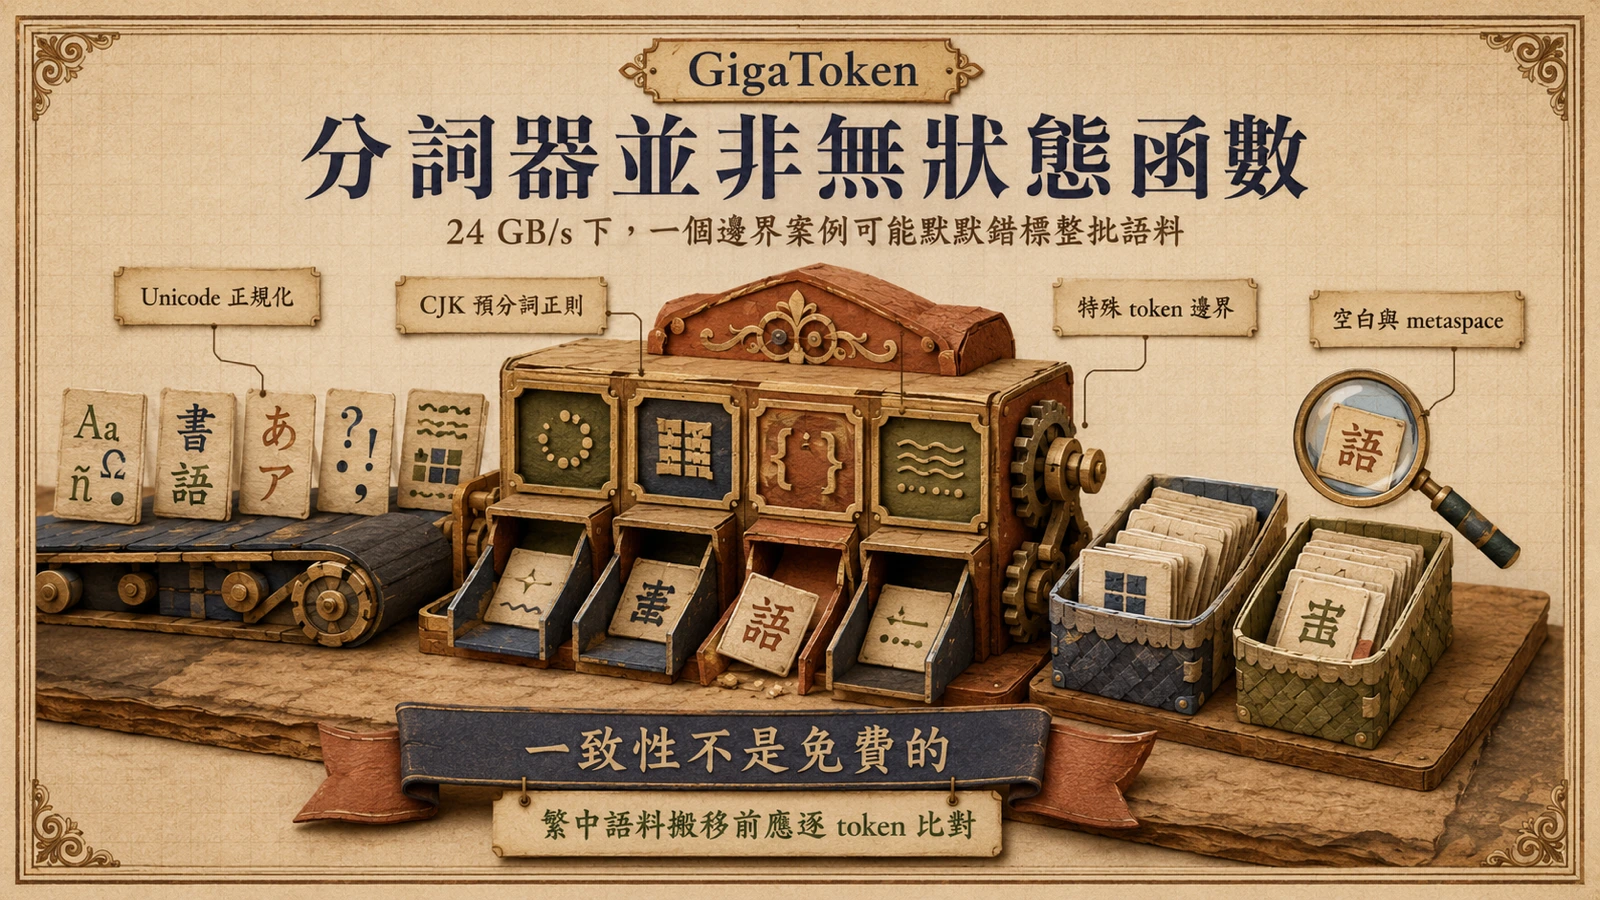
989 倍的速度固然驚人,但它把風險從運算時間轉移到輸出等價性。BPE 在規格上看起來是確定性的查表合併,實務上卻不是無狀態函數:Unicode 正規化(NFKC 或 NFC)、空白與 metaspace 的處理、特殊 token 邊界、以及 CJK 預分詞正則的差異,長年是 HF、tiktoken、SentencePiece 之間輸出不一致的根源。作者強調「投入大量功夫確保輸出與 HF 一致」,正說明一致性不是免費的——而當分詞器跑在 24 GB/s,任何一個邊界案例的錯位都可能在一個晚上把整批語料默默錯標,且直到模型收斂異常才被發現。對 CJK 語料尤其如此:中文、日文預分詞正則與詞表設計的差異,正是各分詞器歷史上最容易分歧之處,這也是繁中訓練團隊在搬移前最該用自有語料跑逐 token 比對、而非直接相信基準數字的原因。
所以呢:誰該換、誰要等
對每天要對 TB 級網路文本做前處理的訓練團隊,分詞從分鐘級壓到秒級,代表資料管線的 CPU 預算與等待時間可大幅縮短,重算、重洗 corpus 的成本門檻同步下降。對推論服務或單文件即時分詞的場景,受 Python 往返與 ABI3 限制,提升不會到基準的極限值,需自行用 gigatoken bench 在目標 CPU 上實測。若語料取得依賴公開網站,還要把來源端的基礎設施成本算進去;The Numbers 因 AI 爬蟲占九成流量而停機重建的案例說明,處理端吞吐提升不等於抓取端沒有外部成本。
選型上,BPE 詞表的 Llama、Qwen、DeepSeek、GLM、Phi 陣營是最大受益者;Gemma、Mistral 等 SentencePiece 用戶則應等待後續優化,或先在相容模式下評估一致性與實際增益再決定是否搬移。若瓶頸在端側記憶體與算力,而不是訓練資料前處理,可改看〈ESP32-S3 執行 28.9M 參數 LLM 的實測〉;若瓶頸在伺服器端的推論吞吐而非分詞,〈騰訊 AngelSpec 的推測解碼〉則示範了從解碼階段與驗證調度擠出加速的另一條路;若瓶頸在長上下文的 KV cache 記憶體與解碼延遲,〈Kimi Linear〉的混合線性注意力則從架構層把記憶體占用與序列長度脫鉤,是同一條端到端成本曲線上的另一個槓桿;若瓶頸在 OCR 等長輸出解碼的 KV cache,〈Unlimited-OCR〉的 R-SWA 更把解碼階段的 KV cache 固定為恆定,是針對長輸出任務的更激進一端。