從記憶體圖索引走向全快閃
小紅書(RedNote/Xiaohongshu)的搜尋、推薦與廣告服務高度依賴近似最近鄰搜尋(approximate nearest neighbor search, ANNS)。在嚴格的服務水準協議(SLA)下,過去必須仰賴記憶體內的圖形索引 HNSW 才能同時兼顧吞吐與低延遲。然而用戶與內容規模持續膨脹,記憶體佔用隨之失控,資本與營運成本成為瓶頸。該團隊在 OSDI ‘26 發表的論文《The Clustering Strikes Back: Building Cost-Effective and High-Performance ANNS at Scale with Helmsman》指出,將 ANNS 從 HNSW 遷移到建構於全快閃(all-flash)伺服器之上的聚類式(clustering-based)架構,是兼顧成本與效能的可行走法。
HNSW 的記憶體天花板
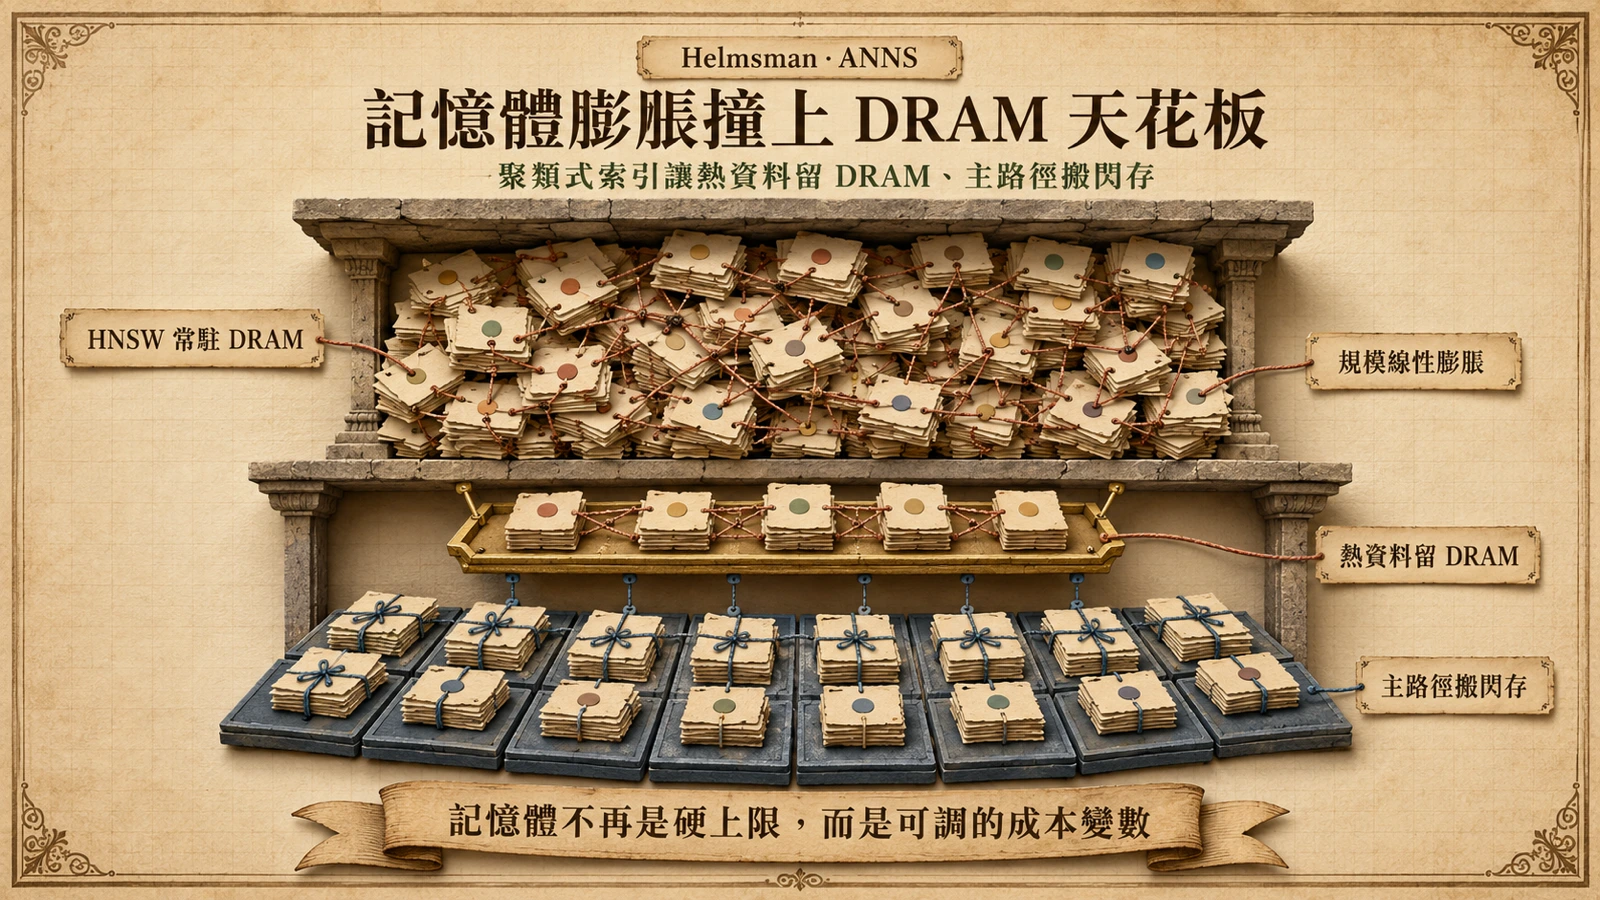
理解 Helmsman 的價值,得先看清楚它取代了什麼。HNSW(Hierarchical Navigable Small World)之所以長期是 ANNS 的主流,是因為分層圖結構能在毫秒級完成檢索、召回率又高;但它的代價是把整張圖與所有向量常駐 DRAM。當向量數量從億級走向十億級,每新增一個向量就連帶新增多條鄰居邊,記憶體佔用幾乎隨規模線性膨脹。對小紅書這類內容平台,使用者與筆記向量持續累積,DRAM 容量很快就從「可規劃的成本」變成「卡住擴張的硬上限」——既要維持 SLA、又不能無上限堆機器,這正是 HNSW 在超大規模下的結構性困境。
聚類式索引走的是另一條路:先把向量空間切成一群群聚類,查詢時只載入少數最相關的聚類,其餘留在較便宜的儲存層。這讓「熱資料留 DRAM、檢索主路徑搬閃存」成為可能,把記憶體從硬上限重新定義為可最佳化的成本變數。挑戰則在於閃存的讀取延遲與軟體棧的額外開銷,得靠工程補回來。
三項關鍵設計
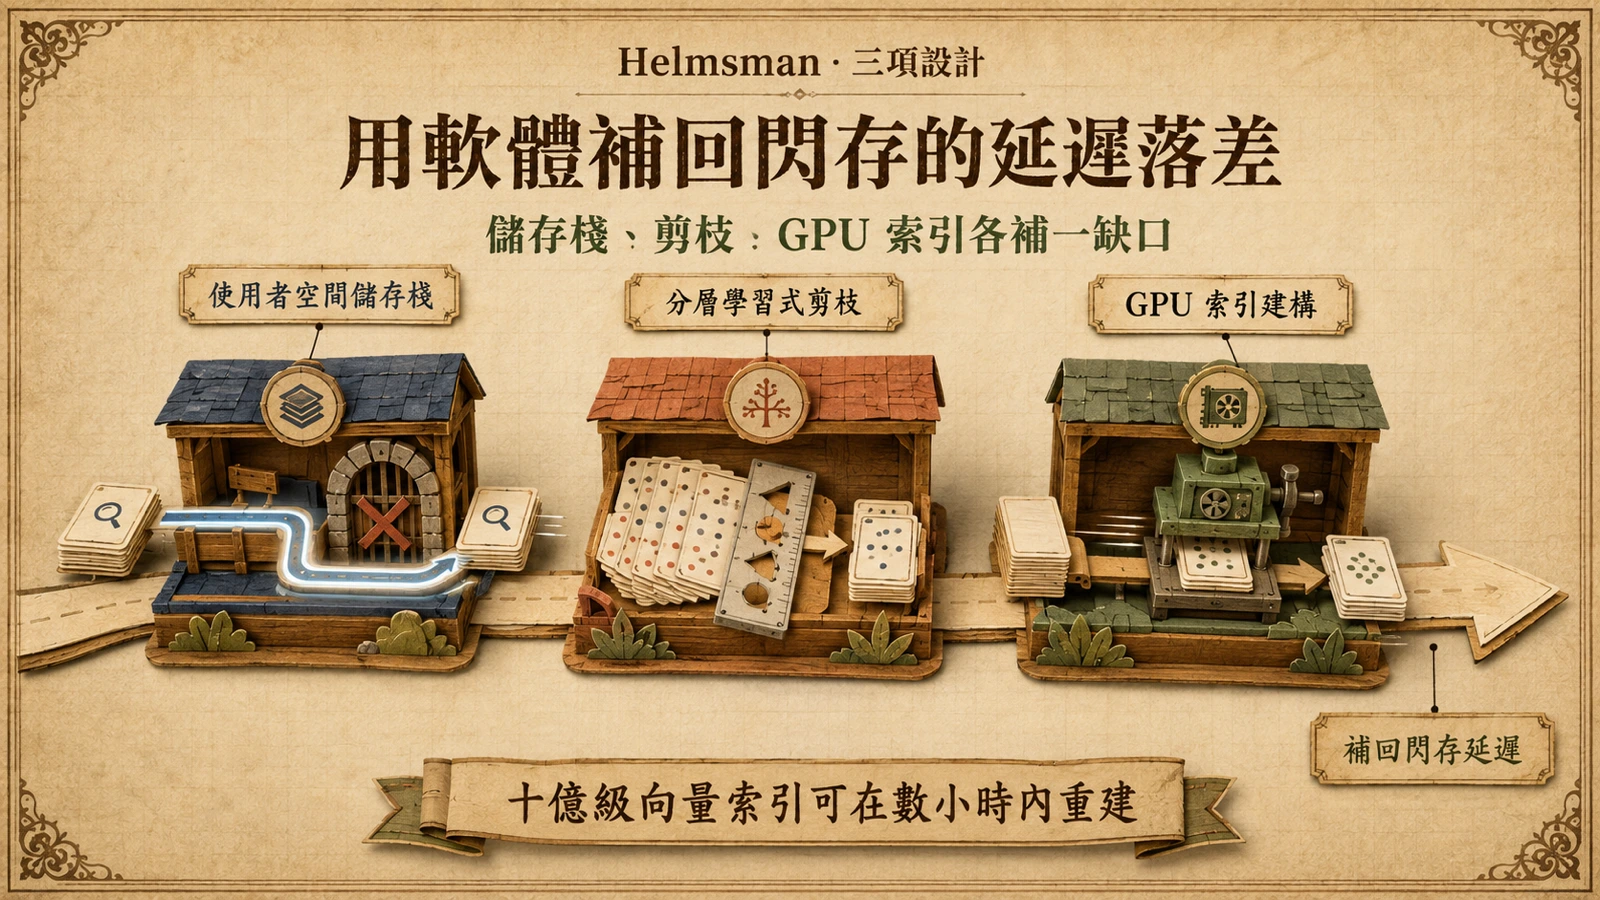
根據 USENIX 公開的論文摘要,Helmsman 結合三項核心元件:面向 ANNS 的使用者空間(userspace)儲存棧,藉以繞過核心 I/O 路徑、降低閃存讀取的額外開銷;分層學習式剪枝(leveling-learned pruning)模組,取代固定式剪枝策略以動態收斂搜尋空間;以及 GPU 加速的索引建構管線,讓十億級向量規模的索引重建可在數小時內完成。作者群來自小紅書、華東師範大學與上海交通大學,論文收錄於 OSDI ‘26 論文集第 1623 至 1639 頁。
三項設計各自補一個把檢索搬到閃存後出現的缺口。使用者空間儲存棧處理的是核心 I/O 的額外開銷:傳統核心路徑每次讀取都要經過系統呼叫與上下文切換,對閃存的細粒度隨機讀取是沉重放大,繞過核心等於把這段開銷削掉。學習式剪枝處理的是召回率:聚類式架構若用固定規則剪枝,會在邊界案例犧牲精確度,改用學習到的策略可依資料分布動態收斂搜尋空間。GPU 索引建構則回應十億級規模下「重建一次要多久」的營運現實——數小時內完成才讓索引重建跟上內容更新節奏,成為可常態化的作業。
對大規模檢索基礎設施的意義
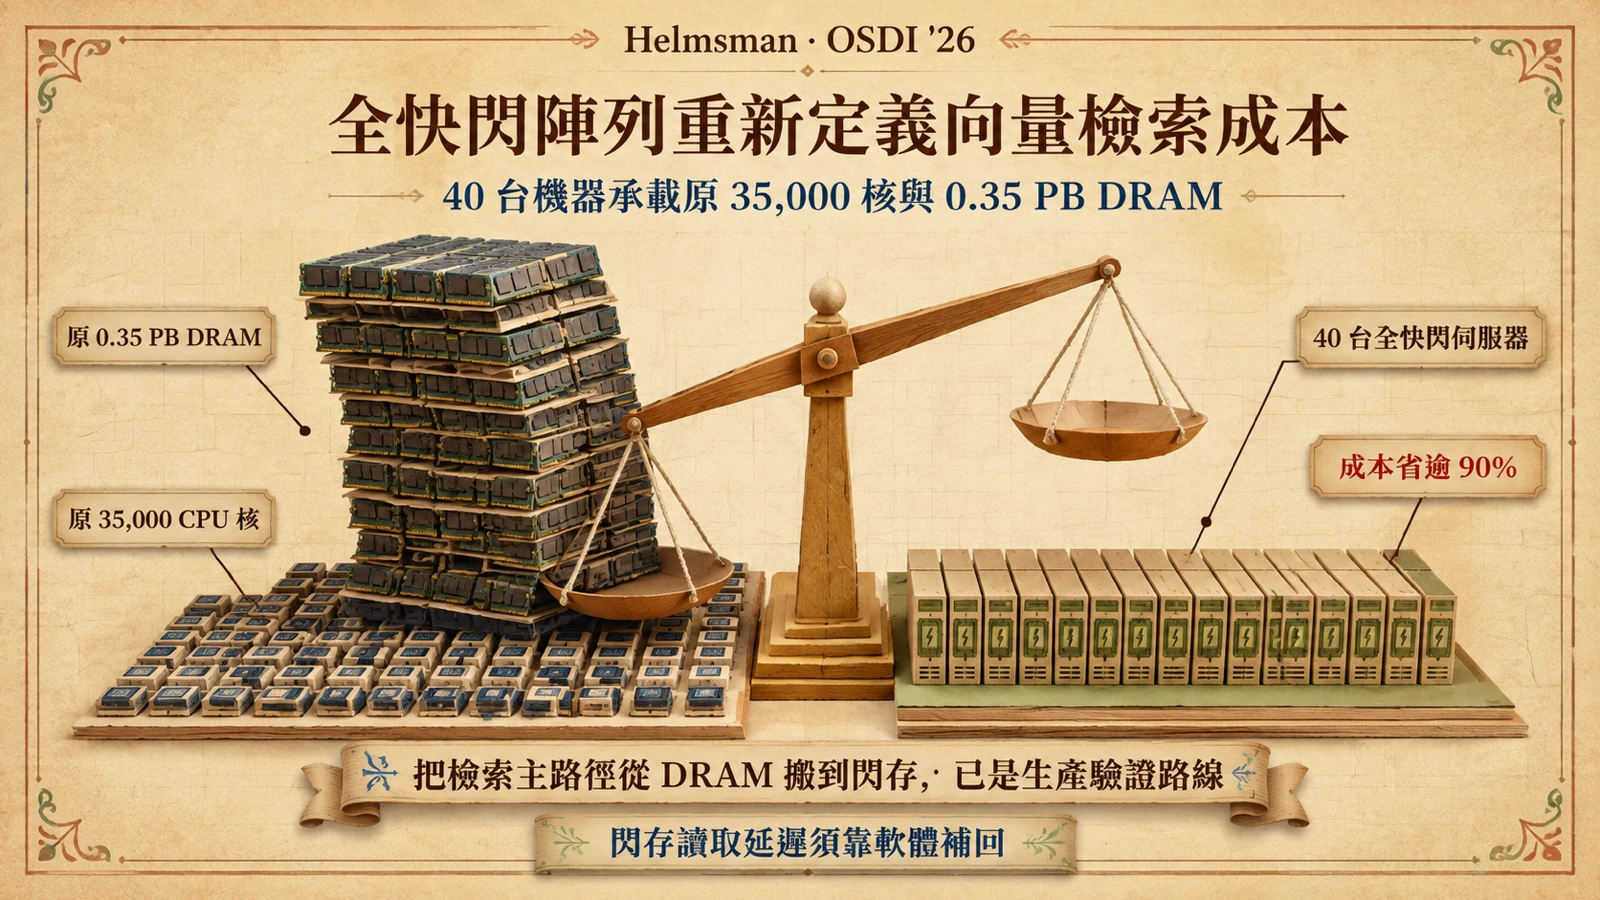
真正值得決策者關注的數字在落地成果:論文明白寫道,目前上線部署已穩定運行數個月,40 台全快閃伺服器承載了過去需要約 35,000 個 CPU 核與 0.35 PB DRAM 才能支撐的 ANNS 工作負載,硬體成本節省超過 90%。這組對比說明:當向量檢索進入十億級規模,純記憶體方案的邊際成本將快速失控,把熱資料留在 DRAM、把檢索主路徑搬到閃存並以軟體補回延遲落差,已是經過生產驗證的路線。若要把這條成本曲線放進更大的 AI 需求背景,可對照 Alphabet 財報揭露的 Cloud 訂單與每分鐘 220 億 token 用量;前者聚焦檢索基建,後者呈現整體運算需求。對任何正在評估 RAG 與推薦系統基礎架構的團隊而言,Helmsman 提供的不是另一個 ANN 演算法,而是一份可參照的儲存─計算重構成本曲線。若需先釐清這類系統在 RAG 中的角色,可先看〈Embedding 與向量檢索〉的定義。