快取為何會在長會話中過期
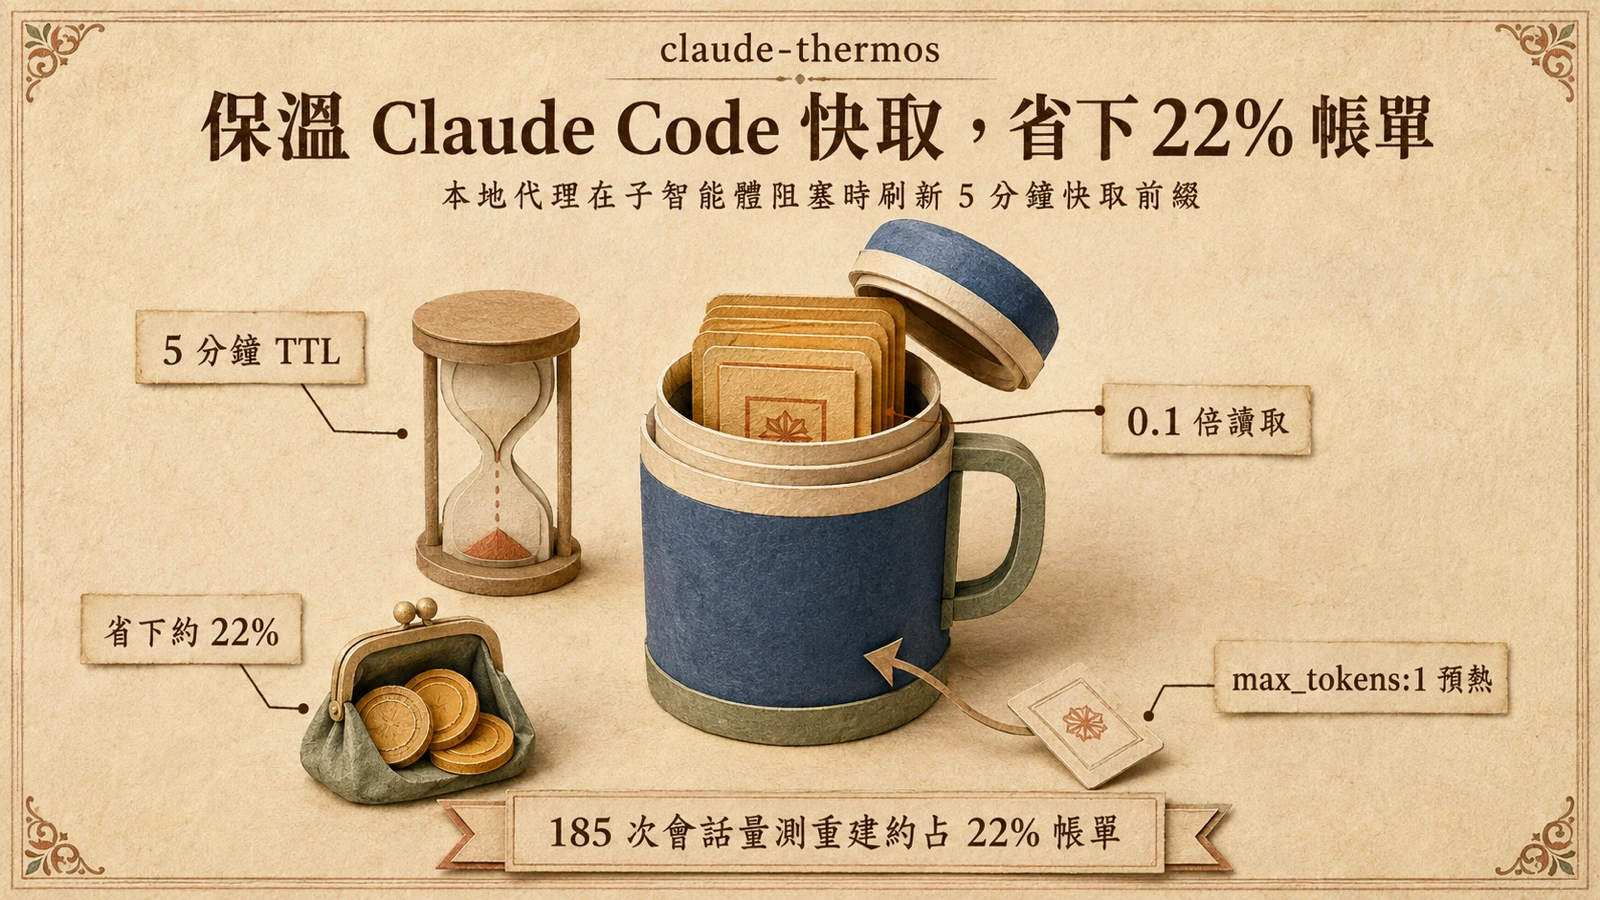
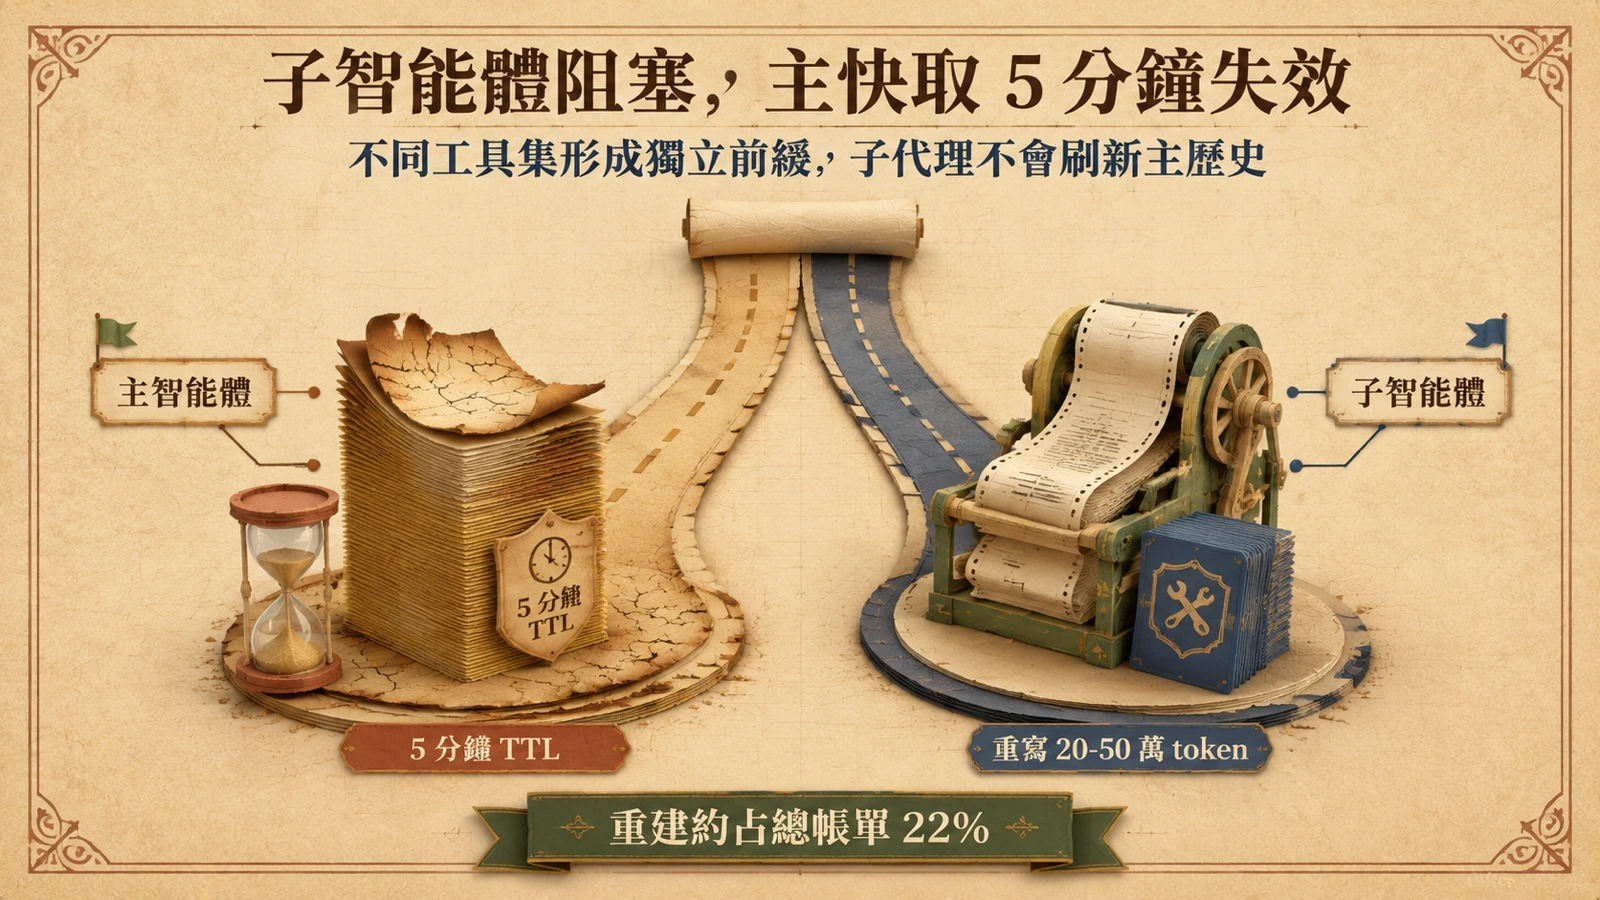
Claude Code 的提示詞快取採用 5 分鐘 TTL,命中時整段對話歷史以 0.1 倍輸入價讀回;一旦同一前綴超過 5 分鐘無請求,快取失效,下一輪就必須以 1.25 倍寫入費率重新編碼。在多智能體的長會話中,主要的失效觸發點並非開發者思考時間,而是主智能體被一個執行超過 5 分鐘的子智能體阻塞。子智能體因系統提示與工具集不同而擁有不同的快取前綴,永遠不會刷新主智能體的快取,主歷史於是在無人觸碰下老化失效。作者量測約 185 次本地會話,這類重建約占總帳單 22%,單次失效常重寫 20 萬到 50 萬個模型 token,等於把片刻前還在快取裡的內容再付一次錢。
本地反向代理的保溫機制
claude-thermos 在本機啟動一個小型反向代理,把 ANTHROPIC_BASE_URL 指向回環端口,所有流量仍送往真實 Anthropic API。代理監看 /v1/messages 流量,依「模型+工具集+系統文字」組成快取譜系,第一個帶工具的譜系視為主智能體,其餘為子智能體。當主譜系閒置而某個子智能體仍在運行,代理會在 5 分鐘 TTL 內以 max_tokens:1、不啟用串流的方式,重播主智能體最後一次真實請求;這顆回傳的單 token 會被丟棄,重點在於 prefill 階段讀回並刷新完整快取前綴。預熱請求直接送至 API,不經代理,因此不會干擾真實流量。工具以 uvx claude-thermos 取代原本的 claude 指令即可運作,需 Python 3.11+ 與 PATH 中的 claude CLI,設定 CLAUDE_THERMOS_DISABLE=1 可在單次執行中停用。
保溫機制的邊界與失效情境
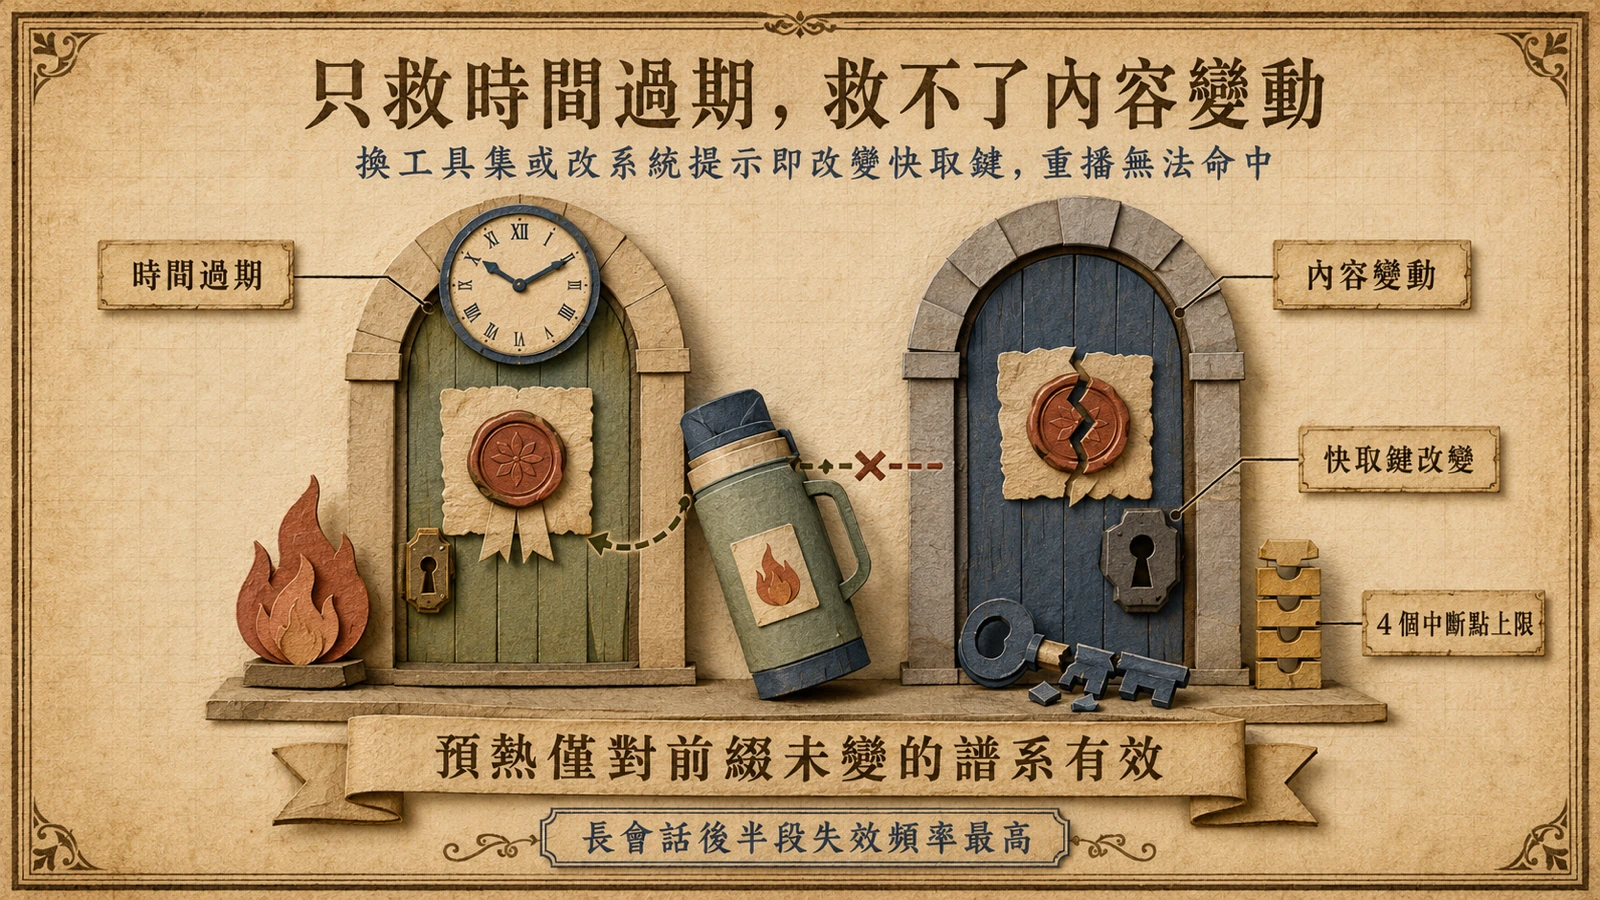
理解 claude-thermos 的限制,等於理解 prompt cache 的運作前提。預熱只對「快取前綴未變」的譜系有效:一旦主智能體在會話中途更換工具集、改寫系統提示,或累積的對話歷史讓前綴超出 4 個可中斷點的限制,快取鍵就會改變,此時重播舊請求也無法命中,重建仍會發生。換句話說,這個工具省下的是「內容沒變、只是時間過期」這一類失效,對「內容本身就變了」的失效無能為力——而長會話後半段,恰好是後者發生頻率最高的位置。
此外,保溫本身並非零成本。每次預熱都付出一次 0.1 倍的快取讀取費,若一個會話反覆在主、子代理之間切換、觸發大量預熱循環,累積的小額讀取也可能侵蝕原本要省下的金額。作者把這層權衡寫進 summary.json 的 net_savings 欄位,讓使用者能用自己帳單的實際 token 單價回算淨收益;這個欄位也是判斷 claude-thermos 在特定工作流上「到底划不划算」的最直接依據,而非直接套用作者 22% 的量測結果。
費用權衡與適用場景
每次預熱只付一次 0.1 倍的快取讀取,能避免一次在更大前綴上、1.25 倍的完整重寫,權衡明顯有利。預設參數 —idle 270 秒、—interval 270 秒、—max-cycles 4、—subagent-window 540 秒皆可調整。每個會話會在 ~/.claude-thermos/logs 寫出 events.jsonl 與 summary.json,後者彙整 warms_fired、rewrite_avoided_tokens、net_savings 等欄位;net_savings 乘以模型每輸入 token 價格即為美元節省額,作者舉例在每百萬 token 3 美元的費率下,net_savings 達 120 萬約可省下 3.60 美元。若要把快取節省放回模型整體經濟性,可接著看 Claude Opus 5 的每任務成本拆解;前者處理會話層浪費,後者比較模型層價格與完成率。新版 serve 模式可作為常駐代理,讓 VS Code 擴充套件與多個終端共享同一個保溫器,單一代理即可覆蓋整機所有客戶端。截至撰稿,專案在 GitHub 約 156 stars、採 MIT 授權,對重度依賴 Claude Code 多智能體工作流的團隊,是把隱性稅轉為可控支出的實用工具。若團隊也在比較其他終端代理,可延伸閱讀xAI Grok Build CLI 的 Skills、Plan 與 Subagents 設計。