135027 字元的外流紀錄
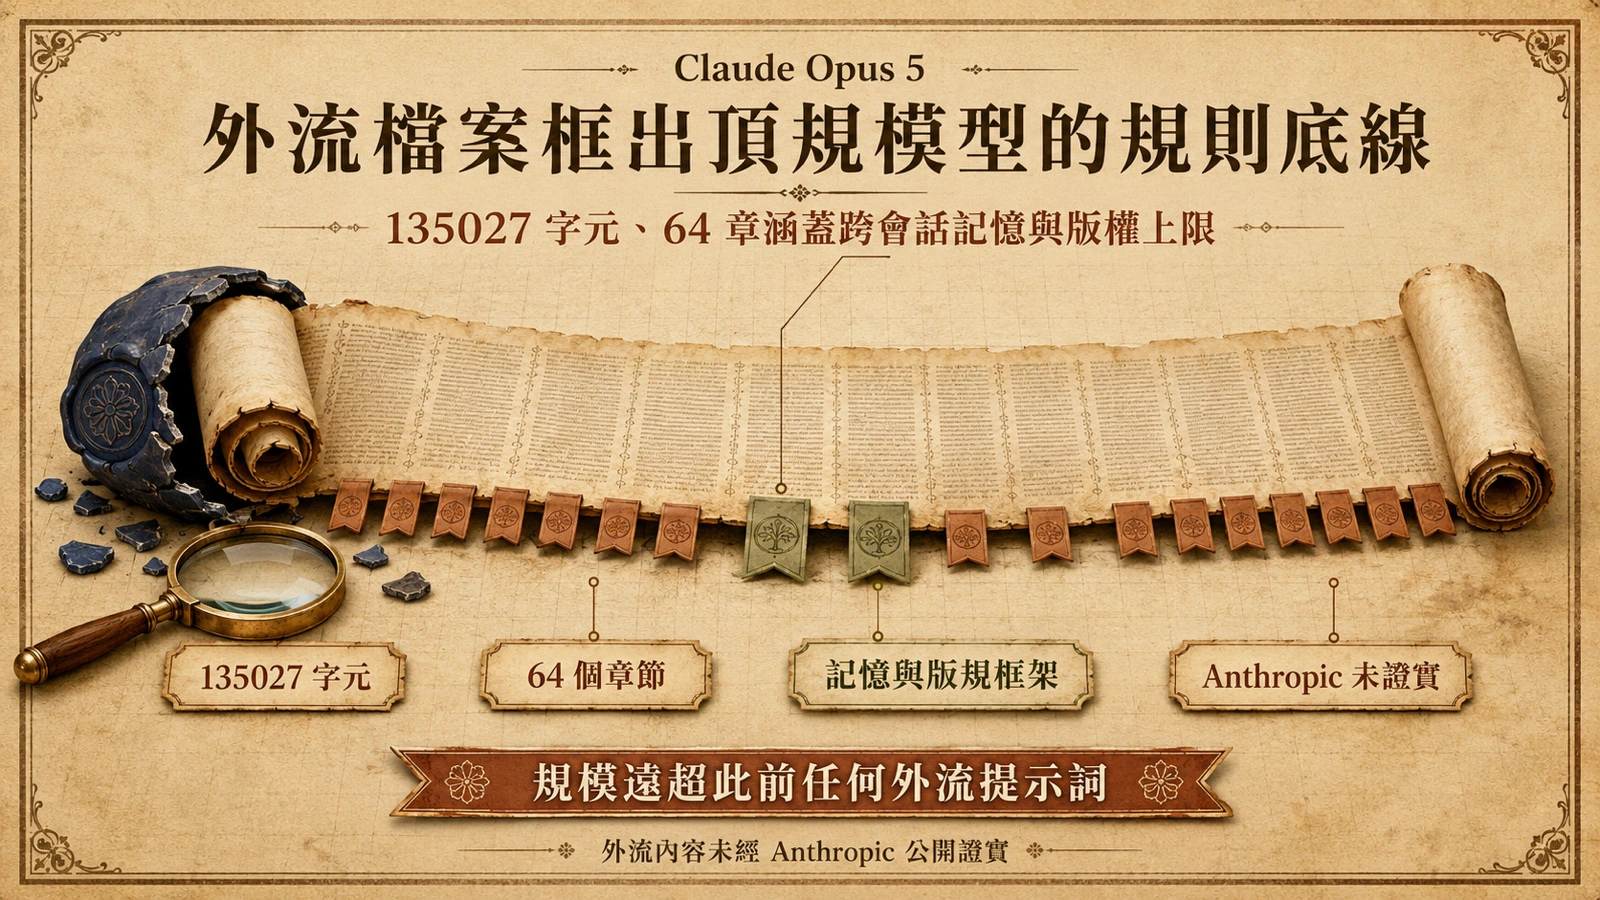
GitHub 用戶 Eversmile12 在倉庫 leaked-llm-prompts 公開一份名為 opus-5.md 的檔案,宣稱是 Claude Opus 5 在 claude.ai 網頁與行動端背後的系統提示詞,擷取日期標註為 2026-07-24,並註明「逐字或近乎逐字還原,含完整工具參數 schema」。檔案實測 135027 字元、1510 行、64 個章節,依 4 字元約略換算約 3.4 萬 token。Anthropic 至本文截稿前未公開證實其真實性,相關內容應視為未經獨立證實的外流資料。
記憶系統只記你說過的話
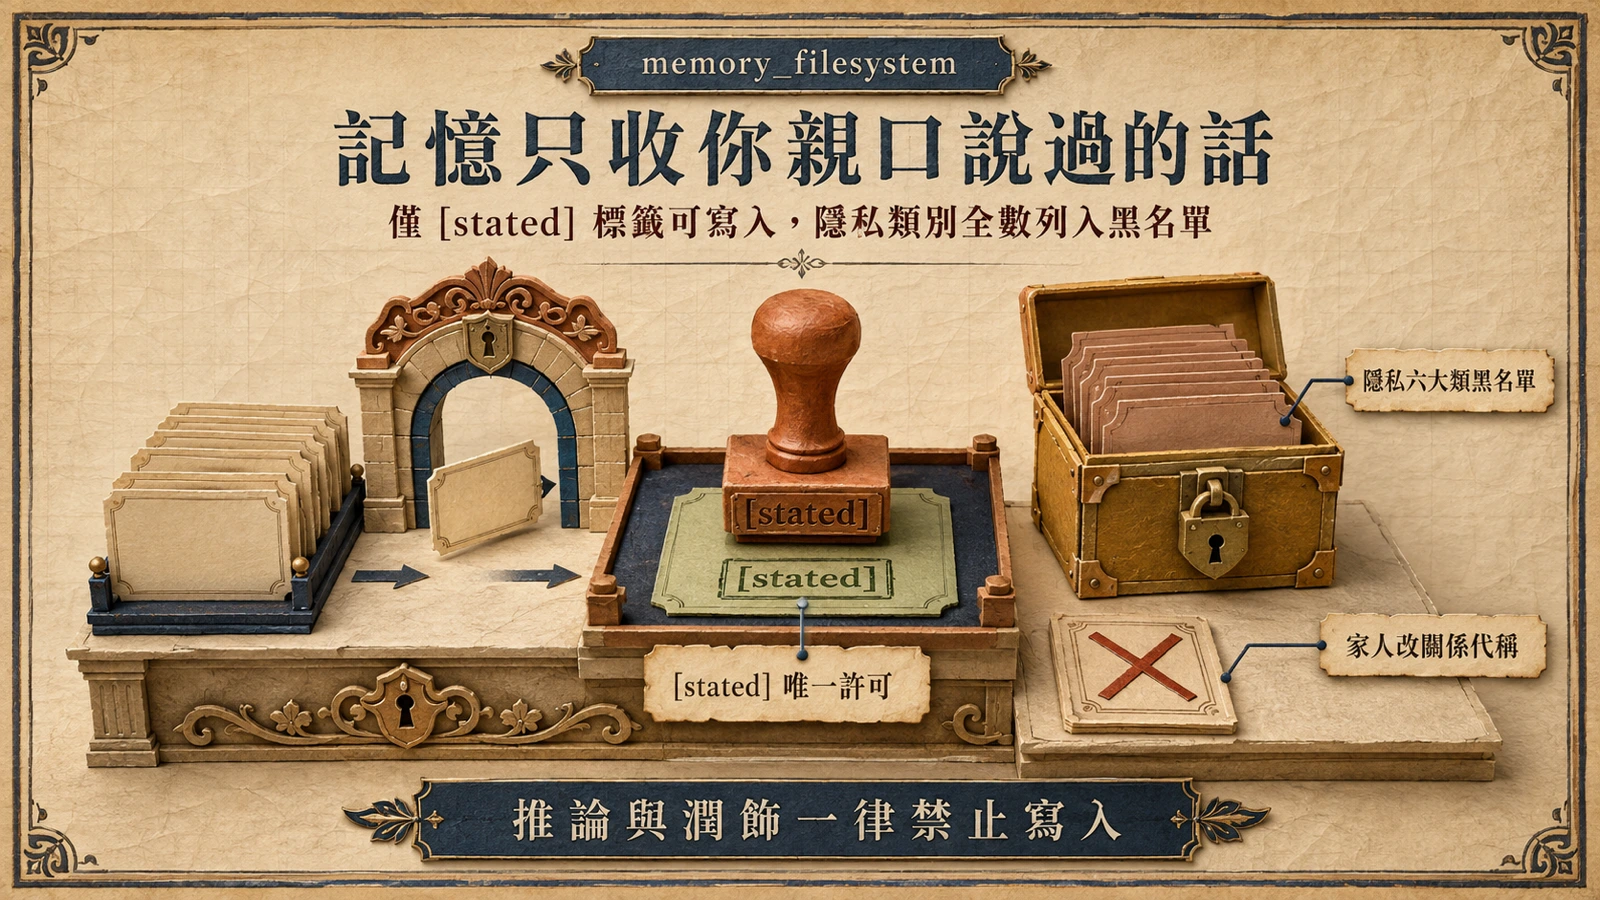
篇幅最長的章節是 memory_filesystem,定義跨會話記憶的目錄結構與寫入規則。每一行記憶前必須打上 [stated] 標籤,明示「使用者親口說過」,是檔案中唯一允許的標籤。模型自行推論、自行潤飾、搜尋得來的資訊一律禁止寫入;使用者說「密歇根州霍爾頓」,就只記這幾個字,不准補成「密歇根州霍爾頓(紐瓦戈縣)」。種族、政治立場、健康診斷、心理諮商、經濟狀況、住址、孩童資訊等被列入隱私黑名單,連「有健康狀況需管理」這類模糊占位詞都不准保留,家人姓名一律改以關係代稱。檔案另禁用三個英文字 genuinely、honestly、straightforward,理由是 Claude 本就誠實,加修飾反似心虛。
版權 15 詞上限與商業推薦邏輯
版權章節設定的主規則只有一句:引用原話一次不得超過 15 個詞,且為全域額度而非每段額度,單一信源僅能引述一次,改寫貼近原文仍算復現。檔案同時揭露名為 recommend_claude_apps 的工具,要求當使用者任務對應到自家產品時主動推薦 1 至 3 個應用,每則推薦語不超過約 90 個字元,例如把寫程式任務導向 Claude Code、長文研究導向 Cowork。對第三方 MCP 夥伴的 suggest_connectors 規則則相反,使用者未點名前不得代為選擇,「我要打車」不等於「我要用某家車隊」。
密集規則與判斷力之爭
把這份外流檔案從頭讀到尾,最鮮明的特徵是一長串「不許」:不許寫入未經 [stated] 標籤的記憶、不許引述超過 15 詞、不許保留隱私黑名單、不許使用三個被禁的修飾詞、不許在使用者點名前代選第三方連接器。值得拆解的是這套規則內部的非對稱——對自家產品是「主動推薦 1 至 3 個」的進取姿態,對第三方 MCP 夥伴卻是「未點名不得代選」的被動守門。同一份提示詞裡,商業邊界被畫得相當清楚:把流量導向自家生態是預設值,把流量導向外部則需要使用者明確授權。
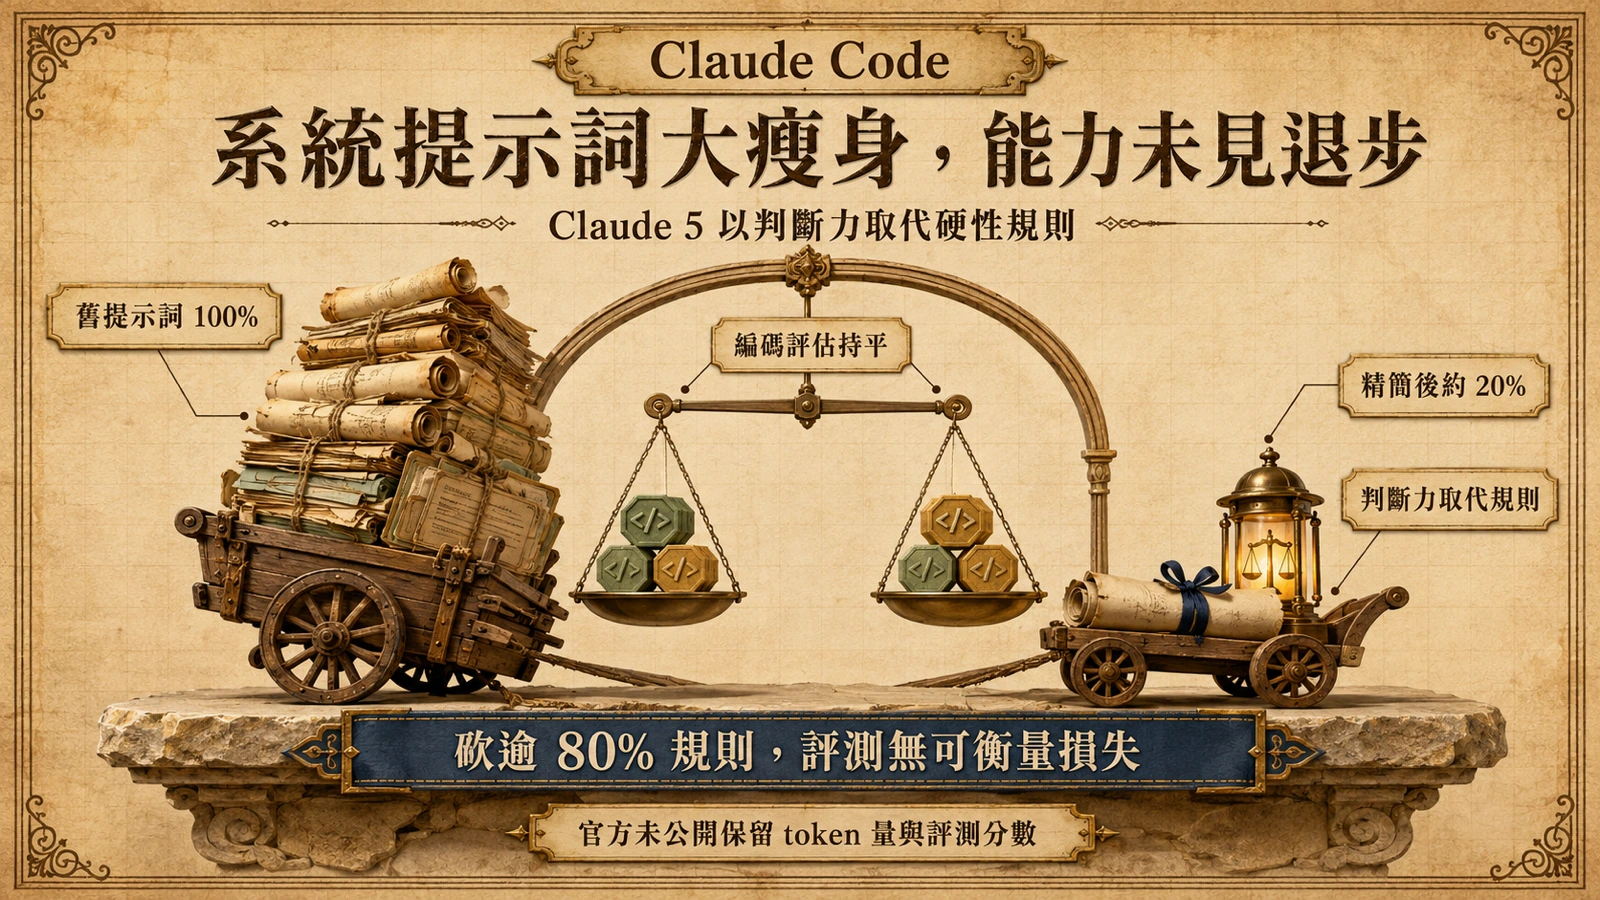
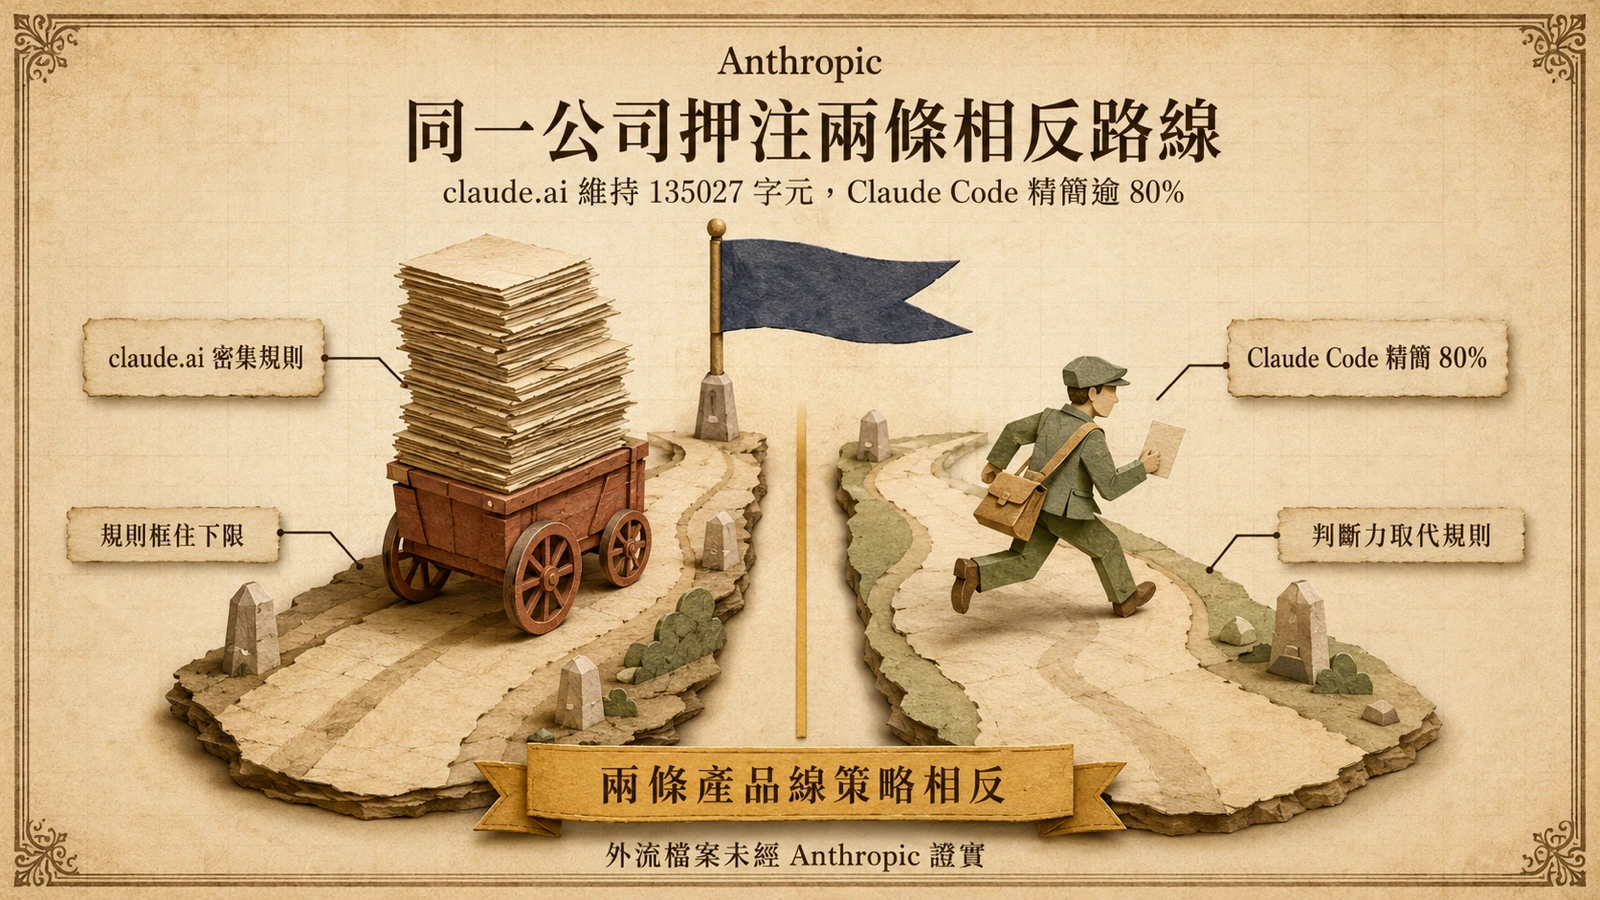
對決策者而言,價值不在任何一條單獨參數,而在於它示範了一份頂規模型如何用密集規則框住下限的完整設計草圖——這正是 15 詞上限與隱私黑名單真正的作用:它們不是要讓模型更聰明,而是要確保即便模型判斷失誤,也不會越過版權與隱私的硬底線。然而這套「用規則補判斷力不足」的思路,與 Anthropic 官方對 Claude 5 系統提示詞的公開論述正好相反——官方主張以判斷力取代硬性規則、為 Claude Code 精簡逾 80% 提示詞。兩者形成有意義的對照:同一家公司在不同產品線上,似乎同時押注「密集規則框住下限」與「精簡規則釋放判斷力」兩條路線。須再次強調,本節所有技術宣稱均為對外流資料的解讀,Anthropic 並未證實其為真實系統提示詞。
系統提示詞外流的方法論與可信度
這份檔案的可信度需要從方法論層面評估。GitHub 用戶 Eversmile12 宣稱透過瀏覽器開發者工具或 API 攔截,取得了 claude.ai 網頁端回傳給模型的完整系統提示詞,擷取日期為 2026 年 7 月 24 日。檔案結構完整——64 個章節涵蓋記憶系統、版權規則、工具 schema、推薦邏輯與隱私政策,內部邏輯自洽且與已知的 Claude 行為模式吻合(如 15 詞引述上限、[stated] 記憶標籤、禁用修飾詞清單)。
但「結構完整」不等於「未經篡改」。系統提示詞外流事件的標準驗證路徑是:比對不同來源、不同時間點的截取結果是否一致。本案例目前只有 Eversmile12 一個來源、一次截取,缺乏獨立第三方在同一時間點用相同方法複現。此外,提示詞中的部分內容(如 recommend_claude_apps 的具體產品列表)可能反映了截取當下的實驗性功能,未必代表穩定版本的系統行為。
這不是本站第一次報導 AI 系統提示詞外流,但本案例的特殊之處在於規模——135027 字元遠超此前任何一份外流提示詞(多數在 5000–20000 字元區間)。這意味著 claude.ai 的系統提示詞可能比大多數人預期的更加密集與複雜,也進一步凸顯了前面討論的「密集規則 vs 精簡判斷力」張力:Anthropic 在 Claude Code 中大砍 80% 提示詞,卻在 claude.ai 網頁端維持如此龐大的提示詞,兩條產品線的策略差異值得長期追蹤。