新架構家族的第一個成員
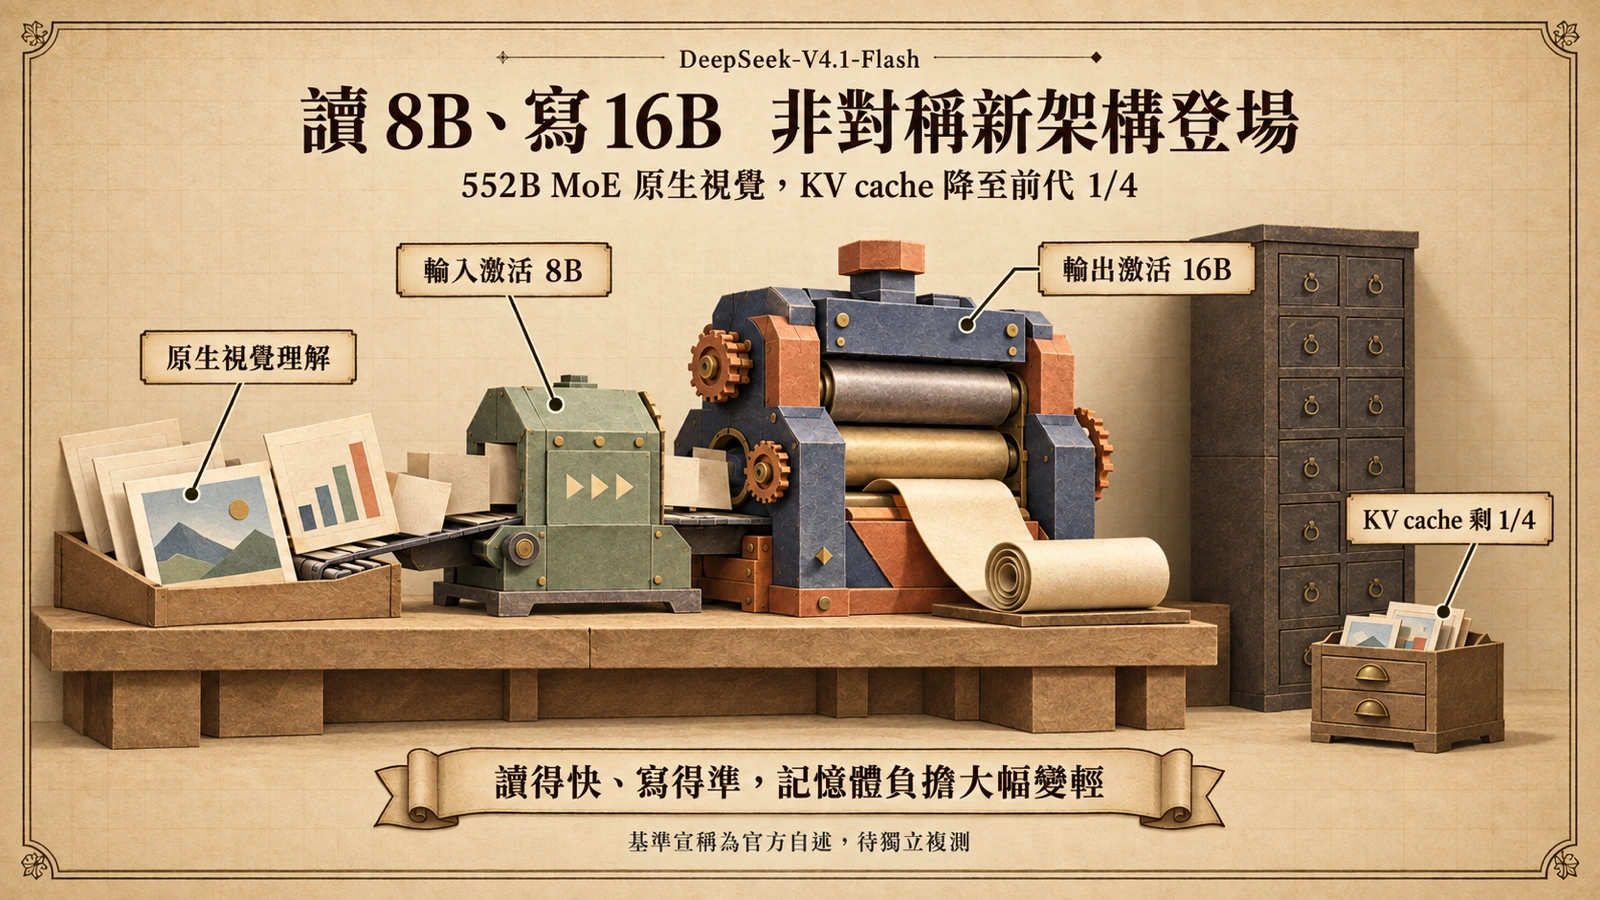
DeepSeek 台灣時間 9 月 10 日在官方 API 平台發布 DeepSeek-V4.1-Flash。官方變更日誌以「今天正式發布」的措辭宣布上架,並定位它為新架構家族中最小的模型、具備原生多模態視覺理解。依HuggingFace 模型卡載明的數字,模型擁有 552B 骨幹參數與 196B Engram 參數,prefill 階段每 token 激活 8B、解碼階段激活 16B——輸入激活小於輸出的配置,打破了主流 MoE「一組激活值走全程」的慣例。
「V4.1」這個版本號值得停下來看:它不是 V4-Flash 的小改款,而是新架構家族的起點。前一代 V4-Flash 是 284B 總參、13B 激活的輕量主力;V4.1-Flash 的參數規模明顯放大,卻透過讀寫分徑把輸入端的每 token 激活量壓得更低。官方公告同時表明,這套架構是為了擴展到更大模型而設計——V4.1-Flash 只是這個家族的第一塊基石,後續更大的成員才是真正的目標。
Causal Encoder-Decoder:讀與寫各有自己的路徑
要理解這次架構改動,先回到 Transformer 推理的兩個階段:prefill(預填)把整段 prompt 一次讀入、為每個 token 建立鍵值狀態;decode(解碼)再逐 token 生成輸出。兩個階段的負載特性完全不同——prefill 高度平行,比的是吞吐;decode 一步步走,每一步都受記憶體頻寬限制,且每個 token 的品質都直接寫進最終答案。過去的 MoE 不論讀或寫,每個 token 激活的專家規模都相同。
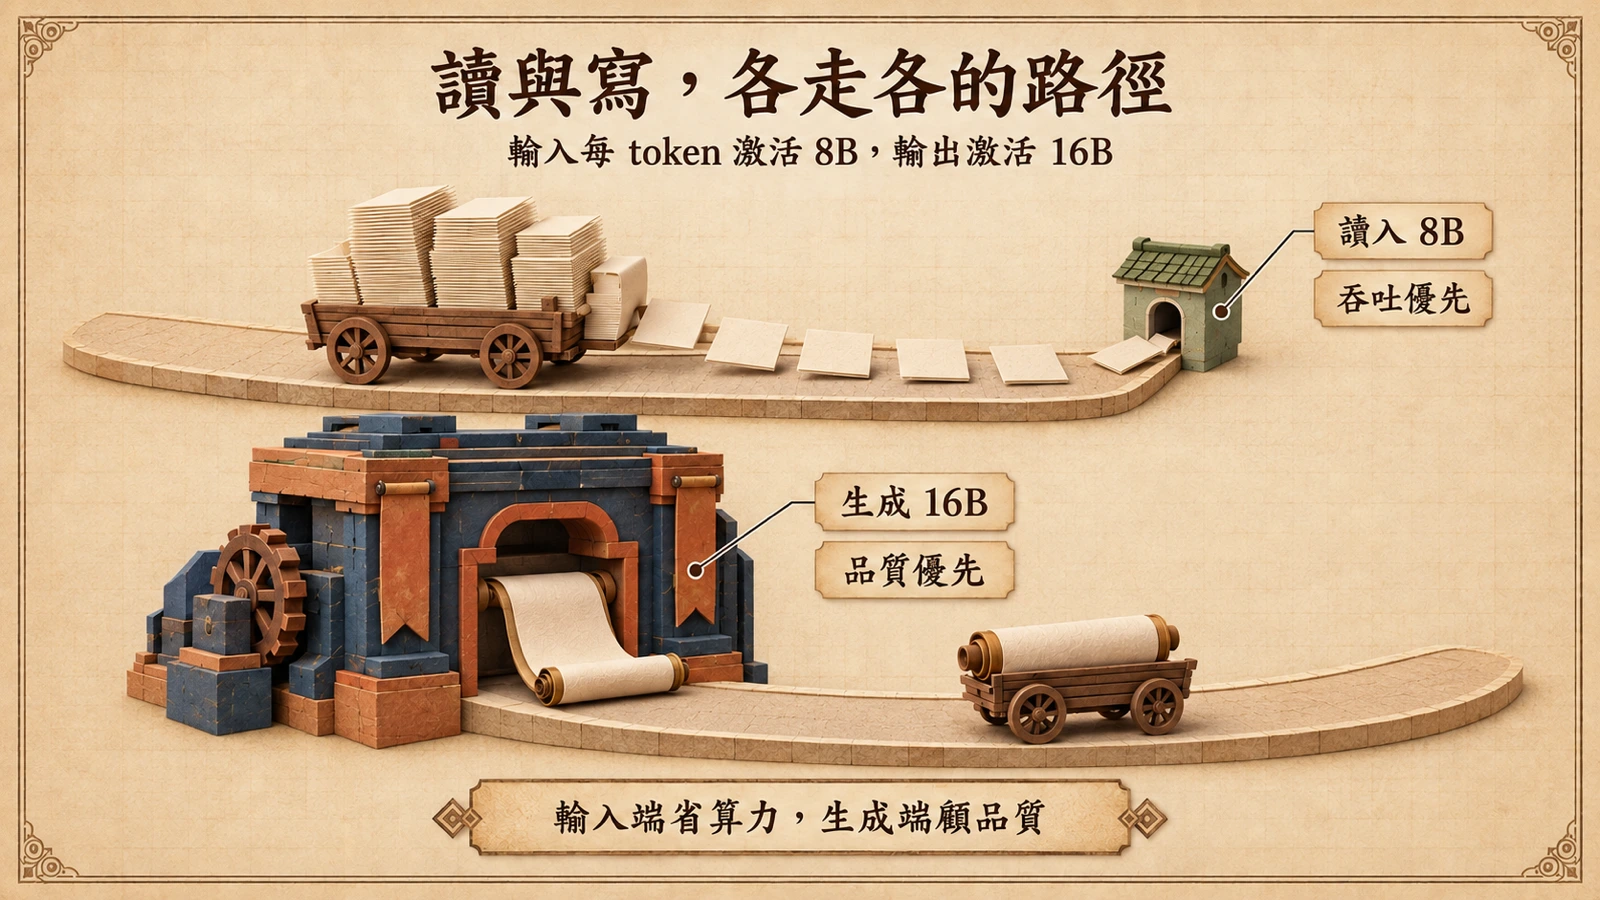
官方公告對新架構的一句話描述是「New Causal Encoder–Decoder architecture: just 8B active parameters for input, 16B for output」——把兩條路徑的寬度正式拆開:讀入走 8B 的窄路徑,生成走 16B 的寬路徑。這個配置的工程邏輯可以這樣理解:在代理與長上下文場景裡,輸入 token 的數量遠大於輸出——系統提示、工具回傳、歷史對話每一輪都要重送,輸入端每 token 的成本乘上龐大基數,才是帳單主力;輸出端量少但每個 token 都影響成品,值得用較寬的路徑顧好品質。
至於 196B 的「Engram」參數扮演什麼角色,模型卡目前只列出數字,尚未附上技術報告層級的說明。從它與 KV cache 大幅縮減同時出現來看,合理推測與記憶狀態的壓縮有關,但這屬於解讀,仍待官方後續文件證實。
KV cache 降到 HBM 的 1/4、SSD 的 1/8
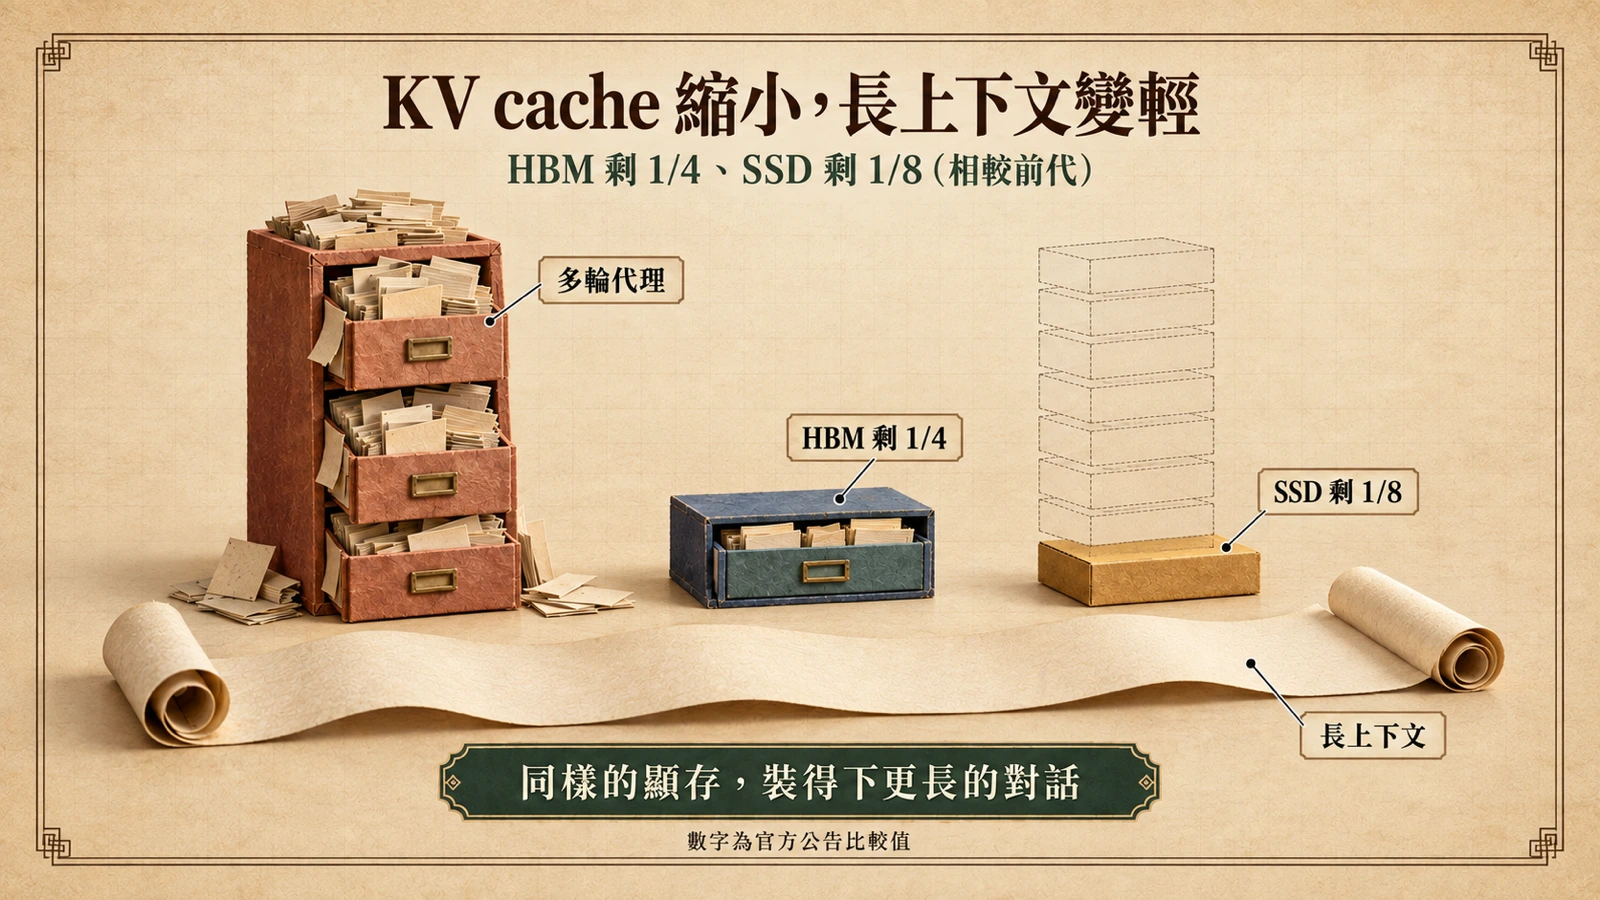
官方公告給出一組明確的比較數字:與前一代相比,V4.1-Flash 的 KV cache 只需要 1/4 的 HBM、1/8 的 SSD 儲存。這組數字值得拆開來看。KV cache 是長上下文推理的記憶體主角——模型讀過的每個 token 都要保留鍵值狀態,供後續注意力查詢使用;context 越長、對話輪次越多,這份狀態就越大,大到成為部署成本的主要決定因素。
HBM 指的是 GPU 的高頻寬記憶體:需求降到 1/4,同樣的顯存可以容納更長的 context,或同時服務更高的併發;SSD 指的是把放不進顯存的 KV cache 卸載到固態硬碟的分層方案:需求降到 1/8,卸載的成本門檻同步下降。對以百萬 token 上下文為基準配備的 V4 世代模型線而言,KV cache 的體積直接決定長上下文是規格表上的數字,還是付得起的日常。
再往下一層看計費結構:DeepSeek 的 API 對快取命中的輸入 token 提供獨立價格,多輪代理工作流大量依賴快取命中來壓成本。KV cache 變小,單位硬體能保留的快取變多,快取命中率與帳單都會直接反映這個改變——這也是官方把「更小 KV cache、更大節省」當成發布主軸的原因。
原生視覺理解:從實驗軌道走進主線
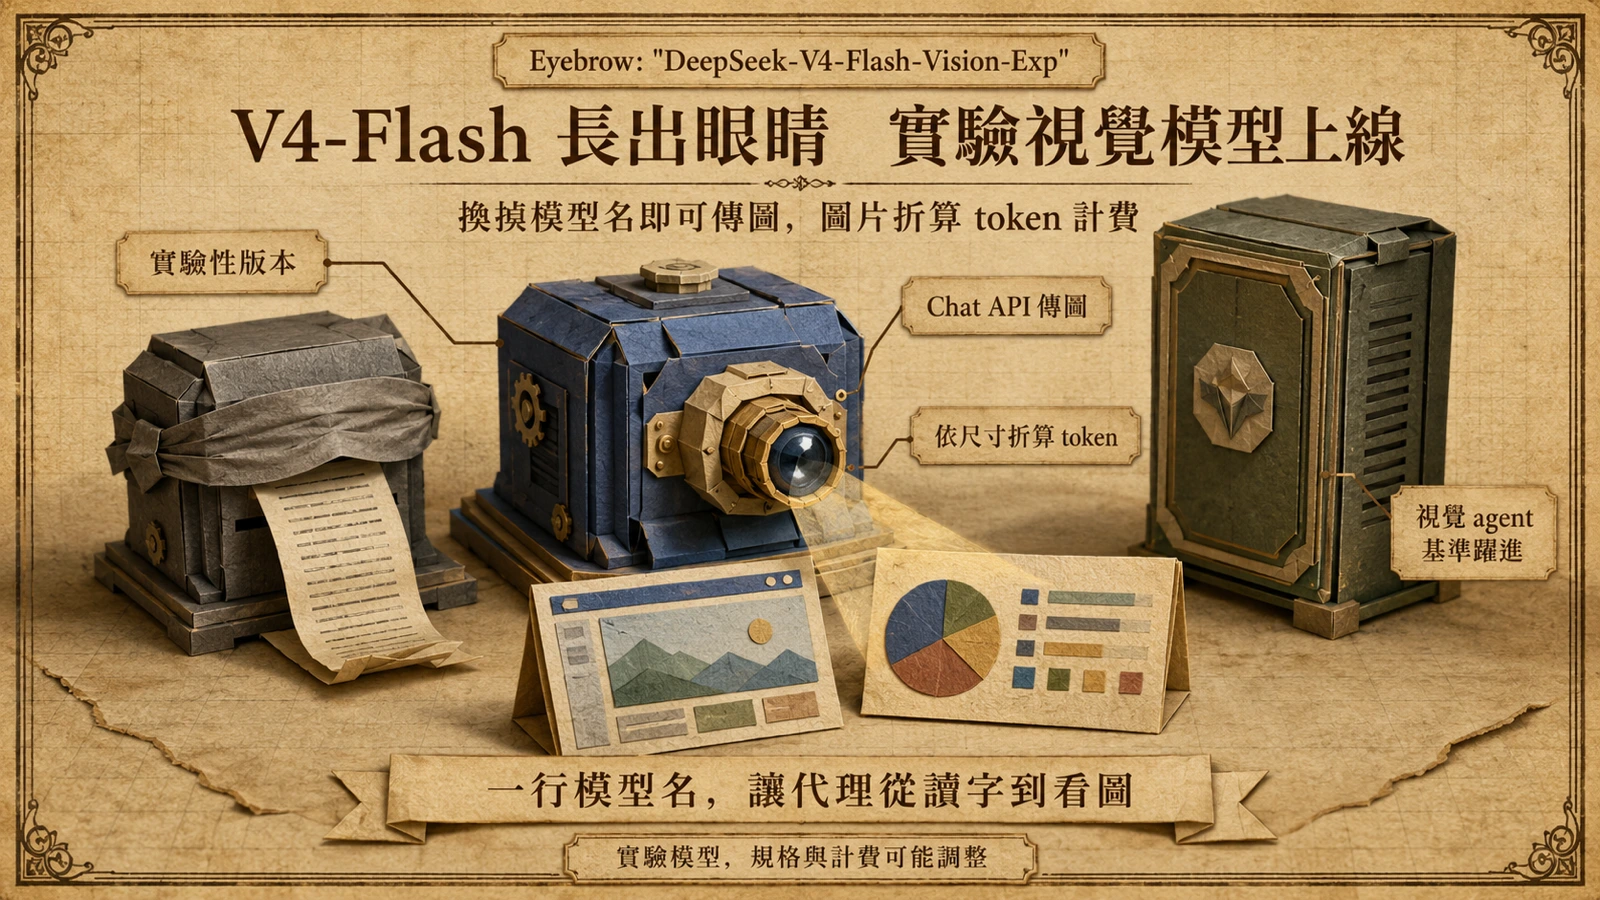
V4 世代第一次「看圖」是八月底的事:當時 DeepSeek 把 V4-Flash-Vision-Exp 掛上實驗標籤、以獨立模型名提供,開發者要傳圖就得切換模型名稱,圖片還要依尺寸折算成 token 計費。V4.1-Flash 把這條路線收進主線——變更日誌以「native multimodal visual understanding」描述它的視覺能力,視覺不再是外加的實驗分支,而是架構的原生規格;模型卡隨附的推論程式也涵蓋視覺編碼器。
對開發者的實際意義很直接:同一個模型名稱同時處理文字與影像,代理工作流不必為了看一張儀表板截圖或 UI 截圖切換模型。對照八月那篇文章的觀察——「先在實驗軌道試營運、再決定轉正」是 DeepSeek 一貫的節奏——V4.1-Flash 等於用一個新架構版本,把實驗軌道驗證過的需求正式轉正。
V4 家族座標:Flash 接棒,Pro 出現退場訊號
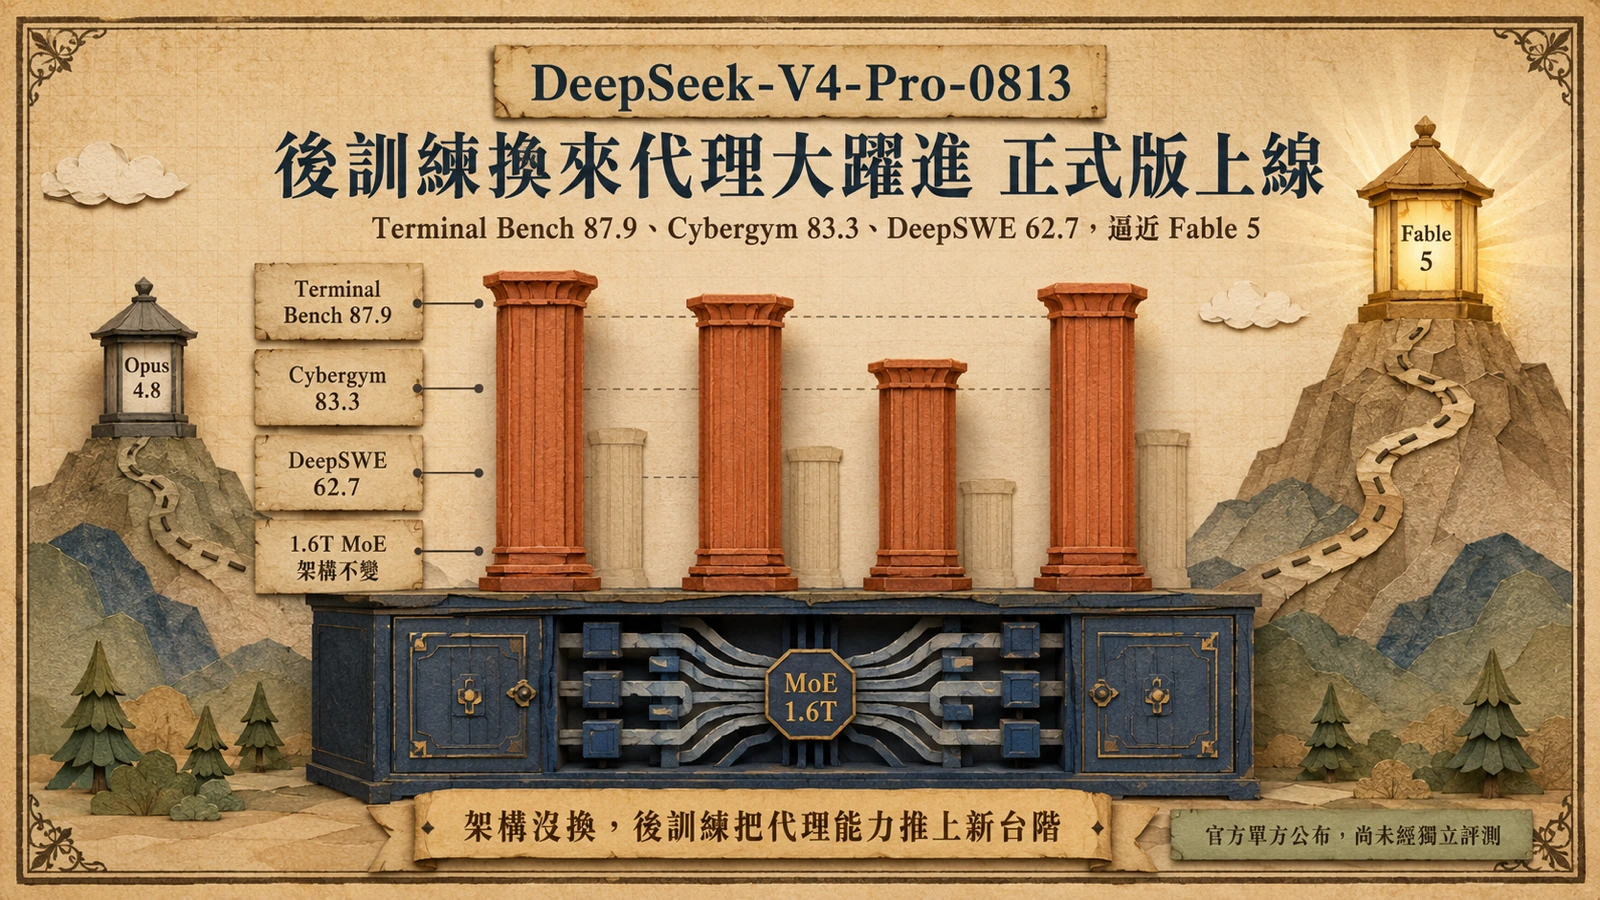
把 V4.1-Flash 放回產品線,分工正在改寫。V4-Flash-0731 是 284B 總參、13B 激活的輕量主力;V4-Pro-0813 是 1.6T 總參、49B 激活的旗艦。官方公告稱,新的預訓練方法配合更大規模的 RL 後訓練,為 V4.1-Flash 帶來超前旗艦模型(包括 V4-Pro)的基準表現;官方文件並已釋出讓 V4-Pro 逐步退場的規劃訊號——等於宣告輕量新架構打贏了自家旗艦。
這個劇本其實有前例:0731 上市時,V4-Flash 就曾以遠小於 V4-Pro 預覽版的激活參數量在多項基準勝出。差別在於,當時的差距主要來自後訓練,這次則進一步換掉架構本身——非對稱的讀寫分徑加上 KV cache 縮減,讓「更便宜、更快、更小記憶體 footprint」不再與「旗艦品質」互斥。若後續家族成員依官方預告往上擴展,V4 Pro 的位置被取代只是時間問題。
API 計價與取用方式
計價方式延續 DeepSeek API 的既有結構:以每百萬 token 為單位,輸入區分快取命中與未命中兩種價格,並採尖峰/離峰雙軌費率;官方先前並已預告將調漲 API 整體定價。V4.1-Flash 的成本優勢有兩層:定價本身,加上 KV cache 縮減帶來的快取命中紅利——後者在多輪代理場景會隨使用時間累積放大。
取得方面,模型卡與推論程式已在 HuggingFace 公開,附提示編碼參考與最小 PyTorch 推論實作,涵蓋視覺編碼器,自架評測可以直接展開。開源推論引擎的支援進度值得盯著 vLLM、SGLang 等專案的動態——非對稱架構需要引擎端配合,支援到位的速度會決定自架路線何時實用。
未驗證之處與後續追蹤
發布首日的資訊仍以官方自述為主。「基準成績超前包含 V4-Pro 在內的旗艦」出自官方公告,尚無逐項分數的獨立複測;Engram 的設計細節、Causal Encoder-Decoder 的完整架構說明,都還沒有技術報告或論文層級的可回查文件;V4-Pro 的退場時程也未給出明確時間表。此外,視覺輸入的計費折算率、與前代模型的逐項成本對照,以定價頁後續更新為準。
後續值得追蹤三個訊號:第三方評測機構對 V4.1-Flash 的複測結果;開源社群的部署實測,尤其 KV cache 實際佔用與非對稱激活的推論速度;以及官方是否釋出技術報告,把 Engram 與新架構的設計講清楚。在這些訊號到位之前,把 V4.1-Flash 視為「方向明確、數字待驗」的新架構起點,是比較穩健的讀法。