9 月 10 日進 API:從 ChatGPT 功能變成開發者產品
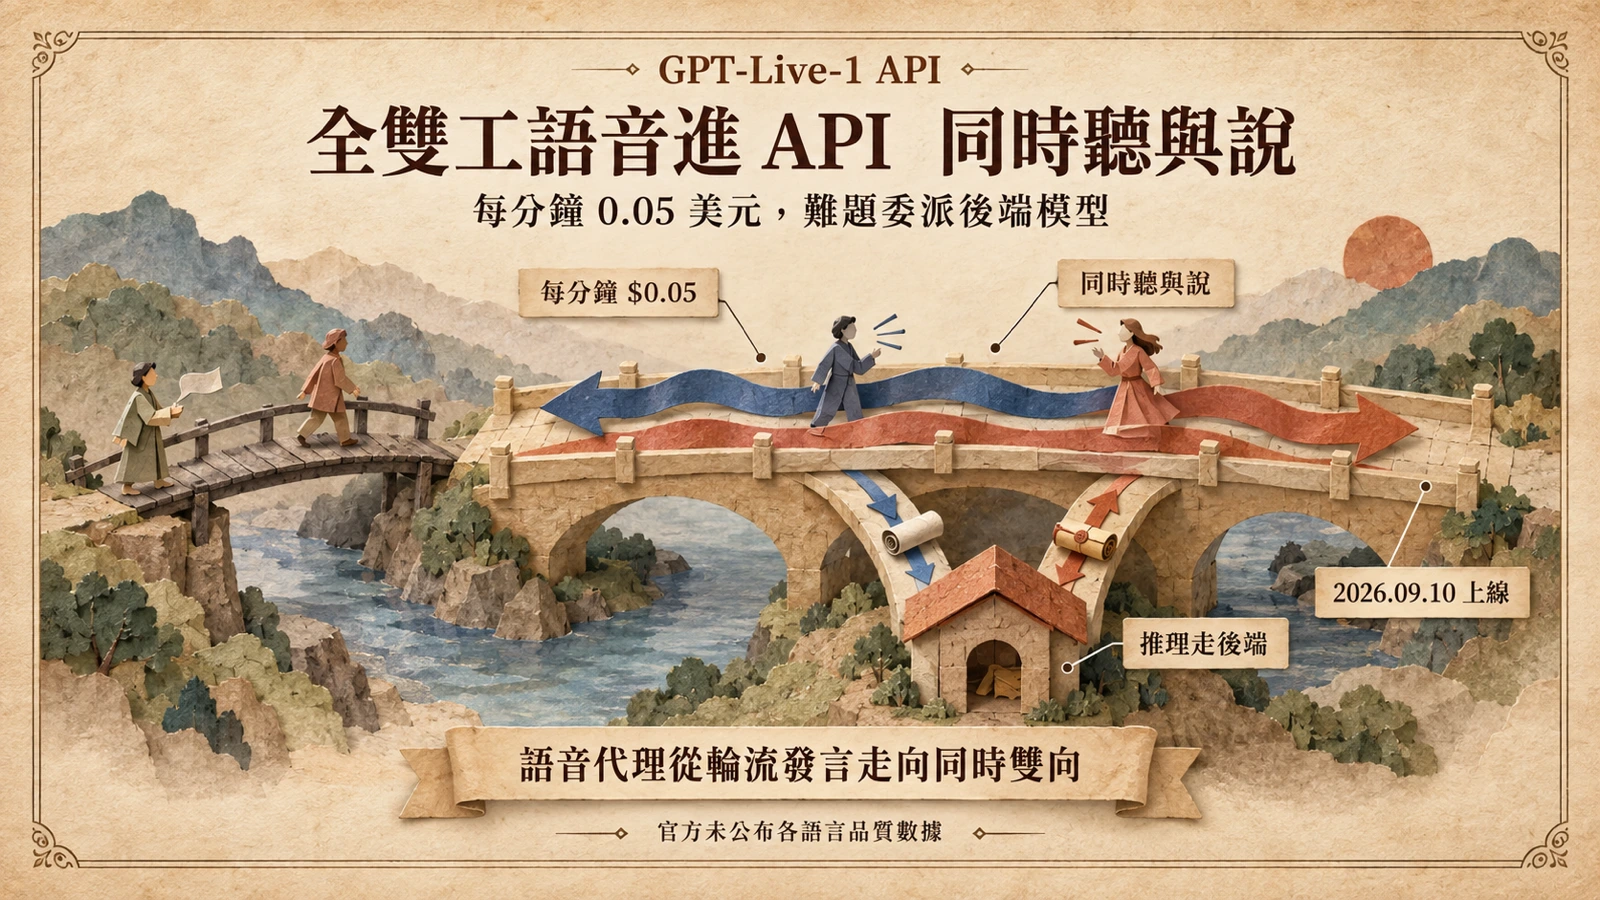
OpenAI 在 9 月 10 日把全雙工語音模型 GPT-Live-1 推入 API,官方公告的標題寫得直白:用 GPT-Live-1 在 API 裡打造更自然的語音體驗。這距離 GPT-Live 系列 7 月 8 日登陸 ChatGPT 剛好兩個月——當時官方僅承諾很快會帶進 API,開發者能做的只有到登記頁留資料等通知。現在這塊拼圖補上了,費率同步公開,GPT-Live-1 正式成為開發者可呼叫、可計價的模型。
時間軸其實是兩段式布局。7 月 8 日,GPT-Live-1 與輕量版 GPT-Live-1 mini 先進 ChatGPT,付費用戶預設使用 GPT-Live-1、免費用戶使用 mini,全球 iOS、Android 與網頁端陸續推送;9 月 10 日 API 上線,OpenAI 在開發者論壇的公告把這一步定位為「把 ChatGPT 的自然全雙工語音對話帶給開發者」。從消費端產品到開發者 API 只隔兩個月,側重的是讓語音互動盡快長出生態,而不只是停留在 ChatGPT 的功能更新。
全雙工:同時聽與說,對話不再輪流等
要理解這次開放的核心,得先拆「全雙工」(full duplex)。傳統語音代理是一條串接管線:語音辨識(ASR)先把聲音轉成文字,語言模型生成回覆,再由語音合成(TTS)念出來。每個階段都要等上一個階段完成,使用者與機器輪流獨白,搶話與冷場得靠外掛的輪流發言偵測去猜。7 月的發布說明對 GPT-Live 的描述是:它建立在全雙工架構上,可以一邊聽一邊說;對話中它會用「mhmm」「yeah」這類短回應表示還在聽,可以快速一來一往,也可以選擇沉默。
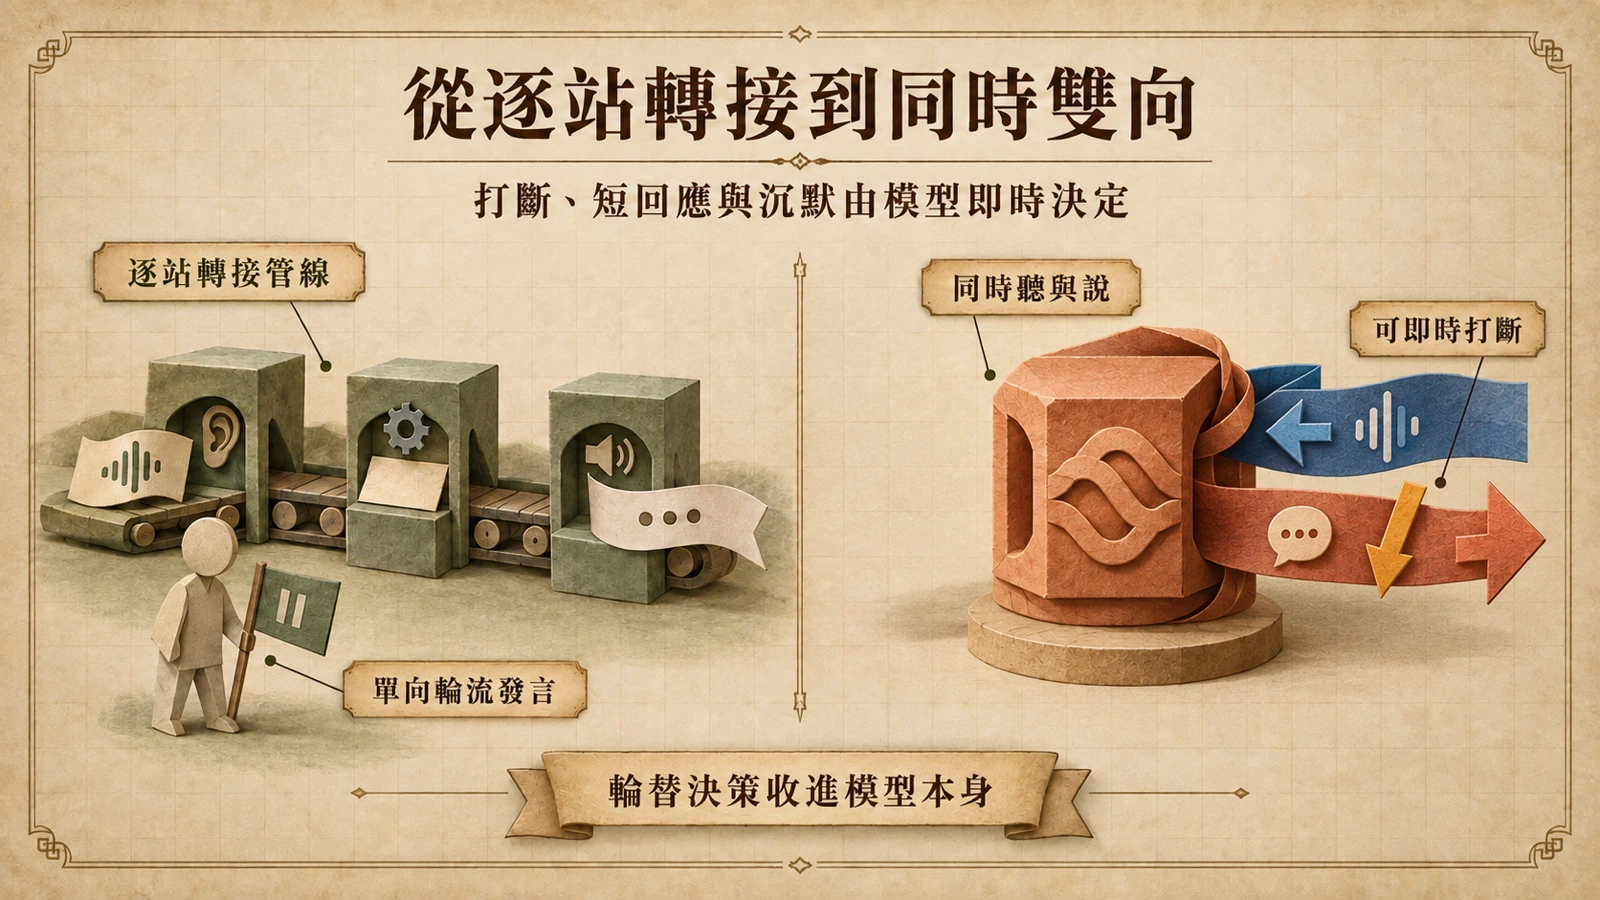
對開發者來說,差別不只是聽感。管線式的延遲是逐站累加的,而全雙工把「該說話、該閉嘴、該打斷還是該繼續聽」的互動決策收進模型本身,等於把過去最難調校的那層對話狀態機交給模型處理,應用端可以專心設計業務邏輯與資料接線。
語音層與推理層分離:邊聊邊把難題交給後端
架構面是這次 API 最值得注意的設計。官方語音代理指南明載:live 模型負責口語互動,並把推理與工具使用委派給另一個後端,後端工作期間使用者可以繼續說話。換句話說,GPT-Live-1 顧好對話節奏——聽、說、回應、停頓;遇到需要查資料、深度推理或呼叫工具的請求,就打包交給後端模型處理,等結果回來再無縫接回對話。公告文件還示範了把 GPT-Live-1 接上 Codex:應用端把對話上下文傳給 Codex,再把答案帶回語音對話。
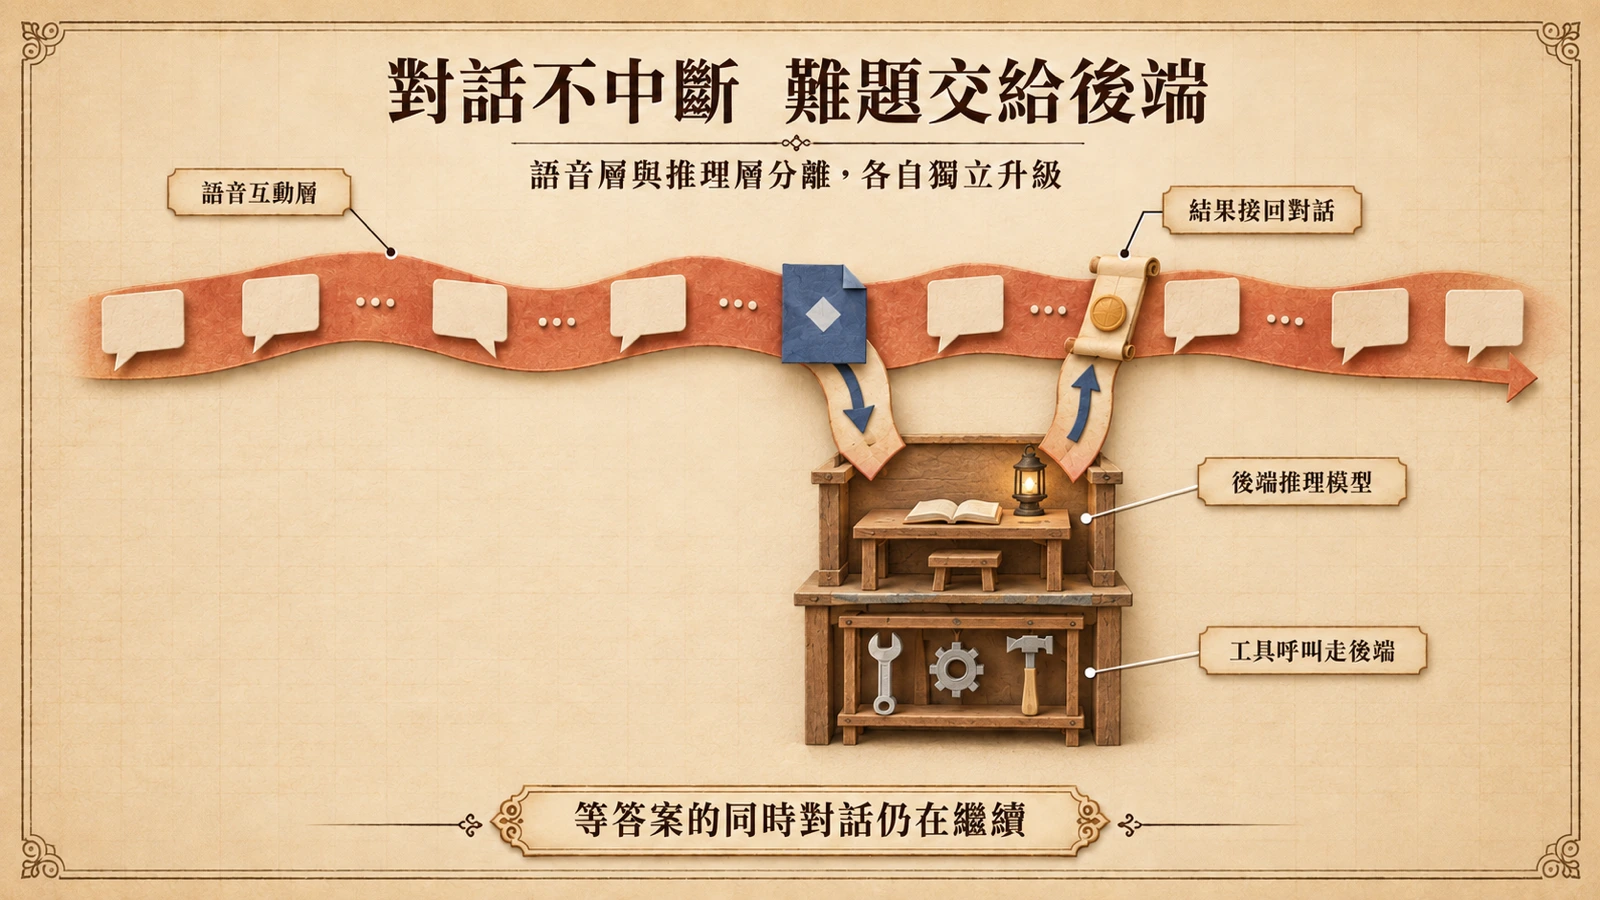
這跟 OpenAI 既有產品線怎麼分工?官方對 Realtime API 的定位是打造語音對語音的代理,模型直接處理聲音、維護對話狀態並可呼叫工具;GPT-Live-1 則把「互動」與「推理」拆成兩層,推理交給獨立的後端模型。對開發者而言兩條路線並存:要一站式語音模型選 Realtime,要「全雙工語音體驗+自選後端推理」就組 GPT-Live-1——這種分層也讓語音體驗與推理能力可以各自升級,不必綁在同一個模型版本上。
每分鐘 0.05 美元:成本怎麼算
價格是這次最直接的數字。OpenAI 定價頁把 gpt-live-1 列在即時與語音生成模型類別,每分鐘 0.05 美元。換算成場景:一小時連續通話 3 美元,一支 3 分鐘的訂位電話約 0.15 美元。
計費方式對語音代理的商業模型有實質影響。過去自建管線要分別估算 ASR、LLM 與 TTS 三段帳單,成本模型複雜;單一費率涵蓋整條語音互動後,單位成本變得容易預估,對電話客服、語音下單這類以通話時長計價的場景尤其友好。反過來說,陪伴型、會議型這類長時間掛線的應用,成本會隨分鐘數線性上升——對話越自然、講得越久、帳單越厚,產品設計時要把這條曲線算進單位經濟。
Yelp 與 Hatch 先上線:電話線上的第一批成績單
最先把 GPT-Live-1 接上生產環境的,是餐飲與服務業的電話場景。Yelp 的新聞稿說明,Yelp Host 與 Hatch 是第一批部署 GPT-Live-1 的方案:前者替餐廳接電話、處理訂位與點餐,後者服務水電、清潔這類本地服務專業者。OpenAI 公告中引述 Yelp 的說法,把 GPT-Live-1 接入這兩個產品後,輪替與準確度都優於原本的傳統語音架構;用 Yelp Host 接聽訂位與餐點來電時,通話處理率也有明顯改善。
場景選擇其實有道理。餐廳電話是典型的惡劣環境:廚房背景雜音、來電者中途改口、併行交談樣樣來,輪替與打斷處理正是傳統管線最難做好的部分。Yelp 把改善歸因於輪替(turn-taking)與準確度兩個指標,等於從營運端驗證全雙工架構的實用性,而不只是展示效果。需要留意的是,這些說法由當事廠商與 OpenAI 自行公布,未見獨立第三方複核,實際改善幅度仍待驗證。
托管 API 與開源全雙工:開發者的兩條路
把視野拉寬,GPT-Live-1 進 API 之後,「全雙工語音」的取得方式分成兩條路。一條是托管 API:免硬體、按分鐘付費,最快上線,代價是權重不開放、費率與模型迭代都掌握在供應商手上。另一條是開源權重:NVIDIA 八月釋出的 VoiceChat 11B 是開源全雙工代表,同時把工具呼叫收進模型,但僅限研究用途,且需要資料中心級 GPU 自行託管。
競品側的對照也逐漸清晰。Claude 的語音模式走「既有文字模型加語音介面」路線,七月起擴及 Opus 與 Sonnet,主打用口語推演難題;OpenAI 則把語音拉成獨立產品線,從 ChatGPT 的桌面版語音多代理到這次 API,一路把語音從附屬功能推向主介面。選型時可以這樣歸納:要立即上線、按用量付費,托管 API 最快;要掌控權與深度客製,就得評估自託管開源模型的工程與授權成本。
導入前該驗證的三件事
最後是限制與待驗證清單。第一,語言表現:官方尚未公布各語言的延遲與品質數據,繁中電話場景(訂位、客服、中英混用)導入前應自行實測打斷處理與輪替延遲,不能假設英文環境的體驗可以直接平移。第二,聲學環境:全雙工意味著模型會聽到自己聲音的回音與環境噪訊,開發者論壇上已經有人問「回音消除要由客戶端 AEC 處理,還是模型能容忍自己的聲音進入上行」,免持聽筒、電話線、廣播環境的部署條件要先界定。第三,成本結構:每分鐘計費雖好預估,但量產前應用真實通話時長分布試算,再決定哪些場景適合全雙工、哪些用傳統管線反而便宜。
這三件事並不減損這次開放的分量——把全雙工語音從自建管線縮短成一個可呼叫的模型名稱,門檻已大幅下降。但「聽起來像真人」與「用起來不煩人」之間還有一段調校距離,短回應頻率、打斷敏感度、沉默時機都會因場景而異。接下來值得追蹤的指標有三個:更多像 Yelp Host 這類生產環境的實績數字、獨立評測能否複現官方與首批客戶宣稱的改善幅度,以及輕量版 mini 何時跟進進入 API。